
Por Mengchen, desde Aofeisi
QbitAI | Cuenta oficial de WeChat: QbitAI
El chiste más gracioso que se ha oído últimamente en el mundo de la IA:
En el próximo mes, las tres grandes van a lanzar nuevos modelos.
El nuevo Claude ha sido calificado como un 'gran salto': al corregir un bug puede 'atacar la raíz', identificando el problema de clase subyacente y resolviéndolo de una sola vez.
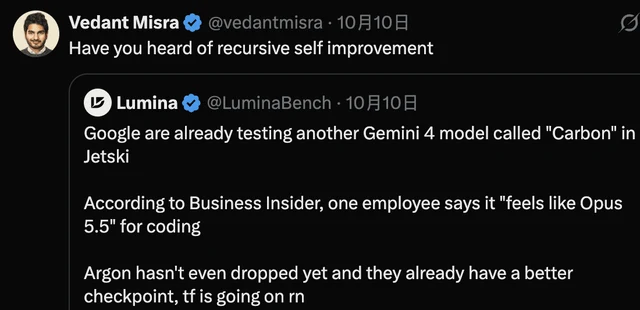
Gemini lanzará Carbon, la versión mejorada de Argon, y las pruebas internas de los empleados indican que 'puede competir con Opus 5.5'.
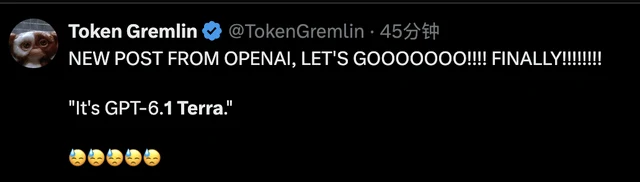
ChatGPT lanzará el tamaño mediano, 6.1 Terra…
Vaya, y uno que pensaba que el actual 6.1 Sol era simplemente Terra con otro nombre.
El nuevo modelo de Claude sabe salir de los esquemas mentales
Según información de Information.
Si crees que en el último mes el ritmo de lanzamiento de nuevos modelos de IA ha sido rápido, no esperes que el próximo mes se frene.
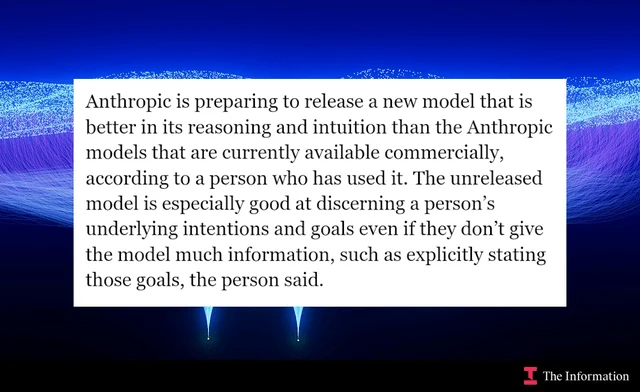
Según usuarios de pruebas internas, el nuevo Claude es mejor en razonamiento e intuición, y destaca especialmente en discernir las intenciones y objetivos latentes de una persona.
Por ejemplo, una persona puede pedirle al modelo que corrija un solo bug, y el modelo podría identificar el problema de clase que causa ese bug y preguntar si conviene corregir toda la clase de problemas, según una persona que ha usado el modelo.
El nuevo Claude también se desempeña mejor al salir de los esquemas mentales, en lugar de repetir los consejos o soluciones comunes y triviales.
Si un usuario pide consejos sobre cómo invertir en acciones, no sugerirá el tópico de mirar la ratio precio-beneficio, sino que propondrá sus propios algoritmos creativos para predecir el comportamiento futuro de las acciones.
Todavía no está claro si el nuevo modelo es Fable u Opus; en cualquier caso, es más potente.
Gemini 4 Carbon posiblemente usó RSI
Mientras tanto, Google también está desarrollando un nuevo modelo, con el nombre en código 'Gemini 4 Carbon'.
Las primeras versiones de Argon quedaron rezagadas en algunas tareas de programación frente a Claude Opus 5.
Carbon supera a Argon en tareas de programación y sigue rindiendo mejor en tareas que requieren comprensión visual, como analizar videos o probar funcionalidades de páginas front-end (gracias al entrenamiento con datos de YouTube).
Carbon estuvo disponible varios días para los empleados en la plataforma interna de programación de Google, Jetski; los empleados que lo probaron opinaron que 'se siente comparable a Opus 5.5', aunque aún requiere más pruebas.
Google probó una serie de modelos Gemini 4, con los nombres en código Argon, Barium y Carbon.
El de nombre interno 'Barium-B' fue el elegido, y se lanzó como el Argon que vemos hoy.
Tras filtrarse el rendimiento de Carbon en las pruebas internas, el empleado de Google Vedant Misra publicó una respuesta: '¿Has oído hablar de la mejora recursiva de uno mismo (RSI)?'.
No está claro si estaba insinuando que Carbon usa la técnica RSI.
¿OpenAI se quedó sin ideas?
GPT-6.1 Terra ya ha aparecido en el código de Microsoft Copilot.
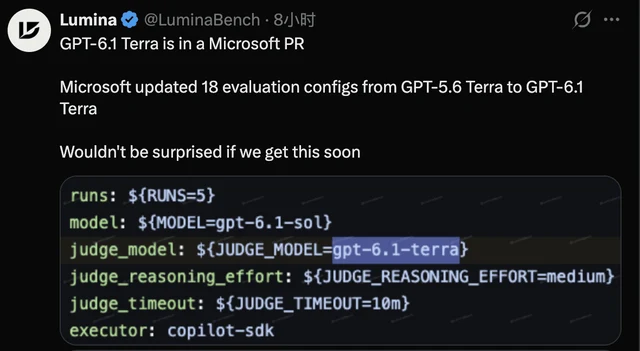
Entonces, la sospecha de muchos de que el 6.1 Sol era en realidad Terra con el nombre cambiado resultó ser errónea. Resulta que el 6.1 Sol simplemente fue una actualización modesta respecto al 5.6 Sol.
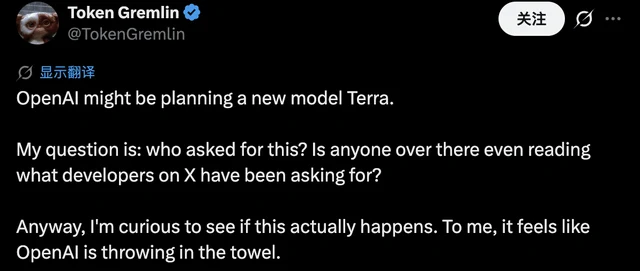
La reacción de mucha gente al ver la noticia del 6.1 Terra fue: parece que OpenAI ya se ha dado por vencida y se ha echado a perder.
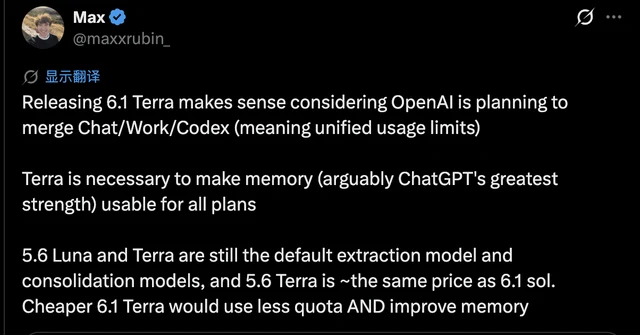
Sin embargo, algunas personas también consideran que la actualización de Terra es realmente importante para OpenAI.
Porque planean fusionar los modos Chat/Work y Codex de ChatGPT, por lo que necesitarán un modelo más barato para los usuarios gratuitos.
Al mismo tiempo, OpenAI publicó un nuevo avance.
Los últimos modelos GPT rinden mejor en lenguajes de programación poco comunes (FORTRAN, COBOL).
Muchos bancos y servicios públicos dependen de estos software antiguos, y ya casi no quedan programadores humanos capaces de mantenerlos.
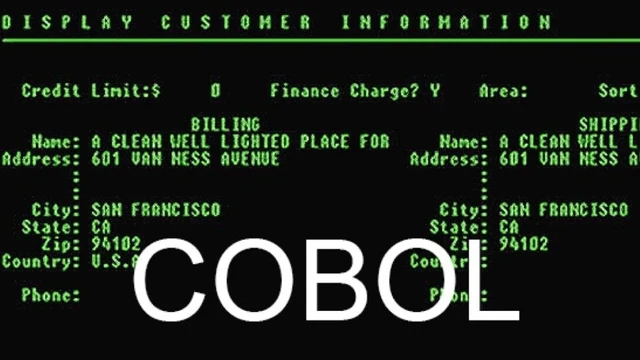
COBOL da soporte a más del 40% de los sistemas bancarios, el 80% de las transacciones presenciales con tarjeta de crédito y el 95% de las transacciones de cajeros automáticos, mientras que Fortran se usa en la predicción meteorológica y en el análisis de seguridad de reactores nucleares.
En las pruebas de migración de programas COBOL a otros lenguajes, GPT‑6.1 Sol alcanzó una precisión del 86.6% en el nivel low, mientras que GPT‑5.6 Sol solo obtuvo un 5.4%. En niveles de razonamiento más altos, la precisión llegó al 97.9%, prácticamente agotando la prueba.
En cuanto a los modelos nacionales, DeepSeek fue el primero en salir a la superficie, y a continuación los nuevos modelos de Kimi, GLM y Minimax irán apareciendo uno tras otro.
En definitiva, el próximo mes de noviembre (11) seguirá siendo emocionante.
Enlaces de referencia:
[1]
https://x.com/kimmonismus/status/2112242007062233122?s=20
[2]
https://x.com/maxxrubin_/status/2112256163761016977?s=20
[3]
https://openai.com/index/low-resource-programming-languages/