
Si ejecuta modelos en su Mac o utiliza MPS como herramienta principal de aceleración para el cálculo, ¡hay mucho por disfrutar en PyTorch 2.15! FP8 llega a MPS, la decodificación de modelos de lenguaje obtiene caminos más rápidos a través de capas lineales y softmax, y nuevos kernels Metal abordan algunas partes sorprendentemente costosas de audio, video y cargas de trabajo de entrenamiento.
Unas palabras rápidas sobre quiénes somos: somos el equipo de PyTorch en Hugging Face. Contribuimos en todo lo relacionado con PyTorch, y uno de nuestros campos de enfoque es el backend MPS, donde el objetivo es convertir tu Mac en un lugar de primera clase para ejecutar y entrenar modelos de PyTorch. A principios de 2026, ejecutar incluso modelos pequeños en MPS a menudo implicaba trabajar con operaciones no soportadas, picos de rendimiento y crecimiento inesperado de la memoria. Así que ejecutamos modelos reales desde el Hub de Hugging Face en cuanto a lenguaje, imágenes y video, identificamos dónde falla MPS y lo corregimos en PyTorch, cada vez más a menudo reemplazando MPSGraph con kernels Metal dedicados. Gran parte de este artículo es el resultado de ese trabajo, realizado junto con los mantenedores de PyTorch y los contribuidores de la comunidad.
TL;DR
- FP8 llega a la Mac: almacena valores de
float8_e4m3fnen la mitad del espacio de BF16 y utiliza multiplicación matricial escalada y todas las otras operaciones soportadas en CUDA/CPU. - Los modelos MoE decodifican 5–6.5 veces más rápido que en 2.14: Qwen3.6-35B-A3B pasa de 9.4 a 61.3 tokens/s en un M3 Ultra, gracias a un matmul agrupado nativo con un camino de decodificación dedicado, menos sincronizaciones GPU-CPU y un enrutamiento más rápido para el top-k.
- Menos tiempo por token para cada LLM: los capas lineales de una sola fila utilizan kernels matriz-vector especializados, y el softmax sobre el vocabulario es aproximadamente 8 veces más rápido.
- Más álgebra lineal en la GPU: soluciones complejas de LU y triangulares, inversas más rápidas para matrices pequeñas, y descomposición QR más rápida.
- El audio, el video y el entrenamiento también reciben atención: caminos más rápidos para las convoluciones, el relleno, el dropout, la interpolación hacia atrás y las reducciones. La decodificación del VAE de video de Wan2.2 ahora alcanza un pico de 8 GiB de memoria en lugar de 270 GiB.
- Más control desde Python: flujos públicos MPS y un tiempo de eventos más confiable.
- Requisitos actualizados: MPS ahora requiere macOS 15 o posterior; PyTorch 2.15 requiere Python 3.11 o posterior.
- Un vistazo a 2.16: atención total en Metal, más migraciones de MPSGraph a Metal y decodificación más rápida de LLM.
¿Qué significa esto para usted
Si ejecuta modelos en una Mac con transformers, diffusers o herramientas como ComfyUI, esto es lo que cambia en la práctica con la versión 2.15:
- LLMs locales mucho más rápidas. Los modelos de mezcla de expertos decodifican 5–6.5× más rápido que en 2.14: en un M3 Ultra con
torch.compile, Qwen3.6-35B-A3B pasa de 9.4 a 61.3 tokens/s y LFM2.5-8B-A1B de 23.6 a 123.6 tokens/s. Los modelos densos también se benefician, gracias a capas lineales más rápidas y a un softmax 8× más rápido para el muestreo. (Más) - Generación de video que cabe en la memoria. La decodificación de un video con el VAE tiled de Wan2.2 utilizó la memoria del driver hasta 270 GiB; ahora alcanza un pico de aproximadamente 8 GiB. (Más)
- Edición correcta de imágenes con Qwen-Image-2.1. En la versión 2.14, el codificador VAE Qwen-Image-2.1 corrompió silenciosamente las imágenes en MPS, interrumpiendo los flujos de trabajo de edición de imágenes (reportado en ComfyUI). La misma cambio de padding lo soluciona: ahora un ciclo de codificación y decodificación coincide con el CPU a 29.95 dB PSNR, en lugar de 10.06 dB.
- Pesos FP8 en tu Mac. Los tensores FP8 ocupan la mitad de la memoria que los BF16, y
F.scaled_mmlos multiplica directamente en el GPU. (Más información)
Contenidos
- Inicio de uso
- FP8 llega a MPS
- Decodificación más rápida de modelos de lenguaje
- El álgebra lineal recibe un impulso
- Convoluciones, relleno y entrenamiento
- Softmax y reducciones
- Un footprint de memoria mucho menor para el decodificado de vídeo
- Más control con las secuencias MPS
- Más operaciones funcionan en MPS
- Un vistazo rápido a PyTorch 2.16
- Resumen
Inicio de trabajo
Necesitará un Mac con chip Apple Silicon con macOS 15 o posterior y Python 3.11 o posterior (ver la matriz de compatibilidad de 2.15). Si su sistema operativo es demasiado antiguo o no hay una GPU Metal disponible, la comprobación de disponibilidad de MPS ahora le indica por qué.
Para probar el candidato de lanzamiento en un entorno separado:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8 llega a MPS
FP8 te ofrece otra forma de ahorrar memoria en tu Mac. PyTorch 2.15 añade torch.float8_e4m3fn tensores en MPS: un byte por valor, la mitad del almacenamiento de FP16 o BF16.
Puede multiplicar estos tensores con F.scaled_mm, que soporta tanto la escalación por tensores como por filas. Aquí hay un pequeño ejemplo con una escala por tensores:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
> Decodificación más rápida del modelo de lenguaje
Cada LLM tiene una fase de prellenado y una fase de decodificación. Durante la decodificación, cada token nuevo pasa por el modelo como una fila única, de modo que las multiplicaciones matriciales grandes se convierten en productos matriz-vector. PyTorch 2.15 acelera ambos tipos de capas que dominan este paso: las capas lineales densas y las capas mezcla de expertos.
Capas lineales
Desde la versión 2.14, MPS ha tenido los kernels GEMV para torch.mm, pero F.linear sigue pasando por MPSGraph. PyTorch 2.15 los conecta con F.linear, por lo que la entrada de decodificación común [1, 1, hidden_size] los utiliza directamente, con las adiciones de bias válidas fusionadas en ella. En 96 formas de capas BF16 de modelos reales, se obtiene un 1.23× aumento de velocidad por medio del promedio geométrico. Las ventajas más grandes se dan en proyecciones pequeñas, como las puertas en los modelos MoE, donde el antiguo método dejaba la mayor parte del ancho de banda de memoria sin usar. Las capas grandes y las cabezas LM ya estaban cerca de ser limitadas por el ancho de banda, por lo que permanecen cerca de 1×.
Capas Mixture-of-experts
Una capa de mezcla de expertos envía diferentes cantidades de tokens a cada experto. El Grouped matmul maneja esas grupas desiguales en una sola operación, y 2.15 proporciona a MPS una implementación nativa.
En 2.14, el método grouped matmul copió los desplazamientos de grupo a la CPU y realizó un recorrido por los grupos. Los nuevos kernels Metal leían los desplazamientos directamente en la GPU, utilizando Metal Performance Primitives cuando estuvieran disponibles y un camino Metal separado en otros casos. Los grupos pequeños, que son el caso común durante el decodificación, también obtienen su propio kernel.
Por ejemplo, 64 tokens pueden dividirse en grupos de 16, 32 y 16.
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
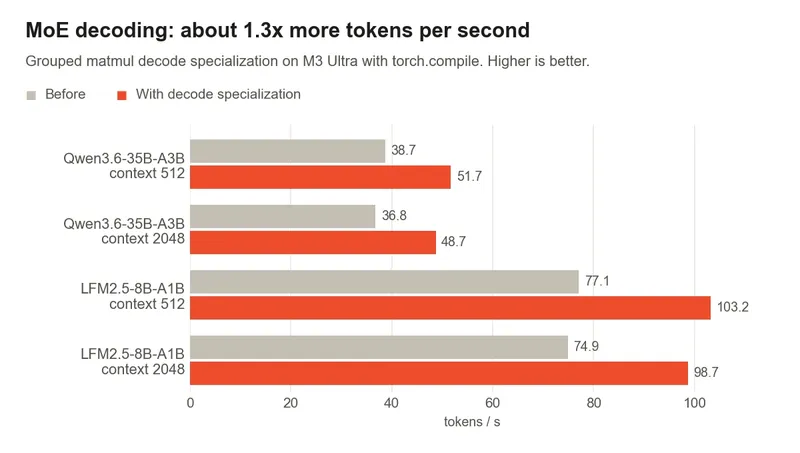
El núcleo de decodificación se muestra directamente en el rendimiento de los tokens. En un M3 Ultra con torch.compile, los modelos MoE generan aproximadamente 1.3 veces más tokens por segundo:

La álgebra lineal recibe un impulso
Computaciones de valores complejos
Trabajar con tensores complejos se vuelve más fácil. complex64 factorización LU, resolución LU y resolución triangular ahora se ejecutan en MPS, lo que también abre las operaciones y gradientes basados en ellos, como los determinantes complejos. Aquí hay un pequeño sistema resuelto directamente en el GPU:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
Matrices pequeñas y soluciones más grandes
Las matrices pequeñas también requieren kernels rápidos. Para la geometría de la cámara y las transformaciones de imagen, lotes de matrices FP32 de hasta 4 × 4 se inverten en un único kernel Metal que combina factorización y resolución. Los problemas más grandes también reciben atención: el QR utiliza actualizaciones bloqueadas, y las soluciones triangulares convierten gran parte de su trabajo en una multiplicación eficiente de matrices.
Las cargas de trabajo de Gated DeltaNet obtienen un camino rápido dedicado para lotes de sistemas triangulares de 16 × 16, 32 × 32 y 64 × 64 FP32, con al menos ocho lados derechos.
SVD también es más robusto en los extremos numéricos. Ahora maneja correctamente valiosos valores singulares muy pequeños, grandes o muy pequeñas magnitudes de entrada y completación de la base con full_matrices=True, lo que a su vez hace que los resultados de pseudoinversión y de mínimos cuadrados sean más fiables.
Convoluciones, relleno y entrenamiento
Los modelos de audio, los decodificadores de video y los bucles de entrenamiento tienen sus propias operaciones costosas. Esta versión introduce varios de ellos en nuevos caminos a través de Metal:
| Operación | ¿Qué cambios hay en 2.15? |
|---|---|
conv1d forward |
Kerneles especializados reemplazan a MPSGraph, además de un camino im2col-plus-matmul para salidas cortas. Útil para formas de modelos de audio y streaming. |
| Acento constante | Movimientos hacia los kernels de Metal, corrigiendo el crecimiento descontrolado del controlador y la memoria en la decodificación de video VAE dividido en tiles (más abajo). |
| Revestimiento de reflexión y replicación | Implementaciones de metal nuevas que son más rápidas y corrigen la corrección inversa. |
| Dropout fuera del lugar | nn.Dropout y F.dropout ahora utilizan el kernel fusionado existente. |
| Upsampling hacia atrás | Un kernel de Metal Gather reemplaza al trazo de resizing-gradient de MPSGraph. |
En el canal, retroceso del conv2d |
Se mantiene en un camino eficiente basado en canales, en lugar de un grafo NCHW con acceso estructurado costoso. |
Softmax y reducciones
La muestra de tokens también se acelera en 2.15. softmax y log_softmax ahora se ejecutan con kernels Metal dedicados, y los vocabularios grandes se benefician más: un softmax en FP32 sobre una fila de logits de [1, 128256] reduce el tiempo de ejecución de 57 µs a 7 µs, aproximadamente 8× más rápido que la versión MPSGraph. La aceleración se mantiene para otros tamaños comunes de vocabulario:

Una huella de memoria mucho más pequeña para el decodificación de video
Uno de los resultados más notables en esta versión proviene del cambio en el relleno constante. La decodificación VAE en Wan-AI/Wan2.2-TI2V-5B-Diffusers realiza 8,764 llamadas de relleno durante una decodificación completa de 28 azulejos. Con el relleno en Metal, el máximo uso de memoria del driver disminuye de aproximadamente 270 GiB a 8 GiB.

| Métrica de memoria | MPSGraph padding | Relleno de metal |
|---|---|---|
| Pico de asignación de tensores actual | 4.422 GiB | 4.095 GiB |
| Peak reservado por el asignador | 8.070 GiB | 8.070 GiB |
| Pico total de driver-memoria | 270.135 GiB | 8.108 GiB |
Más control con MPS streams
Ahora puede elegir qué flujo MPS ejecuta su trabajo, directamente desde Python. torch.mps.Stream y el torch.mps.stream context manager proporcionan la interfaz, y Tensor.record_stream permite que el allocator rastree el uso de un tensor en otro flujo.
Aquí hay un pequeño ejemplo que envía el trabajo a una corriente separada y lo sincroniza antes de leer el resultado:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
Más operaciones funcionan en MPS
Varias operaciones adicionales ahora se ejecutan en MPS: torch.frexp, torch.logspace, torch.take y Tensor.put_, torch.heaviside, torch.special.laguerre_polynomial_l y comparaciones de enteros sin signo. logspace aún no soporta salidas de tipo entero o booleano con más de un elemento.
La corrección de la correctitud también se aplica al atención: la implementación matemática MPS del producto punto escalado de la atención ahora gestiona correctamente el broadcast por lotes y por cabezas.
Un vistazo previo a PyTorch 2.16
El trabajo en 2.16 ya está en marcha. Algunos de los cambios a continuación han sido aplicados en main y están disponibles en las versiones nocturnas; otros todavía se están revisando, por lo que los detalles podrían cambiar antes del lanzamiento.
Decodificación más rápida de LLM
Cuando el camino de decodificación del modelo ya no contiene ninguna operación MPSGraph, la GPU solo comienza a trabajar en un token después de que la CPU haya terminado de codificar todos sus kernels. PyTorch 2.16 comite el búfer de comandos cada 16 kernels, de modo que la GPU puede trabajar mientras la CPU sigue codificando el resto. Para la decodificación compilada de BF16 en un contexto de 2048 tokens:
| Modelo | Antes | Después | Cambiar |
|---|---|---|---|
| LFM2.5-8B-A1B | 108.8 tokens/s | 126.0 tokens/s | +16% |
| Qwen3.6-35B-A3B | 52.9 tokens/s | 62.8 tokens/s | +19% |
| Qwen3.8-27B | 12.1 tokens/s | 12.6 tokens/s | +4% |
La atención se ejecuta completamente en Metal
La atención de producto punto escalada es eliminar completamente MPSGraph: cada forma se ejecutará con kernels Metal, con kernels vectoriales dedicados para la decodificación y primitivos de rendimiento Metal para el relleno de precisión media en las versiones más recientes de macOS. Las formas que antes recurrían a MPSGraph se benefician más. En un M5 Pro, la decodificación con atención de consulta agrupada (32 cabezas de consulta, 8 cabezas KV, dimensión de cabezal 80, contexto 4K) disminuye de 465 µs a 65 µs, y un relleno de 4K × 4K con dimensión de cabezal 40 pasa de 42 ms a 6 ms.
Más migraciones de MPSGraph a Metal
La tendencia hacia la eliminación de MPSGraph continúa. El normalizado por lotes hacia adelante y hacia atrás están en proceso, mientras que el perdida MSE (hasta 12 veces más rápido con entradas pequeñas), std_mean y var_mean (hasta 4 veces más rápido) y bincount ya se han implementado. bincount es el más impresionante: cuando la mayoría de los valores caen en un único bin, contar 4 millones de enteros lleva 6.8 segundos y ahora toma medio milisegundo.
Una instalación más pequeña
Los shaders agrupados se construirán por defecto para Metal 3.1, mientras que las versiones de Metal 4 se compilan únicamente para los kernels que las necesitan. Esto reduce libtorch_cpu.dylib en aproximadamente el 25%, de 384 MiB a 287 MiB, y sienta las bases para los shaders de Metal 4.1 con multiplicación matmuls más rápida y multiplicación de matrices en FP8 nativa.
Resumen
PyTorch 2.15 lleva el FP8 al Mac, una decodificación más rápida de los LLM para modelos densos y MoE, más álgebra lineal en la GPU, y una larga lista de operaciones transferidas de MPSGraph a kernels Metal dedicados. Pruebe el candidato de lanzamiento.
¿Qué sigue para nosotros
- Más MPS: 2.16 se centrará completamente en Metal, y seguiremos desplazando las operaciones desde MPSGraph.
torch.compile: Estamos trabajando para eliminar las interrupciones en el grafo, de modo que más modelos se compilen completamente.- Tus ideas: ¿En qué más deberíamos trabajar en PyTorch? Si algo es lento, falta o está roto, en MPS o en cualquier otro lugar, abre un issue en GitHub y dígnate a nosotros.
Un gran agradecimiento a Nikita Shulga, Kurt Mohler y Aaron Gokaslan por revisar gran parte de este trabajo, y a todos quienes contribuyeron al MPS en esta versión.