Presentamos ChatGPT Images 2.5
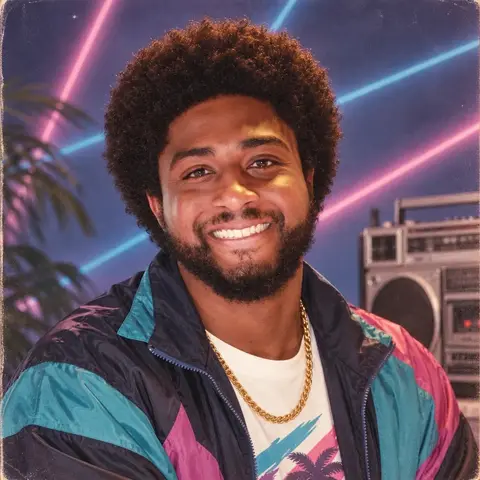
ChatGPT Images 2.5 ayuda a convertir tus ideas, bocetos y fotos de referencia en imágenes más personalizadas y pulidas que reflejan mejor tus ideas.
Explora novedades de IA con sus fuentes y fechas.
ChatGPT Images 2.5 ayuda a convertir tus ideas, bocetos y fotos de referencia en imágenes más personalizadas y pulidas que reflejan mejor tus ideas.
OpenAI está ampliando su apoyo al periodismo con herramientas, formación y alianzas para estudiantes, educadores, periodistas y organizaciones de noticias.
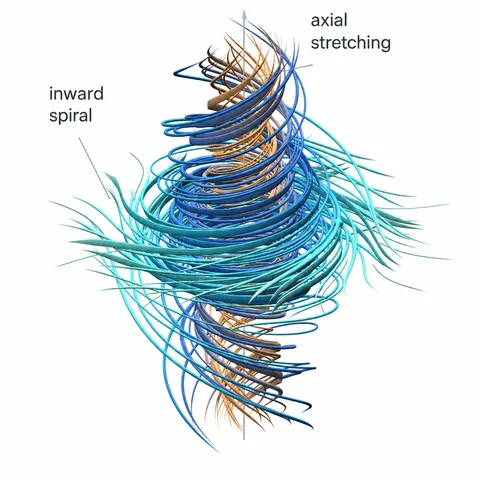
Compartimos una solución generada por IA al problema del Premio Milenio de Navier–Stokes, que incluye un documento explicativo y una prueba formal en Lean.
Solicita ahora el programa de subvenciones de 5 millones de dólares de OpenAI que respalda la investigación independiente sobre cómo la IA generativa afecta el desarrollo, el bienestar y la seguridad de los adolescentes.
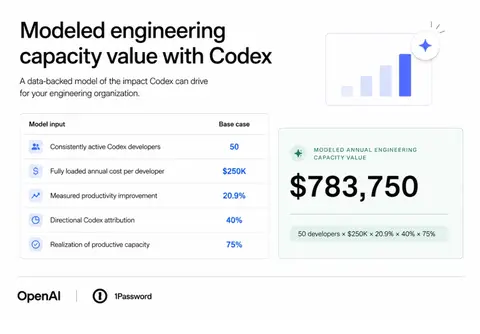
Los ingenieros de 1Password usan Codex para construir rápidamente nuevas funciones y herramientas internas, alcanzando el estado listo para producción mientras mantienen rigurosas políticas de seguridad.
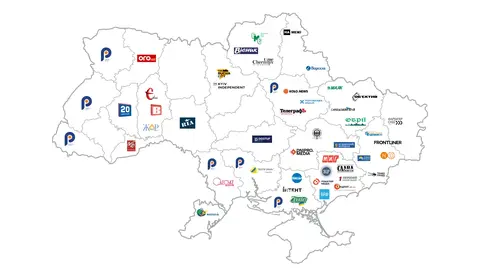
OpenAI, AIRPPU y WAN-IFRA lanzan un programa de IA para ayudar a las organizaciones de noticias ucranianas a fortalecer la innovación, la resiliencia y el periodismo independiente.
Jakub Pachocki reflexiona sobre la capacidad cada vez mayor de la IA y el desafío de mantenerla alineada. Pide medidas de seguridad más estrictas y coordinación internacional.
Dentro de OpenAI, los agentes de programación están transformando la investigación en IA. Explora datos tempranos sobre el uso de agentes, la velocidad de los experimentos, la complejidad de las tareas y la aceleración de la investigación.
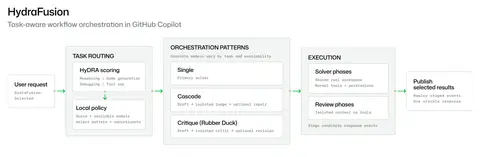
En evaluaciones offline controladas, los flujos de trabajo de codificación selectiva de HydraFusion igualaron o superaron la línea base evaluada de Opus 5 mientras reducían el coste estimado del flujo de trabajo. Ahora disponible como vista previa de investigación en GitHub Copilot. La publicación Proyecto HydraFusion: calidad de frontera mediante orquestación multimodelo apareció primero en The GitHub Blog .
Aprende a ejecutar agentes en paralelo en la aplicación GitHub Copilot y experimenta el momento en que deja de dar miedo y empieza a sentirse poderoso. La publicación Aplicación GitHub Copilot para principiantes: Ejecuta varios agentes a la vez apareció primero en The GitHub Blog .
OpenAI presenta Daybreak for Frontline Defenders. Un compromiso de $1 mil millones amplía el acceso a la IA cibernética de frontera, la capacitación y el apoyo para los servicios esenciales.
Legora usó GPT-6 Astra para revisar 41 documentos en minutos, encontrar los cuatro errores plantados y mejorar el rendimiento en casi un 40% en este flujo de trabajo de revisión financiera.
Usando GPT-6 Astra, Playco creó tres prototipos de juegos temáticos a partir de una base de caja gris y reportó un 50% menos de correcciones manuales que con el modelo anterior.
Presentamos GPT-6 Astra, nuestro modelo más inteligente y alineado hasta la fecha, con capacidades de vanguardia en uso de computadora, programación, ciberseguridad y ciencia.
En los últimos años, el paradigma de evaluación de agentes consistía en dar un objetivo y que el modelo lo alcanzara lo máximo posible en un número limitado de turnos. Por ejemplo, encontrar un tesoro en un laberinto, producir un informe o corregir un fragmento de código. El rendimiento del modelo también se evalúa según la calidad del producto entregado o el grado de finalización de la tarea, y este tipo de evaluaciones suele tener un estado de terminación natural claro. Las tareas de largo horizonte del mundo real en su mayoría no tienen un estado de terminación natural claro, por ejemplo la predicción del tiempo, el trading de acciones o la operación comercial. Es como si una tienda online no pudiera ser "operada hasta su finalización" en una mañana concreta; el inventario acumulado el mes pasado, el precio negociado anteayer y la promoción de ayer afectan
Presentamos Qwen-Drive-1.0. Este es el primer modelo fundacional de visión-lenguaje para la conducción autónoma que unifica la percepción 3D y el cuestionario visual en la etapa de preentrenamiento, y se extiende además a la planificación de movimiento, manteniendo además sin modificaciones la arquitectura del VLM preentrenado durante todo el proceso. El modelo toma como base el Qwen3.5-4B nativamente multimodal y añade dos módulos externos. La cabeza de percepción BEV actúa como una sonda 3D explícita y examinable, y realiza conjuntamente la detección de objetos 3D, la predicción de Occupancy semántica y la segmentación de mapas BEV. El experto en planificación genera la trayectoria futura del vehículo propio basándose en flow matching. Mediante un entrenamiento por etapas, mejoramos significativamente la capacidad de conducción autónoma del VLM general, y verificamos su viabilidad en las tareas de percepción 3D, cuestionario visual de conducción y planificación de movimiento, formando un modelo unificado de visión-lenguaje para la conducción autónoma, que proporciona una base VLM de nueva generación para la adaptación a escenarios de conducción.