
Cornerstone OnDemand, Inc. (Cornerstone) est un leader mondial des solutions de préparation de la main-d'œuvre, au service de 140 millions d'utilisateurs dans 186 pays. L'entreprise a construit un système d'IA multi-agents qui transforme les opérations de base de données d'une lutte réactive contre les incendies en flux de travail proactifs et auto-orchestrés. Le système, appelé Orion AI, utilise Amazon Bedrock et Strands Agents, un framework open source d'orchestration d'agents d'AWS, pour coordonner des agents spécialisés.
Avant Orion AI, l'équipe Enterprise DataOps de Cornerstone passait jusqu'à 45 minutes par incident de base de données à interroger manuellement les vues système et à recouper les journaux avant de transférer le dossier entre les équipes. Avec Orion AI, le diagnostic de base de données est passé de 45 minutes à 10, soit une réduction de 78 %. Une équipe de trois personnes a livré le système en six mois.
Dans cet article, nous examinons le problème opérationnel auquel Cornerstone a été confronté, la façon dont ils ont conçu Orion AI, les résultats qu'ils ont mesurés et les décisions de conception que d'autres équipes peuvent réutiliser.
Le défi opérationnel
Avant Orion AI, l'équipe Enterprise DataOps de Cornerstone opérait de manière réactive, avec quatre points de douleur récurrents :
- Les enquêtes sur les performances de la base de données prenaient environ 45 minutes par incident, réparties sur plusieurs outils et vues système.
- Les flux de travail du cycle de vie de la base de données nécessitaient 10 étapes manuelles ou plus, de l'établissement des connexions à la communication des mises à jour de statut.
- Le reporting entre l'équipe d'ingénierie de fiabilité des sites (SRE) et l'équipe données fonctionnait avec un retard de 15 minutes.
- Des alertes redondantes et chevauchantes créaient du bruit qui enfouissait les signaux importants.
Ensemble, cela signifiait que les ingénieurs passaient leur temps à coordonner manuellement au lieu de résoudre les problèmes.
La solution : Orion AI
Orion AI est un système multi-agents dans lequel un agent coordinateur (le méta-orchestrateur) délègue le travail à des agents enfants spécialisés disposés dans une topologie en étoile (hub-and-spoke). Les ingénieurs interagissent avec lui via une application web, en posant des questions et en approuvant des actions au même endroit où ils coordonnent déjà leur travail opérationnel. Les agents couvrent la surveillance de l'infrastructure, les diagnostics de base de données, les opérations du cycle de vie de la base de données, l'analyse client et le support basé sur les connaissances.
Deux principes ont guidé la construction : la confidentialité des données grâce aux contrôles AWS dans le cadre du modèle de responsabilité partagée, et une intégration approfondie avec les outils opérationnels existants. Amazon Bedrock a fourni un accès géré aux modèles de fondation, et Strands Agents a fourni la couche d'orchestration.
Résultats
Orion AI a apporté des améliorations mesurables tant en rapidité qu'en précision du diagnostic et a libéré l'équipe de la coordination manuelle. En automatisant les goulots d'étranglement manuels et en rationalisant les flux de travail inter-équipes, Cornerstone a obtenu les résultats suivants.
| Métrique | Avant | Après | Amélioration |
| Temps de diagnostic de base de données | 45 minutes | 10 minutes | 78 % plus rapide |
| Étapes manuelles du cycle de vie | Plus de 10 étapes | 1 seule interaction | Réduction de 70 % |
SRE-to-data-team décalage des rapports |
15 minutes | Instantané | En temps réel |
| Alertes redondantes | Volume de base élevé | Filtré | Réduction de 65 % (médiane) |
Dépannage de performances plus rapide
La réduction du temps de diagnostic des bases de données a été le plus important gain d'efficacité isolé d'Orion AI à ce jour. Auparavant, les ingénieurs se connectaient manuellement à l'instance SQL Server affectée, interrogeaient les vues système pour identifier les chaînes de blocage et les types d'attente, croisaient les journaux pour isoler les requêtes longues, et confrontaient les éléments de preuve pour former une hypothèse de cause racine. Cela prenait en moyenne environ 45 minutes par incident.
Avec Orion AI, trois agents spécialisés se partagent l'investigation, chacun étant responsable d'une étape distincte. Au-delà du diagnostic, Orion AI mène les problèmes jusqu'à leur résolution : identification de la cause racine, recommandation du correctif et création d'un ticket Jira prérempli assigné au bon ingénieur d'astreinte. Une procédure manuelle en quatre étapes se réduit à une seule interaction.
Gestion automatisée du cycle de vie des bases de données
Les tâches qui nécessitaient auparavant plus de 10 étapes manuelles, de l'établissement des connexions aux bases de données à l'exécution de requêtes inter-systèmes en passant par la communication des mises à jour de statut, s'exécutent désormais en une seule interaction en langage naturel. Orion AI identifie les bons outils et sources de données, exécute des requêtes à travers les systèmes, valide les résultats et renvoie une réponse unifiée. Du point de vue de l'ingénieur, le travail se réduit à solliciter Orion AI et à valider les conclusions qu'il rapporte.
Surveillance en temps réel et réduction de la fatigue liée aux alertes
Orion AI a supprimé les 15 minutes SRE-to-data-team délai de reporting de 15 minutes, en remplaçant les vérifications manuelles périodiques par une visibilité continue inter-systèmes.
Orion AI a réduit les alertes redondantes de 65 % en médiane grâce à la déduplication, au filtrage par seuil et à la corrélation inter-signaux. Pour 10 alertes précédemment générées, seules 3–4 parviennent désormais aux ingénieurs. Les alertes sont acheminées directement vers les équipes responsables sans couche d'alerte intermédiaire.
Principes de conception clés
Trois décisions ont façonné Orion AI, et vous pouvez les appliquer à vos propres projets multi-agents :
- Diviser les agents par domaine, et non par complexité de tâche: chaque agent intègre un ensemble restreint d'outils pour un domaine opérationnel unique. Cela permet de garder le contexte d'un modèle concentré et d'améliorer la précision de la sélection des outils, plutôt que de demander à un agent polyvalent de tout faire.
- Privilégier par défaut le routage par mots-clés, avec repli sur la recherche sémantique: les requêtes prévisibles sont traitées par mots-clés pour la rapidité. Les requêtes ambiguës basculent vers la recherche sémantique pour plus de précision. Cela maintient une latence faible sans sacrifier l'exactitude sur les requêtes plus difficiles.
- Limiter la mémoire conversationnelle aux sessions et la contourner pour les métriques en direct: la mémoire persistante prend en charge les conversations à plusieurs tours, mais les questions opérationnelles lisent toujours l'état actuel du système. Contourner la mémoire pour les métriques en direct aide à empêcher que des données périmées ne contaminent les diagnostics en temps réel.
Vue d'ensemble de l'architecture
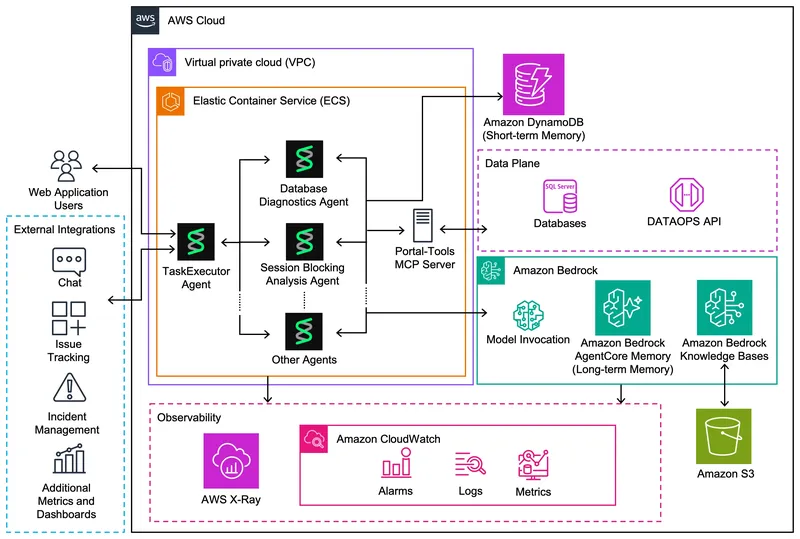
Orion AI est déployé sous forme de services conteneurisés sur Amazon Elastic Container Service (Amazon ECS). Les utilisateurs interagissent via une application web qui achemine chaque requête vers l'agent approprié, invoque les outils nécessaires et assemble la réponse. Le schéma suivant montre comment ces composants se connectent au sein du Cloud AWS.
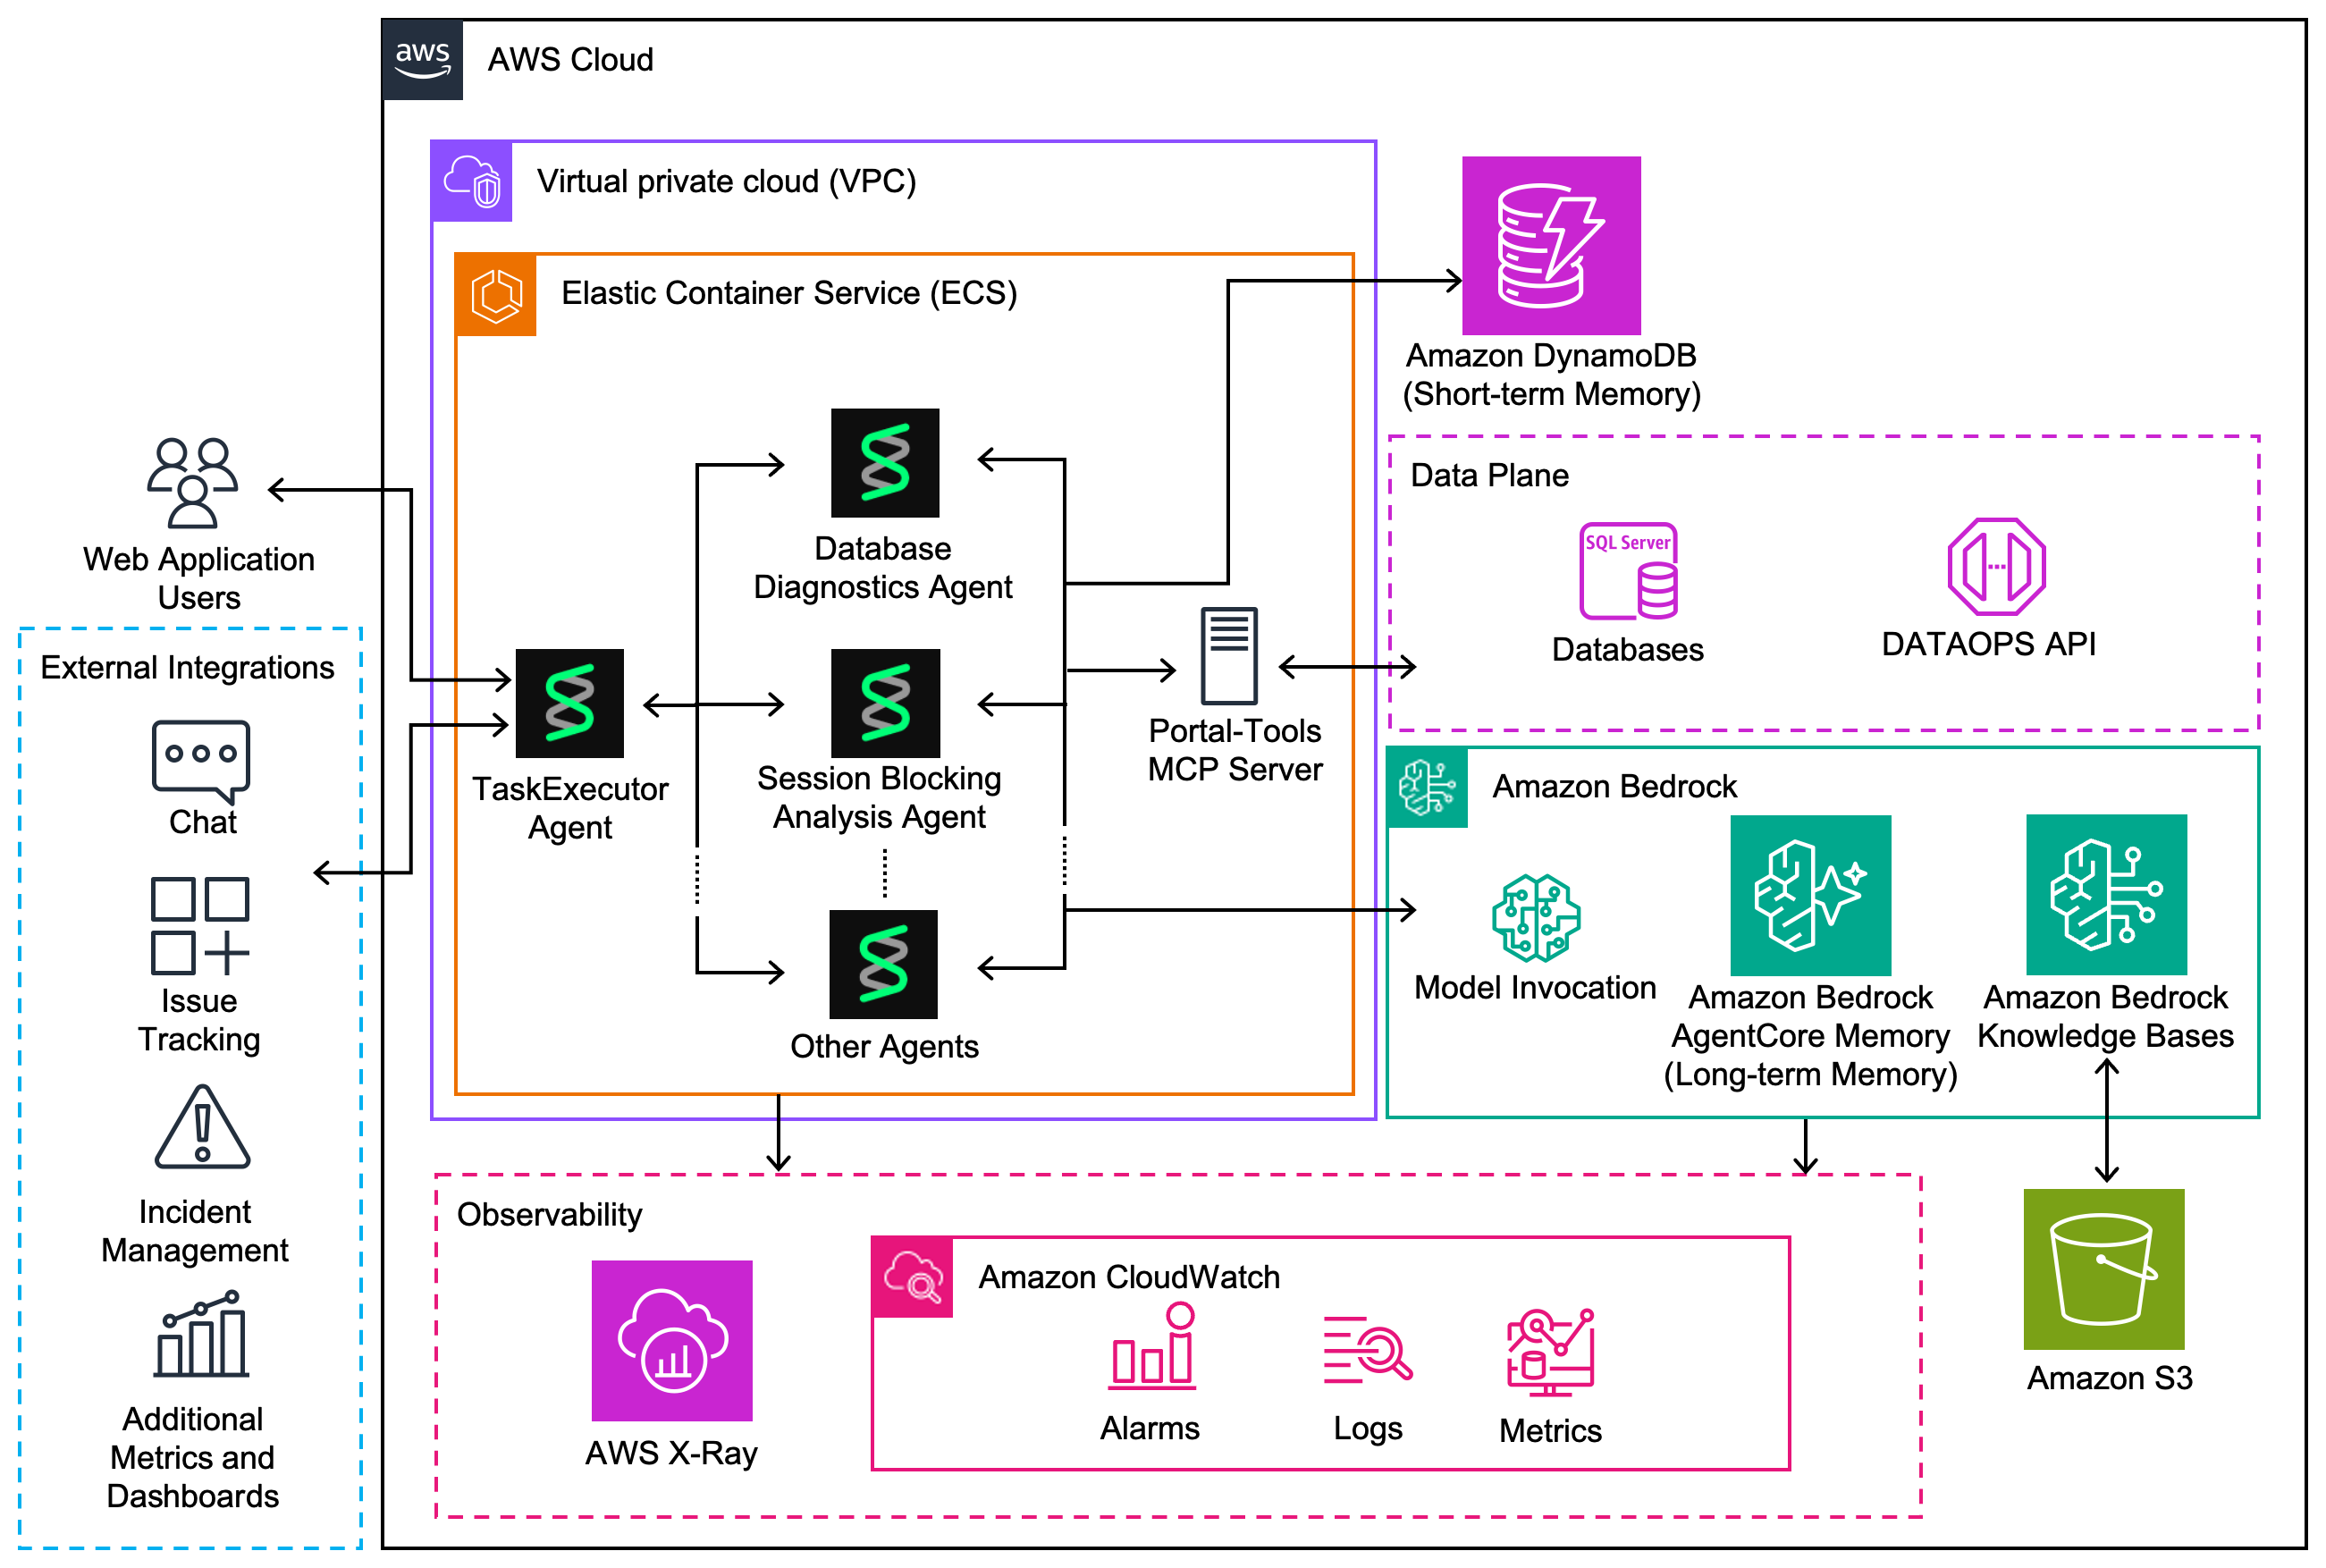
Figure 1 : Architecture d'Orion AI : un méta-orchestrateur sur Amazon ECS achemine les requêtes vers des agents spécialisés, qui accèdent aux sources de données via un serveur Portal-Tools MCP et utilisent Amazon Bedrock pour les modèles, la mémoire à long terme et la génération augmentée par récupération
Analyse approfondie de l'architecture
Les principes de conception précédents se concrétisent dans l'architecture. Le reste de cette section présente les composants fondamentaux d'Orion AI.
Construction du motif hub-and-spoke avec Strands Agents
Orion AI exprime sa topologie avec quelques primitives Strands Agents. Le Agent class est le bloc de construction pour les agents spécialistes ainsi que pour le méta-orchestrateur. Les outils de chaque agent sont de simples fonctions Python marquées avec le décorateur @tool . Celui-ci dérive la spécification d'un outil à partir des annotations de type et de la docstring de la fonction, ce qui signifie qu'il n'y a aucun schéma distinct à maintenir. BedrockModel encapsule le modèle Amazon Bedrock sur lequel chaque agent s'exécute, et MCPClient connecte les agents à des serveurs d'outils externes.
La topologie :
- Le hub est un seul agent Strands agissant comme méta-orchestrateur (le TaskExecutor). Il ne possède aucun outil de domaine — uniquement des outils de routage (
find_relevant_agents,call_agent) et des outils de contrôle de flux (emit_plan_step,emit_confirmation_gate) afin de pouvoir raisonner sur une requête étape par étape. - Les rayons sont des instances
Agentindépendantes, chargées paresseusement via un registre basé sur des décorateurs. Chacune possède son propre modèle, ses outils de domaine et son prompt système localisé.
À l'exécution, le hub invoque un spécialiste par nom via l'outil call_agent enregistré. Chaque spécialiste exécute sa propre boucle d'appel d'outils et renvoie un texte synthétisé au hub, qui assemble la réponse finale.
Routage hybride
Orion AI utilise un routage d'abord par mots-clés avec une solution de repli par recherche sémantique. Environ 80 pour cent des requêtes sont résolues via un chemin rapide en mémoire par mots-clés en moins d'une milliseconde. Lorsque les mots-clés ne suffisent pas à déterminer l'intention, le système revient à une recherche sémantique propulsée par Amazon Titan Text Embeddings V2 pour router selon le sens. Pour la disponibilité des modèles par Région AWS, consultez Supported models by AWS Region in Amazon Bedrock.
Lorsque l'invocation directe d'outils n'est pas appropriée, une chaîne de repli s'active : Amazon Bedrock Knowledge Bases, la capacité entièrement gérée de génération augmentée par récupération (RAG), récupère la documentation opérationnelle afin que les réponses s'appuient sur des procédures approuvées plutôt que d'être générées sans contexte.
Les agents spécifiques à un domaine et leurs limites
Orion AI utilise 13 agents spécifiques à un domaine. Les trois agents SQL Server illustrent la manière dont le découpage par domaine correspond aux étapes d'une véritable investigation :
- L'agent de diagnostics de base de données met en évidence les chaînes de blocage, les types d'attente et les requêtes longues, puis traduit les constats techniques en impact métier avec des recommandations de remédiation. Il répond à la question : « que se passe-t-il et qu'est-ce que cela signifie ».
- L'agent d'analyse de blocage de sessions mène des investigations en plusieurs étapes avec des modèles de raisonnement pour rattacher les chaînes de blocage à un bloqueur racine. Il répond à la question : « pourquoi cela se produit-il et quelle en est la cause racine », en fournissant des recommandations priorisées allant de la terminaison immédiate de la session à des correctifs architecturaux à plus long terme.
- L'agent de diagnostics SQL en temps réel interroge directement les instances SQL Server via l'API DATAOPS de Cornerstone pour obtenir des données de blocage en direct et analyser les sessions à forte consommation de CPU. Il répond à la question : « qu'est-ce qui est vrai en ce moment ».
Les autres agents suivent le même principe de périmètre restreint : surveillance de l'infrastructure, analytique opérationnelle, gestion du cycle de vie des bases de données, analytique client, récupération de connaissances depuis les runbooks, routage des notifications, décomposition des requêtes composées, résolution des écouteurs de groupes de disponibilité (Availability Group) et préchauffage des connexions aux modèles.
Intégration des outils et connectivité aux services
Orion AI accède aux sources de données selon deux modèles :
- Model Context Protocol (MCP) pour les outils partagés par plusieurs agents (par exemple, les diagnostics SQL en temps réel). Un appel de fonction Strands
@tooleffectue un appelMCPClientvia HTTP diffusable (streamable HTTP) vers un serveur Portal-Tools MCP, qui accède à SQL Server et à l'API DATAOPS. L'intégration de Jira suit la même approche via les outils MCP Atlassian externes. - Appels directs du SDK ou de l'API REST pour les sources qui n'ont pas besoin de l'interface MCP partagée. Cela inclut les métriques et tableaux de bord, les plannings d'astreinte et Amazon Bedrock Knowledge Bases via AWS SDK for Python (Boto3).
Cette répartition signifie que chaque agent utilise le mécanisme le plus léger adapté à sa source, tandis que le serveur MCP centralise les outils partagés par plusieurs agents. Ces connexions s'effectuent via TLS, et les informations d'identification telles que le jeton MCP et l'autorisation de l'API REST sont fournies à chaque requête, et non intégrées dans le code des agents.
Mémoire conversationnelle
Amazon Bedrock AgentCore, une plateforme pour créer, connecter et optimiser des agents à grande échelle avec n'importe quel framework ou modèle, fournit la couche de mémoire inter-sessions. Orion AI coordonne le contexte via un gestionnaire de mémoire central qui lit en parallèle dans trois niveaux, chacun disposant de son propre délai d'attente et de sa propre allocation de jetons.
Orion AI coordonne le contexte à travers trois niveaux. La mémoire à court terme conserve le contexte de la session en cours dans Amazon DynamoDB, chiffré au repos par défaut, associé à un résumé glissant de la conversation que Amazon Nova 2 Lite génère de manière asynchrone. La mémoire à long terme assure le rappel inter-sessions via la mémoire AgentCore, une capacité d'Amazon Bedrock AgentCore, organisée en espaces de noms par identifiant utilisateur. À la fin d'une tâche, Orion AI appelle create_event pour déclencher l'extraction, la synthèse et la consolidation automatisées. Un troisième niveau, la mémoire inter-agents, est un bloc-notes éphémère en mémoire qui transmet les constats entre les étapes des sous-agents au sein d'une même tâche.
Le gestionnaire de mémoire effectue des récupérations à travers les niveaux avec un délai maximal strict de 500 millisecondes pour un budget de 4,000 tokens, appuyé par un cache selon la stratégie least-recently-used (moins récemment utilisé). Lorsqu'une requête concerne l'état actuel du système, les agents contournent complètement la mémoire et lisent les données en direct, de sorte qu'un contexte obsolète ne contamine pas les diagnostics en temps réel.
IA responsable et garde-fous
Comme la sécurité DataOps dépend de règles spécifiques au domaine, telles que les opérations de base de données perturbatrices, l'équipe a construit une logique de garde-fous personnalisée plutôt que de s'appuyer sur des filtres de contenu génériques. Orion AI applique des contrôles à quatre niveaux :
- Contraintes de sécurité au niveau du prompt injectées dans le prompt système de chaque agent, bloquant les recommandations dangereuses (par exemple, terminer des processus de base de données critiques) et imposant des méthodes non perturbatrices.
- Une porte de confirmation humaine dans la boucle qui suspend les opérations destructives jusqu'à ce que l'utilisateur confirme dans un délai de cinq minutes, avec un refus par défaut en cas d'expiration.
- Modules de garde-fous personnalisés pour la validation des entrées (limites de longueur, blocage des injections de prompt et SQL), l'assainissement des sorties (censure des secrets et des informations personnellement identifiables), la limitation du débit, le contrôle d'accès basé sur les rôles et le suivi des coûts par requête.
- Protection au niveau du routage qui empêche de répondre aux requêtes opérationnelles à partir de la mémoire, forçant l'exécution d'outils en direct pour les questions sur l'état actuel.
Observabilité
Orion AI utilise les services d'observabilité AWS standards pour la surveillance et le débogage. Amazon CloudWatch fournit des métriques et une journalisation structurée pour la confiance de routage, la latence et l'activité d'invocation des agents. AWS X-Ray trace les appels distribués à travers les exécutions d'agents pour une visibilité de bout en bout du chemin des requêtes.
Enseignements tirés
Les décisions de conception qui ont rendu Orion AI possible sont réutilisables. La répartition des agents par domaine a permis à chaque agent d'intégrer des outils ciblés sans alourdir le contexte d'un modèle unique. L'utilisation du routage par mots-clés par défaut, avec la recherche sémantique comme solution de repli, a maintenu une latence faible sans sacrifier la précision sur les requêtes ambiguës. La limitation de la mémoire conversationnelle aux sessions, tout en la contournant pour les métriques en temps réel, a garanti la fiabilité des diagnostics en temps réel.
L'équipe a également fait des choix d'infrastructure pragmatiques. Elle a déployé le calcul sur Amazon ECS car Amazon Bedrock AgentCore runtime, une capacité d'Amazon Bedrock AgentCore, n'était pas disponible au début du projet, et l'équipe l'évalue désormais comme une option de migration future. Si vous construisez aujourd'hui, pesez le même arbitrage pour votre propre pile : commencez par ce qui est stable et disponible actuellement, et revenez à la question à mesure que les capacités gérées mûrissent.
Conclusion
Orion AI a réduit le diagnostic de base de données de 45 minutes à 10, évité 70 pour cent des étapes manuelles du cycle de vie et réduit le bruit des alertes de 65 pour cent. Une équipe de trois personnes l'a livré en six mois sur Amazon Bedrock. Les schémas à l'origine de ces résultats sont adoptables par d'autres équipes d'exploitation : des agents à périmètre de domaine, un routage hybride, et une mémoire limitée aux sessions avec un contournement pour les métriques en temps réel.
Pour démarrer avec l'orchestration multi-agents sur AWS, consultez les conseils de l'AWS Solutions Library.