
En construisant une IA ancrée sur Amazon Bedrock, Qlik Answers s'attaque à un problème d'entreprise courant : les employés ne manquent pas de données. Ils manquent d'un moyen rapide de poser une vraie question sur ces données et d'obtenir une réponse à laquelle ils peuvent se fier. Les analystes passent des heures à fouiller des documents, des tableaux de bord et la mémoire institutionnelle pour répondre à des questions qu'un collègue pourrait formuler en une phrase. Et lorsque les organisations tentent de combler ce fossé avec l'IA générative, beaucoup se heurtent au même mur : des réponses sans sources, aucun moyen de vérifier un résultat et aucune voie de déploiement de l'outil dans un environnement réglementé.
Qlik, leader mondial de l'intégration de données, de la qualité des données, de l'analytique et de l'IA, a construit Qlik Answers pour résoudre ce problème pour ses plus de 40,000 clients dans le monde. Depuis sa disponibilité générale en février 2026, Qlik Answers est passé d'une capacité naissante à un usage quotidien : le Discovery Agent de Qlik, un agent de détection d'anomalies et de valeurs aberrantes piloté par l'IA, a à lui seul mis en évidence plus de 100,000 découvertes pour les clients depuis son lancement, et la majorité des comptes Qlik Cloud disposant d'outils agentiques activés les utilisent activement.
Cet article explique comment Qlik a construit l'outil derrière cette adoption, et comment Amazon Bedrock le soutient à l'échelle mondiale.
Défi
Qlik a identifié trois problèmes qu'il devait résoudre simultanément pour mettre Qlik Answers en production dans l'ensemble de sa clientèle :
- Orchestrer un raisonnement spécialisé sans ralentir personne. Les questions d'entreprise varient largement : certaines nécessitent une recherche rapide, d'autres exigent de puiser dans l'analytique structurée, des documents non structurés, des définitions de glossaire ou des automatisations. Un assistant unique et polyvalent a tendance à devenir plus lent et moins précis à mesure que des capacités y sont ajoutées.
- Répondre aux exigences de souveraineté des données entre Régions. Qlik sert des clients en Europe, en Asie-Pacifique et dans les Amériques, chacun ayant ses propres attentes en matière de résidence des données. Un modèle de déploiement mondial unique ne satisfaisait pas à ces exigences, mais 11 constructions Régionales distinctes seraient difficiles à maintenir et à améliorer de manière cohérente.
- Prévoir la capacité des modèles des mois avant la demande. La consommation de jetons et la disponibilité des modèles devaient être planifiées 3 à 6 mois avant les lancements majeurs. Qlik a ensuite validé ces projections par rapport à l'utilisation réelle une fois que les clients ont commencé à utiliser le produit, afin que la croissance de l'adoption ne se transforme pas en problème de capacité.
Aperçu de la solution
Qlik Answers offre aux employés, et pas seulement aux analystes, un lieu unique pour poser une question en langage naturel et recevoir une réponse ancrée et sourcée. Selon la question, cette réponse peut provenir d'une base de connaissances, d'une application d'analytique en direct, d'une définition de glossaire ou d'un document. Le système sous-jacent décide du chemin à emprunter.
Trois déploiements illustrent ce que cela représente pour les clients :
- Bystronic, spécialiste mondial de la transformation de tôle, a déployé un chatbot IA en 15 minutes, offrant aux employés un moyen d'interroger les données opérationnelles en temps réel et d'obtenir des réponses sourcées entre les départements.
- Lintech International a indexé plus de 17,000 documents techniques dans Qlik Answers, réduisant le temps de recherche manuelle et accélérant les délais de réponse de 75 pour cent, ce qui a rendu aux gestionnaires jusqu'à 7 heures par semaine.
- TouchPoint Support Services, qui dessert 650 sites de santé et vise à doubler de taille, utilise Qlik Answers pour fournir des conseils rapides et conformes à 15,000 employés travaillant dans des environnements réglementés et au rythme soutenu.
Pour soutenir cela à grande échelle, Qlik a construit le système autour de frontières architecturales claires plutôt qu'un seul grand assistant. Les couches clés sont les suivantes :
- Couche d'entrée. Un point d'entrée conversationnel stable au sein de Qlik Cloud, afin que de nouvelles capacités backend puissent être ajoutées sans modifier la façon dont les clients interagissent avec l'assistant.
- Couche de routage. Une couche légère qui lit le message de l'utilisateur et le contexte de la conversation et décide où la requête doit aller. Sa seule mission est une décision de routage rapide et précise, pas la résolution de la tâche elle-même.
- Couche de réponse. Coordonne la génération de réponses une fois qu'une requête est routée, en choisissant entre une voie rapide pour les requêtes simples et une voie plus délibérée qui décompose une question en sous-questions et puise dans plusieurs sources.
- Couche d'agents spécialisés. Un moteur d'essaim (swarm runtime) partagé définit le fonctionnement des agents spécialisés, des outils, de l'état et des étapes avec intervention humaine, de sorte que de nouveaux spécialistes peuvent être ajoutés sans que chacun ait à inventer son propre modèle d'orchestration.
- Couche d'analytique conversationnelle. Traite les questions portant sur des données structurées en les acheminant vers un chemin de raisonnement adapté à l'application, conçu pour l'analytique plutôt que pour la génération de texte générale.
- Couche de récupération. L'indexation et la récupération de documents non structurés s'exécutent sur Amazon OpenSearch Service, qui stocke et recherche le contenu qui fonde les réponses de Qlik Answers aux questions portant sur la base de connaissances et les documents.
- Couche d'accès aux modèles. Accessible via la passerelle de grands modèles de langage (LLM) propre à Qlik, cette couche se connecte à Amazon Bedrock pour le chat, le streaming, les embeddings et le reranking. Elle applique également Amazon Bedrock Guardrails à chaque requête et à chaque réponse : filtrage de contenu contre l'injection de prompts, les informations personnelles identifiables (PII), les secrets et les sujets interdits, plus une vérification de validation d'ancrage sur les réponses générées. Lorsqu'un modèle sur lequel un client compte n'est pas encore disponible dans la Région via Bedrock, Qlik l'héberge sur Amazon SageMaker AI à la place, puis ramène cette charge de travail vers Bedrock une fois que la disponibilité Régionale a rattrapé son retard. Pour la disponibilité des modèles par Région AWS, consultez Supported models by AWS Region dans Amazon Bedrock.
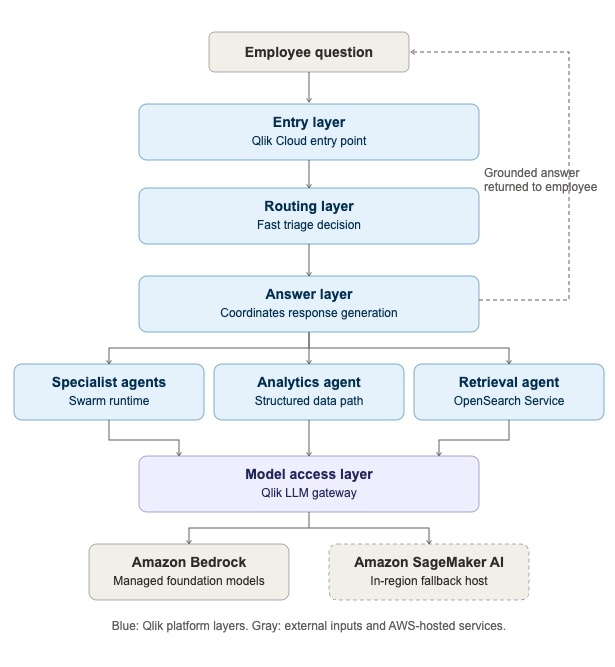
Figure 1 : les questions des employés traversent les couches d'entrée, de routage et de réponse, puis se ramifient vers les agents spécialistes, l'agent d'analytique et l'agent de récupération (adossé à Amazon OpenSearch Service), avant de converger vers la couche d'accès aux modèles, qui rejoint les modèles de fondation disponibles sur Amazon Bedrock, avec Amazon SageMaker AI comme solution de repli dans la Région
Ancrer les réponses dans des sources réelles
L'ancrage a été l'une des décisions de conception les plus importantes du framework. La couche de réponse puise dans plusieurs types de contexte selon la question : métadonnées d'application structurées, contenu récupéré de la base de connaissances, définitions du glossaire, contexte d'automatisation et contenu de documents pour la synthèse. Une fois les éléments d'une réponse complète renvoyés, la réponse intégrale est assemblée et présentée à l'utilisateur.
La récupération seule ne garantit pas l'exactitude. Qlik exécute également une vérification de validation d'ancrage sur les réponses générées, en comparant chacune au contenu source dont elle est issue, grâce à la capacité de contextual grounding d'Amazon Bedrock Guardrails. Cela transforme l'ancrage d'une simple étape de récupération en un contrôle de production vérifié. Pour les questions non structurées, l'outil récupère un contenu spécifique à la question depuis Amazon OpenSearch Service et conserve ce contexte afin que la réponse finale inclue des citations. Pour les questions structurées, il confie le travail au chemin d'analytique conversationnelle. D'autres fonctionnalités, notamment la consultation du glossaire, les automatisations et la synthèse de documents, sont déployées avec des contrôles de capacités, permettant ainsi à Qlik d'étendre ce que l'outil peut faire sans déstabiliser d'un coup l'expérience par défaut de chaque client. Les options de capacités propres à chaque tenant permettent à Qlik de reconstruire le chemin d'orchestration disponible pour chaque requête, afin que les capacités puissent être activées de manière sélective tandis que l'architecture globale reste cohérente entre les clients.
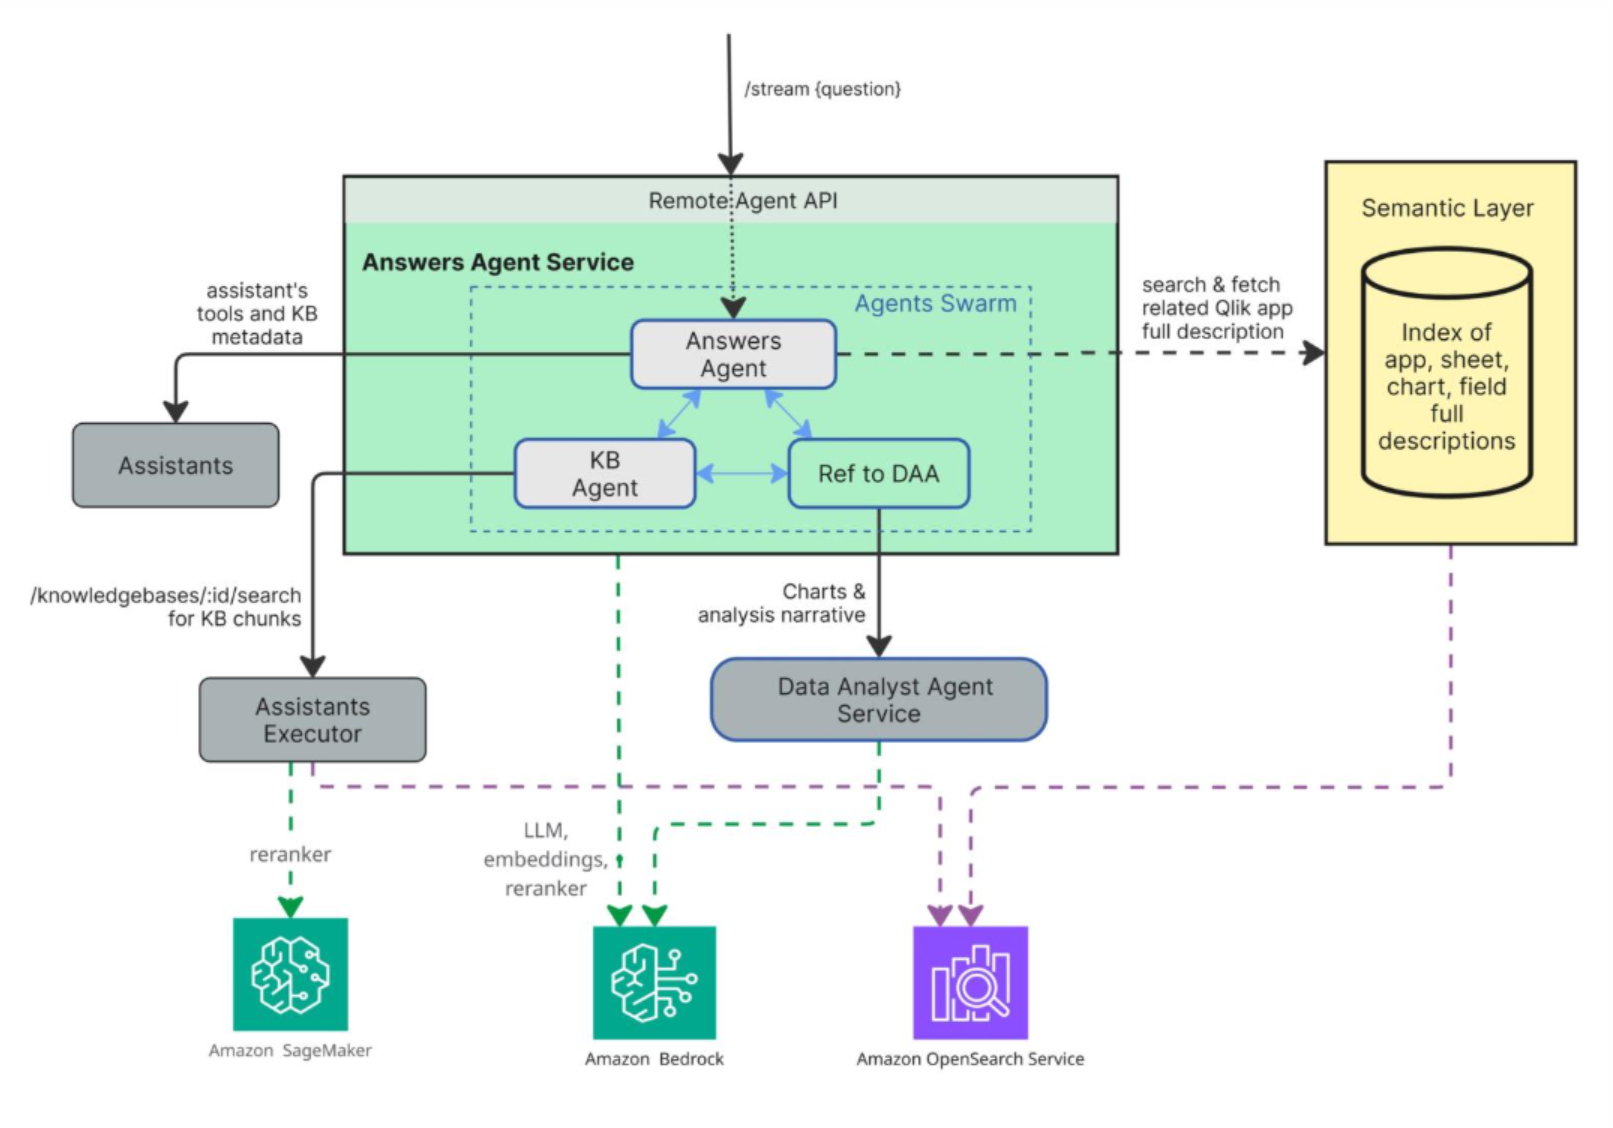
Figure 2 : l'essaim d'agents spécialistes, où l'état partagé, les outils et les étapes humaines dans la boucle permettent à de nouveaux agents spécialistes de se raccorder à un runtime commun
Pourquoi Amazon Bedrock
Qlik a évalué sa stratégie de modèles au regard des trois problèmes décrits précédemment, et Amazon Bedrock a répondu directement à chacun d'eux.
Flexibilité multi-modèles. Avec Bedrock, Qlik peut assigner le modèle le mieux adapté à la tâche de chaque agent au lieu de verrouiller tout le système sur les compromis d'un seul modèle.
Souveraineté des données à grande échelle. Avec l'inférence inter-Régions d'Amazon Bedrock (CRIS), Qlik peut servir les 11 Régions tout en maintenant les données résidentes là où la conformité l'exige. Cela combine portée mondiale et contrôles de souveraineté en une seule capacité gérée.
Marge pour adopter des services gérés de manière sélective. Le modèle de déploiement Régional d'AWS et les options de réservation de capacité donnent à Qlik la marge nécessaire pour continuer à évoluer aujourd'hui. Au moment voulu, des services comme Amazon Bedrock AgentCore offrent à Qlik la possibilité de déléguer davantage de la charge opérationnelle pour des charges de travail spécifiques, sans exiger une migration complète pour y parvenir.
Qlik utilise Bedrock via sa propre passerelle LLM plutôt que de lier la logique applicative directement à un seul modèle. Les équipes produit peuvent changer le choix du modèle par tâche sans réécrire l'application environnante. Cette séparation est importante pour un système dont la stratégie de modèles est appelée à continuer d'évoluer.
Planifier la capacité en amont de la demande
Comme Qlik prévoit la capacité des modèles 3 à 6 mois avant les lancements majeurs, l'équipe a construit un modèle de travail pour projeter la consommation de tokens par fonctionnalité et par Région, puis a vérifié l'utilisation réelle par rapport à ces projections après chaque déploiement. Cette discipline fait partie des raisons pour lesquelles la disponibilité générale de février a pu évoluer sans souffrir de sa propre adoption.
Résultats commerciaux et impact client
Depuis la disponibilité générale de février 2026 de l'expérience agentique de Qlik, Discovery Agent a fait émerger plus de 100,000 découvertes pour les clients, et la majorité des comptes Qlik Cloud avec les outils agentiques activés utilisent activement leurs agents au lieu de les essayer une fois puis de s'arrêter.
Les résultats au niveau client rapportés séparément incluent les temps de réponse réduits de 75 % de Lintech International et jusqu'à 7 heures par semaine restituées aux responsables métier, et le déploiement d'un chatbot en 15 minutes chez Bystronic.
Leçons apprises
La construction et la mise à l'échelle de Qlik Answers auprès de plus de 40,000 clients ont fait émerger quelques leçons qui pourraient aider d'autres équipes à créer des outils agentiques sur Bedrock :
- Séparer tôt le routage rapide du raisonnement approfondi. Les regrouper signifie que chaque requête paie pour plus de traitement qu'elle n'en a besoin.
- Standardiser sur un seul framework d'orchestration pour l'exécution multi-agents plutôt que de laisser chaque nouveau spécialiste inventer son propre runtime. Il est plus facile d'exploiter une application qu'un ensemble de systèmes d'agents déconnectés.
- Traitez les contrôles de sécurité et de grounding comme un verrou au niveau du système, et non comme une réflexion après coup propre à chaque fonctionnalité. Les exécuter une seule fois, au niveau de la couche d'accès au modèle, signifie que chaque nouvel agent spécialisé hérite automatiquement des mêmes protections.
- Utilisez des feature flags au niveau du tenant pour déployer progressivement les capacités. Cela évite que des capacités nouvelles et moins éprouvées n'affectent la fiabilité de l'expérience principale.
- Prenez l'habitude de prévoir la capacité avant d'en avoir besoin. Valider l'utilisation projetée par rapport à l'utilisation réelle après chaque lancement, c'est ce qui transforme la planification de capacité en un processus répétable plutôt qu'en devinettes.
Et maintenant
La feuille de route de Qlik maintient délibérément l'architecture ouverte et adaptable. L'équipe évalue Amazon Bedrock AgentCore pour certaines charges de travail où un runtime agentique géré réduirait la charge opérationnelle, tout en continuant à s'appuyer sur les standards ouverts et sa propre couche d'orchestration lorsque cela donne à Qlik plus de contrôle sur le coût, la latence ou la portabilité. L'objectif est de conserver la possibilité d'adopter des services gérés lorsqu'ils sont utiles, sans concevoir le cadre autour d'un seul d'entre eux. Qlik élabore également un cadre systématique pour évaluer les performances des modèles. Cela permet à Qlik de passer à des modèles mieux adaptés dès qu'ils deviennent disponibles, sans perturber l'expérience sur laquelle les clients comptent déjà.
Conclusion
L'adoption de Qlik Answers depuis son lancement en février 2026 reflète une architecture conçue pour rester en retrait : rapide là où la vitesse compte, délibérée là où la précision compte, ancrée dans des sources réelles à chaque étape, et suffisamment sûre pour que les industries réglementées puissent s'y fier. La flexibilité des modèles, les contrôles de souveraineté régionale et le filtrage de contenu ainsi que la validation du grounding basés sur les Guardrails dans Amazon Bedrock ont donné à Qlik une fondation pour construire cette expérience à l'échelle mondiale. Le résultat à ce jour comprend plus de 100,000 découvertes mises en évidence, des heures restituées aux employés d'entreprises comme Lintech et TouchPoint, et une majorité de comptes ayant activé les outils agentiques qui continuent d'utiliser leurs agents après les avoir essayés.
Pour découvrir ce que Qlik Answers peut faire avec vos données, commencez un essai gratuit de Qlik Cloud Analytics, demandez une démonstration de Qlik Answers ou une démonstration Qlik et AWS, ou visitez la page produit de Qlik Answers pour en savoir plus.