
En un coup d’œil
- Agentic RL exploité : Microsoft Research Asia introduit un paradigme de formation dans lequel l’agent de déploiement identique est directement impliqué dans l’apprentissage par renforcement, éliminant ainsi la nécessité de réimplémenter l’agent au sein du cadre de formation.
- Léger par conception : Agent Lightning v1.0 fournit un plan de contrôle complet pour l’agent RL en environ 3 500 lignes de code.
- Soutien natif à Kubernetes : les agents s’exécutent en tant que tâches standard Kubernetes sur des clusters gérés par l’utilisateur, des services Kubernetes en cloud ou une infrastructure locale, sans dépendre de services de sandboks commerciaux payants.
- Recette de formation efficace en termes de données : un pipeline d’agent de codage en continu a permis à Qwen3.5-9B de passer de 41,8 % à 56,4 % Pass@1 sur SWE-bench Verified, soit une augmentation de 14,6 points, en utilisant seulement environ 6 000 échantillons de formation basés sur un jeu de données open source.
Les agents IA ont évolué de simples modèles à des systèmes complets complexes composés de modèles, d’outils et d’environnements d’exécution. Leurs capacités dépendent de plus en plus du système qui les coordonne depuis l’extérieur du modèle. L’apprentissage par renforcement (RL) est une méthode par laquelle les systèmes IA apprennent par essais et erreurs, guidés par des récompenses et des punitions pour leurs actions. Le RL peut améliorer ces agents, mais la plupart des systèmes de RL d’agents nécessitent que les développeurs réimplémentent l’agent dans le cadre de formation. Cela est coûteux, et cela signifie que l’agent formé n’est pas exactement l’agent qui sera déployé.
Pour résoudre ce problème, des chercheurs de Microsoft Research Asia ont introduit le paradigme d’entraînement de RL agentique Harnessed, et ont ouvert le code du Agent Lightning v1.0 (s’ouvre dans une nouvelle fenêtre). Par rapport à la version originale, Agent Lightning v1.0 met davantage l’accent sur la légèreté, sur l’intégration avec des harnais réels, et sur un pipeline complet et reproductible d’entraînement de RL pour agents.
Agent Lightning v1.0 a été reconstruit sur la base de Harnessed Agentic RL, avec des améliorations clés :
- Léger : l’ensemble du framework compte environ 3 500 lignes de code. Agent Lightning v1.0 implémente un système complet de RL agentique Harnessed, dans un code source suffisamment petit et clair pour être compris, modifié et étendu.
- Formation sur un harnais d’agent réel : les agents atteignent le modèle via le proxy du grand modèle de langage (LLM) dans Agent Lightning v1.0, sans modifier le code existant du harnais.
- Support natif pour Kubernetes : les agents s’exécutent directement en tant que tâches Kubernetes, sans besoin de services de sandboks commerciaux externes. Les clusters gérés par l’utilisateur et l’infrastructure locale peuvent également supporter des déploiements à grande échelle.
- Un exemple complet de formation pour un agent de codage : une pipeline intégrée basée sur Qwen3.5-9B a augmenté le score Pass@1 sur SWE-bench Verified de 41,8 % à 56,4 %, soit une augmentation absolue de 14,6 points, en utilisant seulement environ 6 000 échantillons d'entraînement.
Les limites de l’RL agentique traditionnelle
Le RL agentique traditionnel suppose que le cadre de formation contrôle l’itération d’interaction avec l’environnement. Dans un cycle de type ReAct, le modèle génère une action, l’environnement renvoie une observation, cette observation est ajoutée au contexte, et le modèle génère la prochaine action ; ainsi, tout le processus se déroule sur une trajectoire de token continue. Les systèmes de RL précédents tels que verl, AReaL et slime ont été construits de cette manière, ce qui signifie que l’entraînement d’un agent nécessitait la reconstruction de son cycle au sein du cadre de RL.
Les harnais réels ont dépassé cette hypothèse. Les agents de codage tels que mini-SWE-agent, OpenHands, OpenCode, Claude Code et Codex offrent chacun leur propre gestion de contexte, protocoles d’outils, logique d’exécution et dépendances, tout comme les systèmes d’agents polyvalents. Reconstruire un agent pour l’entraînement est coûteux, et l’agent reconstruit peut ne plus se comporter de la même manière que l’agent déployé.
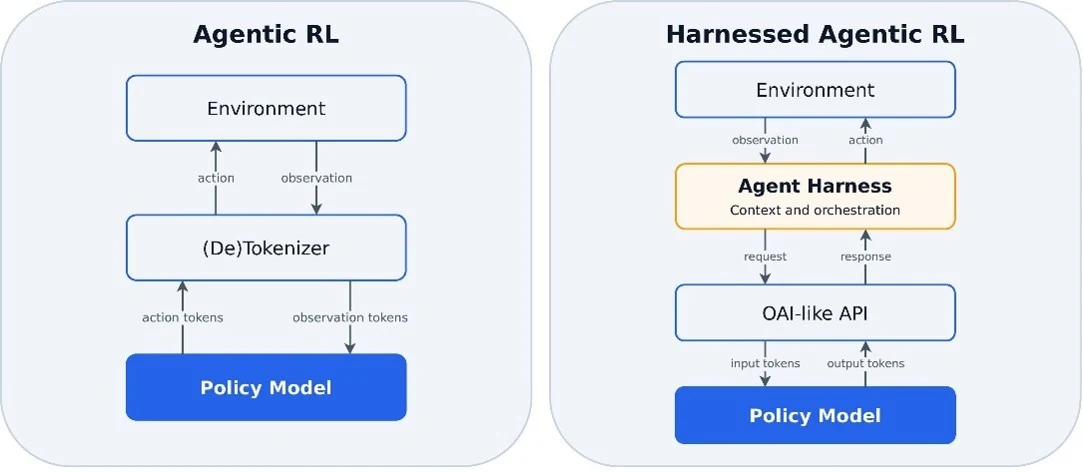
L’agent Lightning emprunte une autre voie. Il place un proxy LLM entre l’agent et le modèle. L’agent continue à fonctionner comme avant : il suffit de diriger l’endpoint qui avait précédemment appelé l’API du modèle vers Agent Lightning, et le framework de formation peut observer et enregistrer ses appels au modèle. Dans la version 1.0, les chercheurs vont plus loin et définissent officiellement ce paradigme comme Agentic RL harnaché : le harnais utilisé lors de la déploiement est celui qui participe directement à l'apprentissage par renforcement pendant l'entraînement (Figure 1).
Quatre défis dans l'entraînement avec des harnais réels
Une différence fondamentale entre l’agentic RL Harnessed et l’agentic RL traditionnel est que le cycle d’interaction avec l’environnement est géré par l’harness agentique plutôt que par le cadre de formation. Le système de formation ne peut observer qu’une série de paires de demande et réponse issue d’un LLM, de sorte qu’une seule expérience peut être divisée en un nombre variable d’échantillons de formation. Cela soulève quatre défis clés :
- Retokenisation et fusion des échantillons : Les harnais conservent le contexte en tant que texte, mais l’entraînement par RL nécessite les IDs de tokens extraits pendant la déploiement. Le passage du texte à travers le modèle de chat et le tokenizer peut modifier les frontières des tokens, de sorte que les appels adjacents ne peuvent pas toujours être fusionnés en un seul échantillon.
- Calcul des avantages : La retokenisation, les sous-agentes et la synthèse du contexte peuvent diviser une mise en œuvre en plusieurs échantillons. Le calcul des bases de données et des avantages directement au niveau de l’échantillon entraîne des mises en œuvre qui produisent davantage d’échantillons, ce qui modifie les relations statistiques originales au niveau de la mise en œuvre.
- Normalisation de la perte : L’évaluation de la perte par nombre d’échantillons accorde plus de poids aux exercices qui produisent plus d’échantillons. Comme le nombre d’échantillons est souvent simplement un produit du comportement du harnais, la normalisation de la perte doit également éviter d’être altérée par celui-ci.
- Formation de la planification du backend : Le nombre et la longueur des échantillons ne sont connus qu’après que le harnais soit terminé, tandis que les comptages GPU et les configurations parallèles de données/tensors sont généralement fixes. Le backend doit transformer un charge de travail variable en ressources fixes.
Spotlight : bulletin de recherche Microsoft
Bulletin de recherche de Microsoft
Abonnez-vous dès maintenantConstruire un plan de contrôle RL pour un agent complet avec 3 500 lignes de code
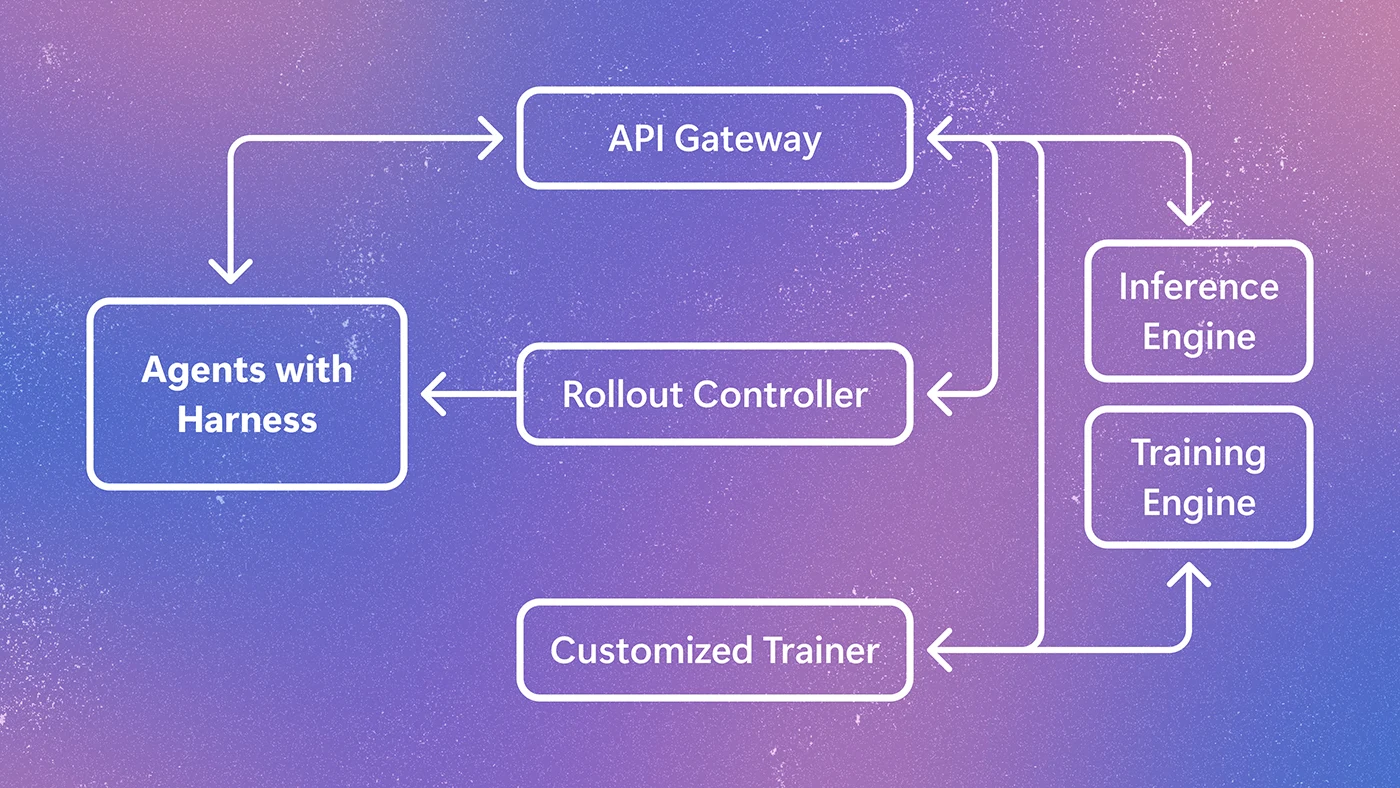
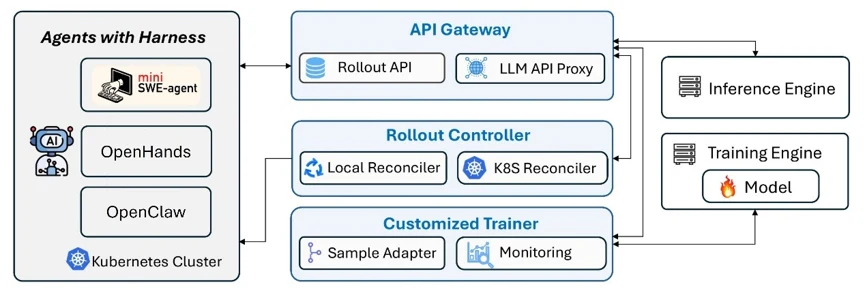
Dans la conception de système, Agent Lightning v1.0 considère la simplicité comme son principe fondamental. L’ensemble du framework comprend environ 3 500 lignes de code, et se compose de trois composants principaux : le API Gateway, le Rollout Controller et le Customized Trainer (Figure 2).
Le gateway API stocke les déploiements, les modèles et les événements, et fonctionne en tant que proxy pour un LLM compatible avec OpenAI. Il relie chaque appel de modèle du harnes à son déploiement et enregistre les prompts, les réponses et les probabilités de journalisation nécessaires pour l’entraînement. Le contrôleur de déploiement initie et gère l’exécution des agents, que ce soit en tant que processus locaux ou en tant que tâches standard Kubernetes, en maintenant l’exécution des agents indépendante du entraîneur. Le entraîneur personnalisé, construit sur Verl, crée les déploiements, attend qu’ils soient terminés, collecte les échantillons et assemble les échantillons d’entraînement finaux via un adaptateur d’échantillon. Par conséquent, pour un harnais d’agent existant, il suffit de pointer l’endpoint du modèle vers le proxy Agent Lightning pour se connecter rapidement à l’entraînement par RL.
Colocalisé RL asynchrone
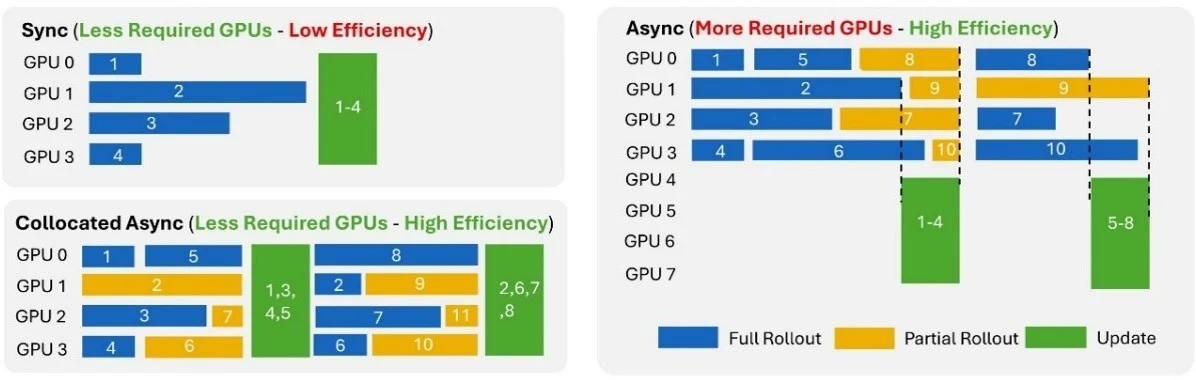
Les temps de déploiement varient grandement entre les agents. Le RL synchrone attend l’agent le plus lent dans un lot et laisse les GPU inutilisés, tandis que le RL asynchrone complet augmente l’utilisation des GPU mais nécessite des pools de GPU distincts pour le déploiement et l’entraînement. En réponse, Agent Lightning v1.0 introduit le RL asynchrone collocalisé, qui permet aux déploiements et aux mises à jour du modèle de partager les mêmes GPU.
Une fois que le système a collecté suffisamment de données de déploiement, l’actualisation commence : le API Gateway cesse d’accepter de nouvelles requêtes et attend que les requêtes en cours se terminent, puis le déploiement reprend après la fin de l’actualisation. Tout le processus de transition d’état est transparent pour l’agent externe. Dans les expériences, cette approche a permis une accélération de vitesse d’environ 2x par rapport au RL synchrone, tout en utilisant moins de GPU que le RL asynchrone conventionnel (Figure 3).
Exécuter des agents sur Kubernetes
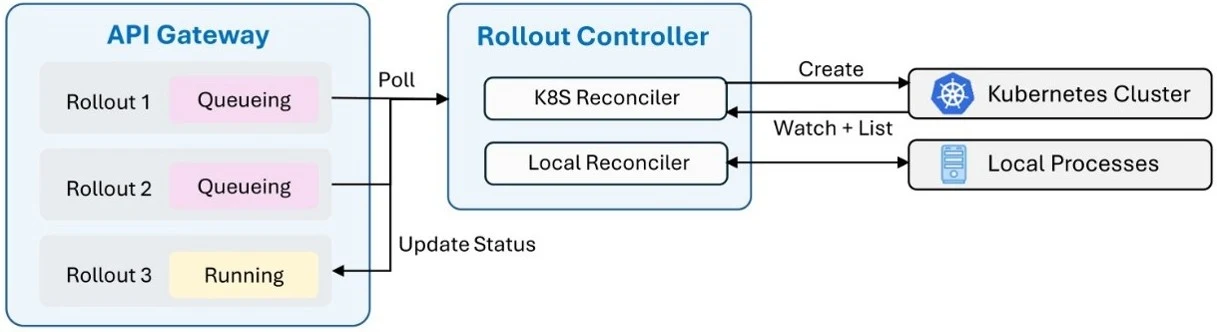
Collecter suffisamment de déploiements signifie exécuter de nombreux agents en même temps, ce qui consomme une grande quantité de CPU, de mémoire et de ressources de calcul. D’autres frameworks d’agentique RL utilisés pour Harnessed hébergent souvent ces agents sur des services de sandbox commerciaux tels que Modal Sandbox ou E2B, où les coûts augmentent rapidement avec l’augmentation de la taille. En revanche, Agent Lightning v1.0 les exécute en tant que tâches standard Kubernetes, réutilisant les clusters auto-gérés existants, le cloud Kubernetes ou l’infrastructure locale (Figure 4). Les ressources informatiques existantes sont utilisées de manière plus efficace, les déploiements importants sont moins coûteux, et l’ensemble du pipeline reste open source et reproductible.
6 000 échantillons d’entraînement, une amélioration de performance de 14,6 points
Pour tester cette approche, les chercheurs ont construit une chaîne de processus complète utilisant SWE-smith, mini-SWE-agent et Qwen3.5-9B, incluant le nettoyage des données, la construction de l’environnement, les mesures de sécurité pour le hacking des récompenses et l’entraînement par RL. Le jeu de données d’entraînement comprend environ 6 000 échantillons et ne nécessite pas de calculs à grande échelle. Seul l’entraînement par RL a permis à Qwen3.5-9B de passer de 41,8 % à 56,4 % sur SWE-bench Verified, soit une augmentation de 14,6 points de pourcentage.
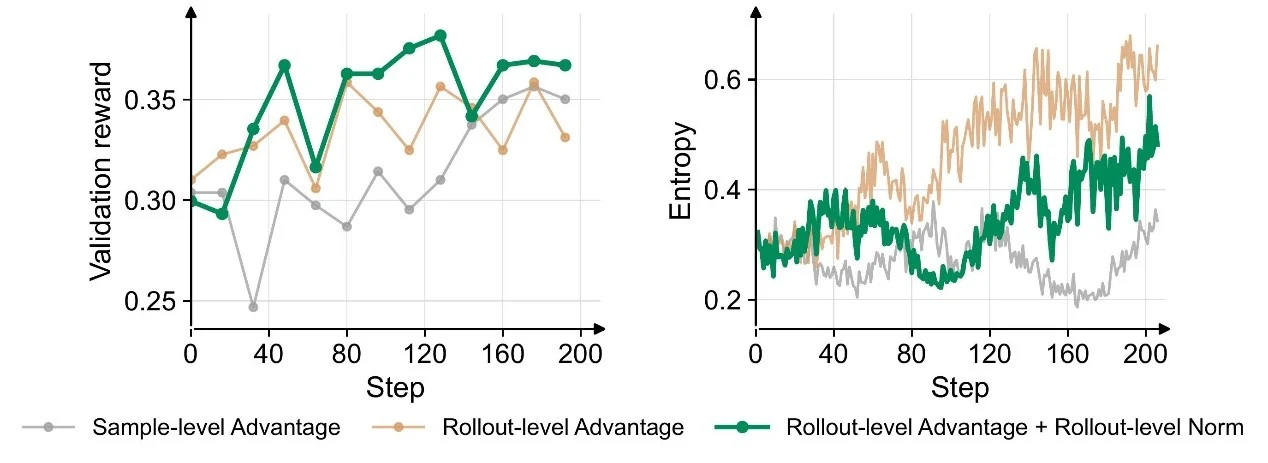
Les expériences supplémentaires menées par l’agent de codage confirment l’analyse antérieure concernant deux défis : le calcul des avantages et la normalisation des pertes. Par rapport à la gestion au niveau des échantillons, l’avantage au niveau du déploiement combiné avec la normalisation au niveau du déploiement permet d’obtenir une récompense de validation plus élevée et maintient l’entropie de la politique plus stable pendant l’entraînement (Figure 5).
La publication Agent Lightning v1.0 : Un framework RL agentique léger de 3 500 lignes pour la formation d’agents avec des harnais réels a été publiée en premier sur Microsoft Research.