
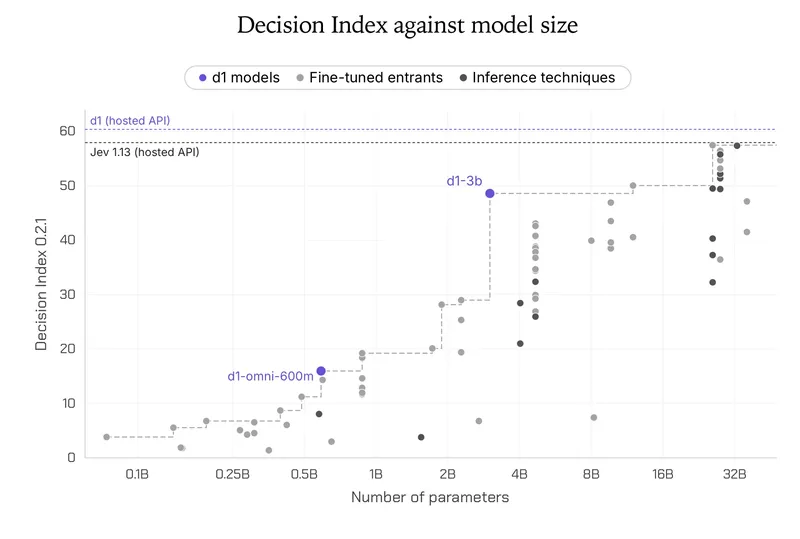
Aujourd’hui, nous publions deux modèles de décision ouverts dans notre famille de modèles de décision d1: d1-3B et d1-omni-600M (expérimental).
- Meilleur modèle de décision sous 10B sur le Decision Index 0.2.1 : d1-3B obtient 48.57, devant tous les modèles 4B et 9B et devant Decider 35B-A3B (47.11).
- Multimodal : d1-3B prend en charge le texte et les images, tandis que d1-omni-600M prend en charge le texte et les images ou le texte et l’audio
- Rapide : d1-3B répond à une question en 16 ms sur un NVIDIA Jetson AGX Thor, en 26 ms sur un Jetson AGX Orin et en 50 ms sur un Jetson Orin Nano
Comment nous avons construit des modèles de décision pour l’edge
Ces modèles de décision ouverts d1 sont construits sur nos Liquid Foundation Models (LFMs). Contrairement à nos modèles génératifs, les modèles de décision ne produisent pas de tokens mais répondent en une seule passe avant.
d1-3B et d1-omni-600M sont entraînés à partir de deux backbones très différents :
- d1-3B est entraîné à partir de LFM2.5-VL-3B, notre dernier VLM, qui est de type decoder-only. Il accepte le texte et les images en entrée.
- d1-omni-600M est entraîné à partir de LFM2.5-Encoder-350M, un encodeur bidirectionnel. Il ajoute des encodeurs de vision et d’audio pour gérer les trois modalités. Il accepte soit le texte et l’image, soit le texte et l’audio en entrée. Ce modèle fait actuellement l’objet d’une publication de recherche précoce et est en cours de développement supplémentaire.
Résultats des benchmarks
Nous avons évalué d1-3B et d1-omni-600M sur sept jeux de données publics couvrant la compréhension de lecture, la détection de toxicité, la classification d’intention, le QA médical et la compréhension multilingue. d1-3B obtient un score moyen de 82.9, le plus élevé du tableau et supérieur à Decider 4B. d1-omni-600M obtient 78.4, dépassant Decider 2B (77.1) avec seulement un quart des paramètres.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| Moyenne | 78.4 | 82.9 | 77.1 | 81.1 |
Nous avons validé que d1-3B conserve les capacités visuelles de son backbone LFM2.5-VL-3B sur des benchmarks de vision standards, et que d1-omni-600M gère les trois modalités. Nous ne rapportons aucun benchmark de vision ou d'audio, car le Decision Index v0.3 n'inclut qu'une division de vision privée et les benchmarks de décision audio constituent actuellement un problème ouvert.
Vitesse
En collaboration avec NVIDIA, nous avons évalué d1-3B sur la pile NVIDIA à travers le NVIDIA GeForce RTX 4090, le NVIDIA Jetson AGX Thor, le Jetson AGX Orin 64 GB et le Jetson Orin Nano. Comme d1-omni-600M est une version de recherche précoce, nous ne rapportons aucun chiffre de vitesse pour elle dans cette version.
Inférence en périphérie. d1-3B répond à une seule question en moins de 50 ms sur chaque appareil mesuré. Trois questions ne prennent que 1.3x le temps d'une seule, l'AGX Thor passant de 16 ms à 20 ms.
| Une question | 3 questions | État de 3.4K tokens | image 384px | 64 états, compactés | |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| Jetson AGX Orin 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
Inférence GPU. Sur GPU, d1-3B répond à une question en moins de 10 ms et traite une image 384px en moins de 18 ms sur les deux plateformes.
| Une question | 3 questions | État de 3.4K tokens | image de 384px | 64 états, compactés | |
|---|---|---|---|---|---|
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
Comment utiliser les modèles de décision d1 open source
Optez pour les modèles de décision d1 lorsque vous avez besoin de décisions structurées et rapides, y compris avec des entrées multimodales. d1-3B offre la meilleure qualité de décision à sa taille, tandis que d1-omni-600M convient lorsque l'empreinte compte.
Installez les dépendances (nécessite transformers>=5.14):
pip install "transformers>=5.14" torch torchvision pillow
Ces modèles embarquent leur propre code, chargez-le donc avec trust_remote_code=True:
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
Pour plus de concision, nous n'incluons que l'exemple pour d1-3B. Consultez la fiche du modèle d1-omni-600M pour obtenir les instructions permettant de l'exécuter.
Premiers pas avec les modèles de décision d1 open source
Les deux modèles de décision sont à poids ouverts et disponibles dès aujourd'hui sur Hugging Face :
- Téléchargez : d1-3B et d1-omni-600M sur Hugging Face.
- Essayez : exécutez les démonstrations dans notre System One Arcade Hugging Face Space.
Nous avons hâte de voir ce que vous allez construire.
Citation
Si vous utilisez ce travail, veuillez citer le billet de blog de la version :
@article{liquidAI2026opend1,
  author  = {Liquid AI},
  title   = {Open d1: Edge decision models for text, vision, and audio},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/open-d1},
}