
À retenir
- Planifications créées par l'agent : les agents peuvent configurer des rappels et des tâches récurrentes depuis une conversation.
- Configuration par exécution : un seul déploiement peut choisir son modèle, ses compétences et ses outils pour chaque exécution.
- Réactions Slack : les agents accusent réception des messages avant de répondre.
Aujourd'hui, nous publions Managed Deep Agents v0.9, avec de nouvelles fonctionnalités qui permettent aux agents de planifier eux-mêmes leurs relances, de se reconfigurer à chaque exécution et de réagir aux messages Slack.
Ces mises à jour facilitent la création d'agents internes qui vivent dans Slack ou vos propres canaux et travaillent davantage comme des coéquipiers.
Laisser les agents planifier leur propre travail
Le nouveau SDK Schedules permet aux agents de créer des rappels, des relances et des tâches récurrentes en pleine conversation, afin qu'ils puissent traiter des demandes comme « Rappelle-moi cela demain ».
L'agent crée lui-même la planification au cours d'une conversation, la planification s'exécute en tant que la personne qui l'a demandée, avec ses permissions et connexions, et les résultats reviennent dans le même canal.
Créer une planification depuis une exécution :
await schedules.create(owner={"type": "user"}, cron="0 9 * * 1-5", timezone="America/Los_Angeles", prompt="Write the daily digest.")C'est le plus utile derrière un outil, afin que les utilisateurs de votre agent puissent créer, lister, mettre à jour et supprimer des planifications simplement en discutant. Voici un outil de rappel :
from langchain.tools import tool
from managed_deepagents import schedules

@tool
async def remind_me(prompt: str, cron: str, timezone: str = "UTC") -> str:
    """Run a prompt for the current user on a cron schedule."""
    item = await schedules.create(
        owner={"type": "user"},
        cron=cron,
        timezone=timezone,
        prompt=prompt,
    )
    return f"Created schedule {item['id']}."
L'agent transmet un prompt et une expression cron, et chaque fois que le cron se déclenche, LangSmith démarre une nouvelle exécution avec ce prompt. Les planifications héritent du canal dans lequel elles ont été créées, de sorte que les résultats soient publiés là où la demande est née : un rappel en semaine demandé dans Slack publie un nouveau message dans cette conversation à chaque exécution. Les planifications ponctuelles (at au lieu de cron) répondent dans le fil d'origine, ce qui convient aux relances comme « vérifie ce déploiement dans une heure ».
Configurer les agents par exécution
Un agent peut désormais être configuré dynamiquement par exécution. Configurez l'agent comme une fonction appelable : il reçoit le runtime au début de chaque exécution et renvoie une define_deep_agent définition, en choisissant le modèle, les instructions, les compétences, les serveurs MCP et le sandbox pour cette exécution.
Au lieu de maintenir une quasi-copie du même agent pour chaque équipe ou dépôt, vous exécutez un seul déploiement. Cela permet à votre déploiement de fonctionner plus souplement, un seul déploiement d'agent pouvant être personnalisé pour différentes équipes ou cas d'usage en fonction du contexte, comme le canal ou l'utilisateur à l'origine de la demande.
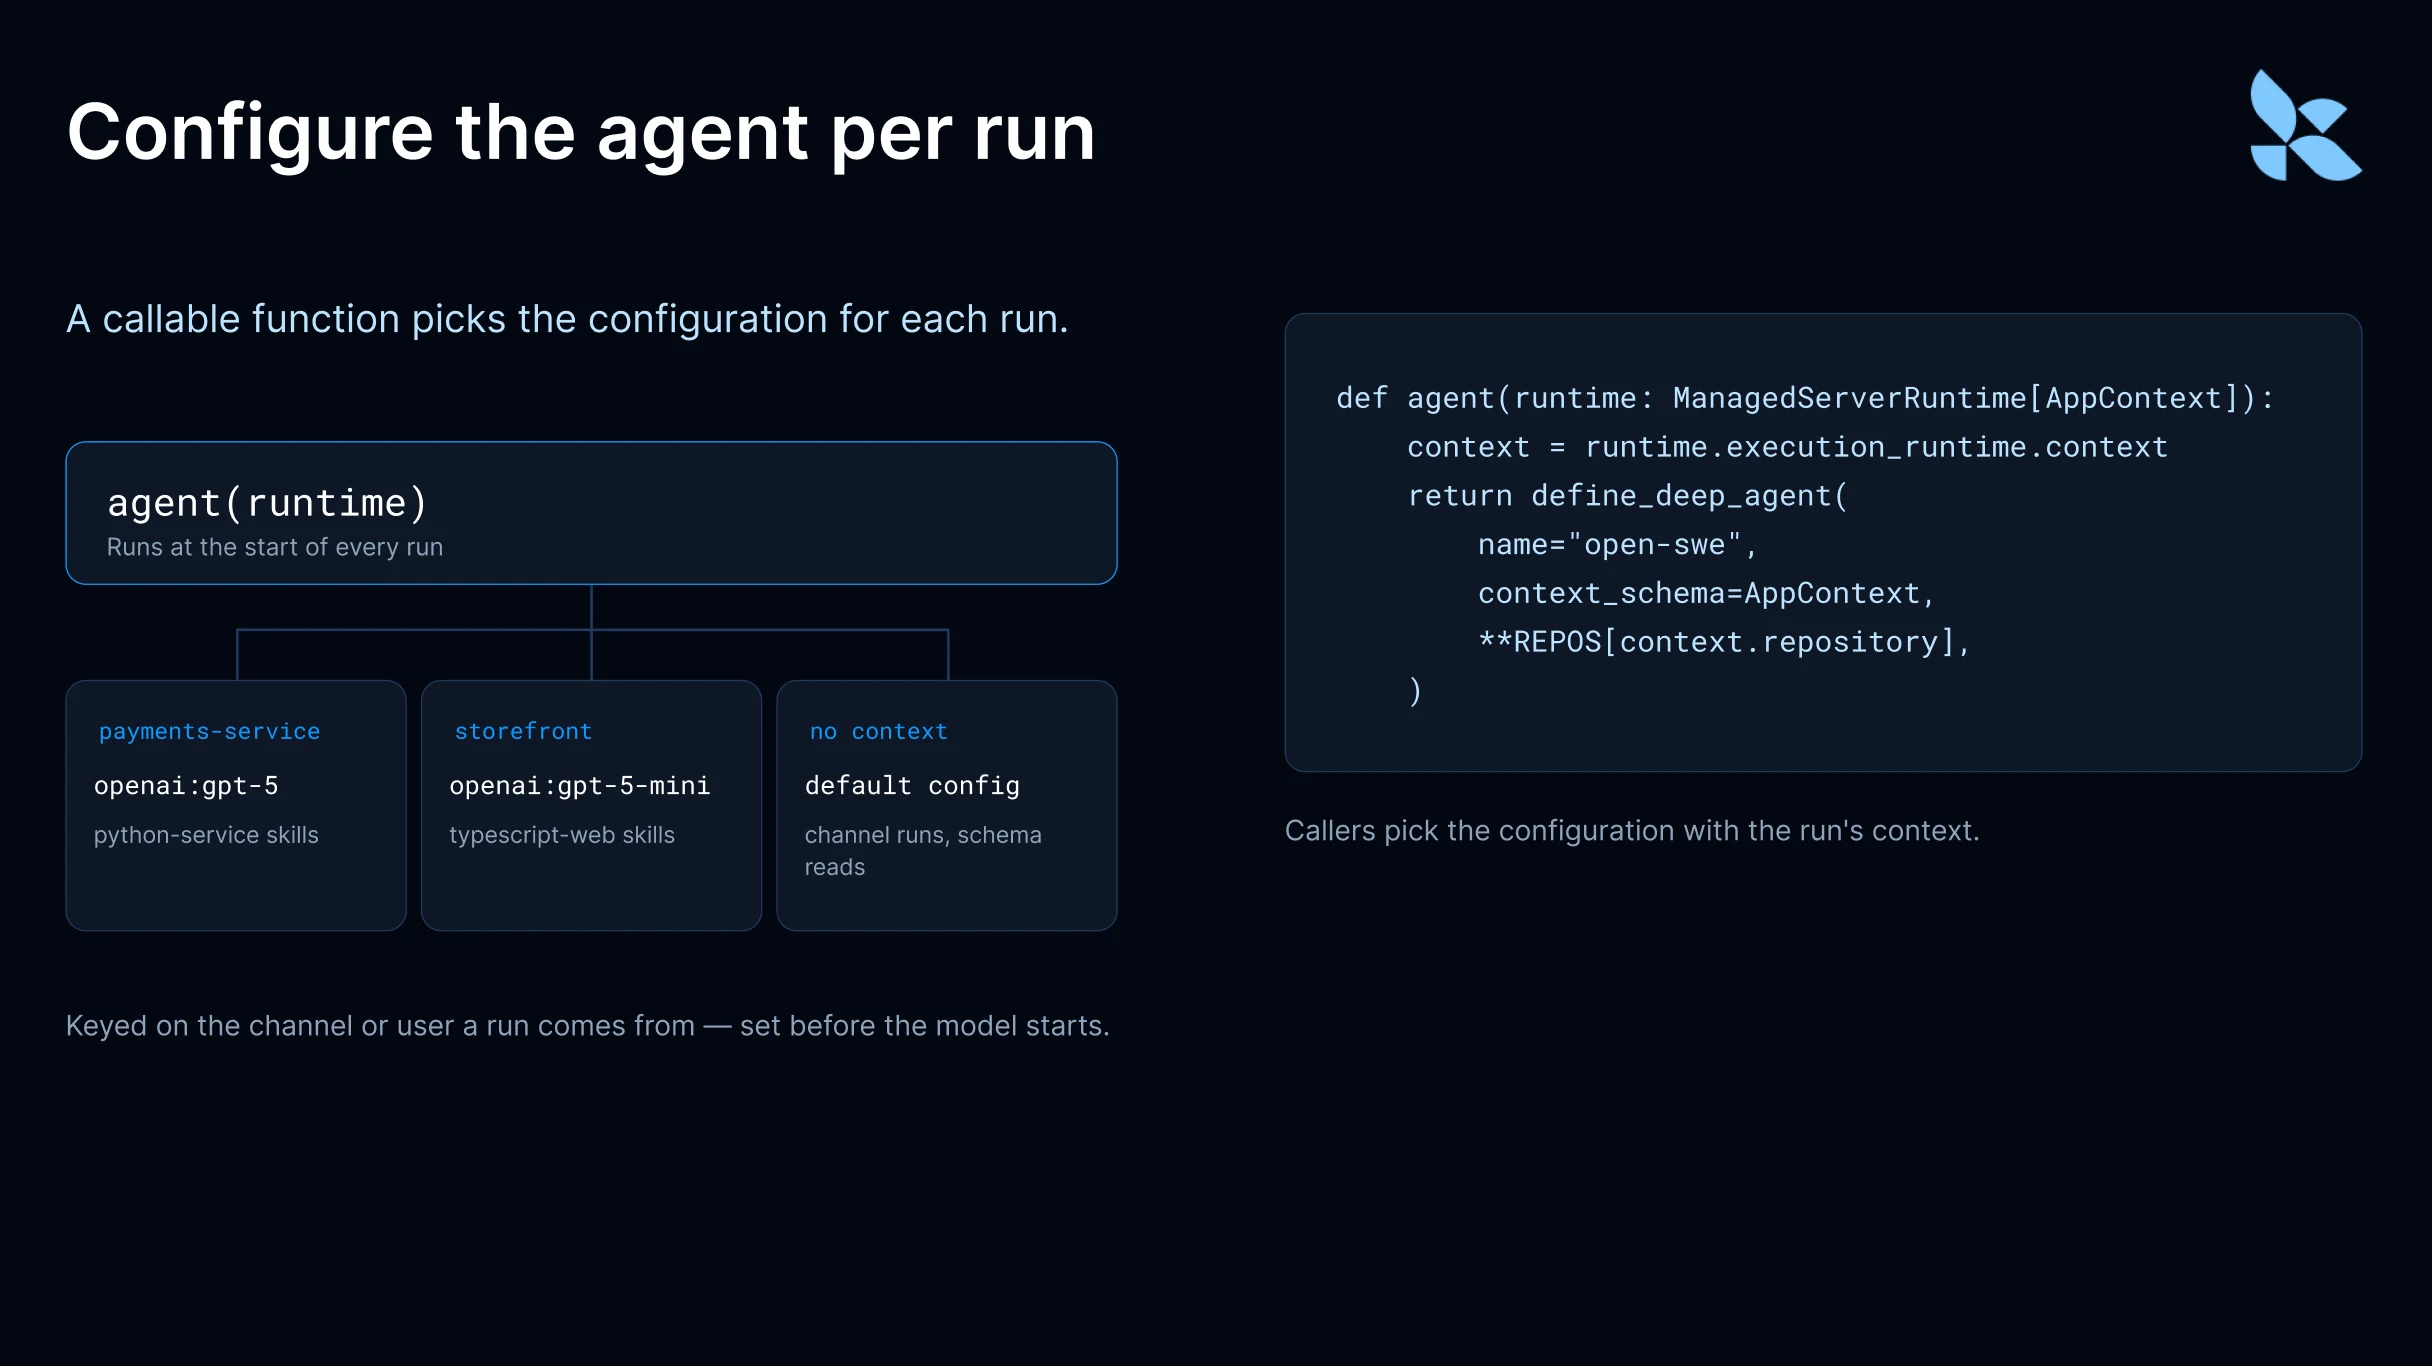
Imaginons qu'un agent Slack interne serve plusieurs équipes. Votre fonction d'agent peut vérifier de quel canal provient une exécution et charger des compétences de facturation pour la finance, ou un serveur MCP de réponse aux incidents pour l'équipe plateforme. C'est différent d'instructions indiquant au modèle quand utiliser une compétence : la configuration est définie avant l'exécution du modèle, de sorte que l'agent ne voit jamais les compétences ni les outils MCP hors de sa configuration. Cela maintient son contexte réduit, sert de double contrôle d'accès et vous permet de choisir le modèle lui-même, ce que le modèle ne peut pas faire.
En général, cela évite les sorties non déterministes lorsque le modèle est chargé de choisir la boîte à outils dans les cas où nous savons exactement quel ensemble d'outils doit être disponible pour l'agent.
La même idée s'applique à un agent de codage qui charge des compétences différentes et un modèle moins coûteux ou plus performant pour chaque dépôt :
# agent.py: one coding agent, configured per repo at the start of each run
from dataclasses import dataclass

from managed_deepagents import ManagedServerRuntime, define_deep_agent

REPOS = {
    "payments-service": {
        "model": "openai:gpt-5",
        "instructions": "Python service. Run pytest before opening a PR.",
        "skills": ["./skills/python-service"],
    },
    "storefront": {
        "model": "openai:gpt-5-mini",
        "instructions": "Next.js app. Run web tests and an a11y check before opening a PR.",
        "skills": ["./skills/typescript-web"],
    },
}


@dataclass
class AppContext:
    repository: str = ""


def agent(runtime: ManagedServerRuntime[AppContext]):
    execution = runtime.execution_runtime
    context = execution.context if execution is not None else None
    repo = context.repository if context is not None else None
    config = REPOS.get(repo, REPOS["storefront"])
    return define_deep_agent(name="open-swe", context_schema=AppContext, **config)
La fonction lit runtime.execution_runtime.context et utilise une valeur par défaut quand il n'y en a pas, comme lors d'exécutions de canal ou quand l'Agent Server charge l'agent pour lire son schéma. Les appelants choisissent la configuration avec le context:
# Same deployment, different repo: just change the run context
await client.runs.create(
    thread_id,
    "open-swe",
    input={"messages": [{"role": "user", "content": "Fix the flaky refund test."}]},
    context={"repository": "payments-service"},
)
Réagir aux messages Slack
Les réactions Slack montrent immédiatement à l'expéditeur que l'agent a pris en charge son message, même lorsqu'il passe un certain temps à raisonner et à appeler des outils avant de répondre. Les réactions sont activées par défaut (👀), et la nouvelle reactions option de votre canal Slack vous permet de les désactiver, de choisir un autre emoji, ou d'en sélectionner un par message. Cet exemple utilise 🐛 lorsqu'un message mentionne quelque chose de cassé, et 👀 sinon :
from managed_deepagents import channels

async def choose_emoji(context: dict) -> str:
    return "bug" if "broken" in context["text"].lower() else "eyes"

channel = channels.slack(name="Support Bot", reactions=choose_emoji)
Les réactions peuvent être simples. Cependant, il est possible de configurer votre réponse de réaction avec une fonction qui appelle un modèle pour choisir un emoji plus précis. Un modèle de décision comme Jev garde cela rapide et peu coûteux ; la documentation du canal Slack présente un exemple complet.
Premiers pas
Managed Deep Agents v0.9 est disponible dès aujourd'hui en bêta publique. Vous pouvez en savoir plus dans la documentation de Managed Deep Agents, ou commencer avec :
uvx --from managed-deepagents mda init my-agent
cd my-agent
uv run mda deployICYMI : la v0.8 a ajouté la mémoire par utilisateur, des canaux HTTP personnalisés pour déclencher des exécutions depuis n'importe quel service, la recherche web intégrée propulsée par Parallel, et plus encore. Lire l'article sur la v0.8.