
Les organisations d'entreprise adoptent le Retrieval Augmented Generation (RAG) pour libérer les informations provenant de sources de connaissances de l'entreprise comme Microsoft SharePoint, Google Drive et Atlassian Confluence. Cependant, ces sources de connaissances contiennent des informations sensibles régies par des structures de permissions complexes. Garantir que les réponses générées par l'IA respectent ces permissions constitue l'un des défis les plus difficiles de l'IA d'entreprise.
Dans cet article, nous explorons comment Amazon Quick et Amazon Bedrock Knowledge Bases résolvent ce défi grâce à l'application en temps réel des listes de contrôle d'accès (ACL), en vérifiant les permissions directement auprès des sources faisant autorité au moment de la requête.
Le problème commercial
Considérons ce scénario : le propriétaire d'un site SharePoint crée une base de connaissances pour son organisation. Des membres d'équipe de plusieurs départements utilisent un assistant IA pour obtenir des réponses à partir de cette base de connaissances. L'exigence essentielle est que chaque membre de l'équipe ne reçoive des informations générées par l'IA qu'à partir des documents qu'il est autorisé à consulter.
Il s'agit d'un défi universel pour les entreprises. Les organisations souhaitent démocratiser l'accès aux informations alimentées par l'IA sans compromettre leur posture de sécurité existante. Un seul document non autorisé apparaissant dans une réponse de l'IA pourrait exposer des documents de stratégie confidentiels, des données financières non publiées ou des informations RH sensibles.
Pourquoi les approches existantes sont insuffisantes
Une approche courante du contrôle d'accès RAG utilise une méthode de réplication et de filtrage pour appliquer les permissions au niveau des documents. Voici comment cela fonctionne généralement :
- Un connecteur de source de données (par exemple, le connecteur SharePoint) récupère les ACL dans le cadre d'une tâche de synchronisation périodique.
- Les ACL sont répliquées depuis la source de données et stockées en tant qu'attributs dans un index.
- Au moment de la requête, le système d'IA associe l'utilisateur connecté aux attributs ACL stockés et filtre les résultats en conséquence.
Bien que cette approche semble raisonnable en apparence, elle présente trois faiblesses fondamentales.
Problème 1 : le système d'IA n'est pas la source de vérité
Dans ce modèle, le système d'IA assume la seule responsabilité de l'application des règles sans être la source faisant autorité des permissions. Cela exige que les connecteurs de données répliquent avec précision une logique ACL complexe et spécifique à chaque source, à travers diverses sources de données. Chaque source de données possède ses propres modèles de permissions uniques. La correspondance des hiérarchies d'héritage, des appartenances aux groupes, des stratégies d'accès conditionnel et des règles de refus à travers des dizaines de connecteurs est une entreprise sujette aux erreurs.
Problème 2 : des permissions obsolètes créent des failles de sécurité
En général, les connecteurs de données prennent en charge des synchronisations basées sur l'extraction, exécutées à la demande ou selon un calendrier défini par le client. Les ACL dans ces solutions d'IA constituent un instantané à un moment donné, celui de la dernière synchronisation exécutée. Certaines solutions utilisent des mises à jour basées sur des événements, mais cela ne fonctionne pas universellement. Par exemple, une source de données comme Confluence n'émet pas d'événement lorsqu'un changement d'appartenance à un groupe se produit. Entre deux synchronisations, un utilisateur dont l'accès a été révoqué pourrait encore recevoir des réponses de l'IA provenant de documents qu'il ne devrait plus consulter.
Problème 3 : l'évolution des capacités des sources de données
Les sources de données modifient régulièrement ou introduisent de nouveaux mécanismes pour contrôler l'accès au contenu. Une nouvelle fonctionnalité de permissions dans SharePoint ou un changement dans le modèle de partage de Google Drive pourrait créer des failles dans la logique de correspondance des ACL. Cela peut exposer du contenu jusqu'à la mise à jour du connecteur.
Comment AWS résout ce problème : application des ACL en temps réel
Pour relever ces défis, nous avons mis en œuvre des vérifications ACL en temps réel comme couche de sécurité supplémentaire, en plus du filtrage ACL pré-extraction existant pour Amazon Quick et Amazon Bedrock Knowledge Bases. Cela garantit que le système applique les contrôles d'accès les plus récents en vérifiant les permissions directement auprès de la source faisant autorité au moment de la requête. Cela évite de dépendre de données ACL potentiellement obsolètes ou incorrectement mappées.
Présentation de l'architecture
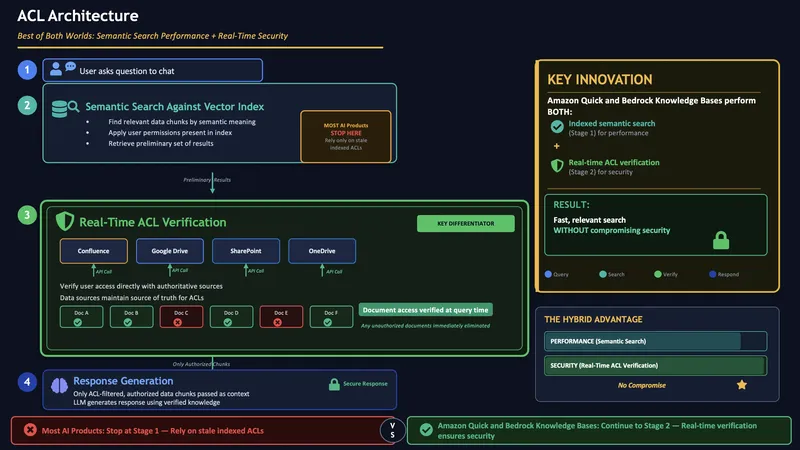
Le schéma suivant illustre notre approche hybride qui offre à la fois des performances de recherche sémantique et des capacités de sécurité en temps réel.
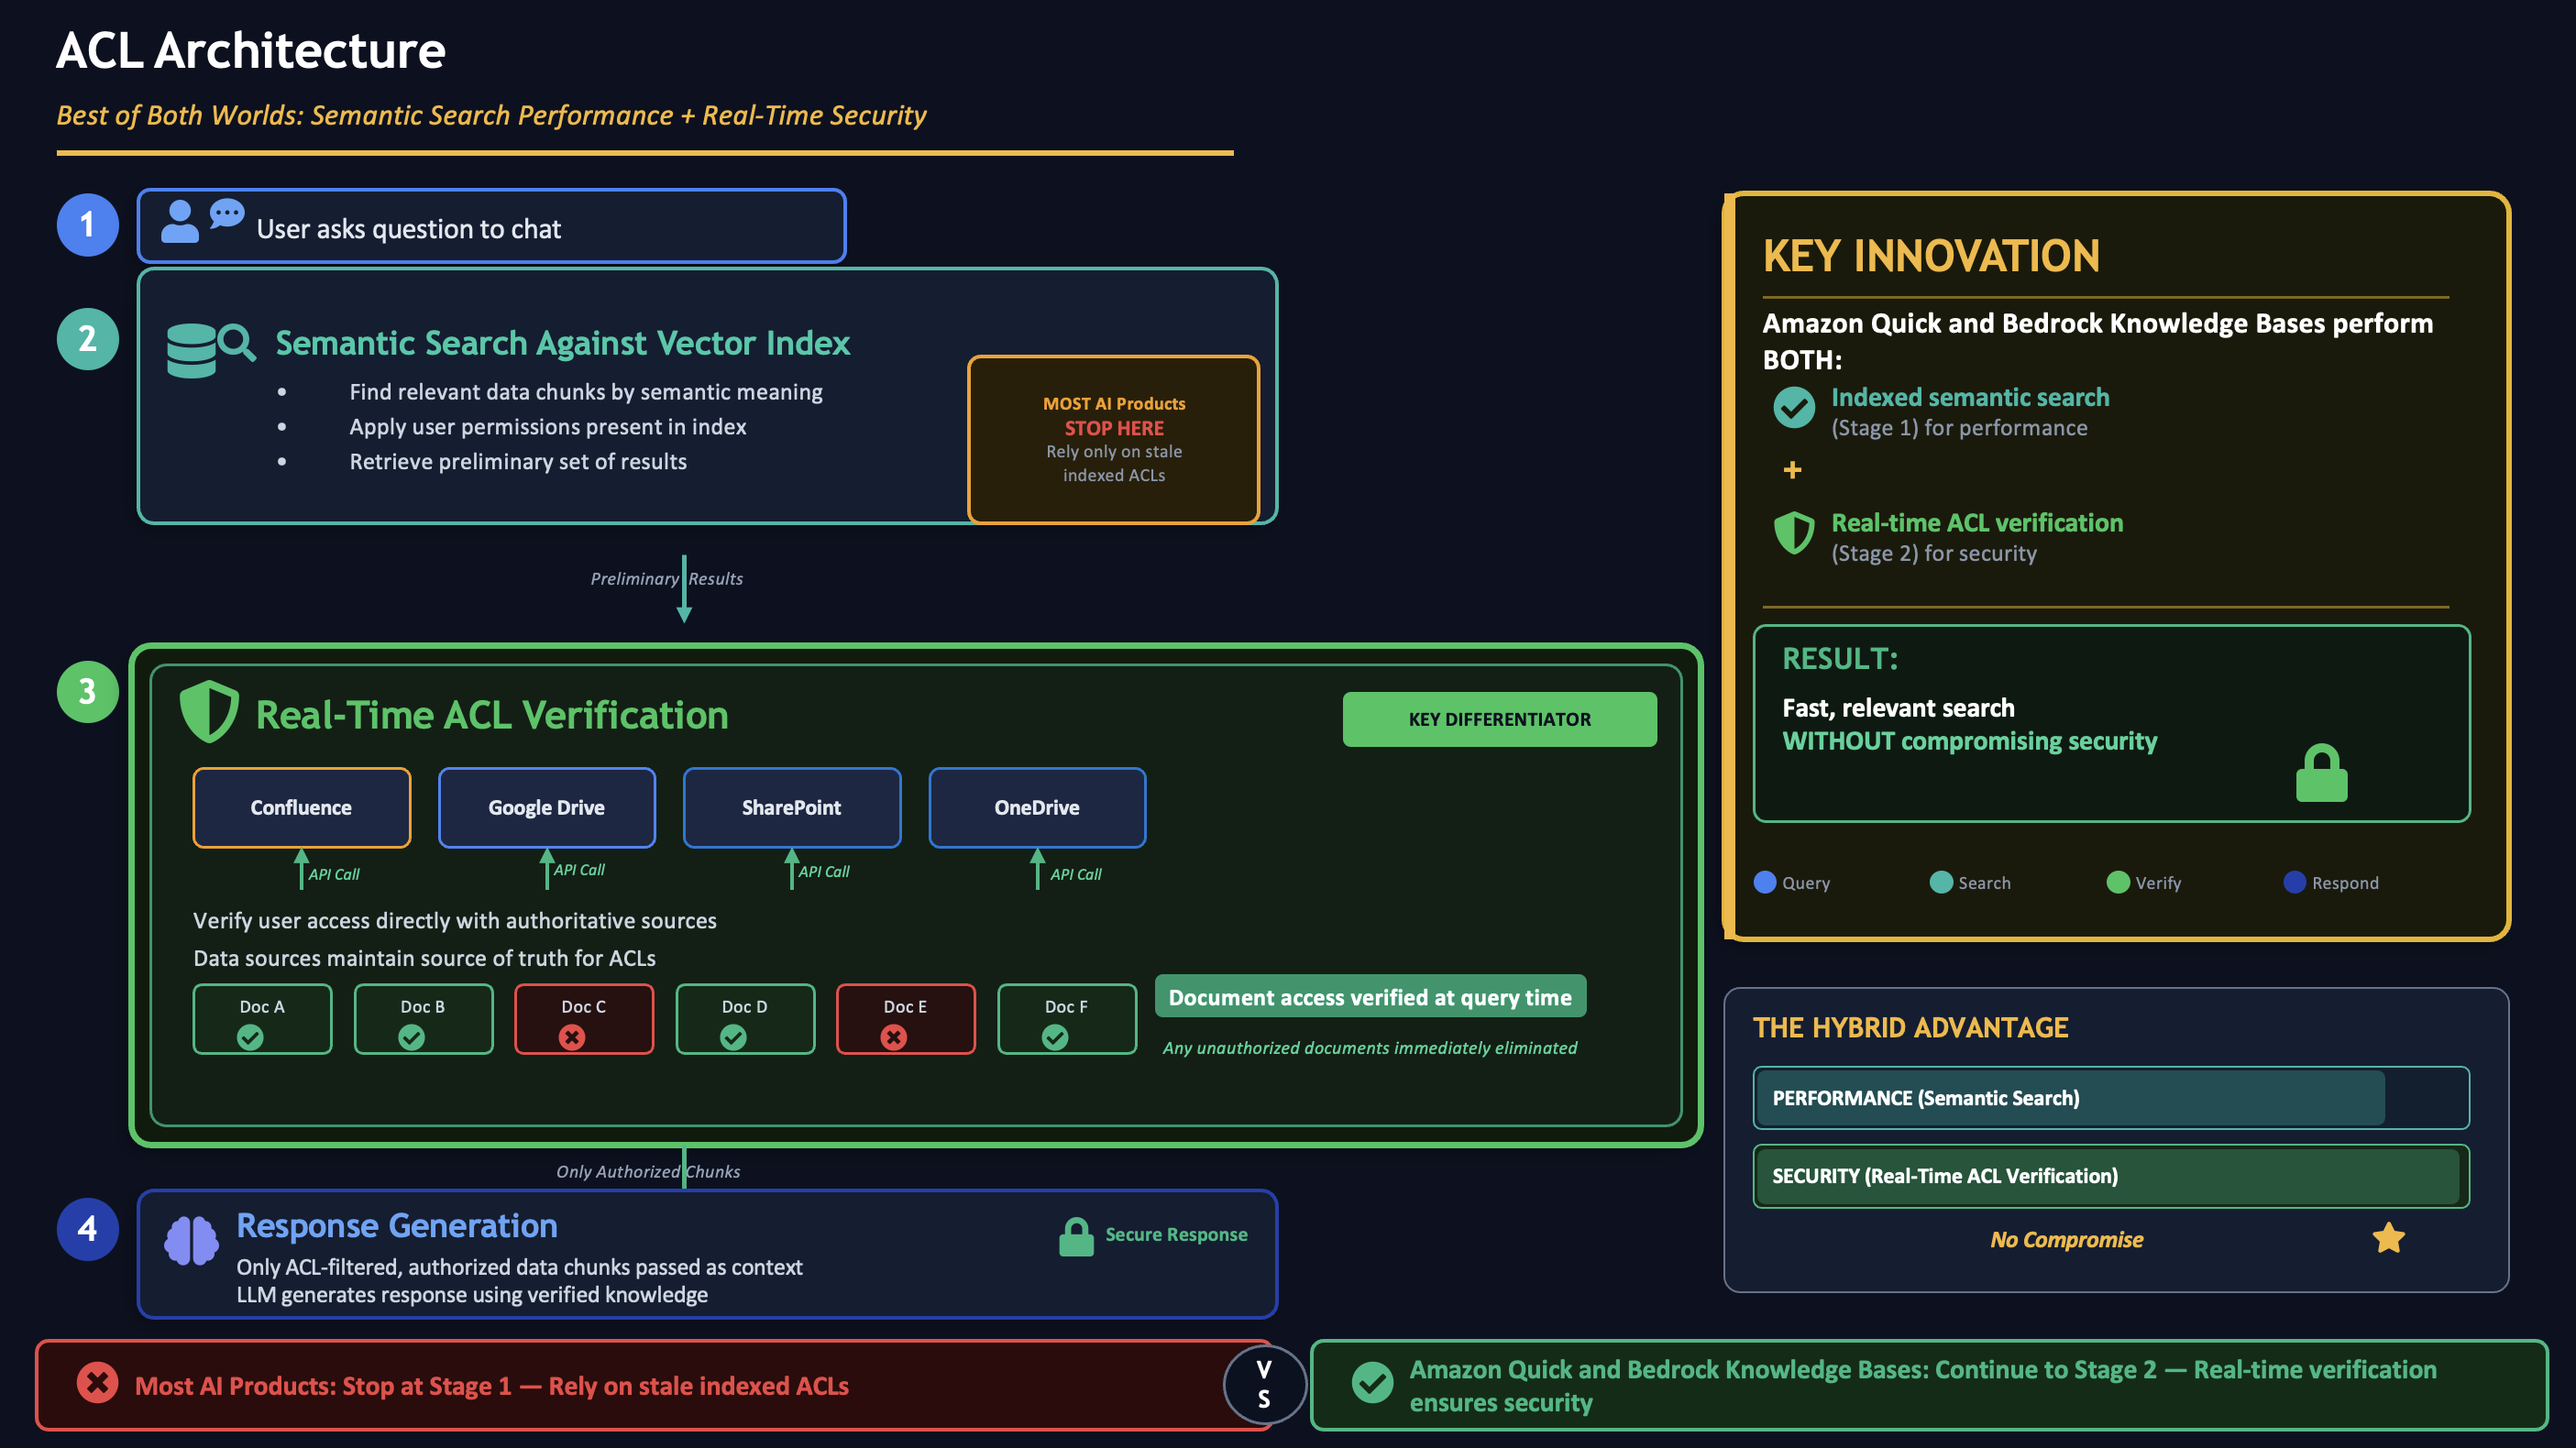
Figure 1 : Architecture d'application des ACL en temps réel pour Amazon Quick et Amazon Bedrock Knowledge Bases, combinant le filtrage pré-extraction (Étape 1) avec la vérification en temps réel auprès des sources faisant autorité (Étape 2)
Fonctionnement : un exemple avec Google Drive
Lorsqu'un utilisateur soumet une requête à un agent Amazon Quick qui utilise une base de connaissances Google Drive, le système applique les contrôles d'accès en deux étapes :
Étape 1 : filtrage pré-extraction
Amazon Quick effectue une recherche sémantique sur l'index vectoriel afin de trouver les passages de documents les plus pertinents. Le système applique les listes de contrôle d'accès déjà stockées dans l'index. Ceci produit un ensemble préliminaire de documents candidats. Cette étape est nécessaire car des appels API en temps réel pour chaque document de l'index seraient trop coûteux à grande échelle.
Étape 2 : Vérification en temps réel
Amazon Quick vérifie les documents candidats en temps réel en appelant les API de Google Drive. Il utilise l'identifiant de compte de service fourni par l'administrateur pour générer des jetons d'accès spécifiques à l'utilisateur via l'usurpation d'identité. Google Drive constitue la source de vérité pour les listes de contrôle d'accès associées à chaque document. Les documents auxquels l'utilisateur n'est pas autorisé à accéder sont exclus de l'ensemble de résultats récupéré. Seuls les passages de documents vérifiés et autorisés sont transmis au grand modèle de langage (LLM) comme contexte. Le modèle utilise ces connaissances pour générer une réponse.
Cette approche en deux étapes équilibre performance et sécurité. Elle utilise des ACL en cache pour l'efficacité tout en garantissant l'exactitude grâce à des vérifications en temps réel. En plus de l'application des ACL, Amazon Bedrock fournit des contrôles d'IA responsable. Ceux-ci incluent Amazon Bedrock Guardrails pour le filtrage du contenu, des vérifications d'ancrage pour réduire les hallucinations, et des politiques de sécurité configurables pour aider les organisations à déployer des applications d'IA générative de manière responsable.
Pourquoi c'est important pour votre organisation
Cette approche offre trois avantages clés :
- Autorisations toujours à jour – Plus de failles de sécurité entre les cycles de synchronisation lorsque vous utilisez un produit RAG. Si l'accès d'un employé est révoqué, le changement se reflète dans les réponses de l'IA en quelques instants, et non en heures ou en jours.
- Confiance pour passer à l'échelle – Les organisations peuvent étendre la couverture de leur base de connaissances en sachant que les vérifications ACL en temps réel confirment les autorités auprès de la source faisant autorité pour chaque requête, quelle que soit la source de données.
- Charge opérationnelle réduite – Vous n'avez pas à vous soucier de la fréquence de synchronisation.
Ce que les clients en disent
« Lorsque nous avons entrepris d'évaluer des solutions d'IA pour notre organisation, nos équipes de sécurité et de conformité ont été claires sur leur priorité absolue : garantir que les collègues ne voient jamais que les informations qu'ils sont autorisés à consulter. C'est une exigence fondamentale, mais beaucoup de plateformes peinent à y répondre de manière significative. L'approche d'Amazon Quick en matière de contrôle d'accès en temps réel a répondu de façon décisive à cette question et a démontré un niveau de rigueur qui s'est distingué tout au long de notre évaluation. Cela a donné à notre comité de révision interne la confiance nécessaire pour aller de l'avant et a établi une base solide pour la façon dont nous envisageons la gouvernance de l'IA à l'avenir. »
— Jamahl Wiggins, Sr. Specialist – M365 Innovation, Mondelēz International
Mondelēz International a déployé Amazon Quick pour ses plus de 35,000 employés répartis dans quatre régions.
Conclusion
Dans cet article, nous avons expliqué comment Amazon Quick et Amazon Bedrock Knowledge Bases mettent en œuvre l'application des ACL en temps réel pour résoudre un défi de sécurité majeur pour les entreprises. L'architecture ACL à double couche vérifie les autorisations directement auprès des sources faisant autorité au moment de la requête. Cela garantit que les réponses générées par l'IA n'incluent que le contenu auquel un utilisateur est autorisé à accéder.
Pour commencer, visitez Amazon Quick et Amazon Bedrock Knowledge Bases.