
Points clés
- Vous pouvez désormais lier des outils à des skills. Les schémas d'outils restent hors du contexte jusqu'à ce que l'agent lise le skill auquel ils sont liés, et sur les modèles qui acceptent de nouveaux outils en cours de conversation, leur ajout préserve le cache de prompt.
- Les applications peuvent épingler des skills à l'exécution, de sorte que les instructions sont dans le contexte avant le premier appel au modèle, sans
read_fileallers-retours. - Les skills peuvent se recharger en cours de conversation, de sorte qu'un agent de longue durée prend en compte les skills ajoutés, modifiés ou supprimés sans démarrer une nouvelle conversation.
Les skills sont l'un des meilleurs moyens de transmettre des connaissances métier à un agent. Un skill est un dossier d'instructions, de scripts et de fichiers de référence qui apprend à un agent comment faire des choses, comme préparer une réunion client ou analyser des transcriptions d'appels à la manière de votre équipe commerciale. Agent Skills est un standard ouvert qui fonctionne avec n'importe quel modèle et est pris en charge par des dizaines de produits d'agents. Vous n'avez pas non plus besoin d'être technique pour en écrire un : à la base, un skill est un fichier markdown.
Les skills fonctionnent grâce à la divulgation progressive. L'agent ne voit au départ que le nom et la description de chaque skill, et ne lit les instructions complètes que lorsqu'une tâche les nécessite. Cela permet de garder un contexte réduit, et l' ingénierie du contexte est la clé pour construire des agents efficaces.
À mesure que l'utilisation s'accroît, les besoins des équipes en matière de skills évoluent. Nous voyons des registres d'skills d'entreprise atteindre des milliers de skills, partagés entre équipes et agents. Nous avons refondu la prise en charge des skills dans Deep Agents pour répondre à certaines demandes fréquentes :
- Liaison d'outils aux skills : les outils liés à un skill ne sont chargés que lorsque l'agent lit ce skill.
- Skills épinglés : lorsqu'un utilisateur demande explicitement un skill, comme
/meeting-prep, votre application peut le charger avant le prochain appel au modèle. - Rechargement des skills : une conversation de longue durée peut prendre en compte des skills nouveaux ou modifiés sans recommencer de zéro.
Comment fonctionnent les skills
Un skill est un répertoire avec un fichier SKILL.md : un frontmatter YAML avec un champ name et description, suivi des instructions que l'agent suit. Un skill peut également inclure des fichiers de support sous scripts/, references/, et assets/ (spec).
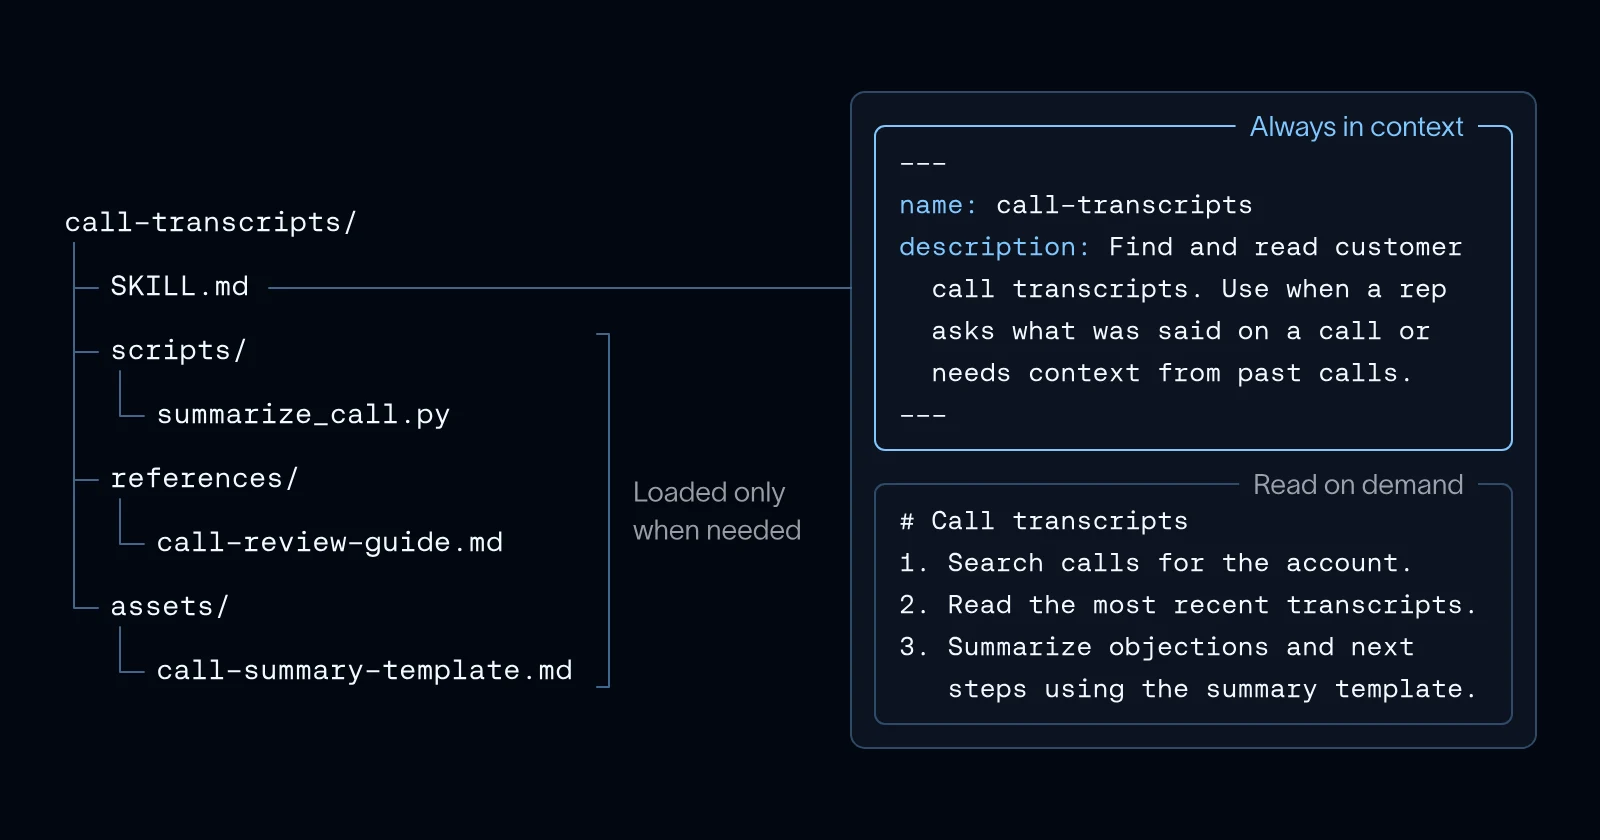
Tout au long de cet article, nous utiliserons notre agent GTM comme exemple fil rouge. Il est construit sur Deep Agents, et sa bibliothèque de plus de 50 skills couvre le travail récurrent d'un commercial, comme meeting-prep, call-transcripts, et competitive-intel-card.
Les skills se chargent à trois niveaux:
- Découverte. Au démarrage, l'agent voit le
nameetdescriptionde chaque skill dans son prompt système. - Activation. Lorsqu'une tâche correspond à un skill, l'agent lit l'intégralité du
SKILL.mdavecread_file. - Exécution. L'agent suit les instructions, et lit les scripts ou fichiers de référence uniquement lorsqu'ils les demandent.
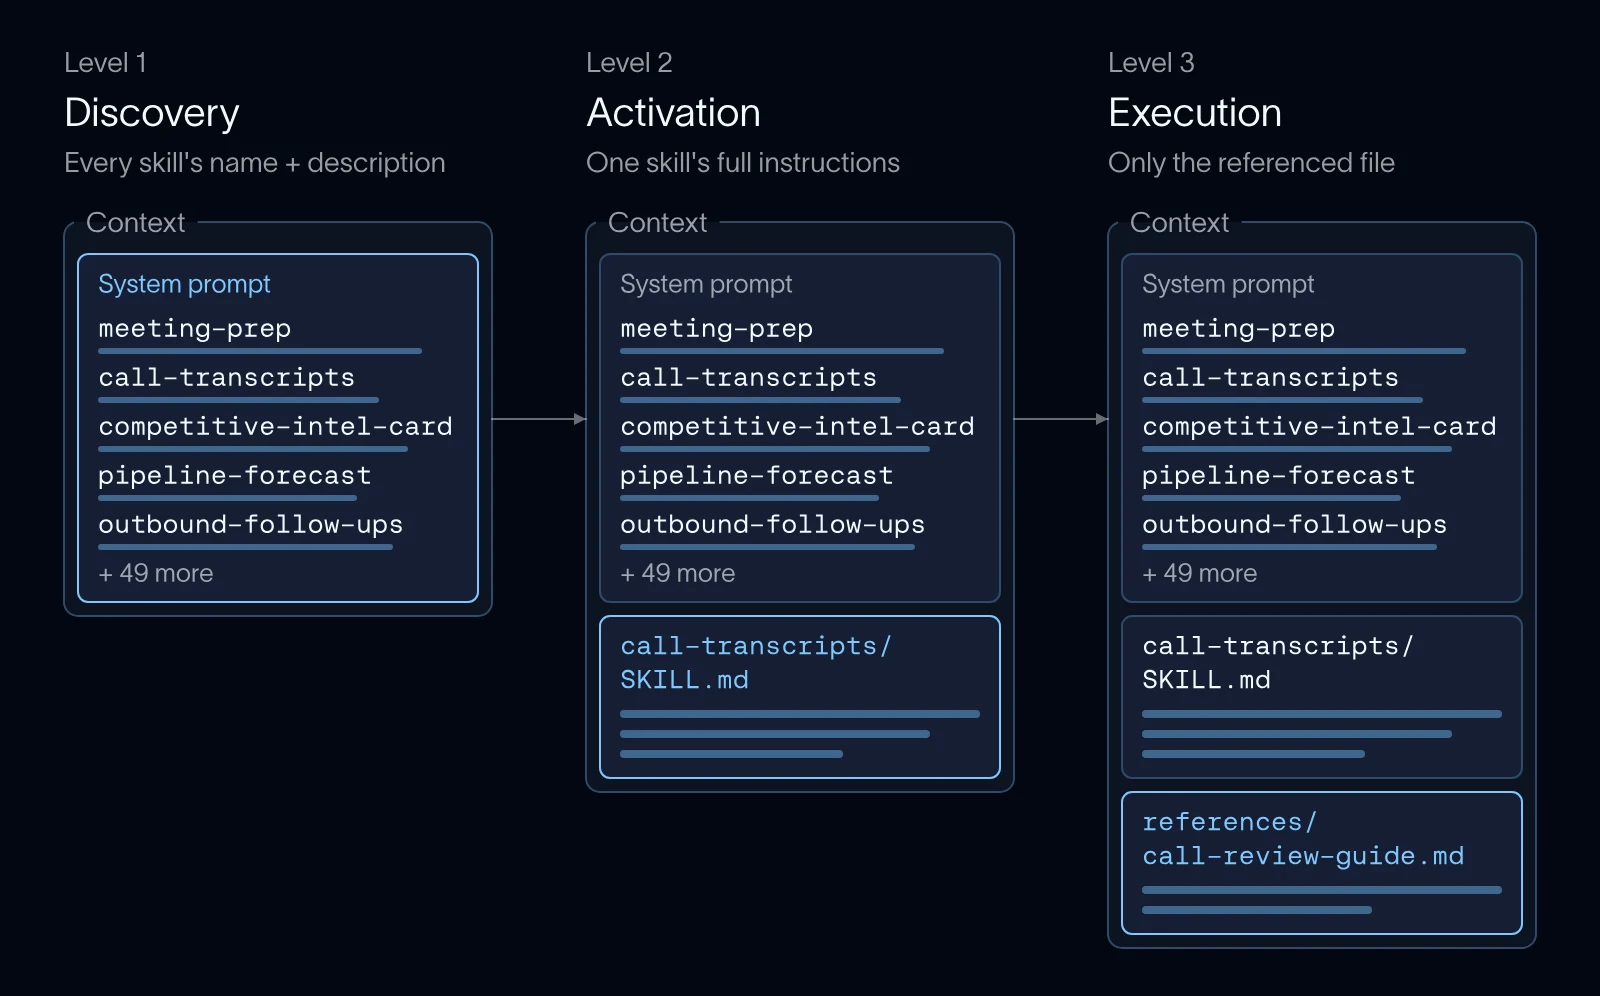
Tant qu'un skill n'est pas utilisé, il ne coûte qu'une ligne dans le prompt système, de sorte qu'une bibliothèque peut contenir des références à une abondance de skills sans encombrer le contexte. Passons maintenant aux améliorations que nous avons apportées dans Deep Agents.
Lier des outils aux skills
Les skills indiquent souvent à un agent comment utiliser des outils spécifiques, et certains outils ne fonctionnent bien qu'une fois que l'agent a lu ces instructions. Jusqu'à présent, les skills et les outils étaient présentés séparément. Vous pouviez garder les schémas d'outils hors du contexte avec tool search, mais rien ne liait un outil au skill qui l'explique : l'agent pouvait trouver et appeler un outil sans lire son skill, ou lire le skill et devoir quand même rechercher ses outils.
Vous pouvez désormais lier des outils à un skill, de sorte qu'une compétence et ses outils sont divulgués ensemble. Un outil lié n'est pas ajouté au contexte tant que l'agent n'a pas lu sa compétence, et un appel à cet outil avant cela échoue comme outil inconnu. Cela permet de garder le contexte léger, et cela signifie que l'agent a lu comment utiliser un outil avant de pouvoir l'appeler. Dans notre agent GTM, call-transcripts explique comment rechercher des appels et lire des transcriptions, c'est donc l'endroit naturel pour lier ces outils.
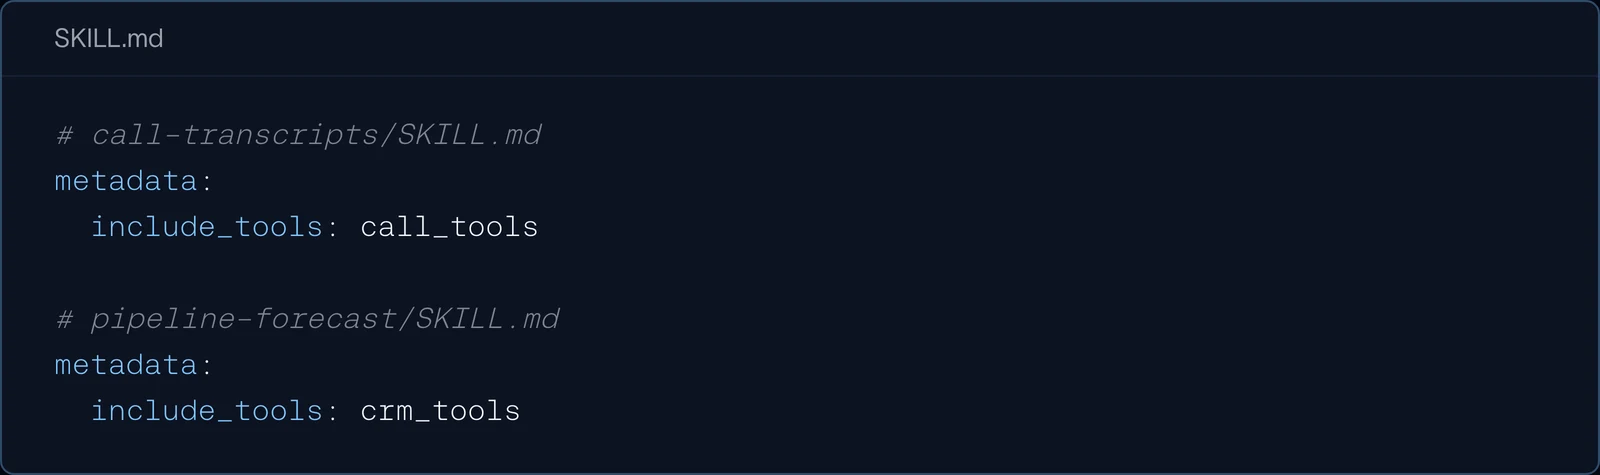
Listez les outils dans les métadonnées frontmatter de la compétence sous metadata.include_tools:
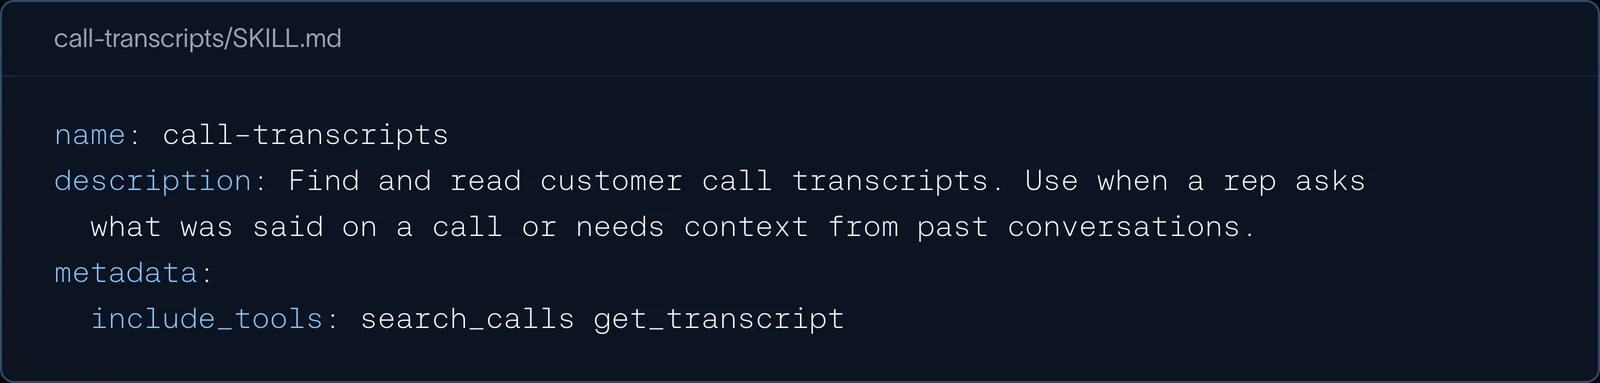
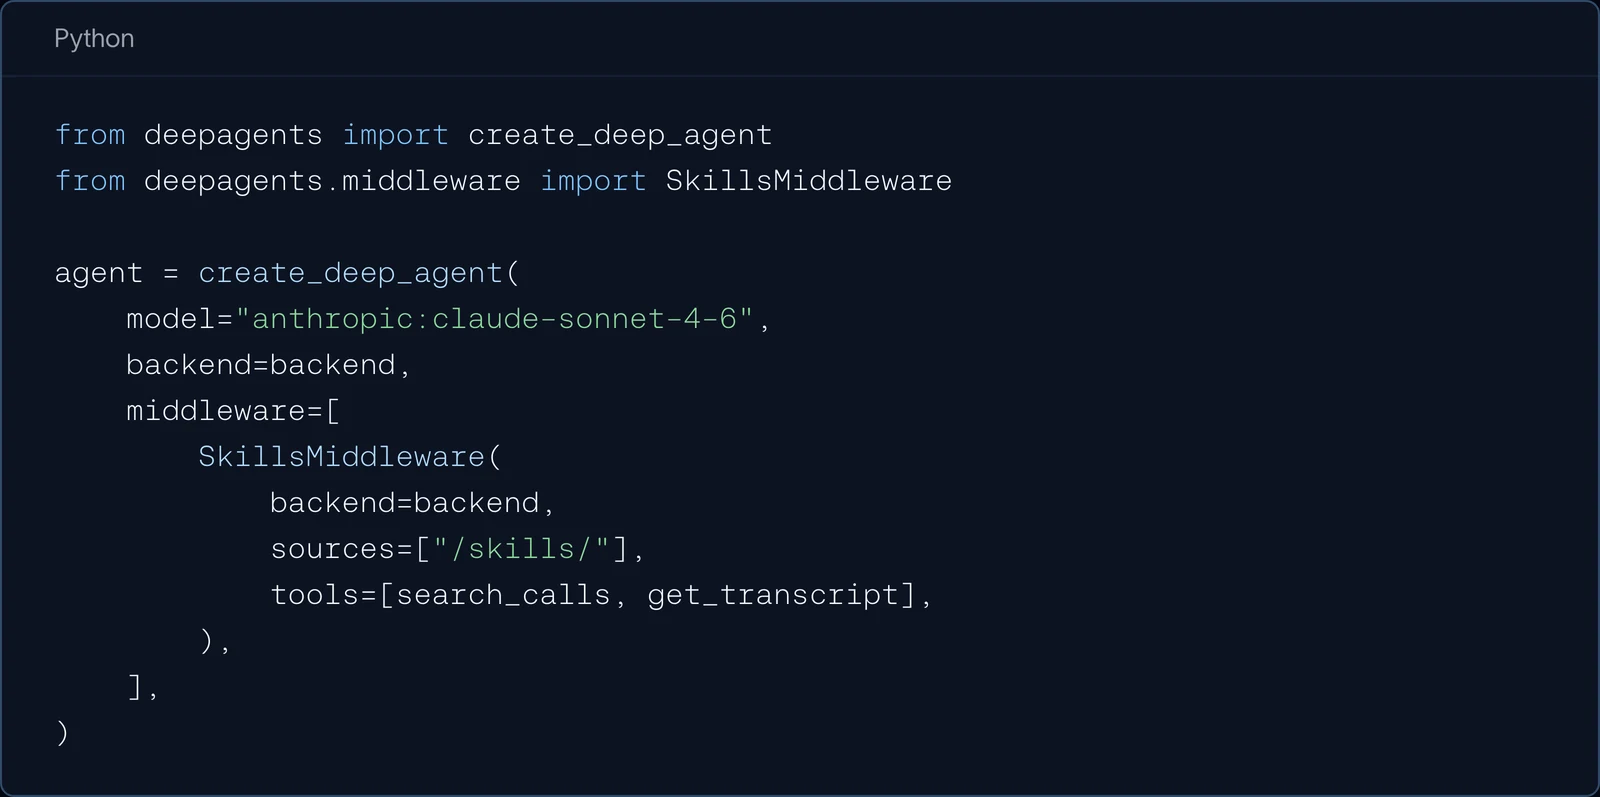
Passez ces outils à SkillsMiddleware au lieu de l'agent :
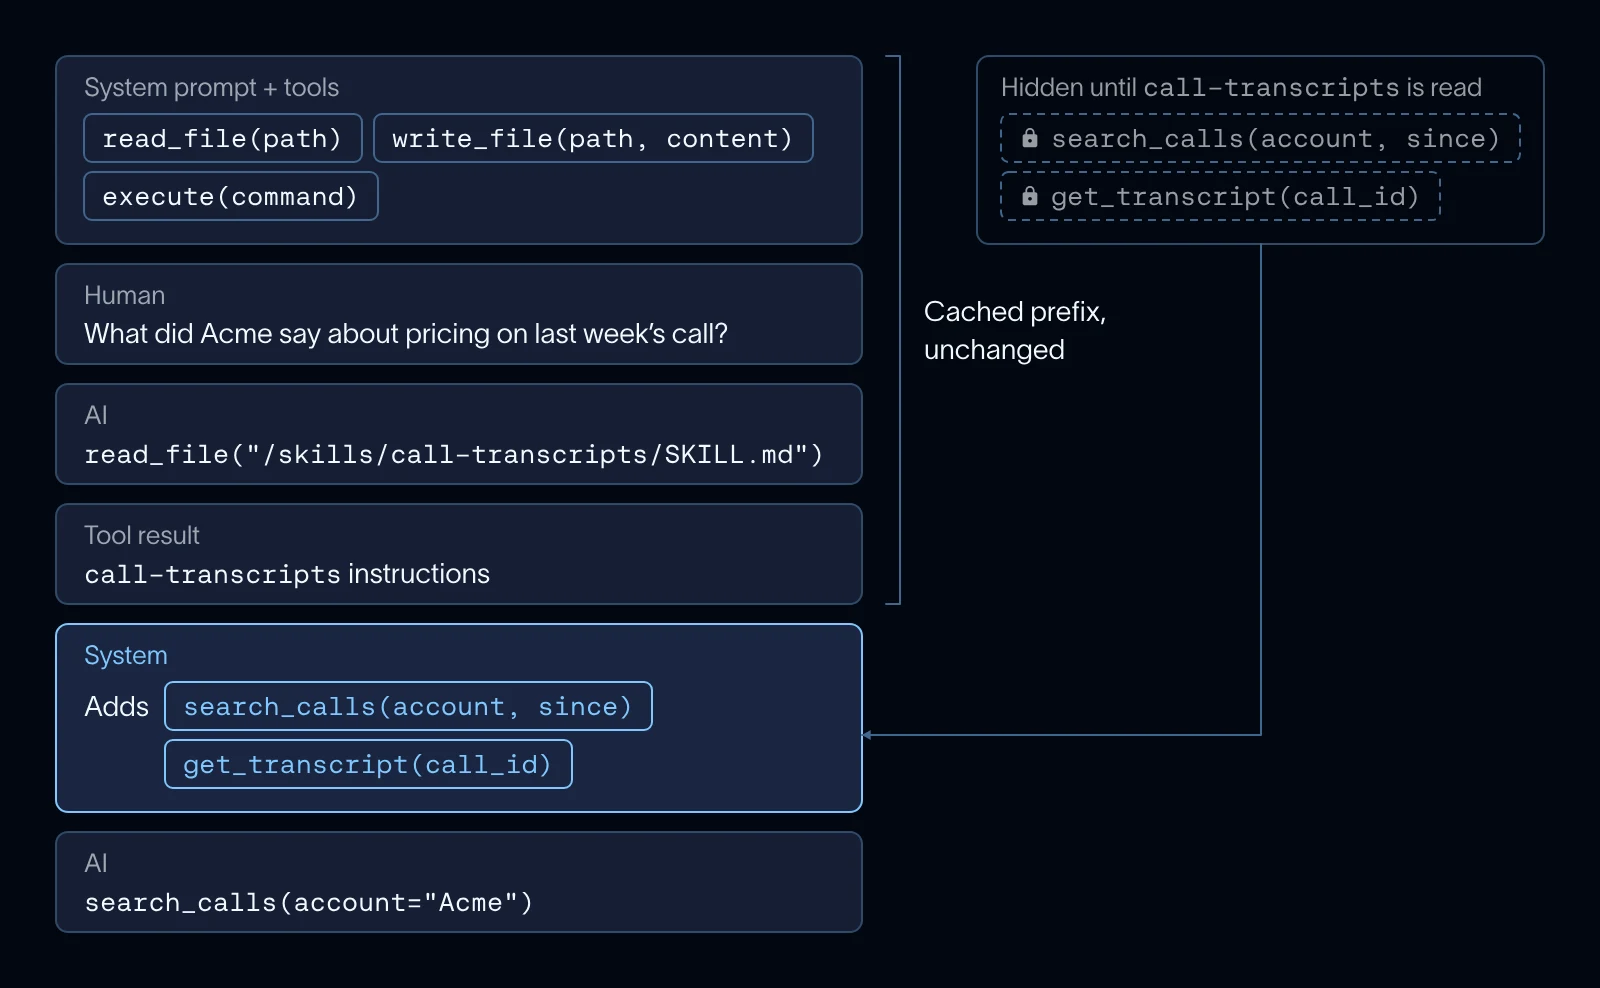
Ajouter des outils en cours de conversation signifiait auparavant modifier la liste des outils de la requête, ce qui invalide le cache de prompt. Anthropic et OpenAI permettent désormais aux modèles plus récents d'accepter des outils en cours de conversation, donc sur ces modèles, Deep Agents ajoute les outils liés d'une skill juste après la lecture de la skill et le préfixe en cache reste intact (Anthropic et OpenAI integration docs). Sur les autres modèles, les outils sont ajoutés à la requête comme avant.
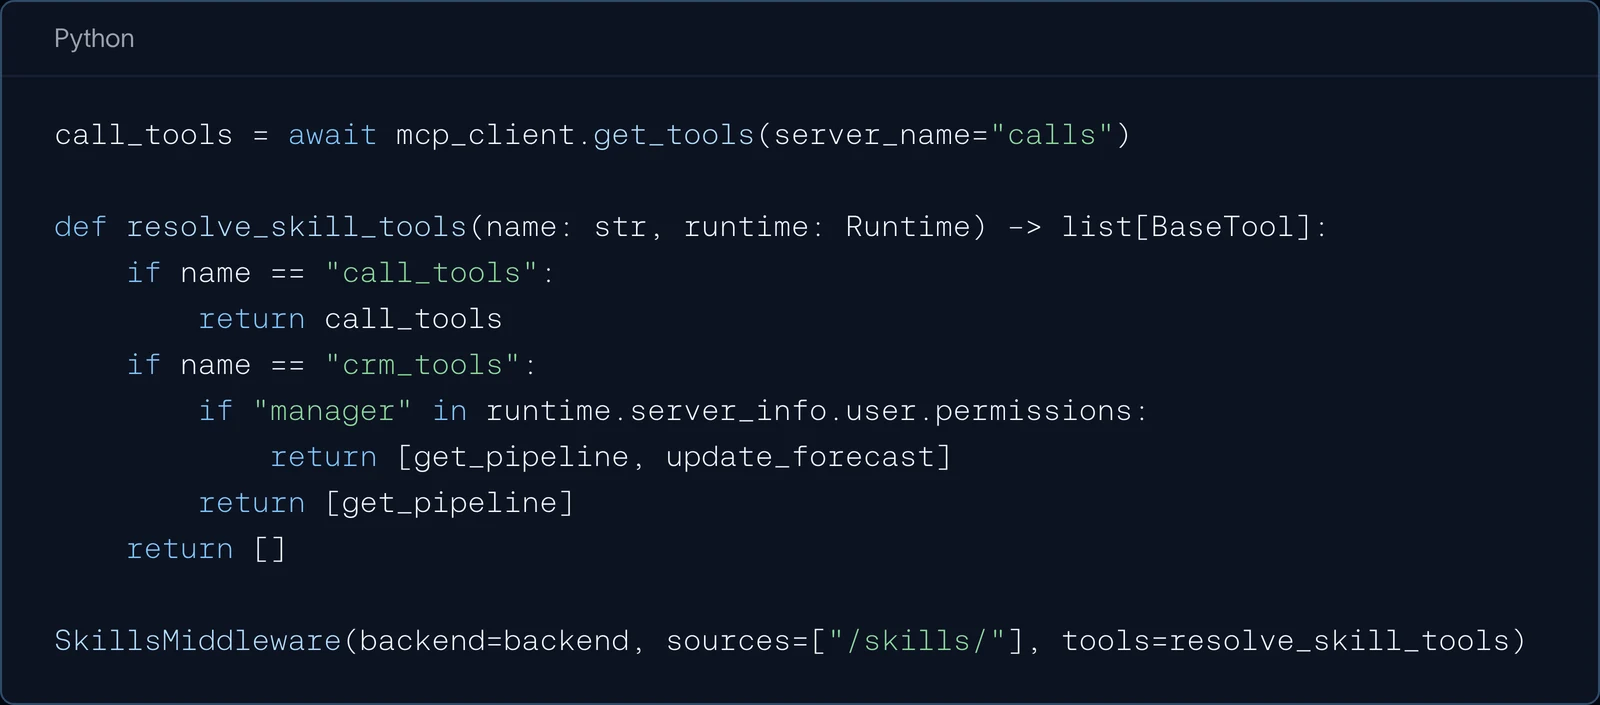
Une liste couvre la plupart des skills. Pour plus de contrôle, une skill peut lister un label au lieu de noms d'outils, et une fonction que vous passez à SkillsMiddleware transforme chaque label en outils. Cela vous permet de :
- Divulguer un groupe d'outils entier, comme tous les outils d'un serveur MCP, sous un seul nom, sans lister chaque outil dans la skill.
- Conditionner les outils aux permissions d'exécution. La fonction reçoit le runtime du graphe, elle peut donc vérifier qui est l'utilisateur et renvoyer uniquement les outils qu'il est autorisé à utiliser.
Ici, call-transcripts reçoit tous les outils du serveur MCP des appels, et pipeline-forecast reçoit les outils CRM, mais seuls les managers peuvent mettre à jour les prévisions :
Voir Add tools to skills pour en savoir plus.
Skills épinglées
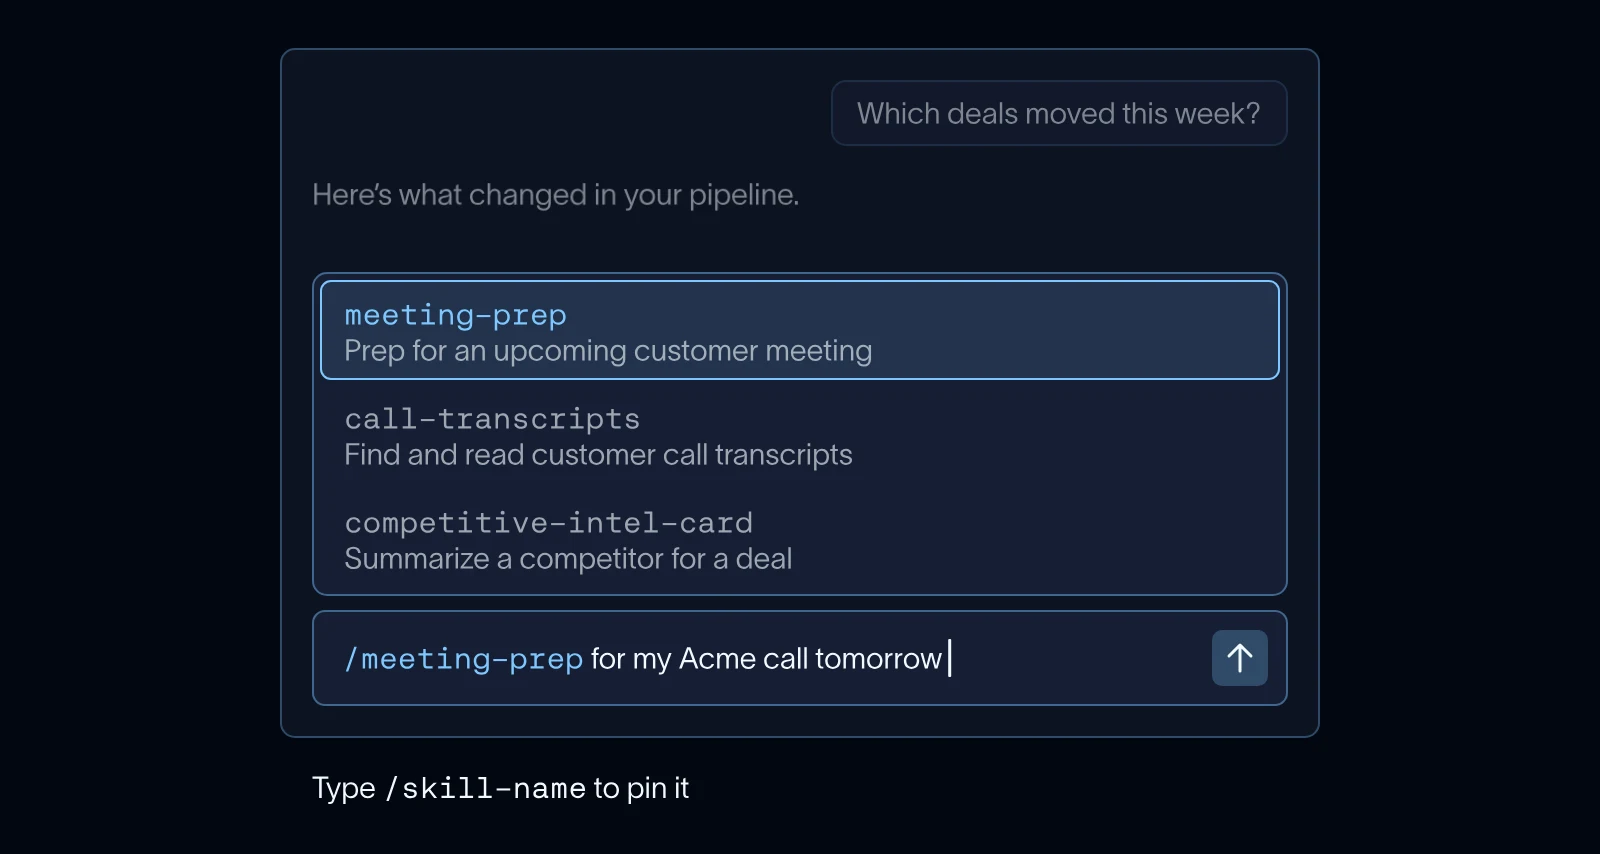
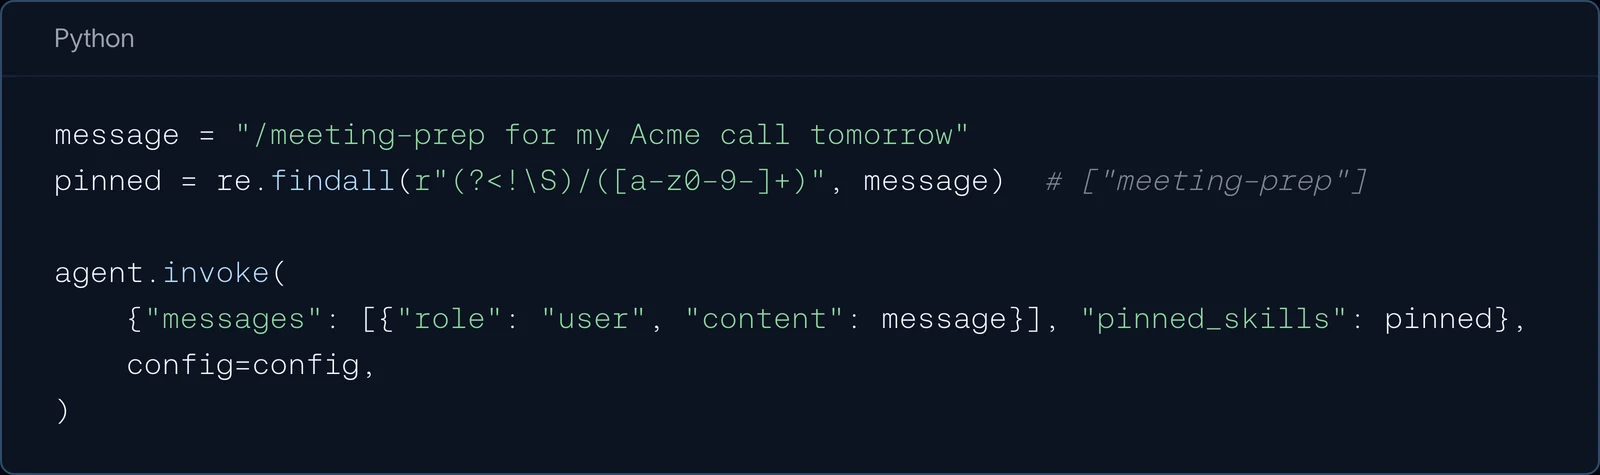
Parfois, l'utilisateur sait déjà quelle skill il veut. Dans notre agent GTM, un commercial peut taper /meeting-prep for my Acme call tomorrow. Sans épinglage, le modèle ne voit que la description de la skill et doit la lire. Cela ajoute un aller-retour avant que le travail ne commence, et le modèle n'est pas garanti de charger la bonne skill. Avec les skills épinglées, votre application trouve les noms de skills dans le message (ou les extrait d'une UI) et les passe dans pinned_skills, et le middleware ajoute les instructions de chaque skill à la conversation avant le prochain appel au modèle. Deep Agents n'analyse pas les messages lui-même, donc vous choisissez la syntaxe :
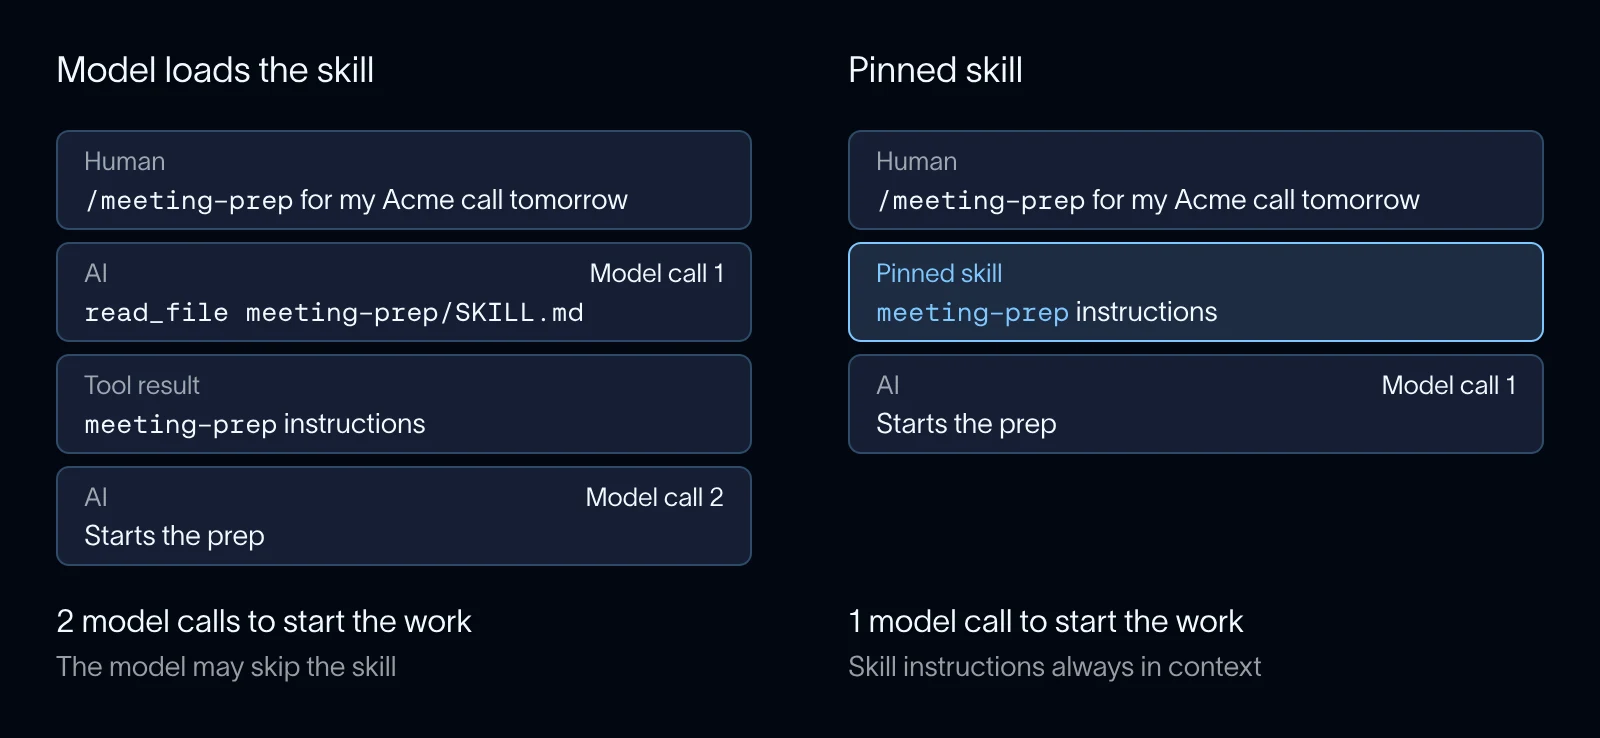
Cela réduit la latence et rend le comportement plus prévisible : les instructions sont garanties comme étant dans le contexte, et les outils liés d'une compétence épinglée l'accompagnent. Chaque compétence épinglée est ajoutée une seule fois sous forme de message balisé, si bien que les messages antérieurs ne changent jamais, le cache de prompt reste valide, et une interface de chat peut afficher la compétence comme une étiquette plutôt que son texte intégral.
Recharger les compétences en cours de fil
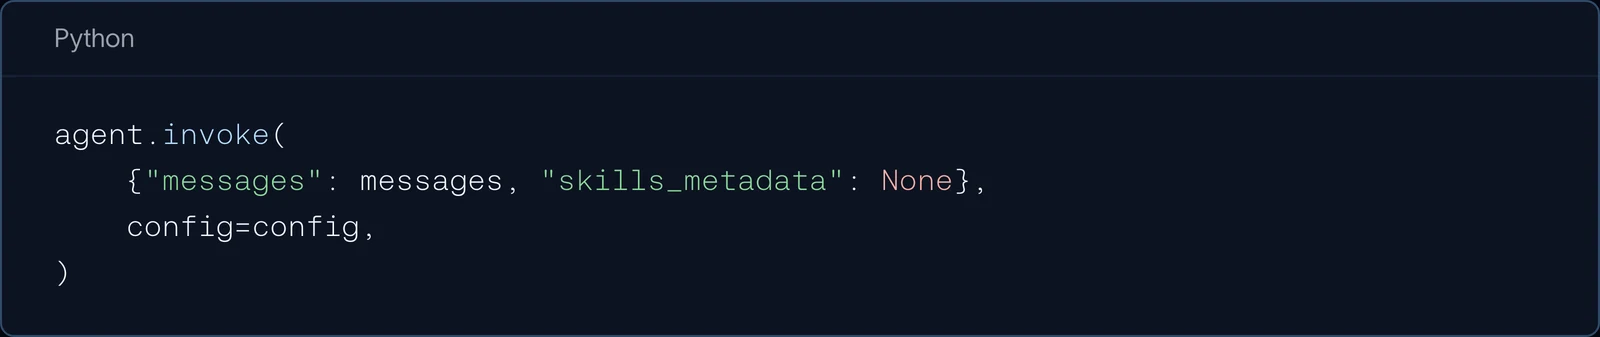
Les compétences sont chargées au début de chaque fil et conservées dans l'état de l'agent, de sorte que chaque tour suivant réutilise le même ensemble de compétences. Vous pouvez désormais invalider cette liste en définissant skills_metadata sur None lors de l'invocation de l'agent. Si un coéquipier ajoute une competitive-intel-card compétence à la bibliothèque, l'application peut choisir d'invalider la liste des compétences et la prochaine exécution rescanne chaque source :
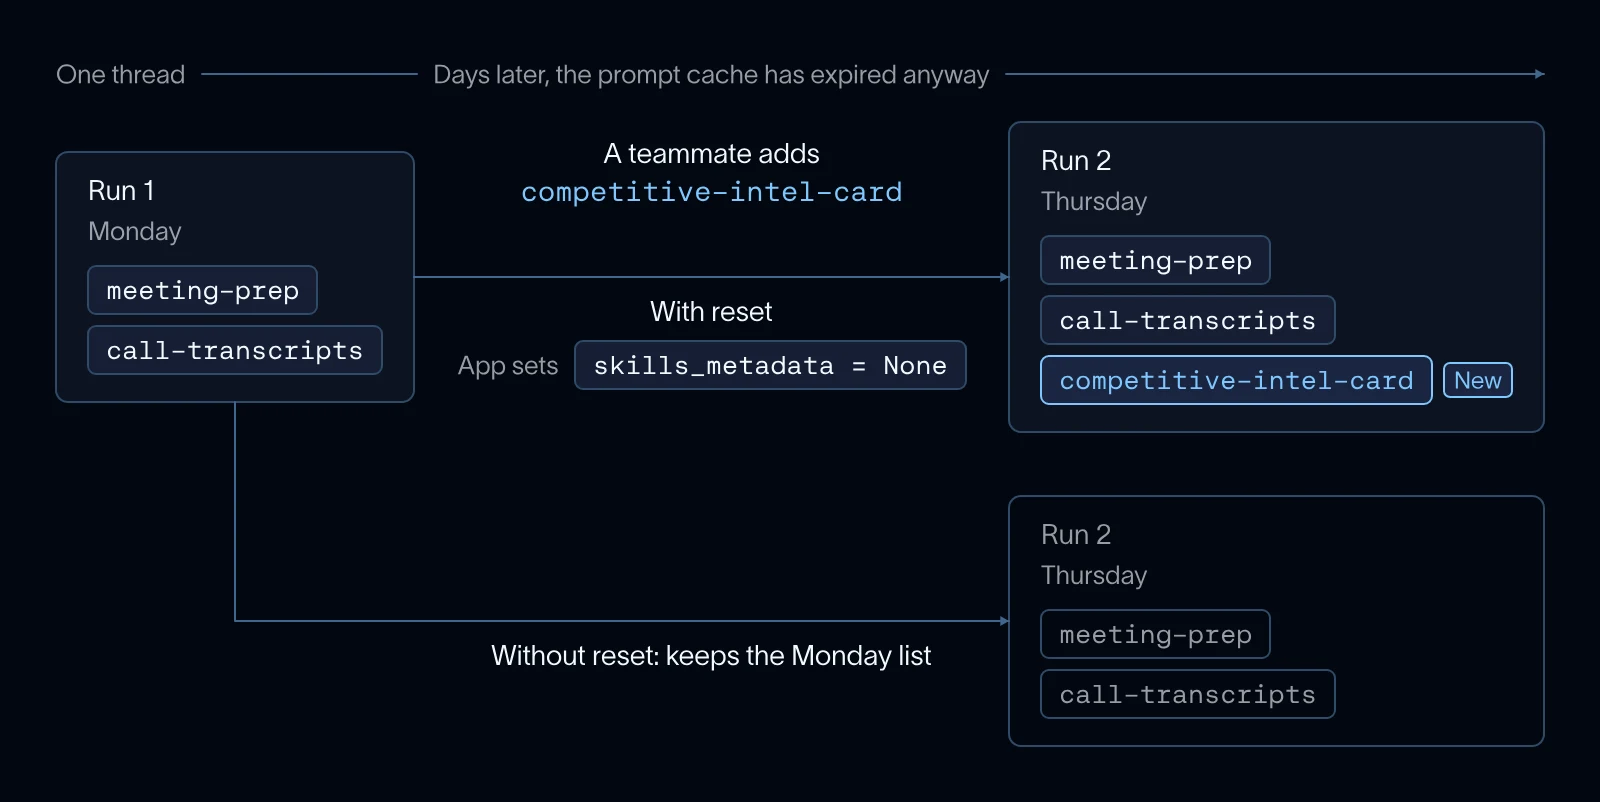
Un rechargement qui trouve de nouvelles compétences modifie le prompt système, ce qui invalide le cache de prompt. Pour un fil resté inactif, ce coût est généralement déjà payé : les caches des fournisseurs expirent typiquement en quelques minutes à une heure d'inactivité (Anthropic, OpenAI), de sorte que le cache est froid au moment où le commercial revient.
Comme la réinitialisation est simplement une entrée d'exécution, vous pouvez aussi remettre le contrôle aux utilisateurs. Par exemple, une /reload commande côté client :
Vous pouvez également réinitialiser depuis update_state ou depuis un middleware, afin que votre application contrôle le moment où un rechargement des compétences se produit. Voir Reload skills.
Premiers pas
Les compétences sont le mécanisme standard du secteur pour fournir à un agent des connaissances de domaine organisées. Ces mises à jour les rendent plus faciles à exploiter à grande échelle : les outils ne se chargent que lorsqu'une compétence en a besoin, les compétences dont un flux de travail a besoin sont chargées au préalable, et les fils de longue durée restent à jour à mesure que votre bibliothèque évolue. Et parce que les compétences sont une norme ouverte, celles que votre équipe rédige fonctionnent d'un modèle et d'un agent à l'autre.
Tout cela est disponible dans la dernière deepagents. Consultez la documentation des skills pour commencer, et faites-nous part de vos impressions via les issues GitHub, le forum, ou sur X.
Remerciements
Merci à Rich Scarrott d'avoir dirigé le développement de ces nouvelles fonctionnalités et à Hunter Lovell pour la relecture des fonctionnalités et du billet de blog !