
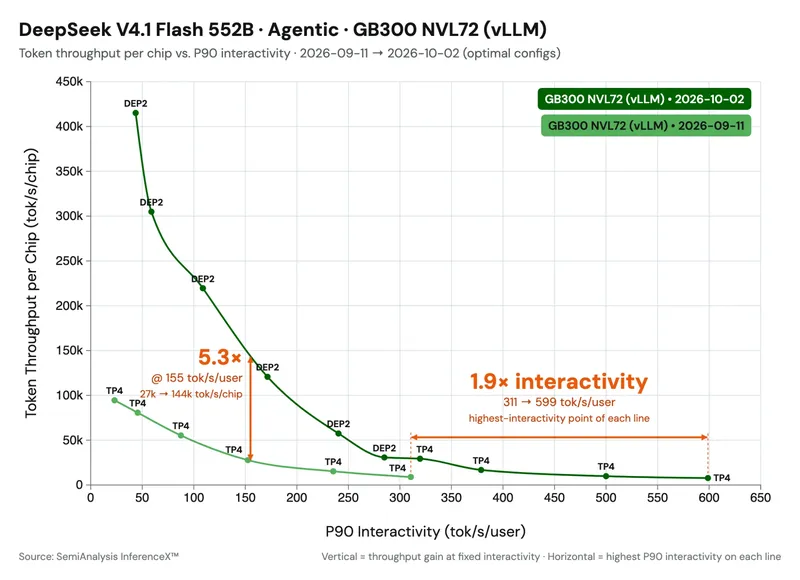
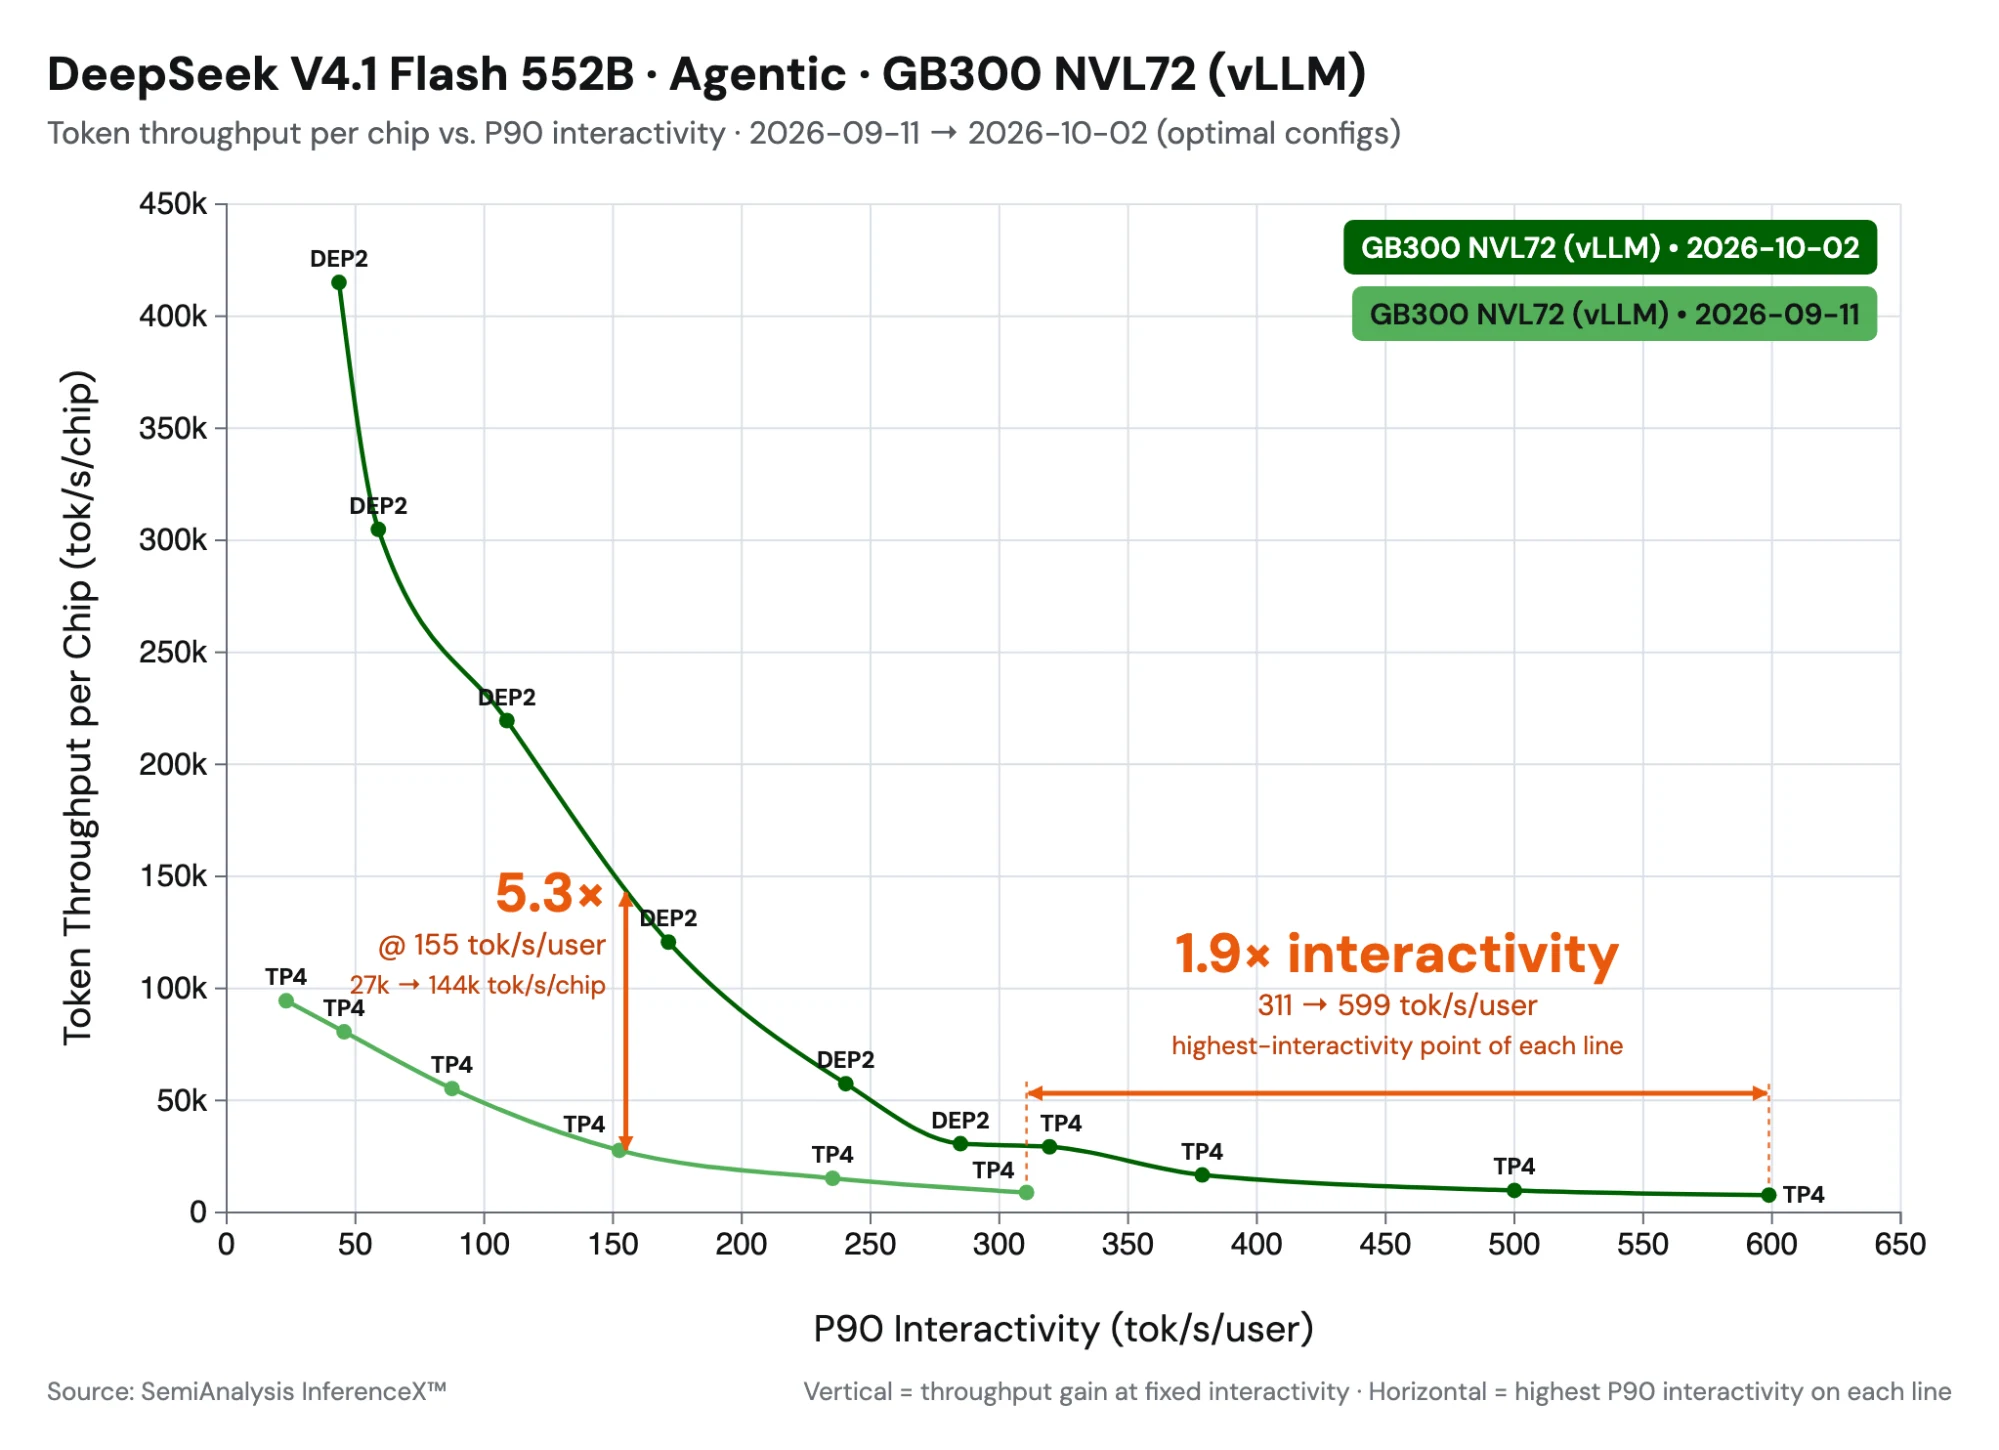
TL;DR : Dans les trois semaines qui ont suivi la sortie de DeepSeek-V4.1-Flash, Inferact et la communauté vLLM ont optimisé le modèle, obtenant un accélération de 1,9x à faible concurrence et une amélioration de débit de 5,3x sous une contrainte de 150 TPS. L'amélioration des performances provient de :
-
Nous avons implémenté le SWA bounded replay avec des CUDA graphs, obtenant une réduction d'environ 30% du TTFT.
-
Nous avons intégré les kernels récemment publiés par DeepSeek, notamment MegaAttention, Mega-mHC, Mega-Gate et DeepSelect.
-
Nous avons fusionné et parallélisé agressivement les kernels restants, y compris les flux secondaires mHC, et fusionné l'all-reduce avec les opérations précédentes et suivantes en un seul kernel.
DeepSeek V4.1 introduit une architecture très efficace pour les tâches de serving agentique à long terme : avec son architecture encodeur-décodeur causale (CED), le modèle active 16B de paramètres par token pendant le décodage, mais seulement 8B pendant le prefill. Le modèle est également extrêmement efficace en mémoire. Il combine plusieurs techniques pour réduire la taille du KV cache : Compressed Sparse Attention 2 (CSA2), FP4 KV cache et le partage du KV cache entre couches, ramenant l'empreinte KV globale à 890 octets par token. Cet article montre comment nous combinons ces optimisations au niveau du modèle de DeepSeek avec des optimisations système côté vLLM pour atteindre un débit 5x supérieur sur le benchmark de serving agentique SemiAnalysis AgentX. Nous présentons nos optimisations en deux catégories : le SWA bounded replay et les optimisations liées aux kernels.
SWA bounded replay
DeepSeek-V4.1-Flash conserve deux types de KV caches. Le KV global est compressé, partagé entre les couches et stocké en FP4, à environ 890 octets par token (rapport V4.1). Le KV à fenêtre glissante (SWA) est non compressé en FP8, couvrant les 128 dernières positions dans chacune des 40 couches.
Le SWA KV engendre deux coûts :
-
Le prefix caching doit le stocker à chaque limite de hit possible, ce qui coûte plus de 10x le stockage du KV global.
-
Le prefill exécute les couches 21–39 sur chaque token de prompt, alors que le décodage ne lit que leurs 128 dernières positions.
Une approche simple consiste à recalculer le SWA KV au lieu de le mettre en cache. Cependant, le recalcul exact est coûteux, car la fenêtre de 128 tokens de chaque couche dépend des positions antérieures de la couche inférieure, donc le reconstruire sur L couches revient à rejouer environ L × 128 tokens.
DeepSeek V4.1 introduit le SWA bounded replay, qui échange l'exactitude contre l'efficacité. Il ne réexécute que les 128 derniers tokens et clippe la fenêtre SWA au début du replay. Le résultat n'est pas bit-exact, mais DeepSeek signale une perte de qualité négligeable (détails ci-dessous). vLLM l'applique à deux endroits, un pour chaque coût.
Côté encodeur : reconstruire la fenêtre lors d'un hit de cache
Avec le replay côté encodeur, vLLM ne met en cache que le KV global et ignore le SWA KV. Lors d'un hit de préfixe de longueur H, il réexécute les tokens [H − 128, H) pour reconstruire le SWA KV, avec des fenêtres clippées à s = H − 128.
Côté décodeur : sauter la majeure partie du prefill du prompt
Dans l'architecture CED de DeepSeek V4.1, la couche 20 calcule le KV global du décodeur et les couches 21–39 le réutilisent. vLLM exécute donc la couche 20 sur chaque token pour produire ce KV global, et n'exécute les couches 21–39 que sur les 128 derniers tokens de chaque requête. Pour les longs prompts, cela saute près de la moitié du modèle.
CUDA graphs pour les couches allégées
Après l'allègement, les couches 21–39 font si peu de travail GPU que, exécutées en mode eager, le surcoût de lancement des kernels domine et le GPU reste inactif. Leurs formes d'entrée diffèrent également de celles des couches 0–20, de sorte que les deux parties ne peuvent pas être capturées dans un seul CUDA graph. Le graphe PIECEWISE « breakable » de vLLM se casse déjà au milieu du modèle, ce qui offre une séparation naturelle : les couches 0–20 sont capturées sur le batch complet, et les couches 21–39 sont capturées séparément sur le batch allégé. Cela rend les CUDA graphs utilisables pour le prefill allégé, et permet aux couches 21–39 d'utiliser leurs propres tailles de capture pour une meilleure couverture des graphes.
Le SWA bounded replay est activé par défaut pour DeepSeek-V4.1 et est contrôlé par --[no-]swa-bounded-replay.
Résultats de précision et de performance
Bien que le SWA bounded replay ne soit pas exact, DeepSeek n'a signalé qu'une perte de qualité négligeable. Nous l'avons confirmé dans vLLM sur des benchmarks incluant GSM8K et GPQA et n'avons observé aucune différence de précision significative (écarts inférieurs à environ 1,5 erreurs standard).
Côté performance, l'encodeur échange une fenêtre de prefill par hit contre de l'espace de cache, donc l'accélération vient du côté décodeur. Nous mesurons le TTFT de prefill d'une requête unique dans trois configurations : replay désactivé ; replay activé sans CUDA graphs côté décodeur (les couches 21–39 s'exécutent en mode eager, et seules les étapes eager sont allégées) ; et replay activé avec CUDA graphs côté décodeur.
Le replay côté décodeur avec CUDA graphs réduit le temps de calcul de prefill de 30–40%. Les CUDA graphs comptent le plus pour les prompts courts, où les lancements de kernels sont le goulot d'étranglement : sans eux, le surcoût de lancement dépasse les économies GPU et le replay est plus lent que la ligne de base (jusqu'à +12% à 1K sur DEP2). Pour les prompts longs, le travail GPU est suffisamment important pour masquer le surcoût de lancement, donc le replay eager capte déjà l'essentiel du gain et les CUDA graphs ajoutent encore quelques points.
Kernels
DeepSeek a publié DeepSeek-V4.1-Flash accompagné de nouveaux kernels dans trois de ses dépôts. DeepSelect est une nouvelle bibliothèque top-k pour DeepSeek Sparse Attention. DeepGEMM a ajouté des kernels d'indexeur creux et plusieurs kernels fusionnés liés aux GEMM. FlashMLA a ajouté la prise en charge du NVFP4 KV cache et un kernel d'attention fusionné, MegaAttention. Nous avons intégré plusieurs de ces kernels open source dans vLLM et suivons l'avancement dans #57448.
Mega-mHC (#56962). Mega-mHC fusionne la chaîne mHC en un seul kernel : l'étape post, l'étape delayed-pre et RMSNorm. Il remplace un chemin fusionné TileLang existant que l'implémentation de DeepGEMM surpasse désormais. Le kernel est 1,14–1,51× plus rapide que la version TileLang sur NVIDIA GB200.
Mega-Gate (#56266). Mega-Gate fusionne le routeur MoE (GEMM de gate, scoring des experts, biais et sélection top-k) en un seul kernel. Auparavant, ces opérations s'exécutaient comme un GEMM suivi d'un kernel top-k séparé, ce qui coûtait un lancement supplémentaire et un aller-retour en mémoire pour les scores. Cette fusion conduit à des accélérations de kernel de 1,18–1,31× aux tailles de batch moyennes.
Chevauchement multistream mHC (#57603). Dans la V4.1, les coefficients mHC sont décalés d'une sous-couche, de sorte que le GEMM des coefficients de la prochaine couture ne lit que des flux résiduels qui existent déjà avant l'exécution de l'attention ou du FFN. Aucun des deux côtés n'a besoin de la sortie de l'autre jusqu'à la prochaine étape post/pre qui les combine. Aux petites tailles de batch, vLLM calcule désormais les coefficients du prochain bloc mHC sur un flux CUDA auxiliaire, en parallèle de l'attention et du FFN. Cela masque un travail qui autrement resterait sur le chemin critique du décodage limité par la latence. Dans le scénario TP4 à faible latence, cela réduit la latence d'environ 4 %.
Logits MQA creux (#56254). Dans la V4.1, les couches d'indexeur tardives sélectionnent leur top-k à partir d'un ensemble fixe de 16K positions candidates. Les implémentations précédentes calculaient le score pour tout le contexte et masquaient tous les blocs non candidats avant le scoring. Les kernels creux de DeepGEMM ne notent que les candidats, de sorte que le coût ne croît plus avec le contexte. Par couche sur NVIDIA GB300, c'est 1,2× plus rapide à 8K tokens et 14–23× plus rapide à 512K. De bout en bout sur 4× NVIDIA GB300, le décodage s'améliore de 3–6 %. Le prefill est 1,43× plus rapide à 512K et 2× plus rapide à un contexte de 1M.
MegaAttention avec KV compressé NVFP4 (#56935). Le kernel MegaAttention de FlashMLA effectue le RoPE des requêtes, l'attention creuse, le RoPE inverse sur la sortie et la conversion FP8 en un seul lancement, en écrivant directement dans le tampon que la projection de sortie lit. Cela supprime les kernels séparés et les allers-retours mémoire entre l'attention et la couche suivante. Il lit également un nouveau format KV compressé NVFP4, qui est 45 % plus petit que le précédent cache KV FP8. MegaAttention améliore aussi l'efficacité du kernel de 1,45× grâce à une fusion agressive qui élimine les écritures HBM entre les opérations.
Kernel WO-A fusionné à faible latence (#58634). Pour les petits batches de décodage sur Blackwell, nous fusionnons le RoPE inverse, la quantification FP8, le GEMM de batch WO-A et la requantification MXFP8 en un seul kernel CuTe-DSL, réduisant la chaîne pré-WO-B de trois kernels à un seul. L'idée clé est de garder les activations intermédiaires sur la puce et de pipeliner le déplacement des données avec le calcul, en évitant les lancements de kernels supplémentaires et les allers-retours en mémoire globale qui dominent aux petites tailles de batch. Cela améliore le chemin WO-A fusionné jusqu'à ~2,1× et offre jusqu'à ~6–7 % de latence inter-token en moins à faible concurrence.
Engram. Les couches Engram de la V4.1 recherchent des lignes dans deux grandes tables FP8 indexées par des n-grams de tokens hachés. Chaque étape ne lit que quelques lignes, de sorte que le placement des tables et la latence de recherche importent plus que le calcul. Nous préchargeons de manière asynchrone les recherches Engram déchargées sur le CPU, en chevauchant l'accès à la mémoire hôte avec le calcul du décodeur pour accélérer le décodage à faible batch (#56512). Les têtes Engram sont partitionnées avec un schéma TP/DP unifié, et les répliques DP colocalisées partagent les mêmes tables hôtes, évitant les copies redondantes et toute communication DP sur le chemin de recherche (#57651). Pour ces grandes tables résidentes sur l'hôte, nous prenons également en charge les transparent huge pages (THP) pour réduire le coût des défauts de page, offrant des kernels de recherche jusqu'à 10× plus rapides pour les prefills (#56926). Nous avons également ajouté des optimisations pour les cas où il n'y a pas assez de huge pages disponibles (#59327).
Performances agentiques
Nous mesurons les performances avec le benchmark SemiAnalysis AgentX comme charge de travail de service agentique représentative (détaillé dans notre article précédent). Ensemble, ces optimisations apportent à vLLM des améliorations de performances significatives par rapport à notre implémentation du jour 0. Comme le montre la Figure 6, notre résultat à faible latence est amélioré d'un facteur 1.9× par rapport à notre résultat du jour 0, et le résultat à haut débit est amélioré d'environ 5×.
Pour le service à faible latence, nous utilisons TP4 avec l'attention FlashInfer. Le décodage à petit batch est largement limité par la bande passante mémoire, donc le partitionnement des poids du modèle sur quatre GPU est un bon choix. Nous avons également essayé MegaAttention, mais son principal avantage se situe dans des cadres à plus haut débit où la fusion a plus de marge pour aider. À TP4, ce bénéfice était beaucoup plus faible, et FlashInfer s'est avéré plus rapide dans nos exécutions.
Pour un haut débit, nous passons à DEP2, en utilisant DP attention avec des experts répartis sur les GPU. Comme V4.1 utilise un latent KV partagé entre toutes les têtes, TP dupliquerait le cache KV sur les GPU. DP évite cette duplication : chaque GPU ne stocke le KV que pour les requêtes qu'il sert, l'affinité de session préservant la localité du préfixe-cache entre les tours. MegaAttention réduit encore l'empreinte KV par requête avec NVFP4, la divisant presque par deux par rapport à FP8 et augmentant la concurrence par GPU.
Fait notable, V4.1 est très efficace en mémoire et n'a pas besoin de déchargement du cache KV tout au long du benchmark. Nous nous attendons à ce que le déchargement du cache KV commence à aider à une concurrence plus élevée avec la désagrégation P/D.
La relecture bornée SWA, associée aux optimisations des noyaux côté préfill, a également grandement amélioré le TTFT.
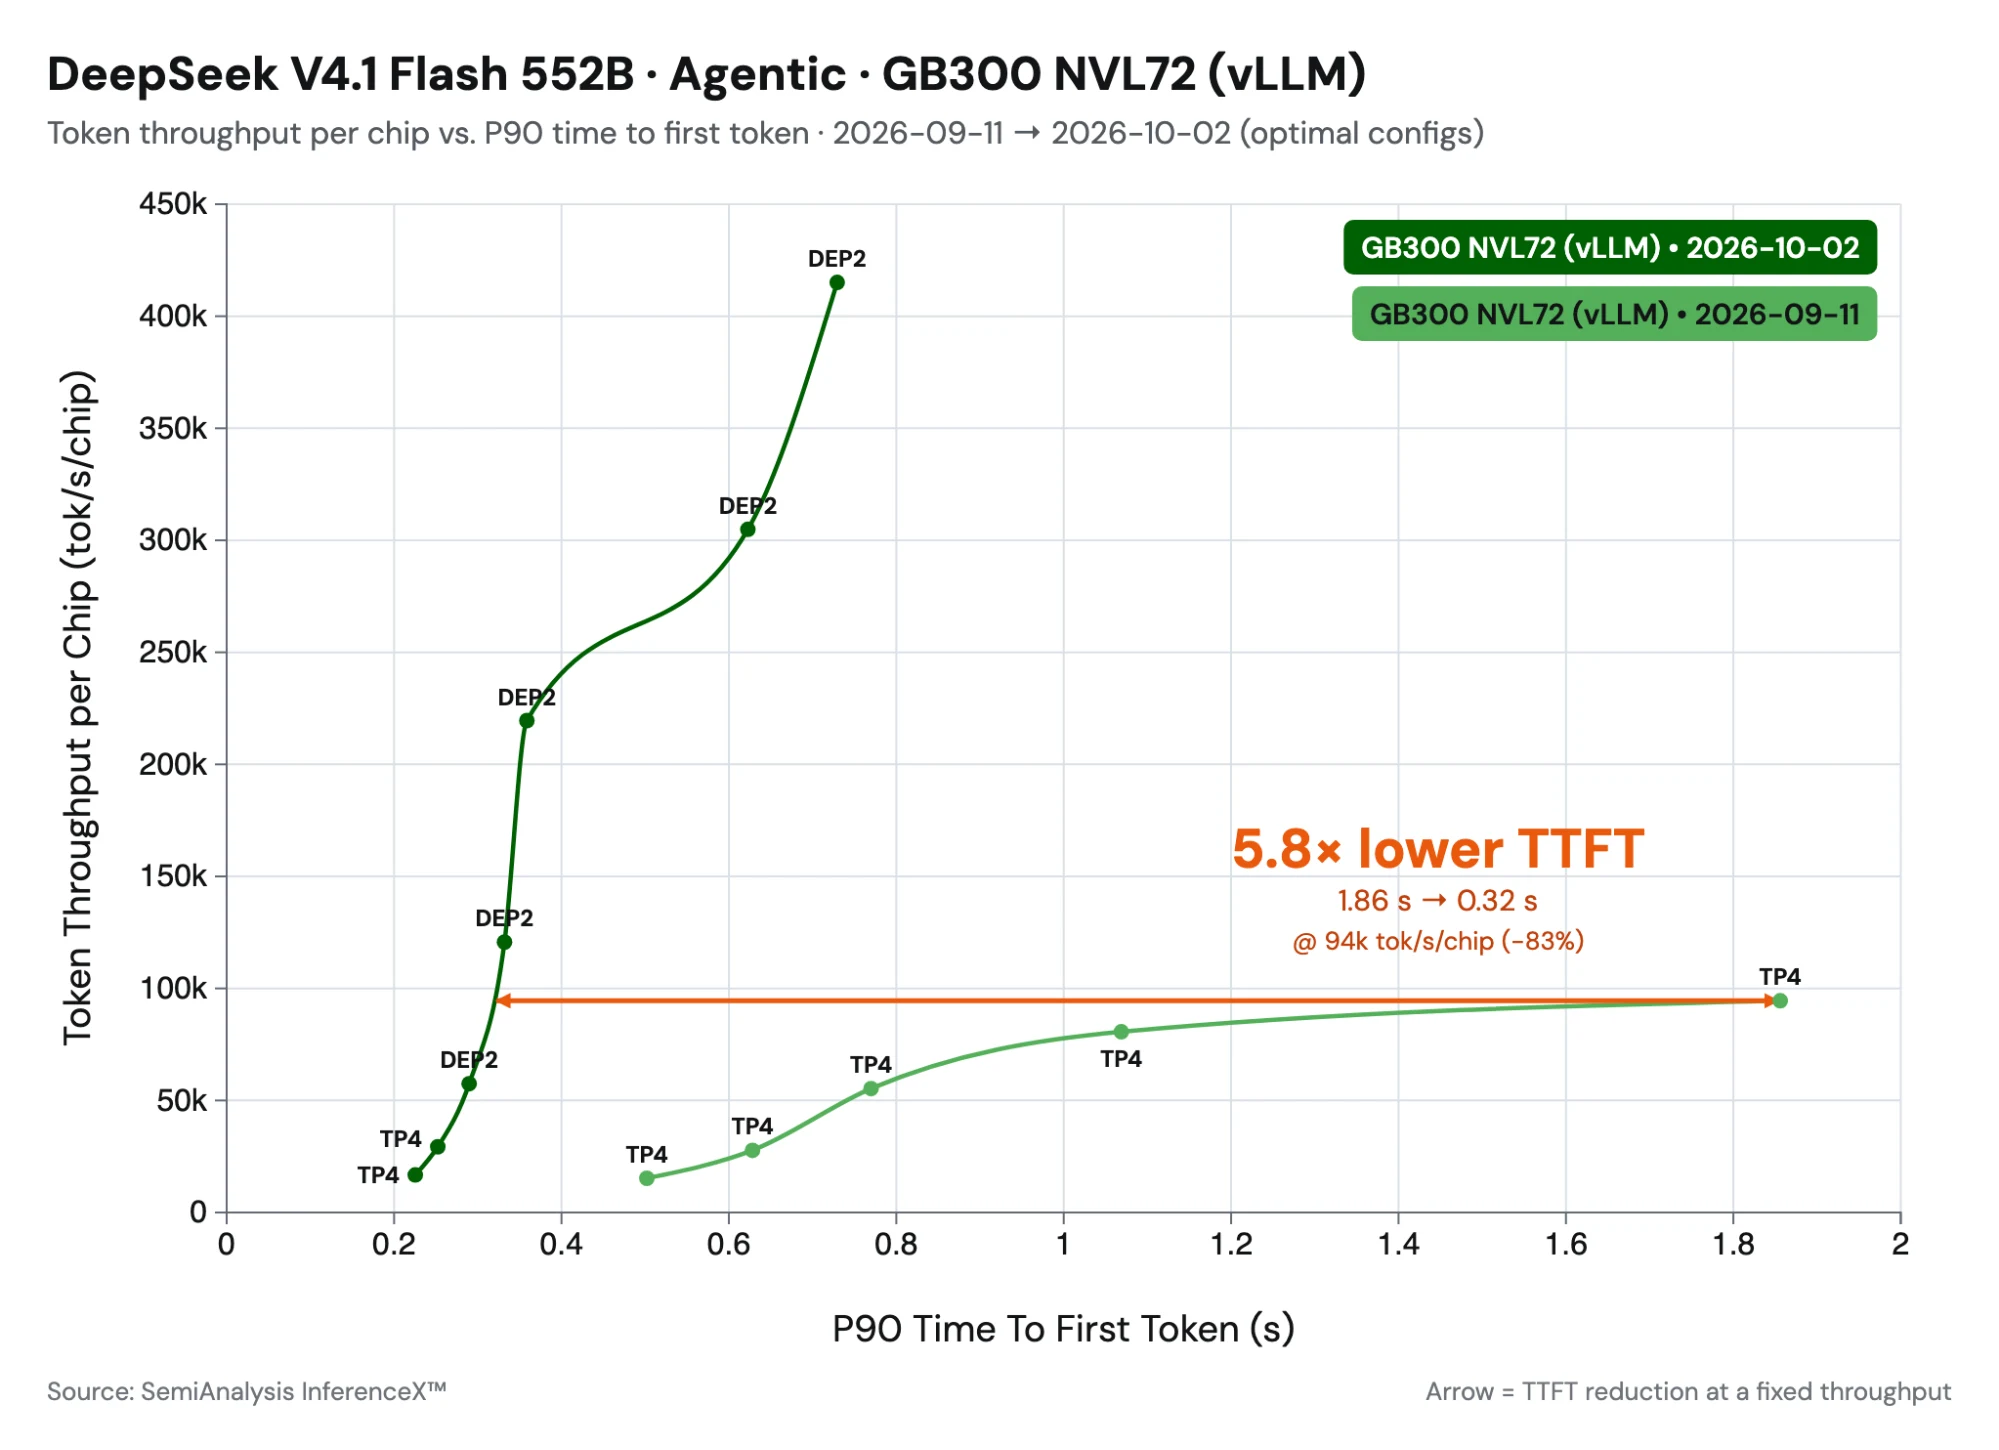
La figure 7 montre le compromis TTFT–débit optimisé. À un débit d'environ 100K, le TTFT baisse de près de 70 % grâce à trois optimisations combinées :
-
La relecture bornée SWA permet à la moitié supérieure du modèle de ne traiter que les 128 derniers tokens, réduisant de moitié environ le calcul de préfill.
-
Les CUDA graphs maintiennent la petite relecture tronquée rapide sur le GPU au lieu d'être limitée par les lancements de noyaux sur CPU, ce qui nous permet de concrétiser pleinement le gain de vitesse.
-
Les améliorations des noyaux accélèrent le calcul du modèle.
Remerciements
Nous remercions DeepSeek d'avoir rendu DeepSeek-V4.1-Flash et les noyaux associés open source, l'équipe Inferact pour la mise en service initiale du modèle et les optimisations, NVIDIA pour sa collaboration et son soutien, et SemiAnalysis pour le benchmark AgentX.