
IT之家 Le 8 octobre, lors de la conférence tenue à San Francisco, aux États-Unis, le 7 octobre à 10 heures du matin, heure du Pacifique (1 heure du matin, heure de Pékin, le 8 octobre), Microsoft a annoncé que GitHub Copilot prendra en charge l'inférence de modèles d'IA en local avant la fin du mois,Les développeurs pourront basculer automatiquement ou manuellement entre les modèles cloud et les modèles embarqués.
GitHub Copilot est l'assistant de programmation par IA de Microsoft, intégrable dans des outils tels que Visual Studio Code et le CLI, qui génère des complétions, des explications ou des suggestions de refactoring en fonction du contexte du code.
GitHub Copilot s'appuie actuellement sur des modèles hébergés dans le cloud, un orchestrateur acheminant les requêtes selon les performances, le coût et la précision. Microsoft prévoit d'étendre ce mécanisme avant la fin du mois, permettant à Copilot de choisir automatiquement entre les modèles cloud et les modèles d'IA locaux, en coordonnant les tâches d'inférence en arrière-plan.
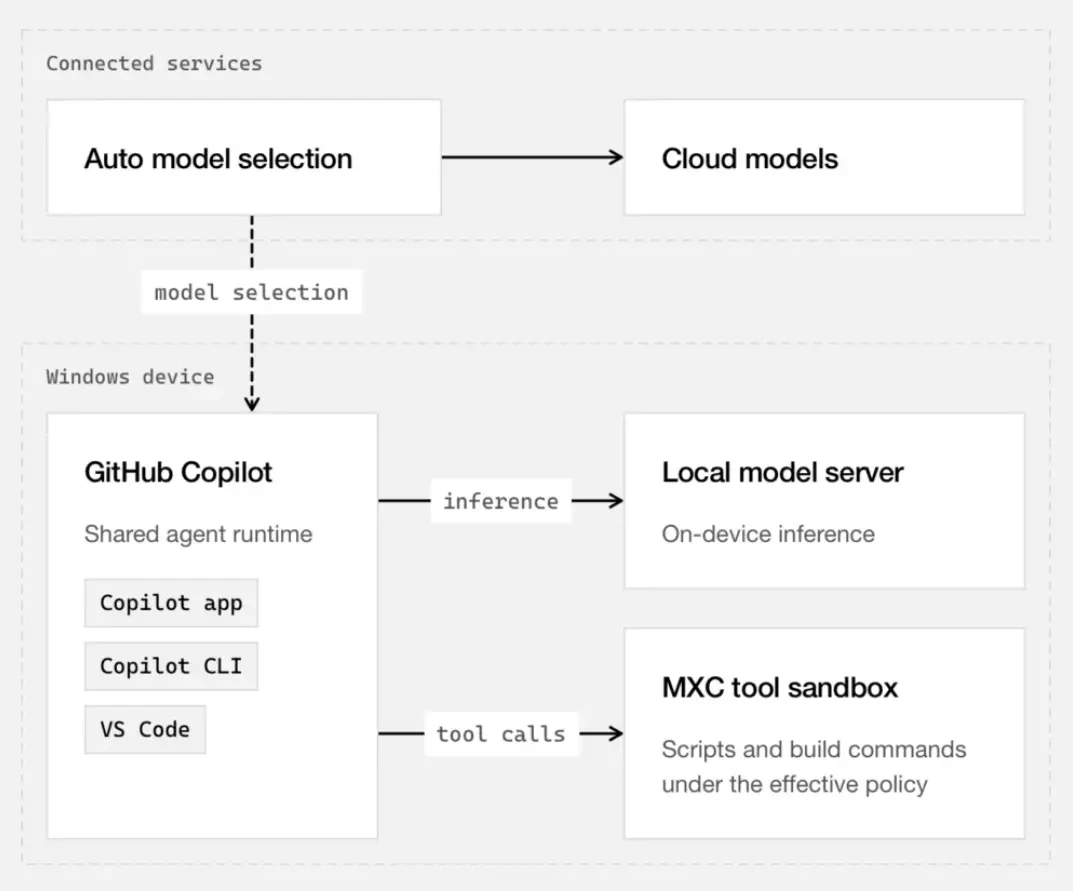
Microsoft propose aux utilisateurs de GitHub Copilot deux modes : orchestration automatique ou usage forcé du modèle embarqué. Les utilisateurs peuvent définir leurs préférences dans GitHub Copilot CLI, l'application Copilot et Visual Studio Code.
La sélection du modèle local prend en charge la spécification d'un fournisseur, d'un modèle ou d'un point de terminaison ; les développeurs peuvent choisir MAI Code 1.1 Flash via Windows ML, ou se connecter à un point de terminaison local compatible OpenAI et utiliser le modèle qu'il expose.
Microsoft lance MAI Code 1.1 Flash, un modèle « mélange d'experts » de 137 milliards de paramètres au total et 6,8 milliards de paramètres actifs, utilisant la quantification et le décodage spéculatif pour optimiser la vitesse de réponse et l'occupation mémoire.
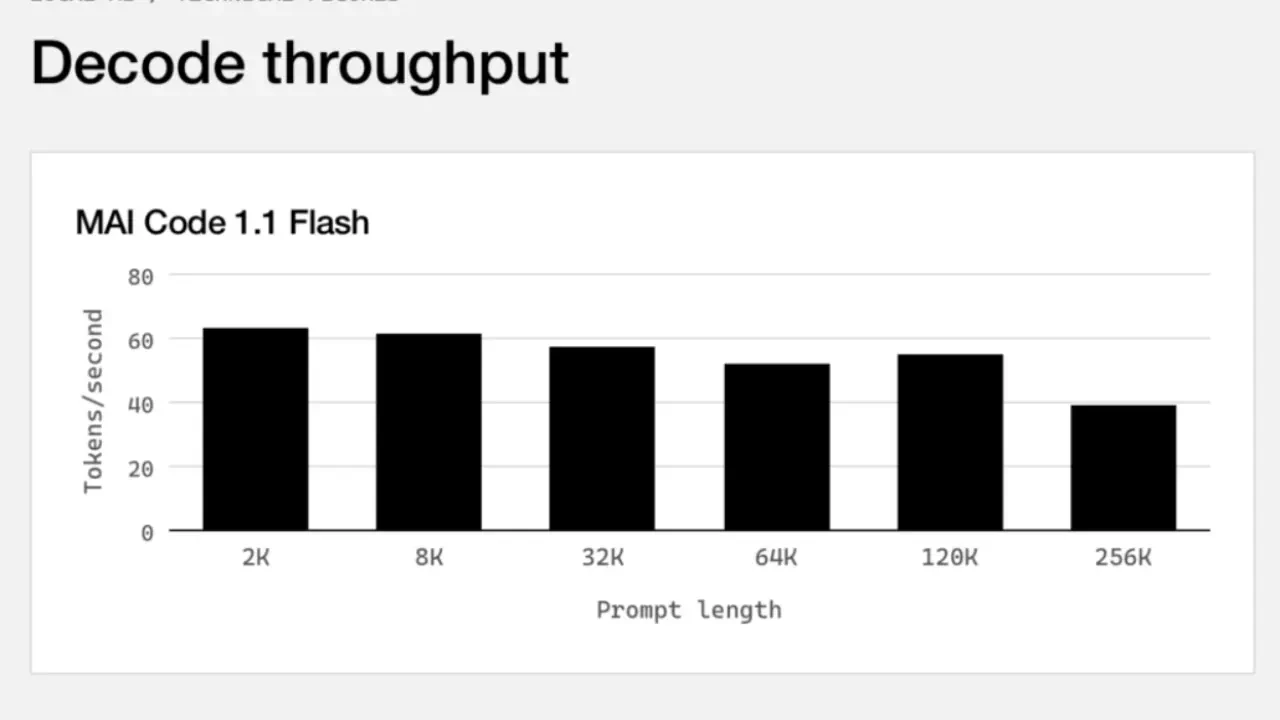
Les tests du modèle sur Surface Laptop Ultra montrent des améliorations significatives du pic d'utilisation mémoire, de l'utilisation des tokens et de la vitesse de traitement dans les tâches complexes. Les tests de débit de décodage montrent qu'avec des prompts de 2K à 256K tokens, le débit se situe entre 40 et 63 tokens par seconde. IT之家 joint les images correspondantes ci-dessous :
Dossier spécial sur la conférence Microsoft Surface Laptop Ultra