
Ce qui a appris à l'IA à résoudre les problèmes de raisonnement abstrait ARC, ce sont... des chats ?
Dans leur dernière article, l'équipe de Kaiming He proposeNAT-ARC, une solution purement visuelle pour résoudre l'ARC.
Elle ne repose pas sur les LLM : elle utilise un pré-entraînement sur des chats, chiens et fleurs d'ImageNet pour apprendre au modèle à « voir », puis transfère cette capacité au raisonnement sur des grilles abstraites.
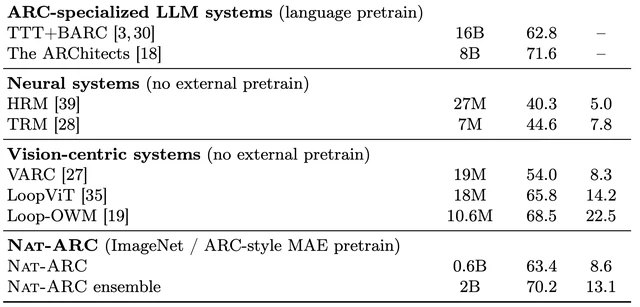
Résultat : le meilleur modèle unique de NAT-ARC atteint un score pass@2 de 63,4 % sur l'ARC-1, et 70,2 % après ensemble.
C'est la première fois qu'une approche purement visuelles'approche du niveaudes systèmes LLM spécialisés.
L'ARC, reconnu comme l'un des tests d'intelligence visuelle les plus difficiles pour l'IA, vous donne quelques exemples d'entrée-sortie de grilles colorées, vous demande d'en déduire la règle de transformation cachée, puis de l'appliquer à de nouvelles grilles.
Jusqu'ici, les solutions dominantes consistaient systématiquement à traduire les grilles en texte ou en symboles, puis à confier le raisonnement à un LLM.
Cet article refuse de le faire, et n'utilise même pas les grilles ARC lors du pré-entraînement.
Les capacités visuelles apprises par le modèle sur le monde réel se sont ainsi naturellement transférées au raisonnement sur des grilles colorées totalement abstraites.
Sur la piste de l'ARC, la montée des solutions visuelles
L'ARC, pour Abstraction and Reasoning Corpus, a été proposé en 2019 par François Chollet, le père de Keras.
Chaque problème de l'ARC suit un format très uniforme : une grille bidimensionnelle d'au plus 30×30, avec au maximum 10 couleurs ; l'énoncé fournit 2 à 5 paires d'exemples entrée-sortie, et le challenger doit inférer la règle de transformation cachée à partir de ces exemples, puis appliquer cette règle à une grille d'entrée entièrement nouvelle pour en prédire la sortie.
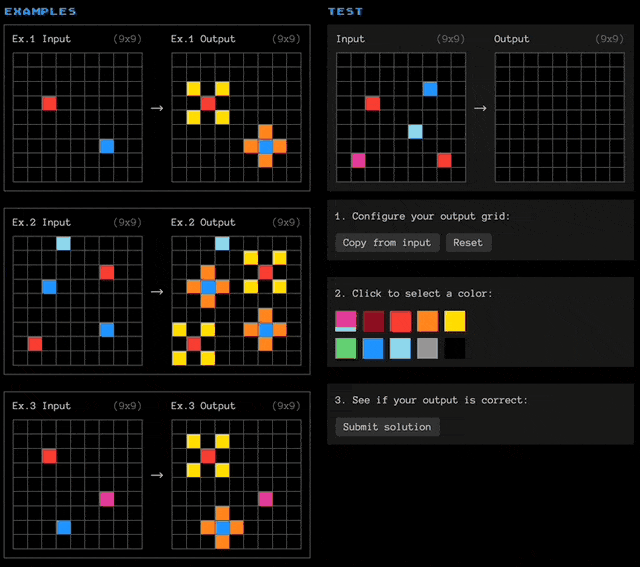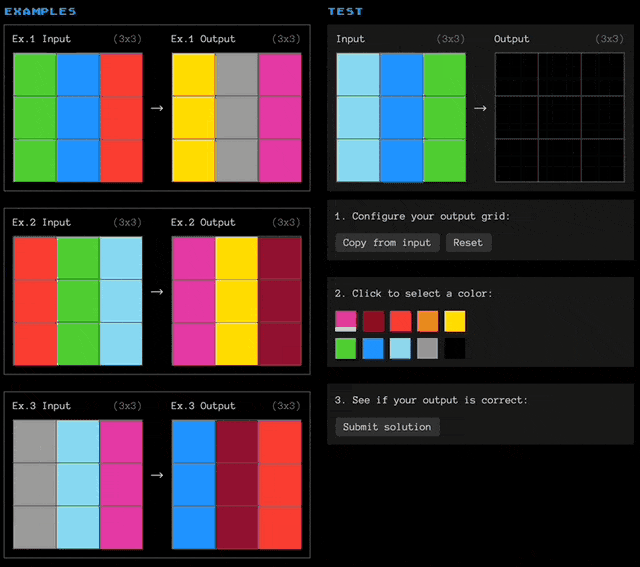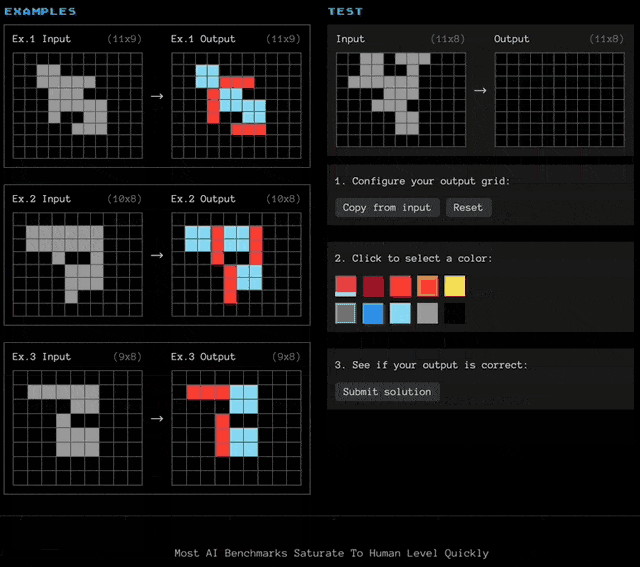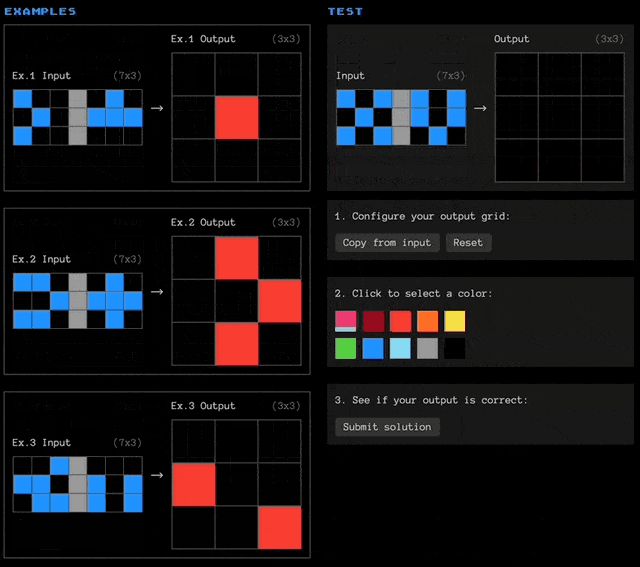
Ces problèmes ressemblent à des jeux d'enfant consistant à trouver des régularités dans des images, mais l'ARC est extrêmement difficile pour l'IA.
D'une part, chaque problème possède une règle de transformation différente, sans modèle fixe à mémoriser.
De plus, les données sont très rares : il faut induire une règle abstraite à partir de deux ou trois exemples et l'exécuter avec précision.
Cette combinaison fait de l'ARCun étalon pour mesurer la capacité de raisonnement abstrait de l'IA。
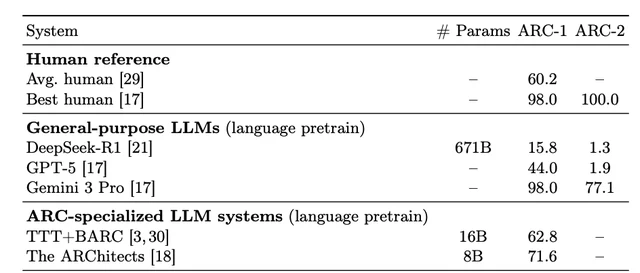
Sur la piste de l'ARC, les solutions dominant actuellement sont presque toutes basées sur les grands modèles de langue, dont l'idée commune est de traduire les grilles en séquences de texte ou de symboles à traiter par des modèles de langue.
La voie visuelle n'a commencé à émerger que plus tard.
Un groupe de chercheurs a suivi une voie complètement différente : au lieu de traduire les grilles en texte, ils les traitent directement comme des images avec des modèles visuels.
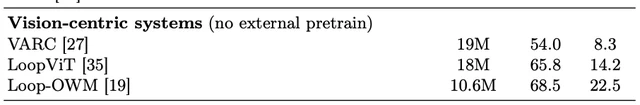
L'étape la plus importante vient du même équipe du MIT, avecVARC, une méthode qui redéfinit l'ARC comme une tâche de traduction conditionnelle d'image à image, atteignant 54 % avec un modèle visuel de 19M de paramètres.
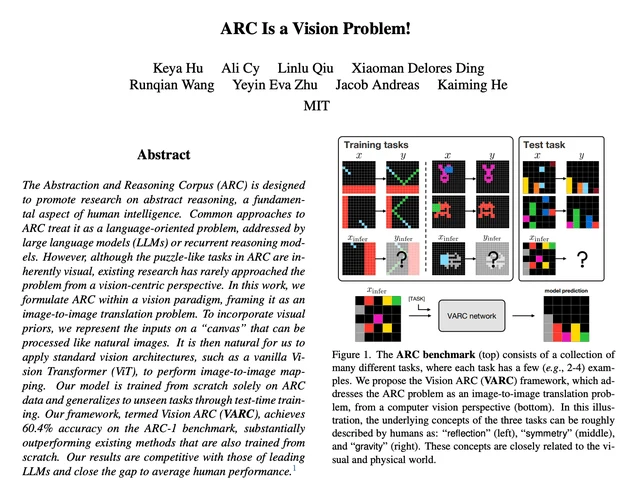
LoopViT ajoute à ce cadre un mécanisme de raisonnement en boucle et atteint 65,8 % avec 18M de paramètres.
Loop-OWM utilise un modèle de pré-entraînement vidéo en few-shot et atteint 68,5 % avec 10,6M de paramètres.
Ces modèles comptent quelques ordres de grandeur de paramètres de moins que les solutions LLM, mais leurs résultats commencent à égaler ces dernières.
Mais la voie visuelle présente toujours une faiblesse structurelle.
Si les LLM réussissent de mieux en mieux sur l'ARC, l'une des raisons principales est qu'ils accumulent des capacités générales grâce à un pré-entraînement sur de vastes corpus : plus le modèle est grand et plus le pré-entraînement est poussé, plus le scaling sur les tâches en aval est marqué.
Or, la plupart des modèles des approches visuelles de l'ARC sont entraînés à partir d'une initialisation aléatoire et ne profitent pas des bénéfices du pré-entraînement.
Sur cette base, l'objectif de NAT-ARC est de combler cette étape de pré-entraînement manquante dans l'approche visuelle, afin de tenter de lever son goulot d'étranglement lié au scaling.
Après avoir vu les chats, place au défi ARC
L'idée centrale de NAT-ARC est deinsérer une étape de pré-entraînement ImageNet MAE au début du pipeline visuel de VARC。
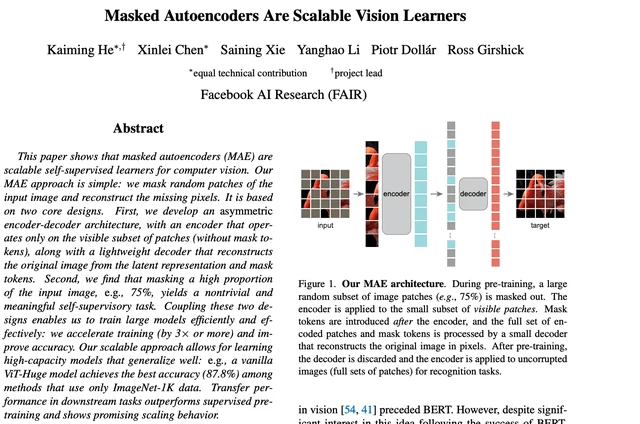
MAE, Masked Autoencoder, est une méthode de pré-entraînement visuel auto-supervisé proposée par Kaiming He en 2022, à l'époque où il travaillait chez FAIR.
Son processus d'entraînement consiste à masquer la majeure partie d'une image et à demander au modèle de reconstituer l'image originale à partir des fragments restants.
Grâce à cette tâche, le modèle peut comprendre la forme, la structure et les relations spatiales des objets.
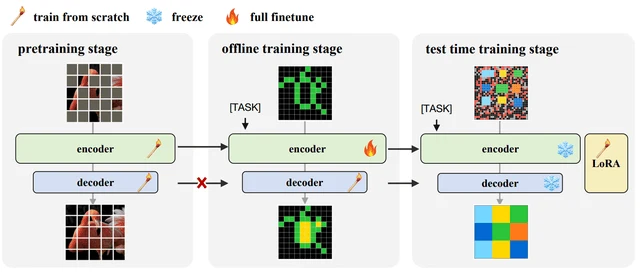
L'approche de NAT-ARC consiste à prendre directement les poids de l'encoder entraîné avec MAE sur ImageNet (un jeu de données contenant environ 1,3 million d'images naturelles de chats, chiens, fleurs, etc.) pour initialiser l'encodeur visuel, tandis que le decoder est entraîné à partir d'une initialisation aléatoire.
L'ensemble du processus se déroule en trois étapes.
- Première étape : pré-entraîner l'encoder avec MAE sur ImageNet ;
- deuxième étape : entraîner hors ligne l'ensemble du codec sur l'ensemble d'entraînement ARC ;
- troisième étape : lors du test, effectuer un fine-tuning LoRA individuellement pour chaque problème.
Pendant la phase de fine-tuning, chaque problème ne dispose que de 2 à 5 paires de démonstrations, et le modèle tente, à partir de ces quelques démonstrations, d'en « apprendre » les règles.
Un détail mérite d'être noté : NAT-ARC a utilisé directement le checkpoint public de MAE, sans dépenser un centime supplémentaire en pré-entraînement.
Cependant, ce checkpoint était conçu à l'origine pour des images ImageNet de plus grande taille, alors que la grille ARC ne fait que 64×64 pixels, soit une différence de taille considérable.
Pour s'adapter, NAT-ARC a abandonné le patch embedding et le codage positionnel d'origine, en ne conservant que les poids du backbone, remplacés par un RoPE 2D comme codage positionnel.
En résumé, NAT-ARC n'a conservé que la capacité d'extraction de caractéristiques visuelles apprise par MAE sur ImageNet, tout en abandonnant entièrement la partie perception spatiale liée à la taille des images ImageNet, pour la réapprendre d'une manière plus flexible.
Mais pourquoi ce qui a été appris en regardant des photos de chats et de chiens peut-il aider au raisonnement sur des grilles abstraites ?
L'article apporte un indice grâce à la visualisation de l'attention.
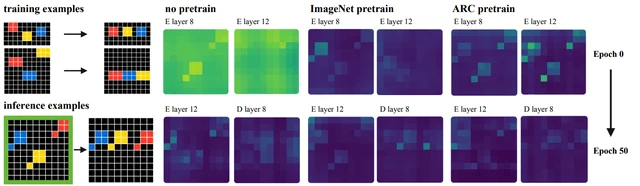
Les chercheurs ont placé devant le même problème ARC des modèles avec trois types d'initialisation (sans pré-entraînement, pré-entraînement MAE sur ImageNet et pré-entraînement MAE sur grilles de style ARC), et ont observé la distribution de leur attention avant même le début de l'entraînement sur ARC.
Le résultat est frappant : l'attention du modèle à initialisation aléatoire est uniformément dispersée, sans aucun point focal ; en revanche, le modèle pré-entraîné sur ImageNet est déjà capable de distinguer le premier plan de l'arrière-plan, et son attention se concentre automatiquement sur les zones de motifs significatifs de la grille.
Ce modèle n'a jamais vu de grilles ARC, mais la capacité « reconnaître un objet en le détachant du fond » apprise sur ImageNet fonctionne naturellement sur les grilles ARC.
Les chercheurs ont poussé plus loin avec une décomposition au niveau des tâches.
Ils ont sélectionné 15 problèmes ARC dont les performances s'étaient nettement améliorées après le pré-entraînement, et ont constaté après annotation manuelle que ces problèmes se regroupaient en deux types de tâches.
Parmi elles, 6 relèvent du match-and-copy : le modèle doit identifier l'objet, la couleur ou le motif correspondant, puis copier la structure correspondante dans la sortie ;
les 6 autres relèvent du connected-component reasoning : le modèle doit identifier, remplir ou recolorer des régions spatialement connexes.
Ces deux types de capacités correspondent précisément aux priors visuels des images naturelles.
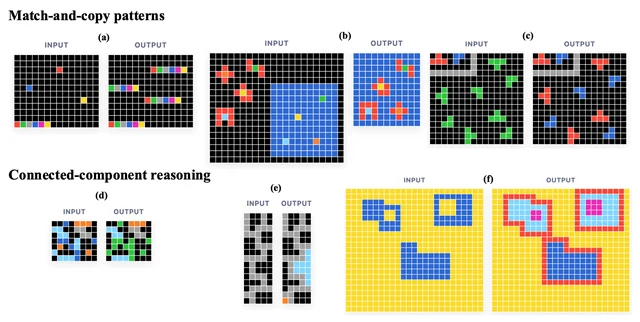
Ce qui a été appris sur ImageNet en regardant des chats, à savoir « séparer le chat du fond d'herbe », devient dans ARC « reconnaître cette région colorée connexe dans la grille ».
La logique sous-jacente du monde visuel et du monde abstrait partage donc, à l'insu de tous, le même jeu de représentations pour des opérations telles que le groupement d'objets, la correspondance de motifs et la segmentation de régions.
Des chats aux chats
Les résultats finaux de NAT-ARC sur l'ARC-1 sont les suivants.
Le meilleur modèle unique utilise l'échelle huge, avec 0,6B de paramètres, et atteint un score pass@2 de 63,4±0,7%.
Pour l'ensemble, les chercheurs ont mis en commun des modèles entraînés respectivement selon trois stratégies de pré-entraînement différentes (sans pré-entraînement, pré-entraînement MAE sur ImageNet, pré-entraînement MAE sur grilles de style ARC) pour un vote majoritaire, obtenant 70,2±0,6% pass@2, avec environ 2B de paramètres au total.
À titre de comparaison, The ARChitects, spécialement affinés pour ARC, ont obtenu 71,6%, avec un modèle de langage de 8B.
L'approche visuelle, avec un quart des paramètres, est venue frapper aux portes des systèmes LLM spécialisés.
Au-delà des chiffres, la découverte la plus importante de cet article est que le pré-entraînement a débloqué le goulot d'étranglement du scaling pour l'approche visuelle.
Sans pré-entraînement, plus le modèle était grand, moins il était performant ; avec le pré-entraînement, le scaling a commencé à produire des gains positifs.
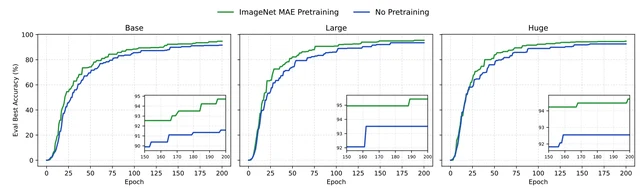
Regardons d'abord les courbes d'entraînement. Pendant la phase d'entraînement hors ligne, les modèles avec pré-entraînement ImageNet convergent nettement plus vite, et ce aux trois échelles base, large et huge, avec en outre une précision finale plus élevée.
Mais la découverte la plus intéressante se cache dans les courbes de scaling.
Sans pré-entraînement, les performances du modèle augmentent encore de base à large, mais chutent paradoxalement de large à huge.
Le modèle grossit et les résultats se dégradent : ce n'est pas un phénomène courant en deep learning, ce qui montre que la quantité de données de la tâche ARC est vraiment trop faible, si bien que l'augmentation de la capacité du modèle n'apporte pas une meilleure généralisation mais du surapprentissage.
En revanche, avec le pré-entraînement ImageNet, la courbe de scaling devient saine : aux trois échelles base, large et huge, la progression monte sans interruption, et plus le modèle est grand, meilleurs sont les résultats.
L'une des expériences les plus cool de l'article est une validation par visualisation.
Les chercheurs ont entraîné un autoencoder qui mappe les images ImageNet vers une représentation en grille discrète de 60×60 avec 10 couleurs, autrement dit une « traduction » d'une photo de chat en grille ARC.
Ensuite, ils ont appliqué à cette grille une transformation ARC avec NAT-ARC — une rotation de 180°, l'ajout d'un bordure bleue — puis l'ont décodée en pixels.
Résultat : le chat a bien été pivoté et la bordure a bien été ajoutée. Le modèle entraîné à partir de chats est ainsi revenu, dans la tâche, au pays des chats.
Cette expérience transforme l'affirmation « les images naturelles et les grilles ARC partagent le même espace de représentation » d'un chiffre statistique en une preuve visuelle.
Les règles de transformation apprises sur les grilles ARC peuvent s'appliquer directement aux représentations latentes d'images naturelles, et inversement.
Le lien entre règles abstraites et représentations visuelles est inhérent à ces deux mondes.
Profil des auteurs
La première auteure de l'article, Xiaoman Delores Ding, membre du MIT CSAIL, vient du groupe de Kaiming He.
Elle est également première auteure de VARC, et NAT-ARC représente en quelque sorte la poursuite de son travail précédent.
Parmi les autres auteures figure Keya Hu (胡珂雅), l'une des premières étudiantes de Kaiming He, diplômée de licence à l'Université Jiao Tong de Shanghai。
On trouve aussi Katelyn Gan et Victor Yin, également du MIT, tous deux étudiants de premier cycle et tous deux student researcher au CSAIL.
L'auteur correspondant, Kaiming He, n'a plus besoin de présentation : il est l'auteur de ResNet et de MAE, deux travaux qui relient presque à eux seuls le fil conducteur de l'IA visuelle de la dernière décennie.
Depuis son arrivée au MIT, il produit continuellement des travaux fondamentaux en vision, et cet article utilise précisément MAE, qu'il a proposé il y a quatre ans, comme outil de pré-entraînement — comme s'il ouvrait une nouvelle voie avec sa propre vieille arme.
VARC a été accepté à CVPR 2026, et NAT-ARC en est la suite directe.
Avec deux articles consécutifs, cette équipe persiste dans la voie purement visuelle pour résoudre ARC ; sur une piste dominée par les LLM, elle repousse sans cesse, à coups de données expérimentales, le plafond de l'approche visuelle.
Adresse de l'article :
https://eccv.ecva.net/virtual/2026/poster/5527