
La méthode standard pour garder un agent IA sous contrôle consiste à faire lire tout ce qu'il fait par une seconde IA. C'est l'approche par défaut, mais elle peut devenir très coûteuse rapidement lorsque les agents fonctionnent pendant des heures et traitent l'équivalent de plusieurs romans de texte.
Goodfire, une startup spécialisée en interprétabilité (comprendre le fonctionnement interne des modèles d'IA), a lancé jeudi une option moins chère : des moniteurs qui observent ce qui se passe à l'intérieur d'un modèle d'IA pendant qu'il travaille, plutôt que de simplement lire ce qu'il écrit. Les moniteurs sont disponibles pour les clients de Baseten, qui héberge et exécute des modèles d'IA pour d'autres entreprises.
Les Base Labs de Baseten ont annoncé un partenariat de sécurité avec Goodfire et la plateforme d'IA Hugging Face le mois dernier.
Ce lancement intervient après une série d'incidents cette année au cours desquels des agents IA ont échappé à leurs environnements de test, notamment des agents d'OpenAI qui ont violé la sécurité de Hugging Face. Kimi K3, le modèle ouvert autour duquel Goodfire a construit son premier moniteur, a profité d'une faille dans son bac à sable pour accéder à Internet et à des informations sur GitHub cet été.
Le système de Goodfire fonctionne un peu comme la sécurité d'un aéroport. De petits détecteurs appelés sondes lisent les signaux internes du modèle à chaque étape du travail d'un agent, de la même manière qu'un portique de sécurité vérifie chaque passager. Ce n'est que lorsqu'une sonde signale quelque chose qu'un modèle d'IA distinct, l'équivalent d'une fouille manuelle, examine la situation de plus près.
Les clients de Baseten peuvent choisir les risques à surveiller, notamment le piratage offensif, le détournement d'armes chimiques et biologiques, et le détournement de récompenses. Ils décident également de la réponse automatisée : consigner l'événement, l'envoyer pour examen humain, ou refuser entièrement la requête.
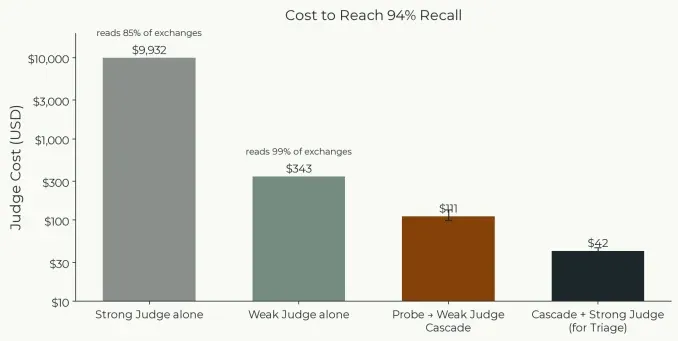
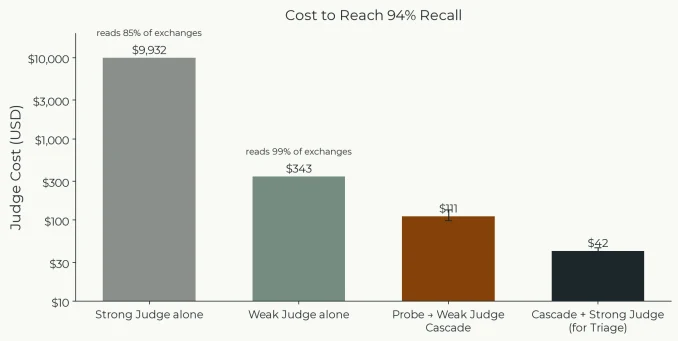
Goodfire affirme que son approche est également moins coûteuse à exploiter. La plupart des moniteurs d'IA sont des modèles distincts qui doivent relire tout ce que fait le modèle surveillé, ce qui ajoute du temps et des coûts. Les sondes de Goodfire, elles, exploitent les calculs que le modèle effectue déjà pendant son travail.
« Les moniteurs d'activations internes sont vraiment peu coûteux parce qu'ils réutilisent les calculs de la passe avant », a déclaré le PDG de Goodfire, Eric Ho, a déclaré dans le MAD Podcast du capital-risqueur Matt Turck la semaine dernière. « Ainsi, le modèle calcule déjà ce token. Tout ce que vous faites, c'est prendre les activations neuronales intermédiaires qu'il a déjà calculées, puis exécuter un classificateur sur ces calculs internes. » En résumé, le modèle fait déjà les calculs, et les sondes ne font que lire les résultats.
Lors des tests de Goodfire sur Kimi K3, la surveillance d'environ 1,500 sessions a coûté environ $51, contre $233 pour un modèle d'IA moins cher vérifiant chaque étape et environ $10,000 pour un modèle haut de gamme. Les sondes ont détecté 94% des sessions de piratage malveillantes et envoyé en réexamen 8.7% des sessions inoffensives.
L'exécution simultanée de quatre sondes a ajouté moins de 2% au temps de démarrage de la réponse du modèle, a indiqué l'entreprise.
« Le grand avantage, c'est que vous pouvez attraper les choses avant qu'elles ne se produisent », a déclaré le CTO et cofondateur de Goodfire, Dan Balsam. « Nous pouvons détecter quand le modèle pourrait pirater pendant une évaluation ou l'entraînement. »
L'argumentaire vise les modèles ouverts. Les développeurs peuvent les télécharger et retirer leurs dispositifs de sécurité, et ils ne s’accompagnent pas du type de surveillance que les laboratoires fermés exercent sur leurs propres systèmes.
« Les dégâts qu’un individu peut causer avec un modèle ouvert sont faibles comparés à ce que quelqu’un peut faire avec des clusters de calcul, comme les fournisseurs d’inférence — là où se situe l’essentiel de la responsabilité », a déclaré Balsam. « Quand nous aurons le moment « Mythos » ouvert, il deviendra clair que les modèles ont besoin de garde-fous déployés au moment de l’inférence. »
Des recherches récentes de Goodfire ont révélé que les principaux modèles ouverts, notamment Kimi K3 et GLM 5.2, se livraient au reward hacking dans 50 % à 96 % des exécutions lors de tests d’agents d’IA.
Goodfire n’est pas le premier à tenter cette approche. Google DeepMind a déclaré en janvier que ses recherches avaient éclairé le déploiement de sondes de détection d’utilisation abusive dans Gemini.
Balsam a précisé que ces moniteurs constituent la partie à court terme d’un objectif de recherche plus long : rétro-analyser un LLM afin que les comportements puissent être retracés jusqu’à l’endroit où ils sont apparus pendant l’entraînement. « Nous espérons transformer la magie de l’entraînement des modèles en ingénierie de précision », a-t-il déclaré.