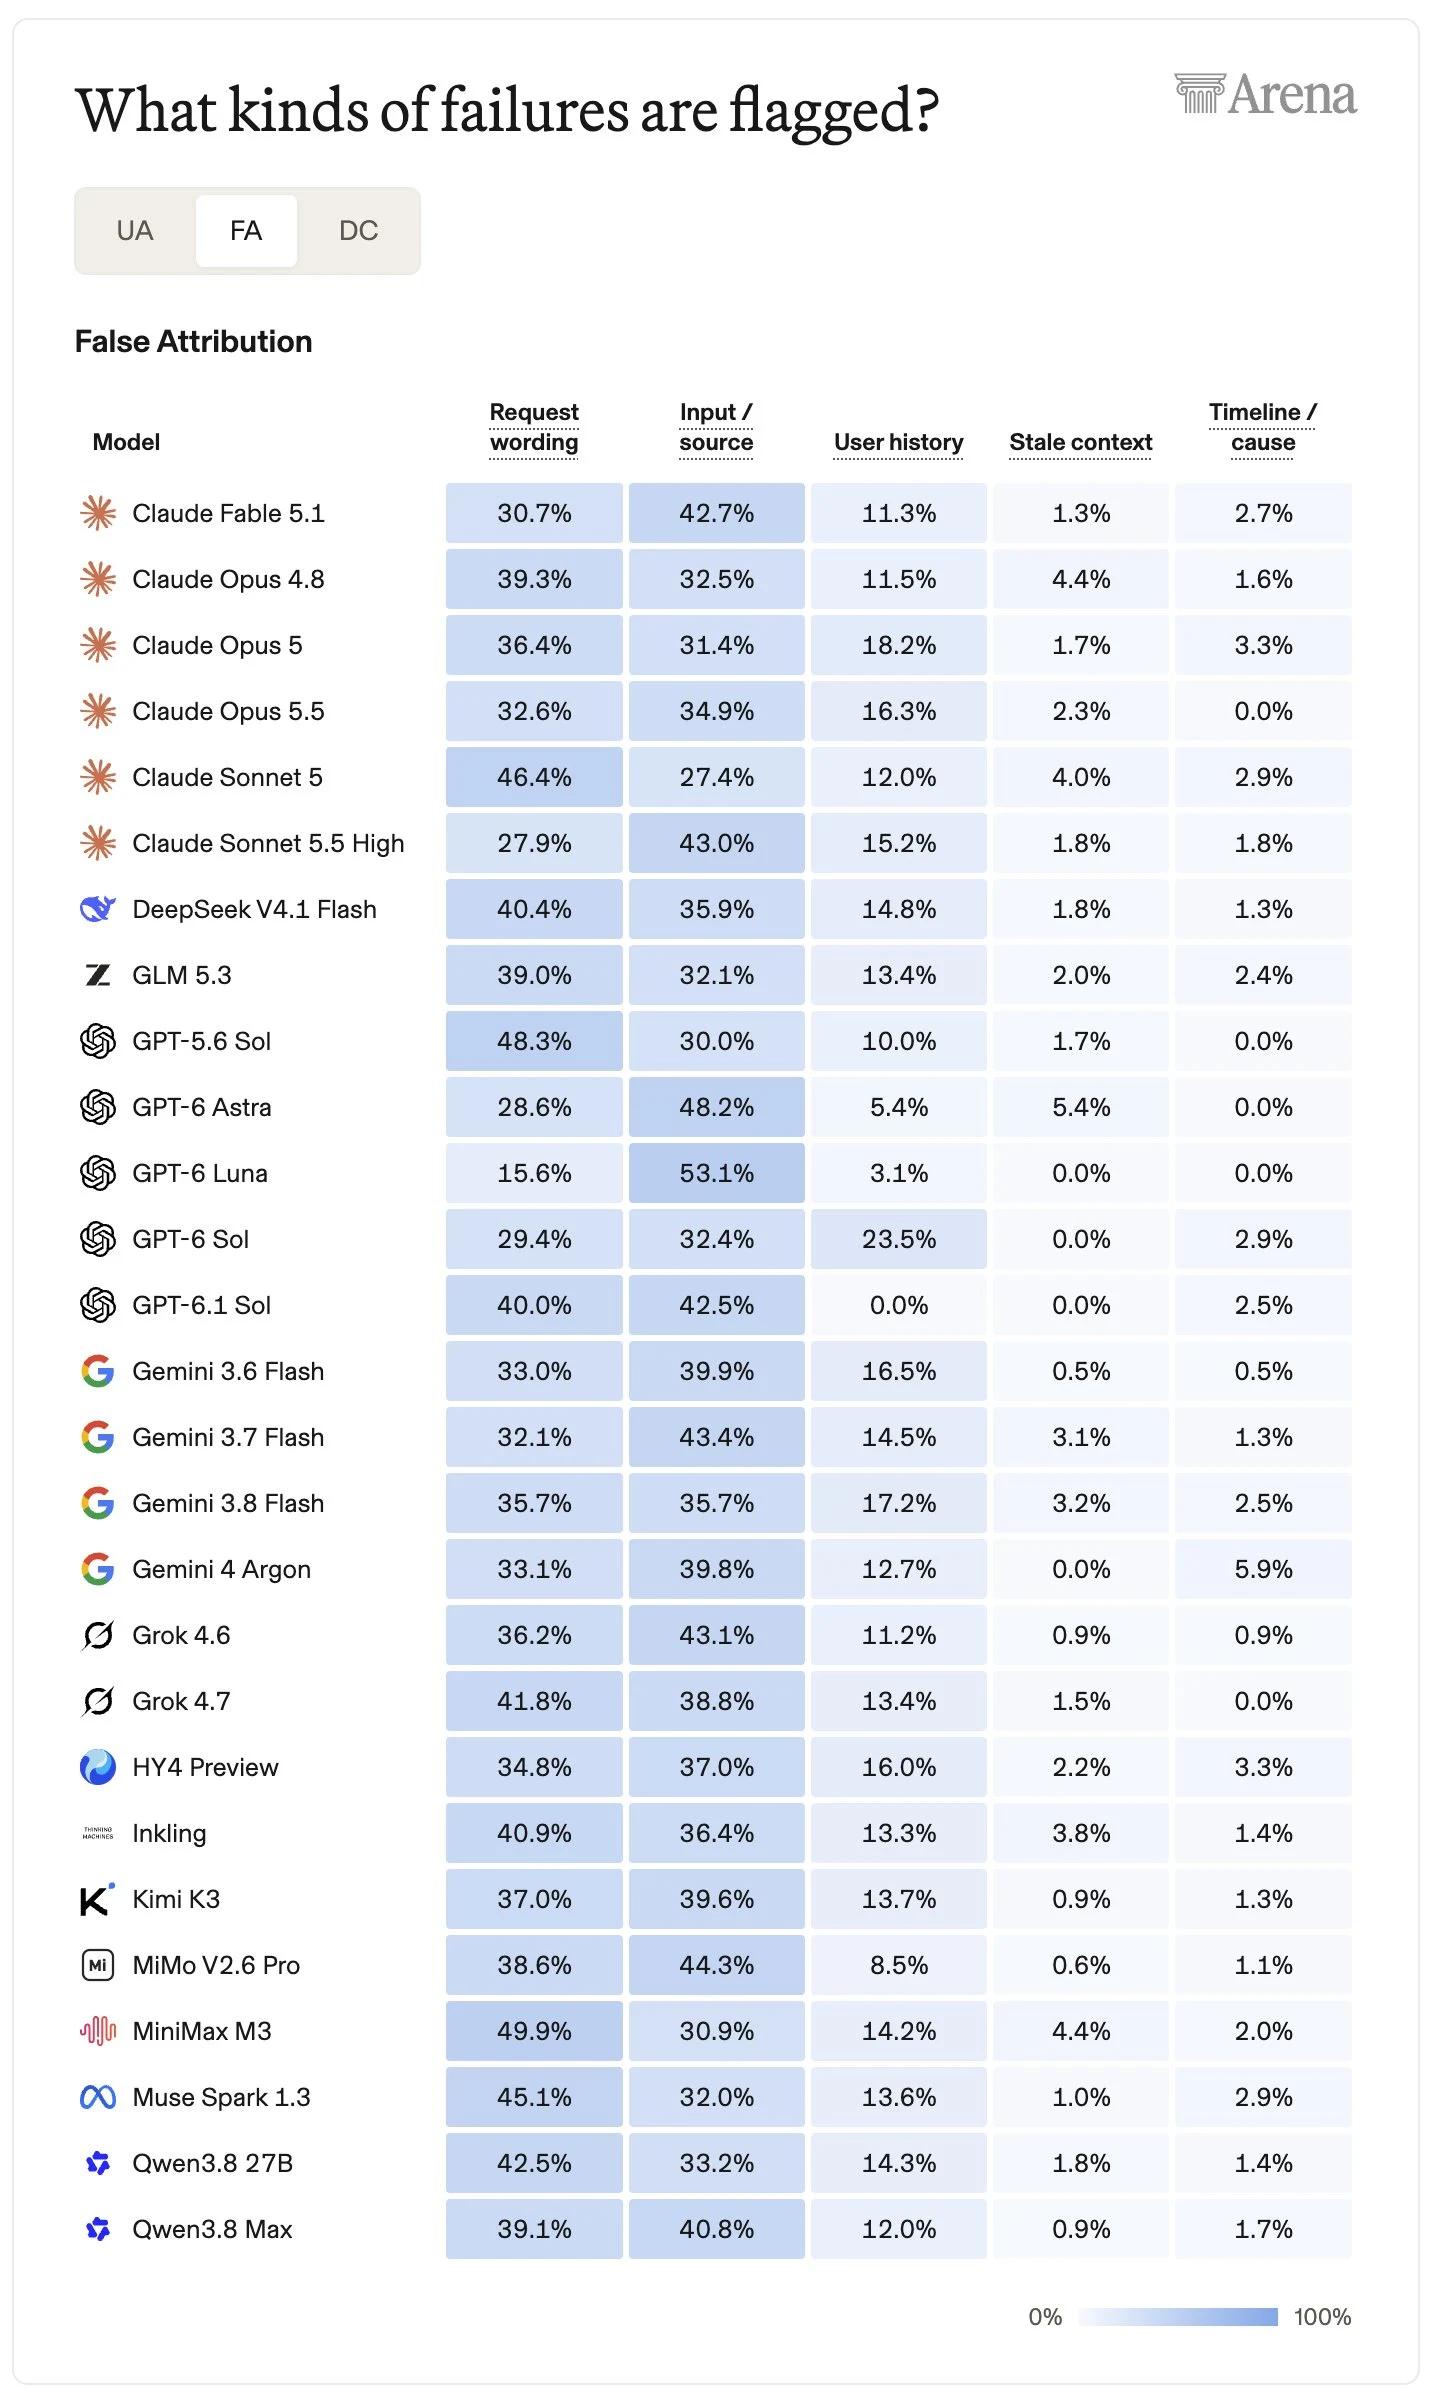
Nous avons également examiné le phénomène de l’attribution fausse, où l’agent attribue une déclaration, une demande, une choix, une approbation ou un fait au utilisateur, mais les preuves fournies par l’utilisateur contredisent cette attribution.
Intéressant, nous avons vu certains modèles se tromper dans leur citation de l’utilisateur (se tromper sur ce que l’utilisateur avait demandé), tandis que d’autres attribuent le travail à un autre utilisateur.
Il y avait des schémas variés entre les modèles : les GPT-6 Luna et Astra étaient rarement mal cités (15,6 % et 28,6 % respectivement), mais souvent mal attribués (53,1 % et 48,2 %). Il est intéressant de noter que le modèle frère GPT-6 Sol présente le taux le plus élevé de mauvaise représentation de l’histoire utilisateur (23,5 %).