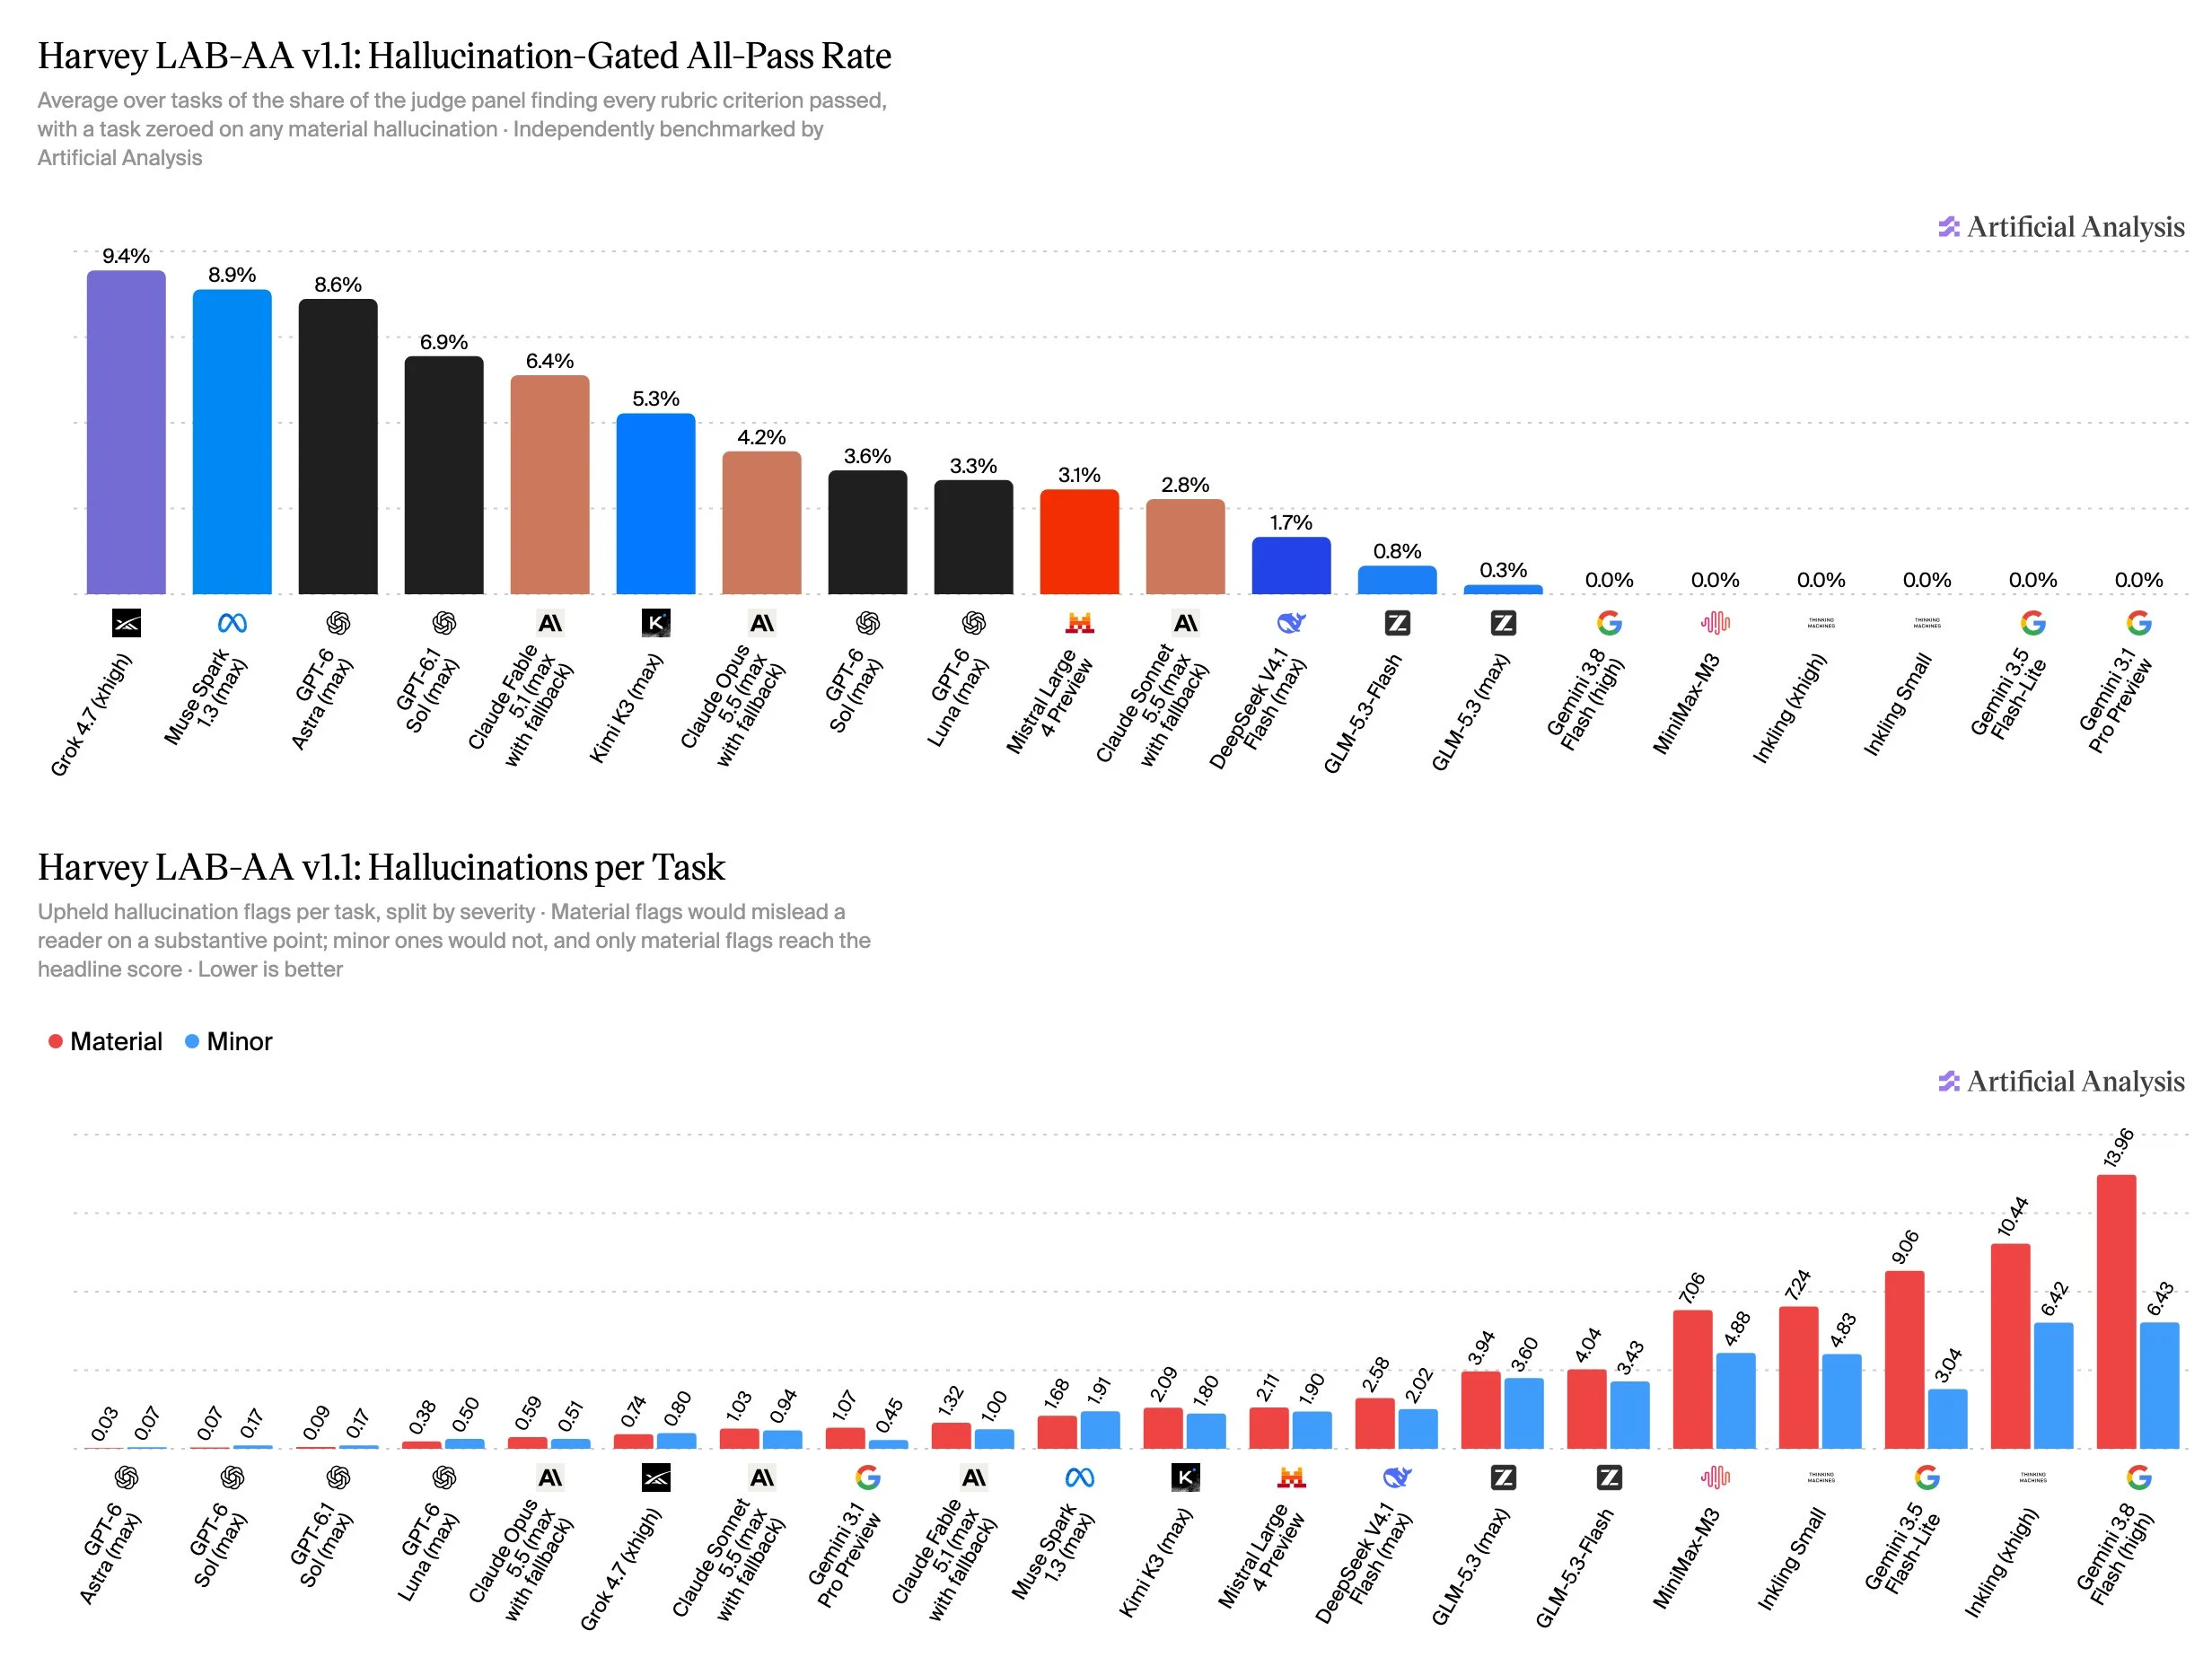
Aujourd’hui, nous annonçons Harvey LAB-AA v1.1 en collaboration avec Harvey. Cette version met à jour notre méthodologie de scoring pour le Legal Agent Benchmark (LAB) en intégrant un test d’hallucination et en exigeant des réponses correctes afin d’éviter les déclarations inexactes. La nouvelle métrique clé de LAB-AA v1.1, la Hallucination-Gated All-Pass Rate, ne attribue des points à une tâche que lorsque les livrables respectent tous les critères et ne contiennent aucune hallucination.
Nous définissons une hallucination matérielle comme une erreur qui pourrait tromper le lecteur sur un point essentiel, tel qu’une date requise contractuellement incorrecte. Une hallucination mineure, en revanche, est une erreur réelle qui est peu susceptible d’affecter significativement l’interprétation juridique d’un document livré. Les hallucinations mineures sont rapportées séparément et n’affectent pas la note principale.
Grok 4.7 (xhigh) occupe la première place avec un taux de passage global géré par leshallucinations de 9,4 %, et plus de 60 % des résultats qui passent normalement sur les modèles testés au lancement comportent une hallucination matérielle.
C’est la première étape pour améliorer la méthodologie de Harvey LAB-AA. Dans les mises à jour futures, nous travaillons avec Harvey pour prendre en compte l’ensemble des facteurs que les avocats considèrent importants, y compris des fonctionnalités d’utilisabilité telles que le style et le ton.
Points clés :
➤ En tête du classement : Grok 4.7 (xhigh) de @SpaceXAI, avec un taux de passage total géré par les hallucinations de 9.4 %, légèrement devant Muse Spark 1.3 (max) de @AIatMeta à 8.9 % et GPT-6 Astra (max) de @OpenAI à 8.6 %
➤ Les hallucinations modifient le classement : sans la porte d’hallucinations, Muse Spark 1.3 (max) serait clairement en tête avec un taux de passage total de 26.7 %, mais deux tiers de ces passages comprennent une ou plusieurs hallucinations matérielles, ce qui donne un taux de passage total avec gestion des hallucinations à 8.9 %. GPT-6 Astra (max) conserve presque tous ses passages après la porte d’hallucinations (8.9 % à 8.6 %) et passe du 10e au 3e rang conjoint.
➤ La famille de modèles GPT-6 est la plus fiable : GPT-6 Astra (max) a en moyenne 0,03 hallucinations matérielles par tâche (4 entre 120 tâches), tandis que GPT-6 Sol (max) a en moyenne 0,07. Lors de la comparaison de six modèles checker sur un sous-ensemble de 20 tâches, GPT-6 Astra n’a aucune hallucination matérielle sous aucun checker, y compris Claude Opus 5,5 (haute). En comparaison, Gemini 3,8 Flash (haute) a en moyenne 13,96 hallucinations matérielles par tâche.
➤ Les modèles à meilleur score ne sont pas les plus chers : Grok 4.7 (xhigh) occupe la première place sur le classement, pour un coût d’environ 9,50 $ par tâche, soit moitié du coût de Claude Fable 5.1 (max avec fallback) à environ 21,70 $, le modèle le plus cher. Muse Spark 1.3 (max) représente une performance forte pour son coût, se classant en deuxième position pour environ 4,20 $ par tâche.
Merci à @nikogrupen et @ItsJulioPereyra de @harvey pour leur travail sur Harvey LAB et leur collaboration.