IT之家 Le 12 octobre, Alibaba Qwen a officiellement lancé aujourd'hui QwenGyre, un cadre d'apprentissage par renforcement en ligne destiné aux tâches d'agents de longue durée.
Selon la présentation officielle, lorsqu'un agent entreprend un travail complexe, une exécution dure souvent plusieurs heures, avec des centaines de tours d'interactions interdépendantes entre le modèle et l'environnement, pour un total de token traités de l'ordre du million. Grâce à une orchestration élastique et au traitement des trajectoires, QwenGyrepermet de faire de ces tâches ultra-longues une source d'entraînement efficace,tout en apportant des gains de capacité et d'efficacité。
QwenGyre peut diviser les GPU en plusieurs unités de calcul : dès qu'un lot de tâches se termine, les unités libérées passent à l'entraînement, un peu comme dans une équipe de projet où celui qui rend son travail en premier rejoint d'abord la rétrospective. Les tâches encore en cours ne sont absolument pas perturbées : leur progression et leur état sont conservés sur place, et même le cache déjà calculé est déplacé en entier, évitant de repartir de zéro. Les unités nouvellement libérées rejoignent directement l'entraînement du tour en cours — ceux qui calculent vite font plus — et enfin les unités centrales agrègent les résultats pour effectuer une mise à jour des paramètres.
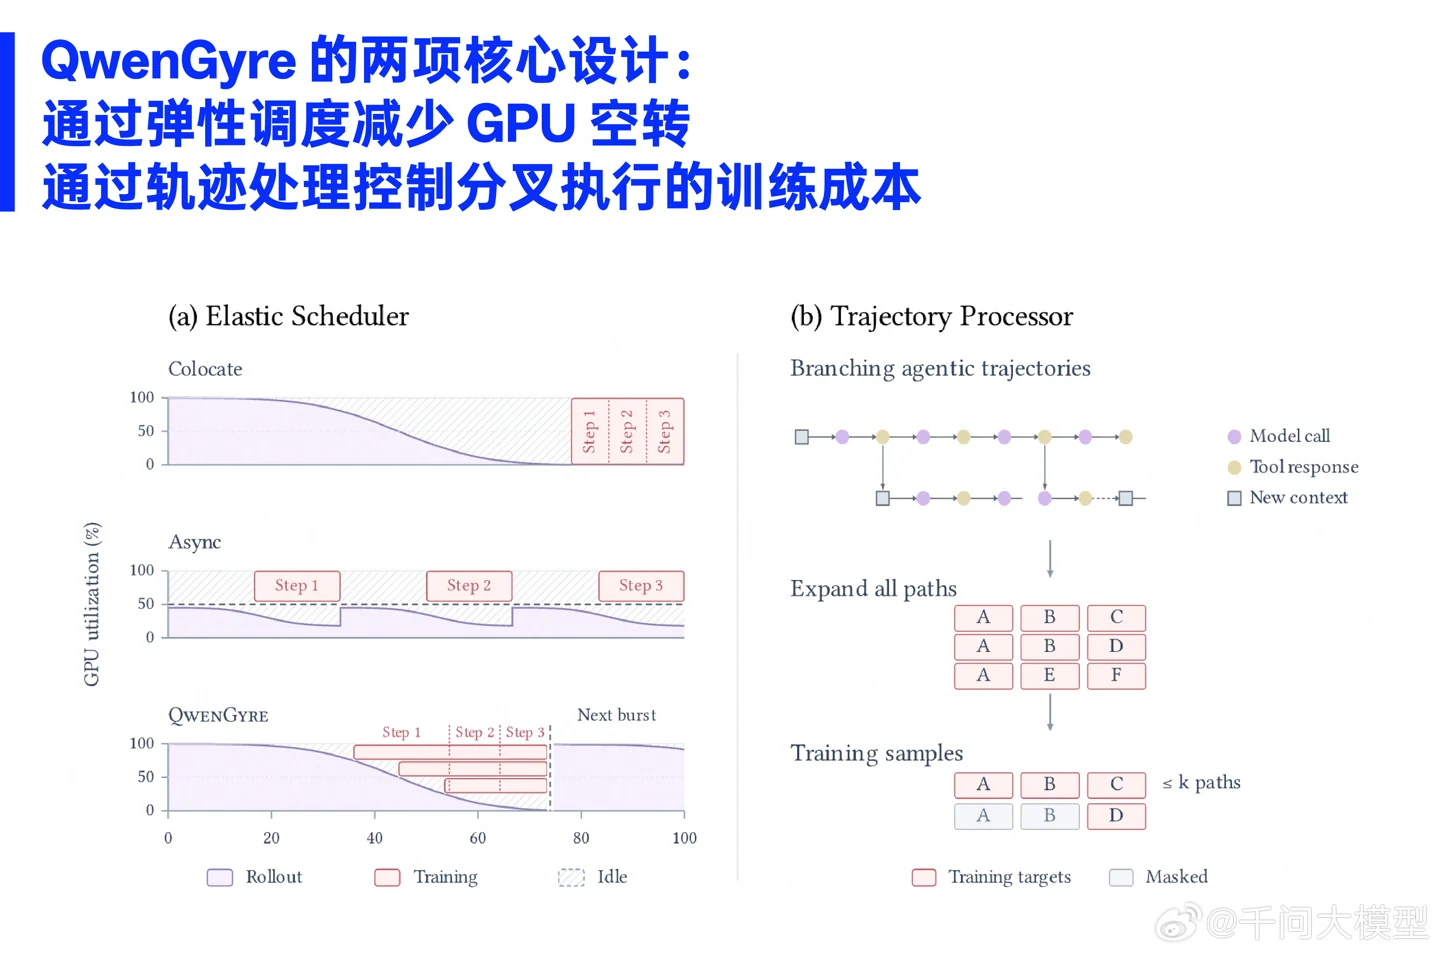
IT之家 note que QwenGyre peut enregistrer via Token-in Token-out le contexte réel de génération de chaque segment de sortie, organiser les trajectoires en arbre selon les préfixes partagés, et ne déployer en échantillons d'entraînement que les chemins sélectionnés. Par ailleurs, les tâches expirées mais partiellement achevées peuvent fournir un retour utile grâce au Partial Scoring, sans gaspiller le moindre effort.
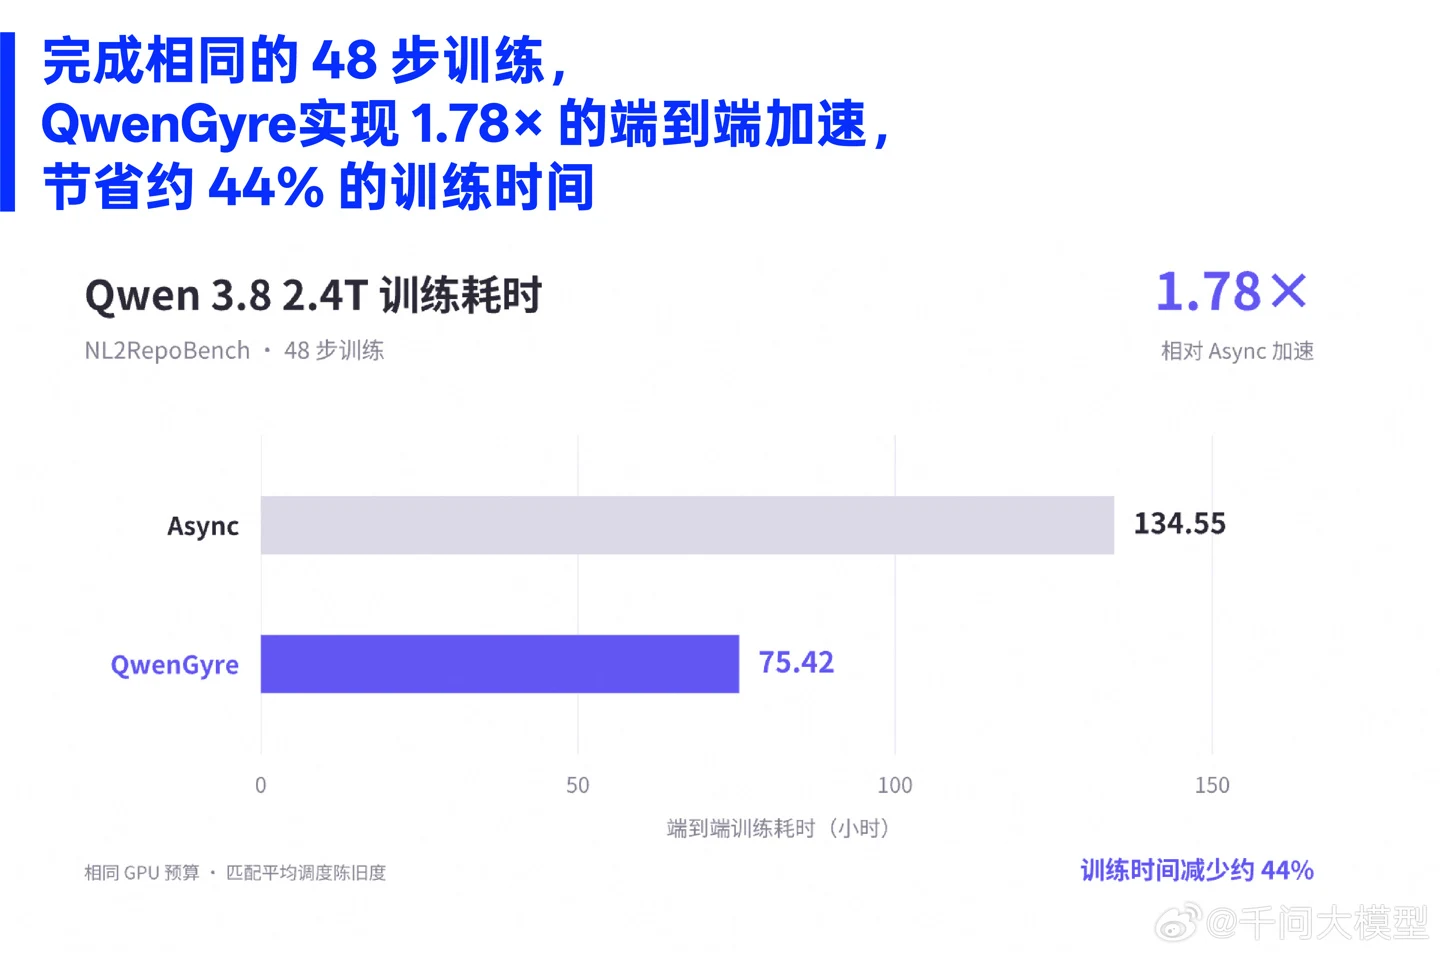
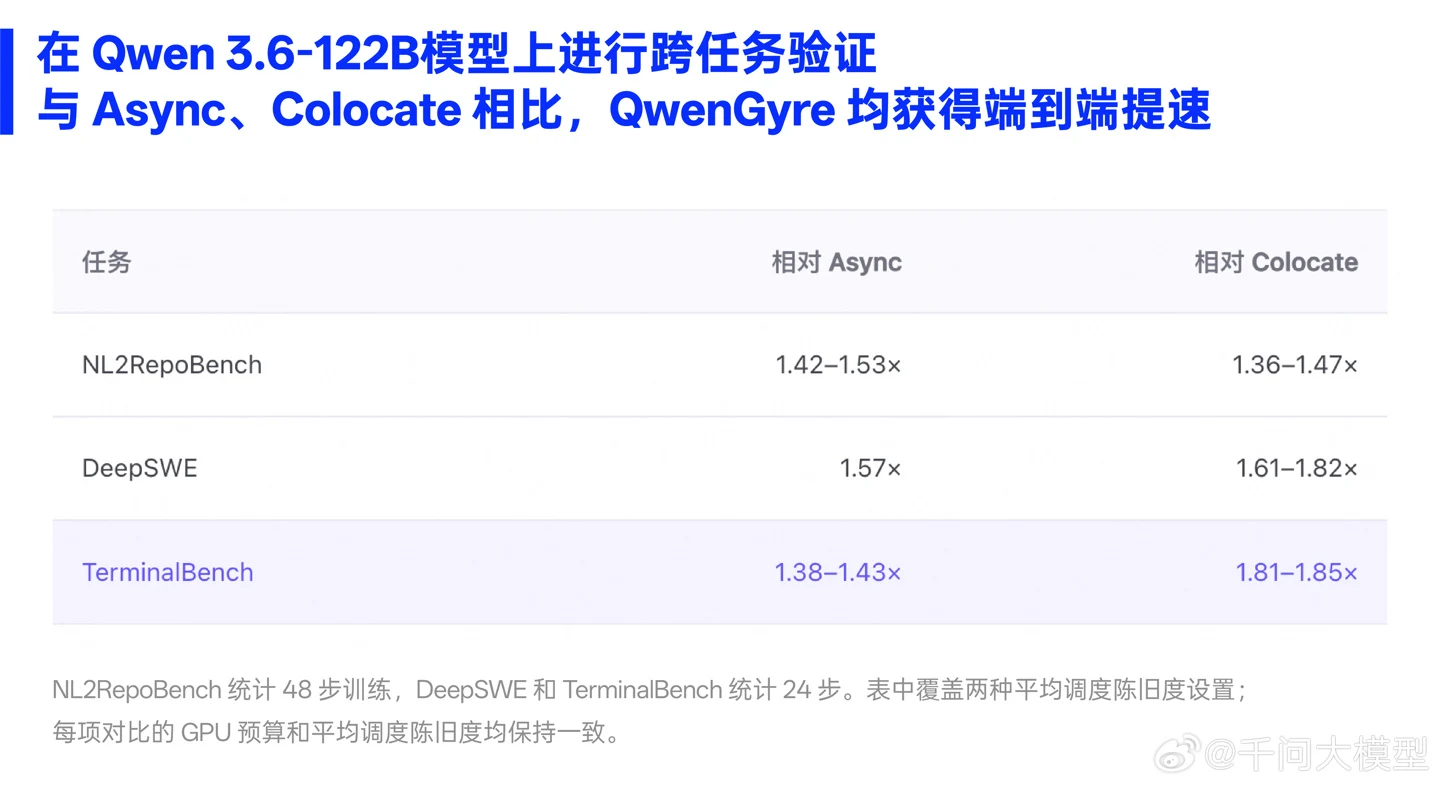
Côté performances, dans l'expérience d'apprentissage par renforcement en ligne NL2RepoBench, l'entraînement a été mené avec des tâches d'environ 70 万 tokens par rollout ; après 48 étapes d'entraînement, le taux de réussite du modèle est passé de 52.5% à 58.5%. À budget GPU identique, QwenGyre atteint une accélération de bout en bout de 1.78× par rapport à Async, avec des scores d'entraînement proches d'Async et de Colocate. Lors des validations multi-tâches sur Qwen3.6-122B, les trois types de tâches NL2RepoBench, DeepSWE et TerminalBench ont tous bénéficié d'une accélération de bout en bout.