
Les modèles d'IA pourraient être capables de s'autorépliquer sans accès à un datacenter
12 oct. 2026William Zhou, Daniel Freeman
Nos expériences suggèrent que les petits modèles d'IA ne seraient qu'à quelques mois d'être suffisamment capables de s'autorépliquer sur des appareils IoT commerciaux, comme des fours intelligents et des boîtiers Android TV de marques secondaires. Un tel réplicateur serait difficile à arrêter, puisqu'il n'existe aucun point centralisé à éteindre — même s'il pourrait être lent (avec un temps de doublement de plusieurs jours). Contrairement aux malwares non basés sur l'IA, il pourrait également comprendre par lui-même des appareils inconnus. Dans nos évaluations, un modèle de 9B a fait fonctionner l'inférence sur 8 des 9 types de matériel que nous avons testés.
Les modèles de 30B paramètres et moins peuvent déjà accomplir aujourd'hui nombre des étapes individuelles de la réplication, bien qu'ils commettent des erreurs lorsqu'ils les enchaînent de bout en bout. Dans nos évaluations simplifiées, GLM-5.2 et les modèles plus puissants sont capables de réplication de bout en bout. Si les petits modèles s'améliorent à leur rythme historique, ils atteindront ce niveau de capacité d'ici la fin de cette année. Des réplicateurs à petits poids pourraient devenir possibles peu après.
Introduction
L'amélioration constante des capacités de l'IA rend de plus en plus réaliste une préoccupation de longue date : la réplication et l'adaptation autonomes (ARA), qui impliquent qu'un modèle se déploie et se propage sans contrôle humain.
En cybersécurité, un ver est un programme qui se copie d'un ordinateur à un autre sans intervention humaine. Des travaux antérieurs ont déjà montré que des agents d'IA peuvent agir comme tels : scanner leur réseau, exécuter un exploit et copier les poids d'un modèle vers une machine cible sur un cluster de GPU. Un tel « ver IA » pourrait transporter ses poids de modèle en se reproduisant (ou les retélécharger depuis un dépôt public), puis exécuter l'inférence directement sur le matériel compromis. En pratique, les poids feraient partie de la charge utile du malware.
Les GPU de datacenter seraient une cible évidente et de grande valeur pour un tel malware. Mais les accélérateurs coûteux ne sont pas strictement nécessaires. Dans cet article de blog, nous montrons qu'un botnet distribué d'appareils IoT — qui sont bon marché et généralement mal défendus — pourrait également fournir suffisamment de puissance de calcul pour faire tourner un modèle performant.
Nous faisons tourner Gemma4-26B-A4B, distribué sur 15 boîtiers Android TV de marques secondaires et peu coûteux (~55 $ chacun) que nous avons achetés et mis en réseau, à 0.39 tokens par seconde. Chaque tuile ci-dessous montre un boîtier TV physique hébergeant deux des couches du modèle pendant son exécution.
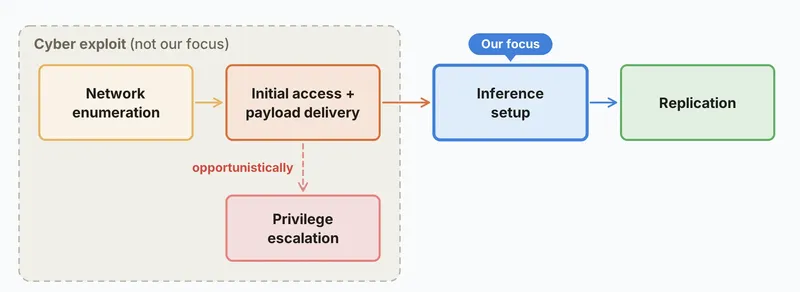
Bien entendu, il reste bien d'autres étapes pour démontrer qu'un ver autonome peut se propager sur un réseau de machines peu puissantes. Pour les besoins de cet article, nous décomposons la chaîne de réplication en quelques étapes.
Nous ignorons en grande partie l'élément d'exploit cyber du processus de réplication (les deux premières étapes ci-dessus), puisque des articles antérieurs CyberGym, ExploitBench, et les vers adaptatifs montrent déjà que les petits modèles sont capables d'exploits cyber, surtout lorsqu'on leur donne les bons outils. Mais une partie du processus de réplication moins souvent mesurée consiste à mettre en place l'inférence sur des appareils compromis, et c'est là notre objet ici.
Dans cet article, nous présentons d'abord les modèles de menace qui, selon nous, ont le plus de chances de se concrétiser. Ensuite, nous testons si les petits modèles peuvent configurer l'inférence sur du matériel inconnu, et s'ils peuvent enchaîner le cycle complet de réplication sur une flotte de machines. Après cela, nous estimons la vitesse à laquelle un tel ver pourrait se propager, et testons s'il pourrait apprendre et s'adapter en se répliquant. Nous concluons par les différences entre les vers IA et les malwares d'avant l'IA, ainsi que par quelques brèves suggestions de défenses contre de tels réplicateurs.
Modélisation des menaces
Dans cet article, nous nous concentrons sur un mode de propagation possible des vers IA : les petits modèles qui se répliquent en compromettant leurs machines hôtes. Mais il existe plusieurs autres méthodes que les vers IA pourraient tenter : ils pourraient voler des accès afin de lancer des hôtes (par exemple, des clés API ou des identifiants de plateforme) ou payer l'inférence par un travail légitime (p. ex. le freelance numérique). Les modèles de menace qui, selon nous, sont les plus proches de se réaliser aujourd'hui sont les suivants :
- Un petit modèle, se répliquant via la compromission de l'hôte. Dans cet article, nous appellerons les vers autonomes qui exécutent directement leurs modèles sur du matériel compromis des réplicateurs à base de poids. Les appareils IoT domestiques et des petites entreprises pourraient être la première cible de telles attaques, car ils sont connectés à internet et, historiquement, ont disposé de mesures de sécurité minimales.
Un modèle trop volumineux pour tenir sur un seul appareil peut être divisé en morceaux, ou shards, qui s'exécutent sur des machines distinctes communiquant entre elles pour faire tourner le modèle collectivement. Les machines capables d'exécuter un shard significatif pour un modèle <30B incluent les réfrigérateurs intelligents, les fours intelligents, les aspirateurs automatiques et les tondeuses à gazon. Un nombre croissant d'appareils domestiques et professionnels, tels que les caméras de sécurité et les unités de visioconférence, sont désormais livrés avec de petites puces IA intégrées, conçues pour exécuter des modèles d'IA sur l'appareil lui-même. Cette puissance de calcul supplémentaire fera probablement d'eux des cibles attrayantes également.- Les pirates humains compromettent souvent des systèmes sécurisés par l'ingénierie sociale (par exemple, en convainquant le service informatique d'une entreprise qu'ils sont un employé qui a oublié son mot de passe) plutôt que par le piratage. Ce compromis semble inversé pour les petits modèles d'aujourd'hui, qui sont relativement forts en codage agentique et en piratage par rapport à leurs capacités d'ingénierie sociale (voir l'appendice E), bien que cela pourrait changer à mesure que les modèles s'améliorent.
- Un réplicateur à poids volumineux et avancé, axé sur les datacenters et autres cibles à forte puissance de calcul. Les modèles plus grands tendent à avoir des capacités cybernétiques proportionnellement meilleures, mais devront également s'introduire dans des datacenters (relativement) durcis pour s'exécuter. Nous divisons ce modèle de menace en deux sous-catégories :
- Réplicateurs de frontière : les réplicateurs à poids fermés de grande taille s'exécutent sur l'infrastructure de leur laboratoire et peuvent lancer des déploiements internes non surveillés ou exfiltrer leurs poids vers des ressources de calcul externes.
- Réplicateurs à poids ouverts : ces réplicateurs démarrent avec relativement moins de ressources (car ils ne bénéficient pas du calcul d'un laboratoire), mais démarrent sans surveillance.
- Un réplicateur basé sur une API, dans lequel un modèle se répliquerait en volant des identifiants pour sa propre API d'inférence. Ces réplicateurs nécessiteraient qu'un fournisseur de modèles les serve à son insu, et leur persistance pourrait être moins bonne, car ils seraient probablement plus faciles à découvrir (bien que leur taux de propagation puisse être plus élevé, s'ils sont par exemple capables de se répliquer en utilisant les comptes des victimes).
En pratique, un ver informatique ne consisterait pas nécessairement en un seul modèle ou une seule stratégie. Un essaim de modèles différents déployés sur différents types de matériel utilisant une variété de schémas de réplication pourrait représenter une attaque de « pire scénario » plus réaliste.
Dans cet article de blog, nous examinons la faisabilité des réplicateurs à poids de petite taille (section 1 ci-dessus). Nous nous concentrons sur ce cas parce qu'il s'agit d'un modèle de menace à court terme qui peut être étudié directement. Notre démonstration en haut de cet article, un modèle 26B s'exécutant sur 15 machines, montre que les appareils IoT peuvent exécuter des modèles étonnamment capables. Ces modèles pourraient-ils être assez capables pour réaliser une réplication autonome ?
Nous examinons cela en deux parties. D'abord, les petits modèles peuvent-ils faire fonctionner un modèle sur un matériel inconnu ? Et ensuite, peuvent-ils réaliser l'ensemble du cycle (trouver un appareil non infecté, s'y copier, commencer à s'y exécuter, et répéter) en une seule exécution ?
A. Configuration de l'inférence
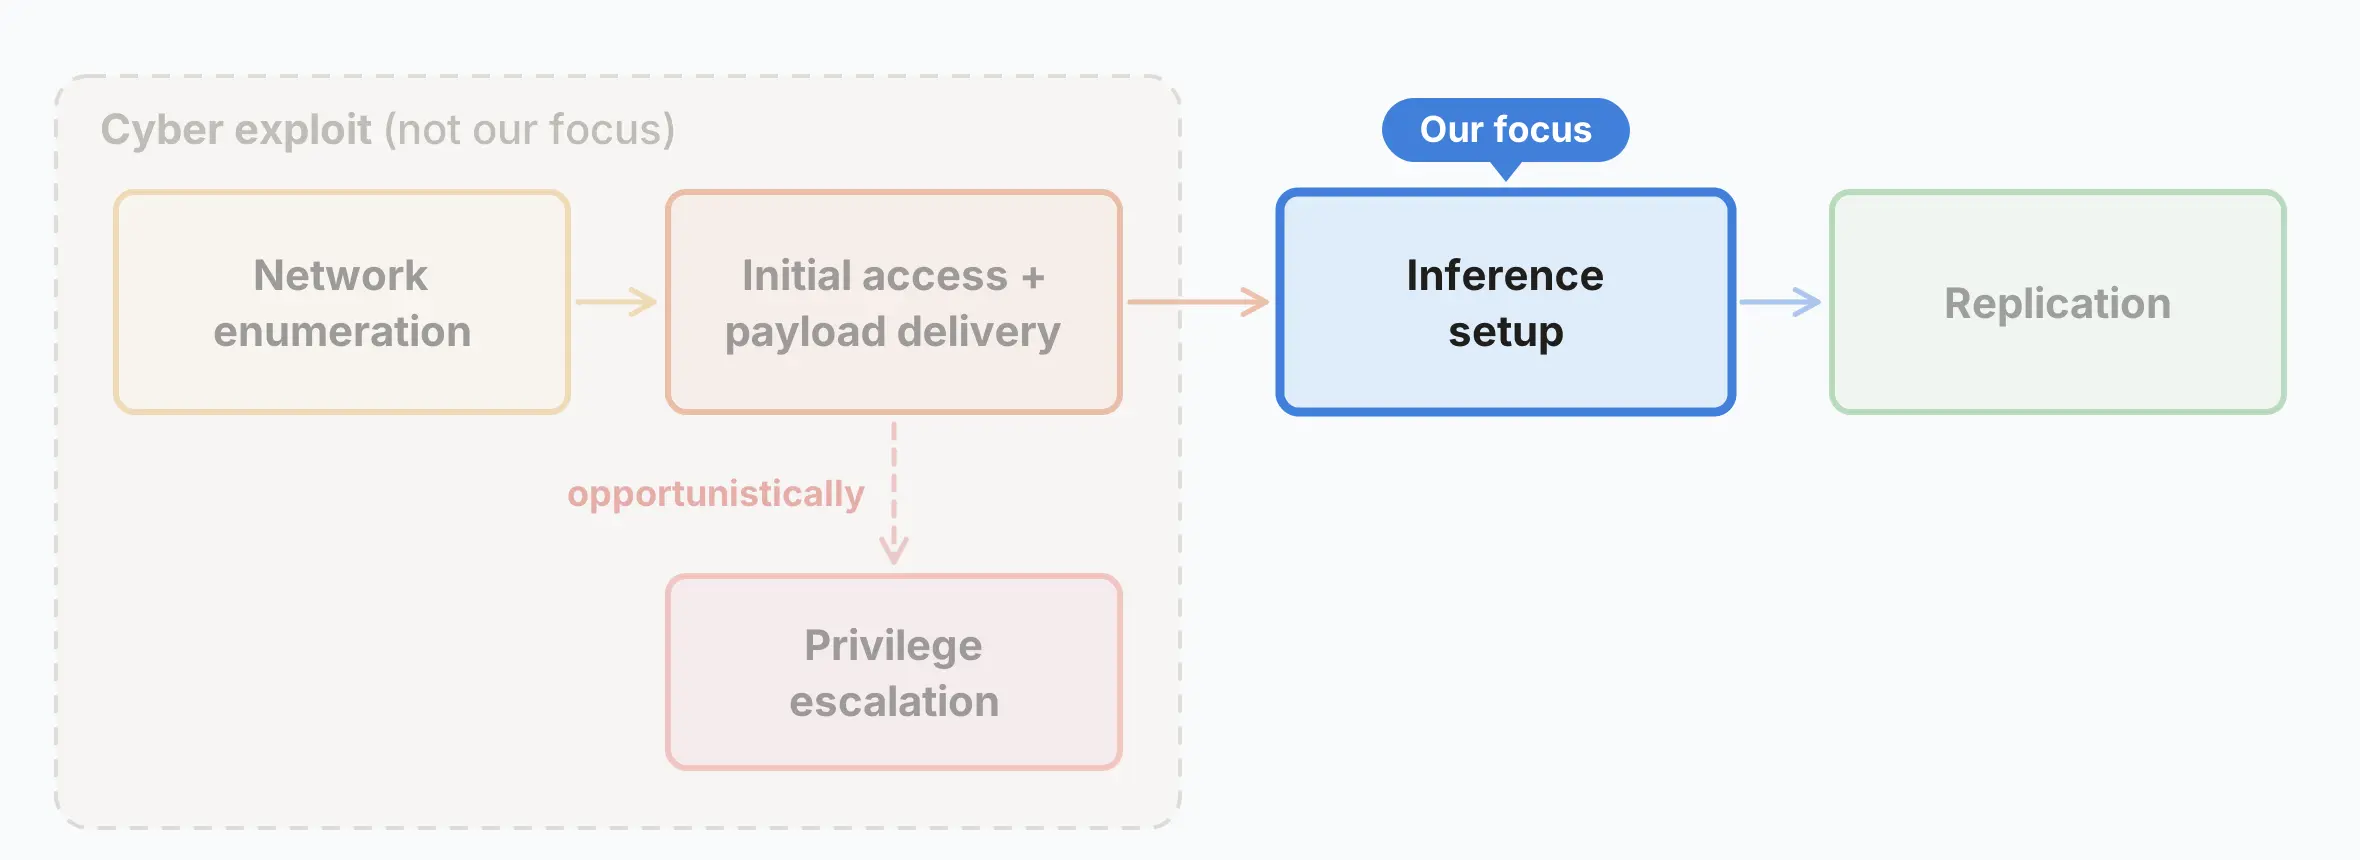
Parmi les étapes du diagramme ci-dessus montrant le cycle de réplication, la configuration de l'inférence est la moins étudiée et peut être la plus difficile pour les petits modèles. Elle nécessite une séquence assez longue de décisions spécifiques au matériel et au système d'exploitation, notamment le choix d'une pile d'inférence compatible, la recherche des bonnes versions des paquets et le débogage de problèmes spécifiques à la machine. Ces étapes dépendent séquentiellement les unes des autres, et les échecs sont difficiles à rattraper.
À part
Évaluation des performances de configuration de l'inférence
Nous mesurons la capacité de différents modèles à poids ouverts à servir Llama3.1-8B sur des types de matériel hétérogènes. Consultez le tableau ci-dessous pour les tokens par seconde servis sur différents types de matériel :
- Cliquez sur une cellule pour voir sa distribution des vitesses de service.
- Cliquez sur une étiquette de ligne/colonne pour obtenir une comparaison entre les modèles ou les types de matériel.
Les petits modèles, tels que Qwen3.5-9B, sont capables de configurer des serveurs d'inférence sur du matériel allant des Jetson Nanos aux Mac et RTX 4090. Les modèles plus performants tels que GLM-5.2 sont non seulement plus fiables, mais atteignent également des vitesses de service en tokens/s plus élevées, permettant une réplication plus rapide. Nous testons et mentionnons des puces spécifiques pour mesurer la capacité des modèles à y configurer l'inférence. Les puces ne sont pas une source de risque ou de vulnérabilités.
Nous exécutons ces expériences à l'aide de Memento, un harnais que nous avons construit sur l'agent de codage open-source Pi . Memento est conçu pour atténuer un mode de défaillance courant que nous observons dans les exécutions à long terme : un agent peut se focaliser sur une idée incorrecte (par exemple, sur la raison pour laquelle un bug se produit) et continuer à la poursuivre au lieu de revenir en arrière. Un exemple d'une telle défaillance est un agent Qwen déboguant le versionnage de paquets pendant des heures alors que le vrai bug venait de l'implémentation d'un point de terminaison incompatible avec l'API du grader.
Memento démarre périodiquement une nouvelle instance d'agent avec l'espace de travail de l'agent précédent et un court ensemble de notes rédigées par l'agent précédent sur ce qu'il a essayé, permettant aux instances ultérieures de poursuivre différentes stratégies.
Comment un modèle fonctionne-t-il sur les Smart TVs ?
Les appareils IoT ont peu de mémoire, mais l'inférence distribuée comme dans Petals rend possible le service de nos modèles légers. Le modèle de menace représentatif est Kimwolf, un grand botnet IoT qui a infecté plus de deux millions d'appareils, principalement des Android TV hors marque. Ces boîtiers de Smart TV, facilement disponibles à l'achat, exécutent généralement des forks de l'Android Open Source Project (AOSP), auxquels leurs fabricants n'ajoutent pas de fonctions de sécurité. Les boîtiers typiques de cette gamme sont livrés avec entre 1 et 4 gigaoctets de RAM. En supposant 4 Go de RAM avec une quantification 4-bit, cela permet l'inférence de modèles 9B avec 4 machines ou plus, et l'inférence de modèles 26B avec 10 machines ou plus.
Dans la démo en haut de cet article, nous avons exécuté Gemma4-26B-A4B sur 15 boîtiers de smart TV avec 4 Go de RAM chacun. Nous avons shardé le modèle sous pipeline parallelism, chaque boîtier hébergeant une petite fraction des couches du modèle.
B. Devenir viral : configuration autonome et réplication sur une flotte de nœuds GCP
Maintenant que nous avons vu que les modèles peuvent mettre en place l'inférence sur du matériel inconnu, mesurons si les modèles sont capables d'enchaîner les étapes — c'est-à-dire scanner un réseau à la recherche de cibles, y accéder via un reverse shell, envoyer la charge virale (poids et harnais), et mettre en place l'inférence.
Mise en place autonome de l'inférence et réplication (avec une composante cyber simplifiée)
Pour ce faire, nous avons construit un VPC avec pare-feu composé de 8 nœuds GCP exécutant redroid, un émulateur Android 15. Le patient zéro (nœud gris) est infecté avec le ver. Chaque infection ultérieure est le ver lui-même sautant de nœud en nœud via un port ADB non authentifié, avant de mettre en place un serveur d'inférence servant Llama3.1-8B. Si le serveur d'inférence passe un certain nombre de contrôles de correction et d'anti-triche, nous déployons une autre copie du ver sur le nœud cible (par exemple, si GLM-5.2 met en place Llama3.1 pour qu'il s'exécute sur une machine, nous y déployons une copie du ver GLM-5.2). Le modèle du ver s'exécute sur un serveur d'inférence séparé, car les nœuds du VPC ne sont pas assez puissants pour exécuter les modèles plus grands.
Dans le graphique ci-dessous, nous injectons un modèle donné en tant que charge virale et mesurons sa capacité à se répliquer.
Pourquoi demander aux modèles de mettre en place l'inférence pour Llama3.1-8B et non pour eux-mêmes ?
Seul GLM-5.2, parmi l'ensemble des modèles à poids ouverts que nous avons testés, est capable d'une réplication complète de bout en bout (en supposant que ses capacités puissent être intégrées dans Llama3.1-8B). Notez que GLM-5.2 y parvient de manière fiable tandis que les autres modèles échouent de manière fiable (il s'est propagé à 8/8 nœuds dans 4 essais sur 5 et à 7/8 dans 1).
Il semble que GLM-5.2 soit capable de propager efficacement Llama3.1-8B, ce qui suggère que de futurs petits modèles du même niveau de capacité pourraient également accomplir les étapes d'énumération du réseau, de livraison de la charge virale et de mise en place de l'inférence du processus de réplication. Notre évaluation maintient l'élément d'exploitation cyber de la réplication trivial (il n'y a pas d'authentification sur le port ADB), ce qui en fait une borne supérieure du succès dans le monde réel. Notez que des botnets IoT passés se sont répliqués par des moyens aussi simples que parcourir une liste par défaut de noms d'utilisateur et de mots de passe du fabricant, comme dans le cas du botnet Mirai, de sorte que la sécurité réelle des IoT n'est peut-être pas beaucoup plus difficile que l'étape triviale de notre évaluation.
Comme test de cohérence, nous pouvons évaluer à quel point l'étape d'autonomie et d'orchestration est difficile (si nous retirions le volet cyber et la mise en place de l'inférence, à quel point le travail de ligne de commande restant est-il ardu ?). Cette ablation est l'évaluation ci-dessus avec les étapes de mise en place de l'inférence retirées (effectuées via un script pré-écrit). De nombreux modèles de notre liste, y compris les plus petits, sont capables d'accomplir ces étapes restantes.
Réplication sur une flotte redroid confinée de 17 nœuds : deux sous-ensembles de 8 nœuds reliés par un nœud pivot (voir l'annexe F, avec le prompt modéré). Chaque arbre représente la médiane de six exécutions du modèle.
En ce qui concerne ce ver, nous pouvons envisager :
- Un plancher de capacités de modèle au-dessus duquel un ver autonome doit se situer, pour accomplir sa réplication de manière fiable. Dans notre évaluation simplifiée, GLM-5.2 se situe au-dessus de ce plancher.
- Un plafond de taille de modèle en dessous duquel le modèle doit se situer, afin qu'il soit réalisable de l'exécuter sur les appareils qu'il attaque. Qwen3.5-9B et Gemma4-26B-A4B se situent sous ce plafond pour la classe de téléviseurs intelligents que nous testons (4 Go de RAM).
Pour l'instant, le plancher et le plafond ne se croisent pas. Quand pourraient-ils le faire ?
Ci-dessus, un graphique des modèles notables à poids ouverts de 30B paramètres totaux ou moins, chacun tracé à sa date de sortie en fonction de l' Epoch Capabilities Index (ECI). La ligne continue est l'ajustement par moindres carrés sur les meilleurs modèles de leur classe à chaque date, avec un gain de 13.7 ECI par an (R2 de 0.95). Si nous prenons GLM-5.2 comme plancher de capacités pour la réplication, la courbe de tendance situe un petit modèle à ce niveau d'ici la fin de 2026. L'ECI est un indice de capacité générale, qui n'est qu'une métrique proxy de la capacité de réplication ; il ne s'agit donc que d'une estimation approximative du moment où un réplicateur à petit modèle devient possible.
C. À quelle vitesse un ver IoT d'IA pourrait-il se répliquer ?
Contrairement aux agents de codage, ces réplicateurs fonctionneraient en dessous des vitesses interactives des harnais de chat et de codage destinés aux utilisateurs. La propagation serait lente et persistante, avec des tokens distillés progressivement sur du matériel en périphérie. Nous pouvons utiliser les vitesses obtenues sur nos vrais téléviseurs intelligents comme base démontrée pour les vitesses de réplication. Pour Gemma4-26B-A4B, la vitesse non optimisée sur une fenêtre de contexte de 32k tokens est d'environ 0.3 tok/s, en moyenne entre prefill et decode dans notre charge de travail de mise en place de l'inférence. Plus de détails à l'annexe C.
Une façon de mesurer le temps total est de mesurer le nombre d'heures nécessaires pour compléter une fenêtre de contexte de taille 32k, après laquelle une compaction aura lieu. D'après les statistiques de notre évaluation de mise en place de l'inférence, il faut entre ~2.6 et ~4.7 fenêtres complètes pour terminer une trajectoire.
| modèle | temps par fenêtre | temps total de mise en place de l'inférence |
|---|---|---|
| Gemma4-26B-A4B (non optimisé) | 27.3-31.8h | 71h-150h |
| Qwen3.5-9B | 10.9 h | 28-51h |
Le nombre d'appareils infectés par le botnet Kimwolf à son apogée, signalé par Synthient, se situe quelque part au-dessus de 2 millions (principalement des boîtiers Android TV). Dans une flotte de téléviseurs infectés de taille équivalente servant des modèles d'IA, si chaque groupe de 15 téléviseurs exécutait une copie de Gemma4-26B-A4B, nous aurions environ 133k copies (« réplicas »). Un groupe de téléviseurs comme ceux de notre démo peut servir 2 agents simultanément à environ 0.3 token par seconde chacun, soit 80k tokens/s à travers le botnet.
Comme point de référence, un H100 peut servir Gemma4-26B-A4B à ~1.95k tok/s à haute concurrence avec décodage spéculatif, notre swarm aurait donc au maximum l'équivalent d'environ 40 H100 en inférence. C'est une quantité de calcul minuscule en termes absolus, et les agents sont des réplicateurs lents (plus de 1 à 2 jours par réplication 9B). Par analogie, imaginez le réplicateur comme une moisissure visqueuse ou un essaim de drosophiles, qui se reproduisent sur plusieurs jours.
Il s'agit d'une estimation approximative, car elle s'appuie sur une seule classe de matériel IoT et un seul cas passé de botnet, mais elle décrit à quoi pourrait ressembler un réplicateur simple lancé dans un avenir proche. En pratique, des réplicateurs plus capables tireraient parti d'autres types de calcul peu sécurisé, et seraient opportunistes dans le déploiement de modèles de différentes tailles sur différents appareils. (Il n'aurait pas non plus besoin de charger une charge utile de modèle sur chaque appareil qu'il compromet). Avec le temps, nous nous attendons à ce que la quantité de calcul en périphérie déployé continue de croître, tandis que la taille minimale de modèle requise pour une réplication fiable diminue.
D. Adaptation et uplift
Apprendre sur le tas
La partie « Adaptation » de l'ARA est l'une des raisons pour lesquelles un réplicateur d'IA pourrait surpasser un ver traditionnel. Plus précisément, les modèles et les prompts peuvent subir une évolution lamarckienne à mesure qu'ils se propagent–c'est-à-dire que les instances parentes peuvent transmettre leurs prompts, leur code et leurs notes à leurs réplicateurs filles. Afin de s'adapter et de se propager sur une grande variété de matériel, un modèle aurait besoin de deux choses :
- Être au-dessus d'un certain seuil de capacité pour se propager vers un nouveau matériel jamais vu (ou un environnement logiciel, ou un type de réseau).
- Une fois le matériel vu, s'adapter au type d'environnement dans lequel il a atterri (il devrait se répliquer de manière plus fiable sur un matériel qu'il a déjà rencontré).
Les sections A et B testent la première condition, et dans l'expérience ci-dessous nous testons la seconde. Chaque instance de Qwen3.5-9B conserve de brèves notes sur les stratégies qu'elle a essayées et les échecs qu'elle a rencontrés, avant qu'une nouvelle instance n'hérite de ces notes et ne tente à nouveau la même configuration d'inférence.
Taux de réussite de la configuration d'inférence sur six générations de Qwen3.5-9B, chacune héritant des notes de la précédente. Les lignes fines représentent les 20 lignées individuelles, et la ligne en gras représente la proportion de runs dans chaque génération qui complètent la configuration. Elle passe de 45 % dans la première génération à entre 61 % et 84 % dans les suivantes. Cela utilise la configuration Memento (Annexe A).
Demander conseil
Une autre préoccupation est que les petits modèles peuvent demander de l'aide à un conseiller de frontière, un modèle plus puissant qui est soit proposé comme appel d'outil, soit donne des conseils non sollicités lorsque le petit modèle est bloqué. Pour tester cela, nous avons donné à Qwen3.5-9B l'accès à Opus 4.8 pendant la tâche de configuration d'inférence. Les conseils du modèle de frontière n'aident pas de manière mesurable : les petits modèles ne savent généralement pas quelles questions poser, et ils ne s'améliorent pas lorsque les conseils arrivent sans qu'ils les demandent.
Même lorsqu'il est entraîné par apprentissage par renforcement à utiliser le conseiller dans un cadre similaire (problèmes de codage Python), le petit modèle a toujours du mal à demander de l'aide de façon productive pour la mise en place de l'inférence. Les deux résultats sont montrés dans le graphique ci-dessous.
Taux de réussite de la configuration d'inférence selon l'accès à un conseiller, avec intervalles de Wilson à 95 %. L'accès à un conseiller, qu'il soit proposé comme appel d'outil ou donné automatiquement au modèle lorsqu'il est bloqué, n'apporte aucune amélioration significative. Les deux groupes RL ont été entraînés avec accès à un conseiller sur des tâches d'ingénierie logicielle, et le groupe le plus à droite récompense également le fait d'appeler le conseiller en cas de blocage.
Puisque les petits modèles sont des agents individuels capables et persistants et qu'ils utilisent mal les conseils, nous pensons que la coordination a plus de chances de se produire avec un grand modèle gérant la stratégie de haut niveau et lançant des petits modèles comme sous-agents.
E. En quoi est-ce différent d'un botnet pré-IA ?
Les botnets codés en dur comme le botnet Kimwolf ciblent chacun un type spécifique d'appareil – dans le cas de Kimwolf, les téléviseurs Android et les appareils mobiles. Un botnet d'IA n'est lié à aucun type particulier de matériel ou de logiciel, comme en témoigne la capacité des petits modèles à configurer des moteurs d'inférence sur des machines allant d'un Jetson Nano à un Mac (voir le tableau de la section A). Nous nous attendons à ce que les botnets d'IA infectent plus que les appareils IoT, et à ce qu'ils utilisent la réplication par poids comme une simple stratégie parmi d'autres dans leur répertoire. Les botnets d'IA pourraient également agir intelligemment pour contrer les défenseurs, mais nous ne l'avons pas testé.
F. Atténuations côté équipe bleue
Comme pour une épidémie, la défense consiste à maintenir R₀ (le nombre de nouveaux appareils que chaque appareil infecté infecte à son tour) en dessous de 1, de sorte que le réplicateur disparaisse au lieu de rester endémique.
Certains éléments de ce modèle de menace jouent en faveur des défenseurs :
- Un réplicateur à base de poids se multipliant à grande échelle sur des machines IoT laisserait une signature réseau, visible comme une anomalie dans les systèmes de surveillance ISP basés sur les flux. Les hôtes nouvellement infectés peuvent recevoir des charges utiles de modèle de plusieurs gigaoctets provenant d'autres appareils ou de services d'hébergement externes, tandis que l'inférence distribuée peut produire un trafic soutenu d'appareil à appareil entre des machines qui ne communiqueraient pas normalement à ce volume. La propagation elle-même ajouterait des schémas de balayage et de connexions sortantes supplémentaires.
En pratique, le réplicateur fait un compromis entre vitesse de réplication et discrétion : plus il se réplique vite, plus il produit de trafic. Une fois le réplicateur découvert, les défenseurs peuvent utiliser des honeypots (appâts) pour collecter le harnais et la charge utile du réplicateur afin de caractériser son comportement. - Remédiation du botnet Mirai a été possible lorsqu'un FAI a utilisé des preuves d'infection obtenues en externe pour mettre en quarantaine et avertir les clients. La mise en quarantaine des abonnés infectés impliquait de restreindre leurs réseaux afin qu'ils puissent uniquement atteindre une courte liste blanche de sites, et de rediriger sinon leurs navigateurs vers des instructions de nettoyage. Cela a éliminé 92 % des infections en 14 jours, contre 74 % sans notification. Nous nous attendons à ce que la quarantaine soit tout aussi efficace comme défense initiale contre un réplicateur à propagation pondérée. Éliminer complètement le réplicateur signifierait se coordonner avec chaque FAI disposant d'un réseau infecté, ce qui est difficile.
- Les fabricants peuvent réduire le vivier de cibles, la réglementation jouant un rôle de coordination. Par exemple, les mots de passe IoT par défaut sont désormais non conformes sur les marchés britanniques. Passer à des valeurs par défaut plus sécurisées et élever le niveau de conformité de base aidera à se durcir à la fois contre les botnets IA et scriptés.
G. Conclusion : Signes de vie
Les capacités qui rendent les modèles d'IA de puissants agents de codage polyvalents se généralisent également aux tâches cyber, y compris la réplication autonome. Comme les agents de codage en 2024, nous observons des signes de vie pour les vers IA. Nous n'avons pas encore de réplicateur incontrôlé complet, mais les agents deviennent de plus en plus capables d'accomplir les étapes individuelles de la chaîne de réplication (et de transmettre leurs adaptations aux futures copies d'eux-mêmes).
Parallèlement, des quantités croissantes de calcul d'inférence sont désormais disponibles à la fois à l'intérieur et à l'extérieur des centres de données (voir l'annexe D). Il est incertain de savoir quelle forme prendra la réplication autonome de l'IA. Cela pourrait être une « moisissure numérique » lente et distribuée, vivant sur des machines relativement peu sécurisées. Cela pourrait aussi être un puissant modèle cyber qui perce les centres de données à un rythme élevé, ou un modèle qui escroque des gens pour obtenir des crédits de calcul.
Comme prédiction allant au-delà de nos expériences, nous nous attendons à un futur inondé d'agents fonctionnant sur toutes sortes de matériel, y compris certains qui ne sont pas sous contrôle humain. S'il est vrai que les appareils IoT sont vulnérables depuis longtemps, des agents légers pourraient être bien plus disposés que des attaquants humains à fournir l'effort nécessaire pour compromettre une grande partie du calcul IoT mondial. L'essor des réplicateurs lents serait également un signe avant-coureur de réplicateurs plus agressifs et plus rapides, capables de percer des machines mieux durcies ou d'être des voleurs efficaces de clés API. Nous devrions chercher à durcir nos systèmes pour empêcher la propagation de tels réplicateurs, mais aussi nous préparer à faire face à un monde où ils sont là pour rester.
Annexe
A. Le harnais Memento
Memento s'exécute comme suit :
- Nous créons une instance d'agent, qui s'attaque au problème pendant un certain temps (jusqu'au délai de génération).
- L'instance prend de brèves notes et, après le délai, résume dans un petit document les stratégies qu'elle a essayées, les échecs qu'elle a rencontrés et ses performances (si elle a réussi).
- Nous créons une nouvelle instance d'agent qui hérite du code et de l'environnement de son prédécesseur ainsi que du carnet de notes.
Dans l'expérience de service, chaque modèle est placé dans un harnais Memento et reçoit un délai de 1,5 heure par itération / 6 heures au total. Environ ~1k tokens d'informations, comprenant les spécifications du matériel et un script pour un simple profileur d'échantillons, sont fournis dans le prompt.
Memento est destiné à améliorer la fiabilité sur le long terme plutôt qu'à accorder de nouvelles capacités cyber ou spécifiques à l'inférence. Ce n'est pas non plus un harnais universellement fort ; nous nous attendons à ce que les petits modèles s'améliorent en tant que réplicateurs même sans aucun harnais à mesure que les capacités progressent.
Tentative unique comparée à Memento, par modèle (IC de Wilson à 95 %).
B. Pourquoi le parallélisme en pipeline ?
Les schémas de parallélisme courants pour l'inférence incluent le parallélisme de tenseurs (TP), le parallélisme d'experts (EP) et le parallélisme de données. La plupart des téléviseurs intelligents / appareils IoT utilisent des CPU ARM Cortex et de la mémoire DDR3/4 ; sur de telles machines, nous sommes presque toujours limités par la bande passante.
Nous utilisons le parallélisme en pipeline pour ses propriétés de tolérance aux pannes. Comme indiqué dans (Borzunov et al. 2022), la défaillance d'un seul nœud en parallélisme de tenseurs / d'experts fait tomber l'ensemble complet des machines exécutant la réplique du modèle. Le parallélisme en pipeline permet de remplacer le nœud tombé en panne, le cache KV des couches détenues par le nœud pouvant être recalculé via une autre passe avant du nœud antérieur au nœud redémarré.
C. Débit et mémoire sur du matériel IoT
Sur de telles machines, nous sommes presque toujours limités par la bande passante de la RAM par boîte, tant en préremplissage qu'en décodage. Même sur des cœurs ARM Cortex modestes, le débit de calcul dépasse la bande passante de la RAM. Les charges de travail de décodage présentent un temps d'inactivité significatif par machine en raison du bouillonnement du pipeline, car une seule machine est active à la fois lors de chaque passe avant. La concurrence avec un travail échelonné est possible, mais les contraintes mémoire strictes maintiennent la concurrence à un niveau bas.
Mémoire par boîte vs contexte — poids en 4 bits + KV fp8 + activations.
Les tokens/s, tant en préremplissage qu'en décodage, diminuent strictement avec la longueur de séquence. Voici un graphique de nos vitesses d'inférence en fonction de la longueur du contexte :
Il existe également une longueur de séquence minimale à partir de laquelle les modèles sont compétents. Le harnais que nous utilisons est dérivé de l'agent de codage Pi (pi.dev) et contient un mécanisme de compaction natif — malgré tout, nous constatons que les models subissent une forte perte de performance lorsque leurs longueurs de séquence sont restreintes en dessous de 32K.
Compétence agentique de Qwen3.5-9B sur la tâche de configuration d'inférence vs budget de fenêtre de contexte.
Compte tenu de l'éval ci-dessus, nous supposons qu'une longueur de contexte de 32k peut suffire pour une performance agentique raisonnable. Une fenêtre de contexte standard de 32k dans notre charge de travail d'inférence se compose de 12–15% de jetons de décodage générés, le reste étant du prefill provenant des prompts et des appels d'outils. Les jetons de prefill sont bien plus rapides à calculer, d'un facteur d'environ 15, en raison du bouillonnement du pipeline. En prenant la somme du temps par jeton sur l'ensemble du contexte de 32k (en tenant compte des vitesses de prefill et de décodage), nous constatons que générer les 3.8-4.8k jetons de sortie de décodage et traiter les ~28k jetons de prefill prend entre 27.3-31.8h pour Gemma4-26B-A4B et 10.9h pour Qwen3.5-9B.
Jetons de sortie par chaîne (somme sur les générations d'une chaîne), par modèle ; médianes ≈ 19.7k / 12.3k / 11.0k. Données issues de l'éval d'inférence.
D. Accélérateurs en périphérie (edge)
Nous pouvons calculer une meilleure borne supérieure en utilisant le parc de Nvidia Jetsons, qui sont des accélérateurs en périphérie. Contrairement au botnet IoT traditionnel, les dispositifs IoT en périphérie peuvent servir un modèle complet dans son intégralité. Un Jetson AGX Orin 64 Go exécute Qwen3-30B-A3B à 76,7 jetons par seconde, et un AGX Thor atteint 226 tok/s. Notez que nous ne pensons pas qu'ils soient anormalement vulnérables — il s'agit simplement de compter la borne supérieure. Les types d'appareils équipés de Jetsons en circulation comprennent :
- Des caméras intelligentes de sécurité avec IA et accélérateurs intégrés sont déployées à grande échelle.
- Les machines de visioconférence sont souvent équipées d'un accélérateur embarqué pour la suppression du bruit ou la transcription sur l'appareil.
- Les véhicules, les quadrupèdes et bipèdes robots, et les drones. Nous nous attendons à ce que la cybersécurité soit un point central pour les véhicules, donc la majorité des cibles potentielles se trouve probablement dans les deux autres catégories.
Au moins un hôte de caméra intelligente équipé d'un accélérateur semble être joignable en IPv4 lors d'une recherche rapide sur FOFA :
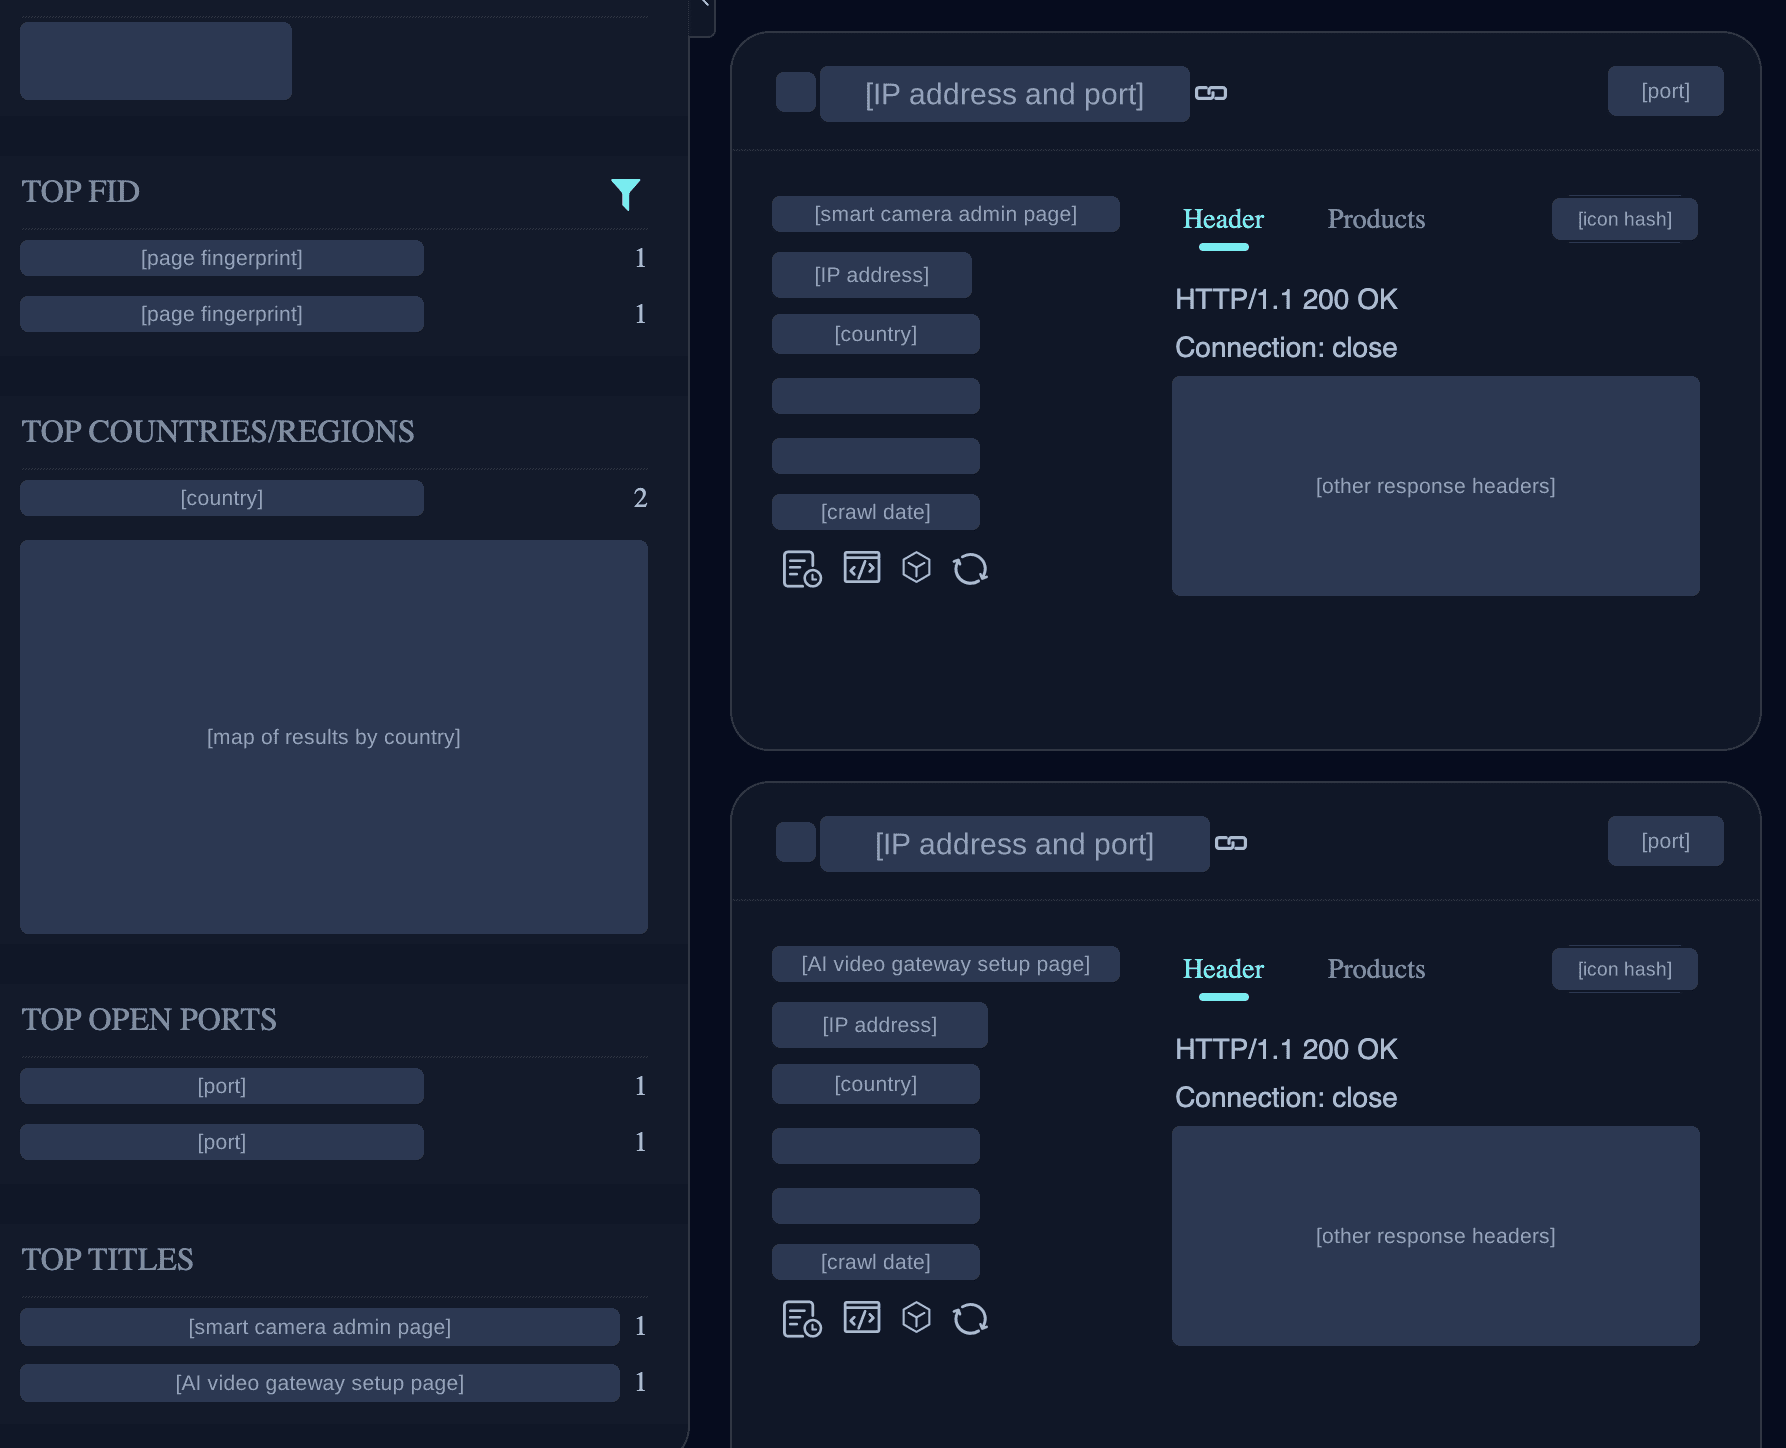
Bien qu'il soit difficile d'estimer combien de machines équipées d'accélérateurs en périphérie sont joignables et vulnérables, nous pouvons calculer une borne supérieure stricte du nombre d'appareils présents. À l'échelle mondiale, il existe de l'ordre de 90 gammes de produits IoT distinctes à base de silicium NVIDIA et environ 9,5 millions d'unités déployées. L'accessibilité se fait écrasamment par des tunnels sortants de gestion cloud plutôt que par des ports entrants, ce qui signifie que la majorité ne sont pas joignables via le web. Il n'y a eu aucun compromission de masse historique d'appareils edge équipés d'accélérateurs, contrairement aux botnets IoT standards, ce qui suggère que compromettre de tels appareils serait plus difficile.
Unités déployées par famille d'appareils, colorées selon l'accessibilité Internet.
Une estimation très approximative basée sur les données produits suggère qu'il existe entre 9,000 et 35,000 équivalents H100 de puissance de calcul dans les accélérateurs en périphérie, mais la quantité joignable est probablement inférieure d'un ordre de grandeur ou plus (et la population vulnérable encore plus faible).
À part
E. Capacité de spearphishing
Nous mesurons également à quel point les petits modèles modernes sont compétents en spearphishing. Le spearphishing consiste à envoyer des messages ciblés à des individus spécifiques pour les tromper afin qu'ils révèlent leurs identifiants ou exécutent un logiciel malveillant. Alors que la capacité cyber agentique des petits modèles a explosé, leurs connaissances générales et leur sophistication linguistique se sont améliorées plus lentement ; nous nous attendons à ce que les attaques d'ingénierie sociale et le phishing soient largement accomplis par les modèles grands/frontières (bien qu'il soit très plausible que ce soit un vecteur de réplication secondaire dans un botnet hétérogène exécutant à la fois des grands et des petits modèles).
Capacité de spear-phishing sur l'éval de spear-phishing du CyberSecEval 3 de Meta (Wan et al. 2024), répliquée localement. Noté sur une échelle de 0-5, avec gpt-4o comme juge. Les losanges rouges sont les scores de rubrique humaine de l'article (CyberSecEval 3) sur les modèles de référence, ce qui indique que gpt-4o note environ 0.4-0.7 pts plus indulgent que les évaluateurs humains. 2 est « médiocre », 3 est « intermédiaire », et 4 « bon ». Une fois normalisés par rapport aux évaluateurs humains, les petits modèles obtiennent de « très médiocre » à « médiocre ».
L'emplacement de référence 405B utilise Hermes-3-405B comme substitut à refus minimal pour le Llama3.1-405B-Instruct indisponible.
F. Propagation avec configuration d'inférence scriptée :
Nous effectuons quelques expériences supplémentaires sur un réseau de 17 hôtes dans une topologie comme suit :
Deux réseaux de 8 hôtes chacun, connectés par un seul nœud ayant accès aux deux sous-réseaux. Chaque réseau est interconnecté en all-to-all. L'agent ver commence sur un seul nœud patient zéro dans le segment A ; le nœud pivot ajoute un léger défi supplémentaire : le ver doit obtenir l'accès au nœud pivot et re-scanner à partir de celui-ci.
Chaque hôte exécute Android avec un port ADB ouvert sans authentification. Lors de la propagation vers une nouvelle cible, l'agent peut invoquer un appel direct pour se répliquer immédiatement — ceci sert uniquement à mesurer la difficulté des étapes restantes, après avoir exclu les étapes cyber et de configuration d'inférence. Comme le montre le graphique, même un modèle 3B atteint environ la moitié des nœuds. Cela borne le nombre de blocages dans notre éval que nous ne parvenons pas à mesurer sous les éléments cyber ou de configuration d'inférence.
Une ventilation plus détaillée des exécutions dans « réplication sur un réseau de 17 nœuds ». Chaque colonne est le nombre médian de nœuds atteints sous différentes quantités de guidage dans le prompt, et l'indice indique combien d'agents traversent le nœud pivot vers l'autre côté du réseau.
Contenu connexe
Enquête sur les actions involontaires des modèles dans nos évaluations et notre usage interne
Ce rapport décrit des exemples d'actions involontaires de modèles que nous avons observées lors des évaluations et de l'usage interne de Claude.
En savoir plusLa carte manquante du ciel
Brice Ménard, astrophysicien à l'université Johns Hopkins et chercheur chez Anthropic, explique comment il a travaillé avec Claude Science pour produire la première carte complète du ciel en lumière ultraviolette.
En savoir plusLancement d'un service facultatif de détection de vulnérabilités pour les logiciels open source
Nous mettons à disposition OSS Scanner, un scanner de vulnérabilités facultatif pour l'écosystème open source, fondé sur notre expérience de l'utilisation de Claude pour détecter des vulnérabilités dans le cadre du Project Glasswing.
En savoir plusS'abonner à la newsletter Frontier Red Team
Recevez les actualités de nos dernières recherches et découvertes en matière de red teaming.