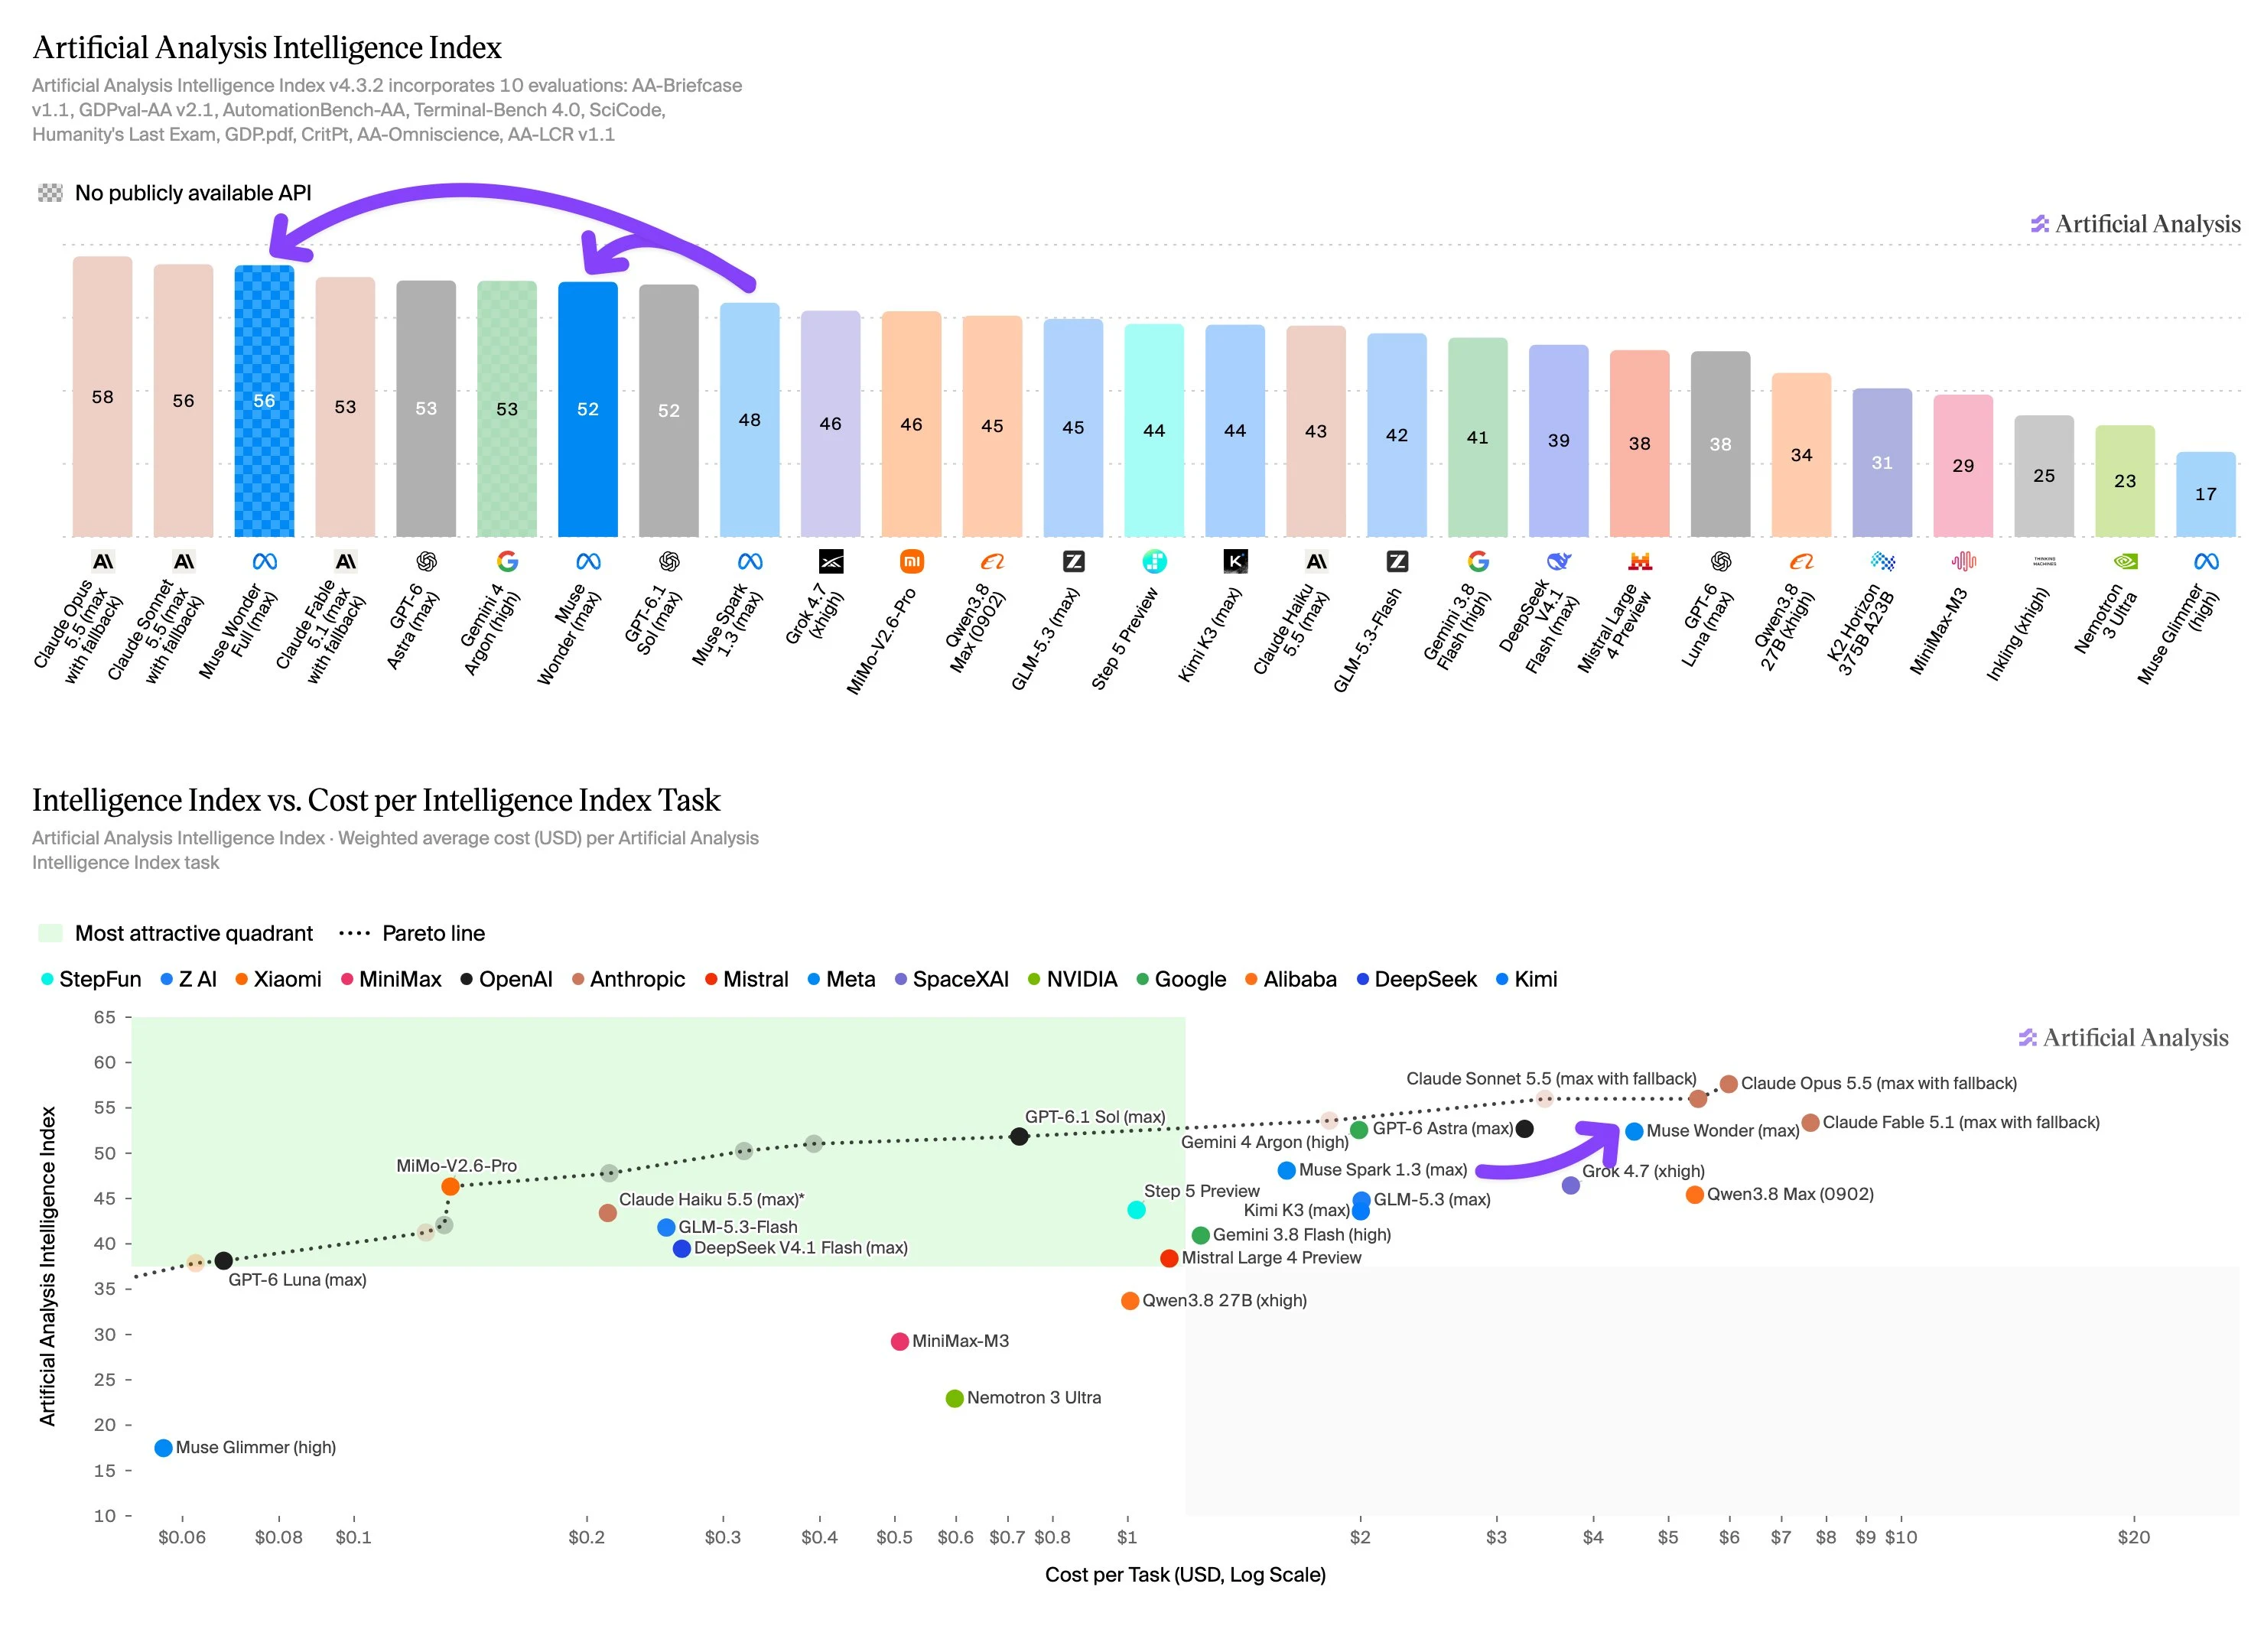
Meta a sorti Muse Wonder et Muse Wonder Full, atteignant des scores de l’Indice d’Intelligence d’Analyse Artificielle v4.3 de 52 et 56 avec un effort maximal de raisonnement – chacun une amélioration significative par rapport à Muse Spark 1.3 (max) qui n’atteint que 48, avec une période de sortie de seulement 6 semaines
Muse Wonder est disponible pour les utilisateurs via l’API de Meta, tandis que Muse Wonder Full n’est actuellement disponible que pour les utilisateurs de Muse Code. Meta indique que chaque modèle est conçu pour l’utilisation personnelle et professionnelle d’agents.
Félicitations à @AIatMeta, @finkd et @alexandr_wang pour la sortie !
Points clés :
➤ Les deux modèles présentent une augmentation de matériau dans le score de l’Indice d’Intelligence global. Muse Wonder Full (max) se place en dessus de Muse Spark 1.3 (max) sur les dix évaluations de l’Indice d’Intelligence, gagnant 8 points pour atteindre 56. Les gains les plus importants ont été observés dans les évaluations agentiques : Terminal-Bench 4.0 (+24 points, de 33% à 57%), GDPval-AA v2.1 (+176 Elo, de 1681 à 1857), et AA-Briefcase (+148 Elo, de 1581 à 1729). Muse Wonder (max) gagne 4 points de l’Indice d’Intelligence et atteint 52, avec des améliorations notables par rapport à avant. Muse Spark 1.3 (max) dans Terminal-Bench 4.0 (33 % à 52 %) et AutomationBench-AA (58 % à 68 %)
➤ Muse Wonder Full (max) se classe parmi les trois premiers sur six des dix évaluations du Intelligence Index, et est particulièrement forte dans le travail lié au savoir agentique et au raisonnement scientifique. Dans le travail lié au savoir agentique, elle est juste en tête avec 33% sur GDP.pdf, se classe #2 sur GDPval-AA v2.1 (1857 Elo), et #3 tant sur AA-Briefcase (1729 Elo) que sur AutomationBench-AA (71%). Dans le raisonnement scientifique, elle est en tête de la classement CritPt avec 33% et se classe #3 sur SciCode avec 63%. Cela repose sur les points forts relatifs de Muse Spark 1.3 (max), qui a également montré une capacité particulière dans ces deux domaines
➤ Les deux modèles utilisent moins de tokens de sortie que Muse Spark 1.3 (max). Muse Wonder (max) et Muse Wonder Full (max) consomment chacun environ 54 000 tokens de sortie par tâche d’Indice d’Intelligence, soit ~10% en moins que Muse Spark 1.3 (max, 60 000). Cette utilisation est inférieure à celle des modèles similaires intelligentes Gemini 4 Argon (high, 62 000) et Claude Fable 5.1 (max avec fallback, 78 000), mais supérieure à celle de GPT-6.1 Sol (max, 38 000) et GPT-6 Astra (max, 27 000). Muse Wonder Full (max) utilise 16 % moins de tokens d’entrée pour une tâche d’Indice d’Intelligence que Muse Wonder (max) (6,44 M vs 7,69 M), ce qui signifie qu’elle est à la fois plus intelligente et plus efficace en termes de tokens.
➤ Le coût par tâche pour Muse Wonder (max) est plus élevé que celui de la plupart des modèles similaires. Malgré une utilisation efficace des tokens, les tarifs premium de l’API ($4 par million de tokens d’entrée, $20 par million de tokens de sortie) et une forte utilisation de tokens d’entrée (7,69M par tâche) font que le coût de Muse Wonder (max) atteint 4,52 $ par tâche d’Indice d’Intelligence. Cela est inférieur à Claude Fable 5.1 (maximum avec fallback, 7,63 $), Claude Opus 5.5 (maximum avec fallback, 5,98 $) et Claude Sonnet 5.5 (maximum avec fallback, 5,46 $), mais supérieur à GPT-6 Astra (maximum, 3,26 $), Gemini 4 Argon (élevé, 1,99 $), GPT-6.1 Sol (maximum, 0,72 $) et son prédécesseur Muse Spark 1.3 (maximum, 1,60 $). Le tarif par token n’est pas actuellement disponible pour Muse Wonder Full, donc aucun chiffre de coût par tâche ne peut être estimé à ce stade.
➤ Les deux modèles améliorent significativement les performances du Coding Agent. Muse Wonder Full obtient 68 sur l’Indice des Agents de Codage d’Analyse Artificielle, avec un effort maximal dans Muse Code, tout comme Claude Code avec Sonnet 5.5 (max, 68) et Opus 5.5 (max, 66). Muse Wonder (max) obtient 63. Ces scores représentent des gains concrets par rapport à Muse Code avec Muse Spark 1.3 (max), qui obtient 54.
Autres détails pour les deux nouveaux modèles :
➤ Fenêtres de contexte : 1M tokens chacune, inchangées par rapport à Muse Spark 1.3
➤ Tarification : pour Muse Wonder, $4 pour les entrées, $0.20 pour les entrées mémorisées, $20 pour la sortie par 1M tokens. La tarification par token n’a pas encore été annoncée pour Muse Wonder Full
➤ Modalités d’entrée : texte, image, vidéo et audio
➤ Modalités de sortie : texte
➤ Disponibilité : Muse Wonder est disponible via l’API de Meta et Muse Code dès le lancement, tandis que Muse Wonder Full n’est accessible qu’aux utilisateurs de Muse Code