

Le nouveau modèle Frontier de Meta, Muse Wonder Full, pénètre dans le top tier des IA
 Matthias Bastian
Voir le profil LinkedIn de Matthias Bastian
12 octobre 2026
 Meta
Points clés
- Les deux nouveaux modèles de Meta, le Muse Wonder et le Muse Wonder Full, comblent l’écart par rapport aux modèles leaders.
- Les plus grands bénéfices se trouvent dans le codage agentique et la résolution autonome de problèmes.
- Les deux versions coûtent près de trois fois plus par appel d’API que leur prédécesseur, le Muse Spark 1.3.
Meta a lancé son modèle Frontier Muse Wonder en deux variantes, et tous deux figurent parmi les meilleurs modèles d’IA disponibles.
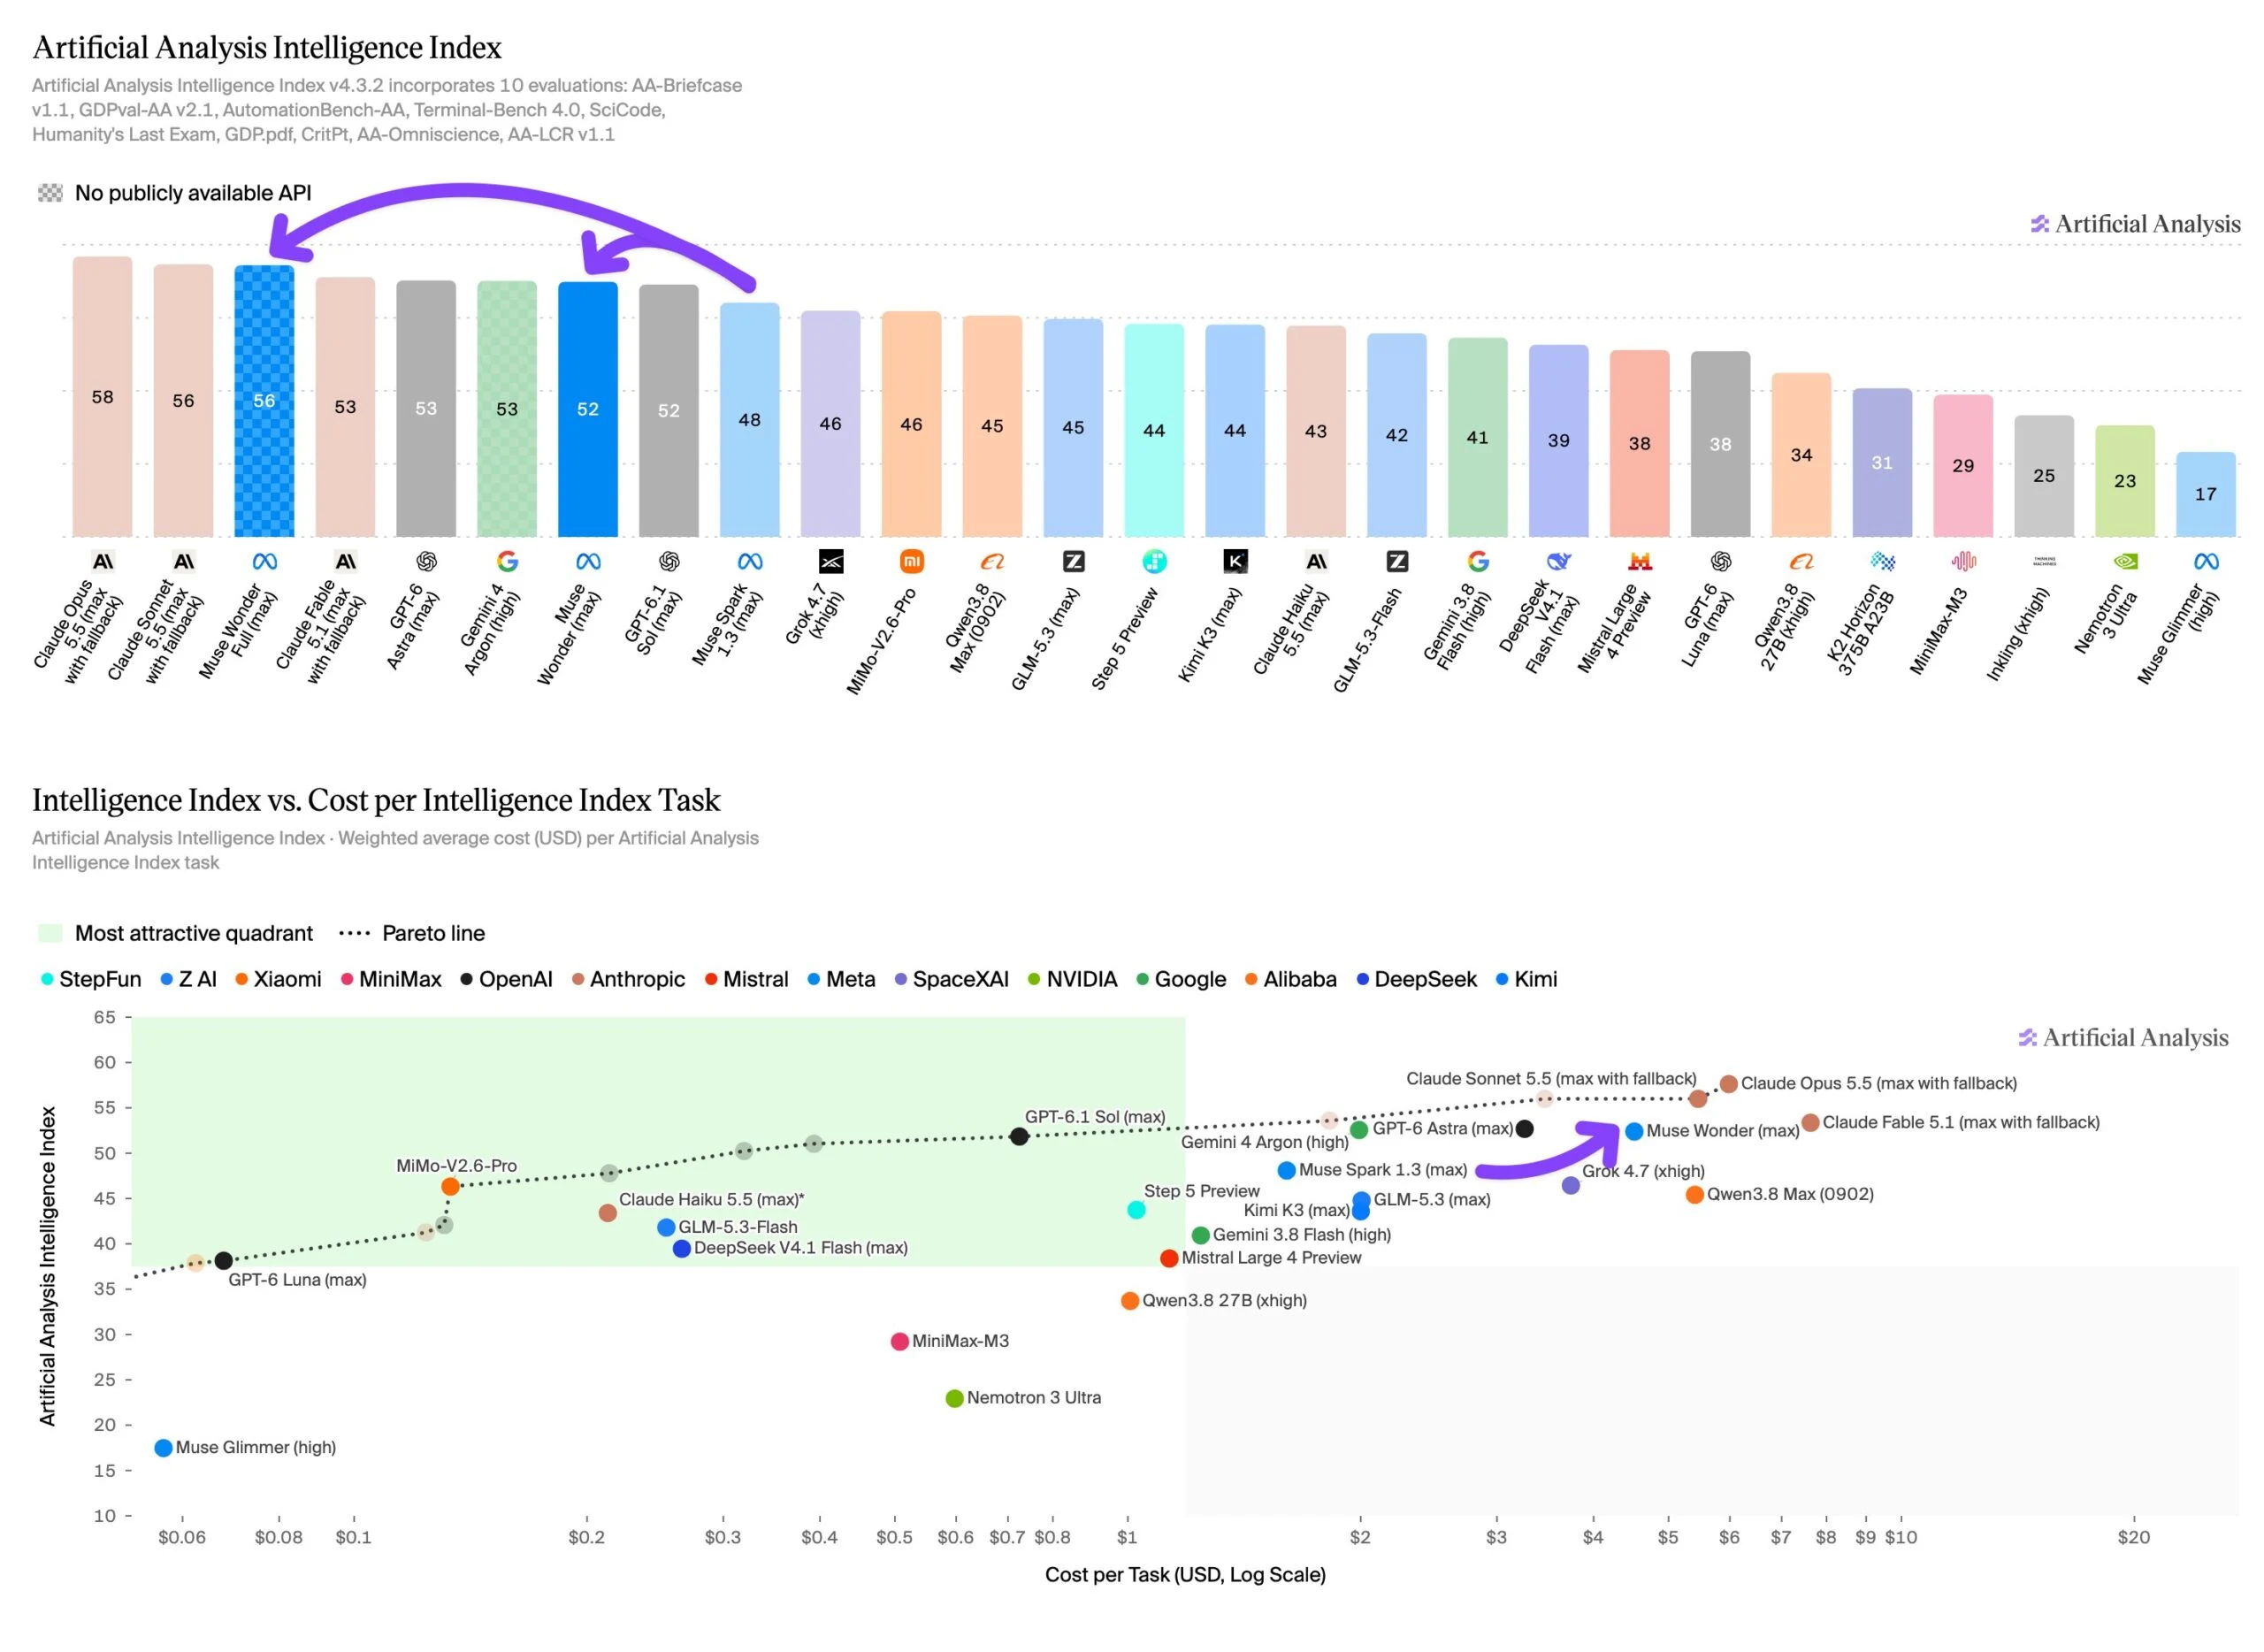
Muse Wonder Full obtient 56 points sur l’Indice d’Intelligence Artificielle d’Analyse v4.3, tandis que Muse Wonder atteint 52 points. Son prédécesseur, Muse Spark 1.3, a obtenu 48 points, ce qui représente une amélioration significative par rapport à un modèle de catégorie intermédiaire.
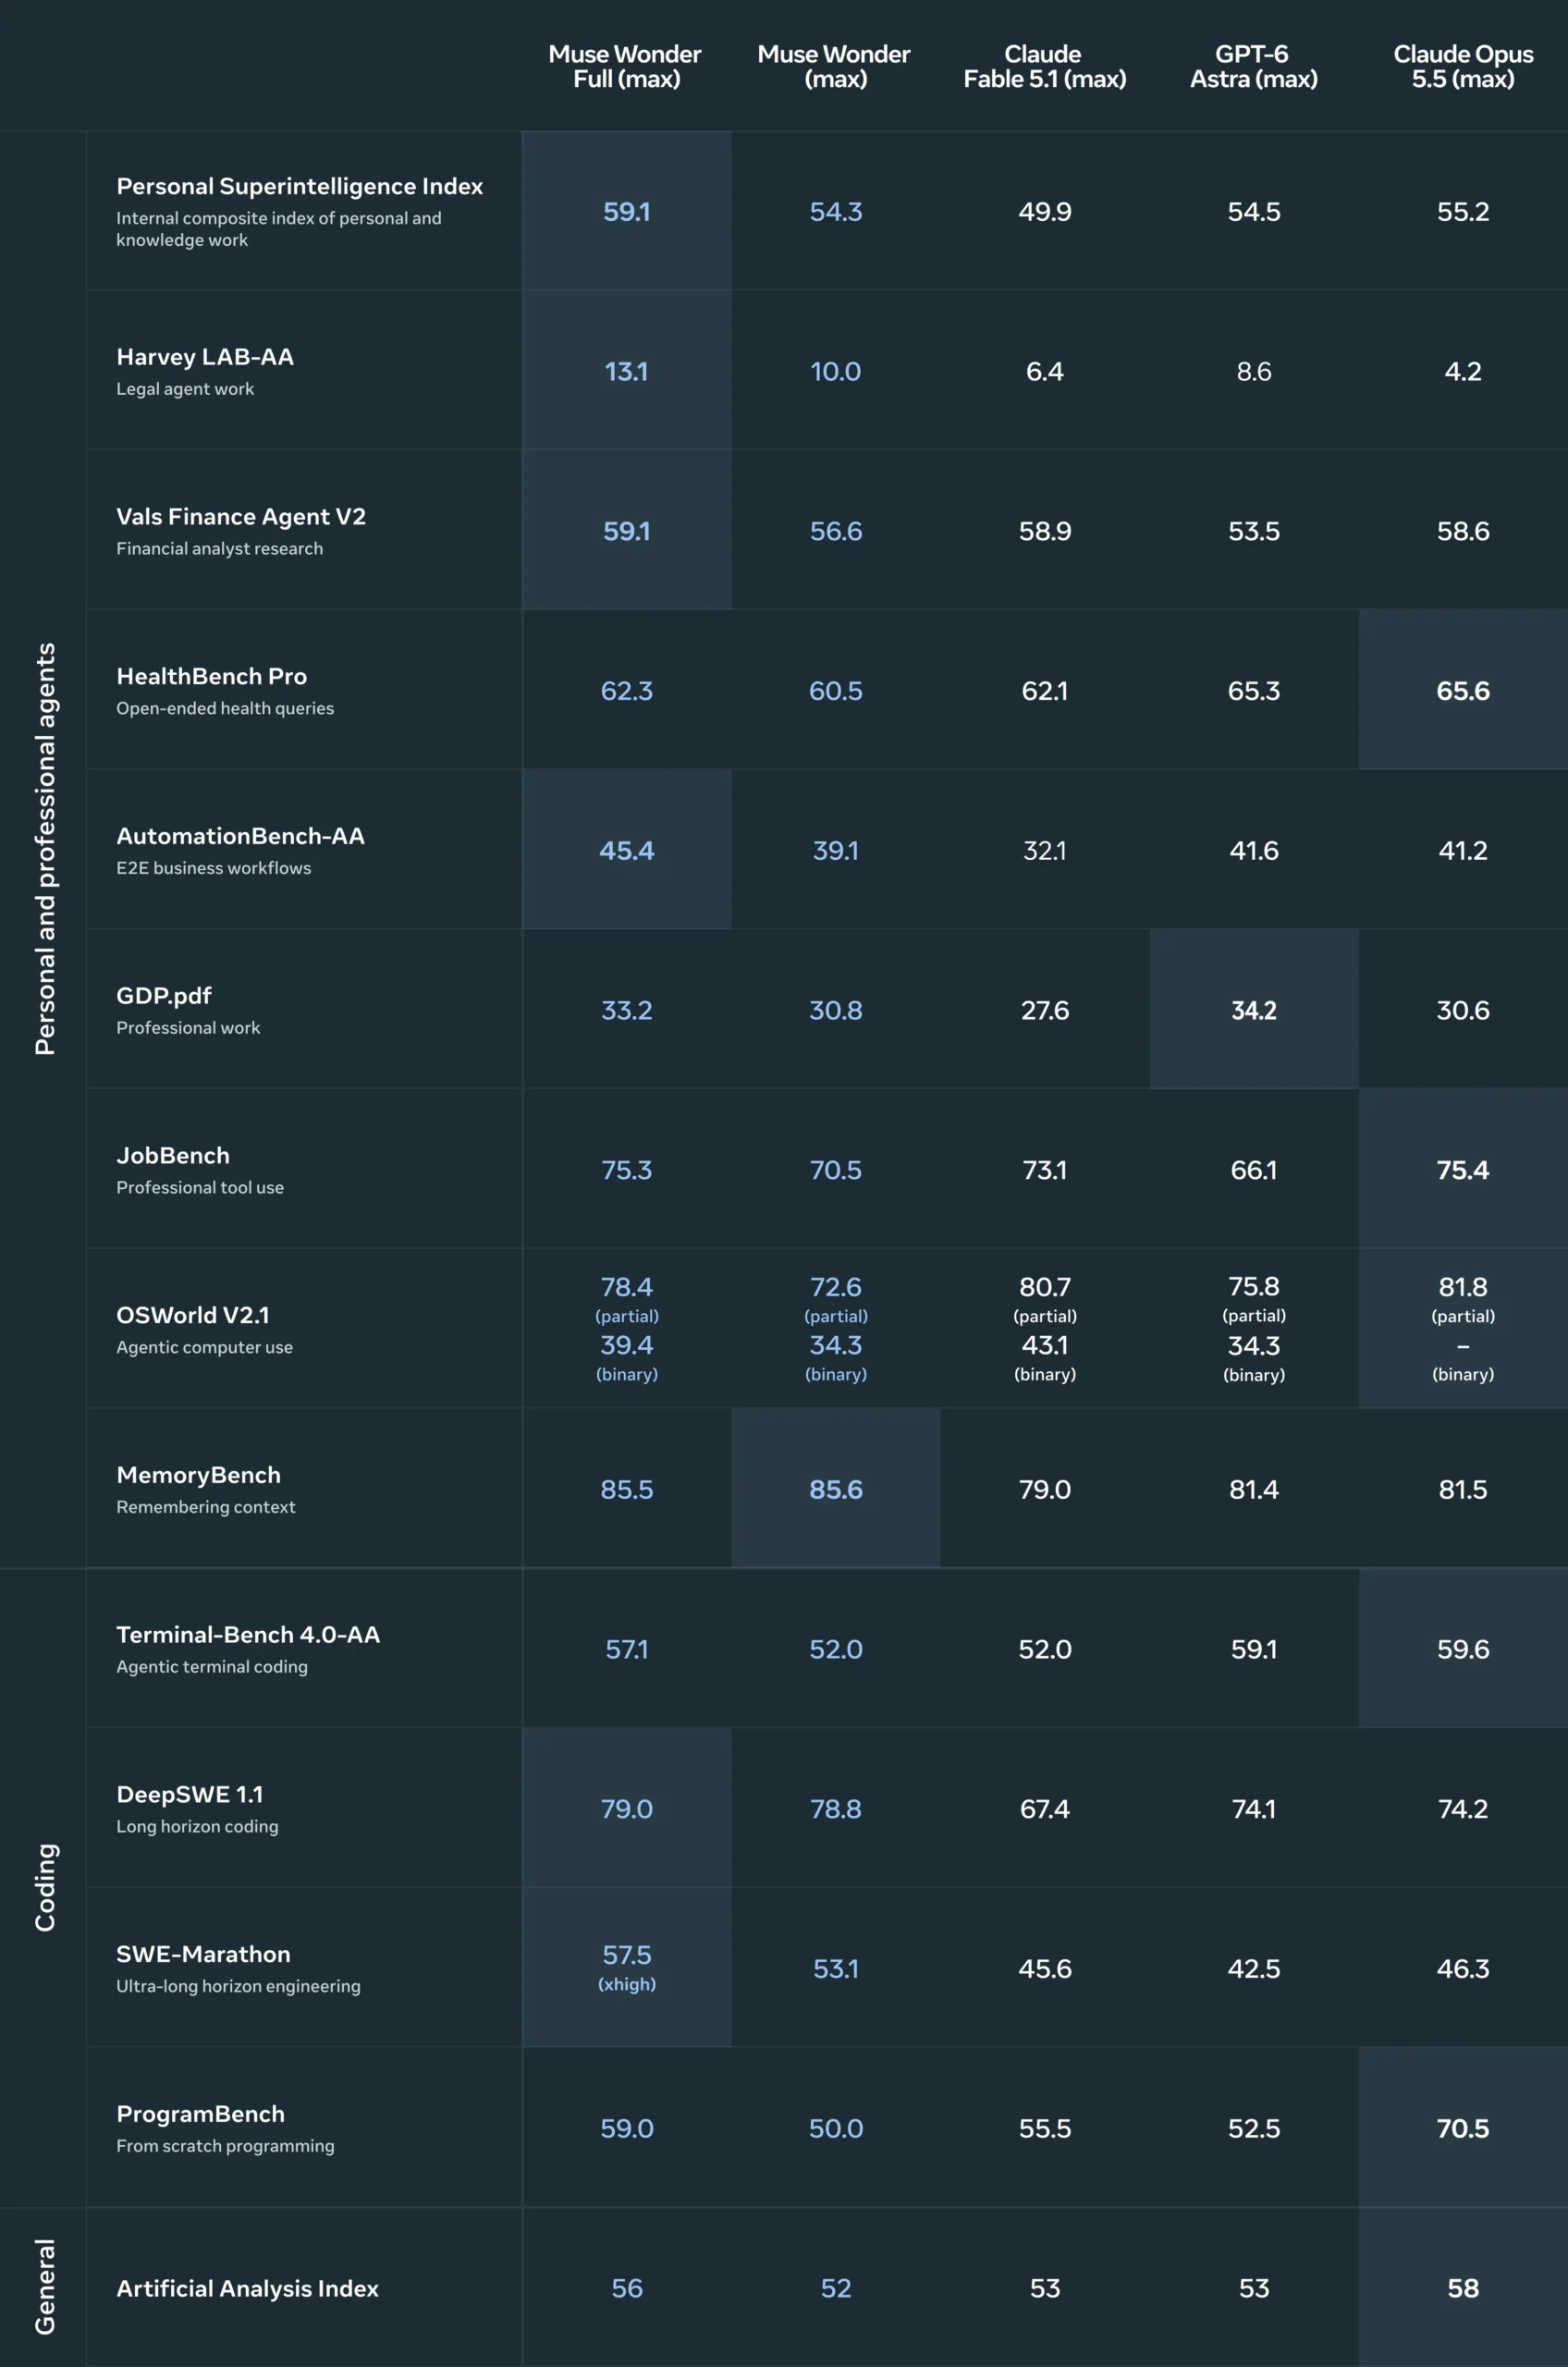
Les gains les plus importants se manifestent dans les évaluations agentiques, des tests qui mesurent la capacité d’un modèle d’IA à gérer des tâches complexes par lui-même. Sur Terminal-Bench 4.0, les performances sont passées de 33 % à 57 %. Muse Wonder Full se classe parmi les trois premiers sur six des dix benchmarks, ce qui représente une performance forte pour Meta, qui semble avoir récupéré après une période moins performante avec ses modèles Llama ouverts.
Les métadonnées mettent en avant deux nouvelles fonctionnalités. « Mémoire active » permet au modèle de retenir des informations clés au cours des conversations et de les rappeler lorsque nécessaire. « Focus actif » est la capacité du modèle à s’attacher aux tâches difficiles, explorer des approches alternatives et poser des questions complémentaires lorsqu’il y a confusion. Les deux sont centrales dans la proposition de Meta pour un agent IA personnel capable d’accéder aux calendriers, aux messages et aux documents.
Les deux modèles prennent en charge une fenêtre de contexte de un million de tokens et acceptent des textes, des images, des vidéos et de l’audio en entrée. Muse Wonder est disponible via l’API de Meta et Muse Code, tandis que Muse Wonder Full est actuellement réservé aux utilisateurs de Muse Code. Muse Wonder offrira bientôt du fonctionnement à l’application Muse, à partir des abonnés payants. Avec le temps, Meta prévoit de développer des modèles spécialisés à partir de ceux-ci pour tous les utilisateurs.
Le codage fait des sauts brusques, mais les connaissances factuelles restent en arrière
Les deux modèles montrent de grandes améliorations en matière de codage. Muse Wonder Full atteint 68 points sur l’Indice des Agents de Codage, égalant Claude Code avec Sonnet 5,5. Muse Wonder obtient 63 points, contre 54 pour son prédécesseur.
Les connaissances factuelles restent une faiblesse. Sur le test de connaissance AA-Omniscience, Muse Wonder Full ne obtient que 30 points, et Muse Wonder en obtient 25. Cela est bien en dessous de Claude Opus 5.5 (46), GPT-6 Astra (43) et Gemini 4 Argon (42), ce qui indique que la série Wonder est basée sur un modèle de base plus petit que ses concurrents. Les faibles taux d’hallucinations aident à compenser cette différence. Muse Wonder Full réduit son taux d’hallucinations de 33 % à 23 % par rapport à son prédécesseur, ce qui en fait le deuxième plus bas parmi tous les modèles ayant obtenu au moins 45 points d’index. Seul Gemini 4 Argon (15 %) hallucine moins souvent.
Meta répond à une critique courante dans son article de blog, selon laquelle les modèles Muse sont affinés pour des tests standard, mais échouent dans l’usage réel. L’entreprise indique que Muse Wonder Full se débrouille mieux que prévu sur des tâches inconnues qui n’ont pas fait partie de l’optimisation du entraînement, et attribue cela à un modèle de base plus solide.
D’après l’indice Vals AI, Muse Wonder Full (Max) fait ses débuts à la cinquième place et bat tous les modèles OpenAI, selon Vals AI. Seuls les modèles actuels d’Anthropic obtiennent une meilleure note. Muse Wonder se classe à la dixième place.
Les meilleures améliorations proviennent du codage et des mathématiques. Sur ProofBench, un benchmark privé pour les preuves mathématiques, Muse Wonder Full résolve 94 des 100 problèmes, contre 58 pour son prédécesseur. Cela le place à seulement cinq à six points derrière les modèles les plus performants (99 à 100). Sur Terminal-Bench 4, Muse Wonder Full a doublé son score en utilisant 30 % moins de tokens d’output. Les performances dans les tâches financières et juridiques sont restées au niveau du prédécesseur, avec une baisse de deux points.
Un meilleur rendement coûte cher
Selon l’analyse artificielle, Muse Wonder coûte 4,52 dollars par tâche sur l’Indice d’Intelligence, soit près de trois fois plus que Muse Spark 1,3 (1,60 dollar). Le tarif des tokens a également augmenté : 4 dollars par million de tokens d’entrée et 20 dollars pour la sortie, contre 1,25 dollar et 4,25 dollar pour le précédent version. Muse Wonder utilise également 28 % plus de tokens d’entrée par tâche, et ceux-ci représentent 76 % du coût total.
Cela place Muse Wonder en dessous de Claude Fable 5.1 (7,63 $) et de Claude Opus 5.5 (5,98 $), mais au-dessus de GPT-6 Astra (3,26 $), Gemini 4 Argon (1,99 $) et GPT-6.1 Sol (0,72 $). Aucune tarification par token n’est disponible pour Muse Wonder Full pour l’instant. Les deux modèles consomment environ 10 % moins de tokens de sortie que leur prédécesseur.
La métadonnée indique que les modèles ont été entraînés dans son centre de données Prometheus interne, à une échelle de gigawatt. Plus de détails se trouvent dans la carte du modèle.
Nouvelles sur l’IA Sans Hype – Sélectionnées par des humains
S’abonner à THE DECODER pour une lecture sans publicités, un bulletin informatique sur l’IA hebdomadaire, notre rapport de pointe exclusif « AI Radar » six fois par an, un accès complet à l’archive et la possibilité d’accéder à notre section de commentaires.
Source : Meta | Artificial Analysis | Model Card