
Par Mengyao, depuis 凹非寺
量子位 | Compte officiel QbitAI
Waouh,ByteDanceest-il en train de transformer la génération par IA en monde ouvert cette fois-ci ?!
Regardez : il suffit d'entrer une phrase, et l'IA génère de nulle part une pièce vue en perspective miniaturisée ~
Ensuite, après quelques manipulations frénétiques au clavier et à la souris, on peut monter sur un avion en papier dans ce monde cyber etvoler librementaller où l'on veut :
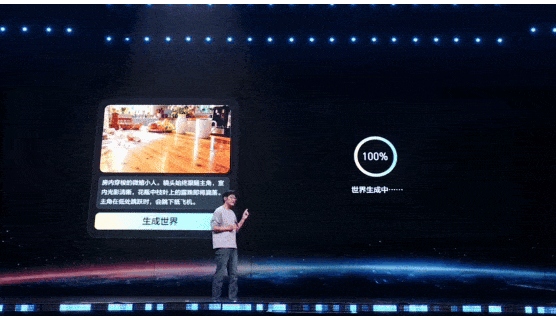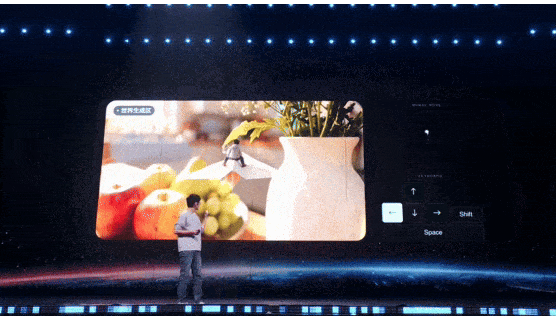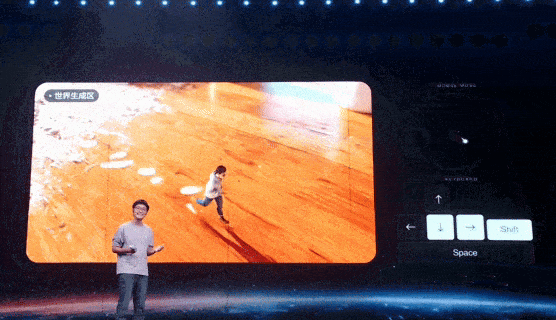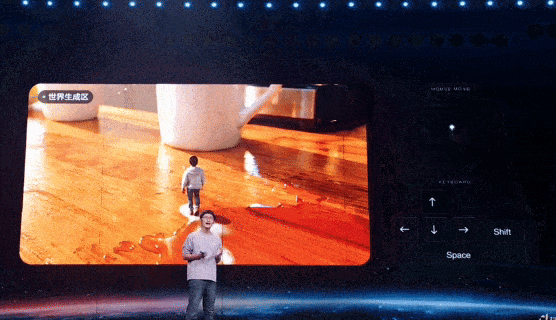
Et ce n'est pas tout : dans ce monde généré par l'IA, on peut même créer à volonté ce qui se trouve devant nous !
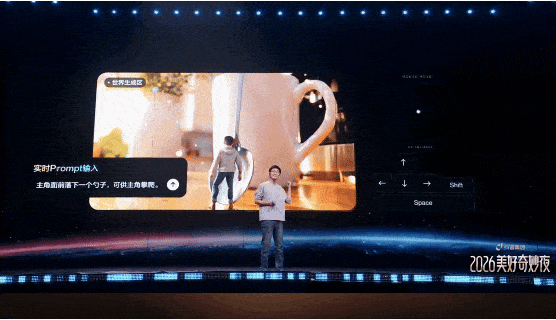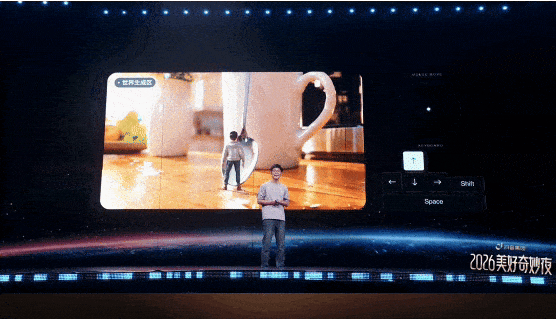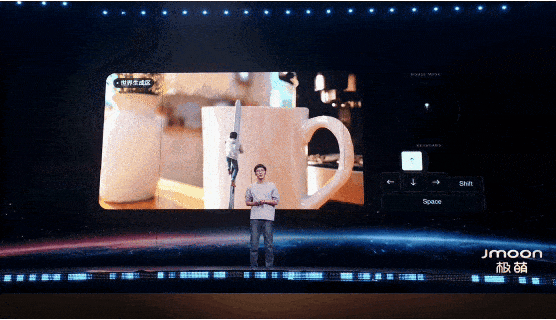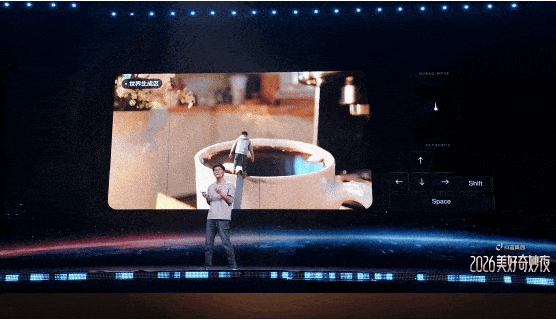
Besoin d'une cuillère ? On en fabrique une de nulle part, et même…
On peut aussiinteragiravec la cuillère, transformant un ustensile du quotidien en véritable site d'escalade —
Bien sûr, ce monde peut faire bien plus que cela encore.
Grâce à la fonctionporte de téléportation, deux scènes totalement sans rapport peuvent être directement connectées.
Une seconde on est dans la pièce, la seconde suivante on pousse la porte et on se retrouve dans l'espace ?!
Une scène aussi magique est apparue lors de l'émission scientifique《Nuit des merveilles 2026》 du groupe Douyinqui vient de s'achever, le démonstrateur n'étant autre que Tim de 影视飓风.
Plus remarquable encore : cette série d'opérations de création cyber repose sur lemodèle de mondequeByteDancedéveloppe discrètement depuis longtemps. (Choc.jpg)
Bien que le modèle ne soit pas encore officiellement lancé, d'après ce qui a été montré sur scène, il démontre déjàgénération de scènes en trois dimensions, exploration libre, interaction en temps réel, édition d'objets,Même la capacité deconnexion libreentre différents espaces ~
Cette fois, ByteDance a profité d'une démonstration en direct de l'émission pour offrir à son modèle mondial une« première apparition »inattendue, prenant ainsi les devants pour étaler ses muscles.
Cela me touche beaucoup : ces dernières années, de World Labs fondée par Li Fei-Fei, au Genie de Google DeepMind, en passant par Cosmos de NVIDIA.
Une foule de géants de la technologie se sont lancés dans la course, tentant de faire comprendre à l'IA les structures spatiales, de simuler les lois de la réalité, voire de prédire comment l'environnement évolue selon les actions humaines.
Aujourd'hui, l'IA est en train de matérialiser les mondes des films de science-fiction.
Dessiner un monde, c'est déjà faire vivre tout un monde
Je suppose que ceux qui se sont initiés les premiers à l'AIGC il y a quelques années n'auraient jamais imaginé que —
un jour, les vidéos générées par l'IA pourraient devenir un monde cyber en 3D dans lequel on peut entrer, qui prend en charge l'interaction et se laisse éditer avec souplesse.
Je viens de compter un peu : depuis le début de l'année jusqu'à aujourd'hui, j'ai déjà testé environ six ou sept produits de modèles mondiaux…
Le niveau de stupéfaction est tel qu'on aurait pu regarder Interstellar la veille et se découvrir le lendemain capable d'entrer dans l'écran, en profitant pour transporter un trou noir dans son propre salon.
Alors, comment l'IA a-t-elle pu passer de la génération d'images et de vidéos à la création de mondes, avec une telle aisance ?!
Cette question, il faut la commencer par une faiblesse technique de la génération multimodale traditionnelle. (doge)
Aujourd'hui, les modèles mondiaux ont donné naissance à plusieurs voies technologiques : prédiction d'états abstraits, modélisation causale physique, mondes 3D génératifs, chacune avec ses priorités.
Celle dont nous allons parler ici est principalement la voie liée à la génération multimodale et à l'intelligence spatiale :
apprendre à l'IA les structures spatiales et les lois d'évolution du monde réel, afin de générer, reconstruire et simuler un monde en 3D qui peut être exploré en continu et avec lequel on interagit en temps réel.
Il faut insister sur le fait qu'il y a ici deux mots-clés :structure spatialeainsi quelois d'évolution。
Or ces deux capacités touchent précisément un problème fondamental que les technologies de génération visuelle n'ont pas encore entièrement résolu ces dernières années.
△ Généré par IA
En 2024, OpenAI a lancé Sora, et ses vidéos générées époustouflantes ont littéralement fait vaciller et chavirer tout le web, laissant tout le monde dans la stupeur aux côtés de Sam Altman.
Mais comparé aux vidéos qui avaient saturé les écrans à l'époque, c'est plutôt le rapport technique publié par OpenAI à la même période qui mérite aujourd'hui qu'on s'y attarde —
« Video generation models as world simulators », traduit littéralement« Modèles de génération de vidéos en tant que simulateurs du monde »。
À cette époque, OpenAI a découvert qu'à mesure que l'échelle des modèles de génération vidéo augmentait, les modèles commençaient à faire émerger une certaine cohérence tridimensionnelle, une persistance des objets, et pouvaient même simuler des interactions environnementales simples.
Mais ce qui est gênant, c'est qu'un modèle capable de générer des images de monde réalistes peut encore échouer à gérer même les plus basiques des « relations physiques ».
Par exemple, Sora est capable de générer une image d'une personne courant sur un tapis de course, avec un personnage, des jeux de lumière et un cadrage qui semblent tout à fait crédibles.
Mais en y regardant de plus près, la relation entre les mouvements du personnage et le déplacement du tapis de course ne correspond pas forcément à la logique physique du monde réel : l'image est très réaliste, mais les lois de la physique semblent un peu laissées au hasard ??
△ Source de l'image : site officiel d'OpenAI
Derrière cela se cache en réalité un problème assez fondamental des technologies traditionnelles de génération visuelle.
Au cours des dernières années, qu'il s'agisse des modèles de diffusion ou des architectures génératives basées sur Transformer, les principaux modèles d'images et de vidéos ont principalement reposé sur l'apprentissage au sein d'immenses données visuelles deLoi statistique, afin de générer des images conformes aux conditions d'entrée.
Cette méthode a connu un succès considérable, au point de pouvoir apprendre implicitement une partie de la géométrie tridimensionnelle, des relations entre objets et des lois physiques.
MaisLa continuité spatio-temporelle visuelle ne correspond pas nécessairement à un ensemble d'états du monde stable et accessible à l'intervention d'actions externes.——
Par exemple, faire en sorte qu'un verre conserve une apparence cohérente tout au long d'une vidéo est déjà relativement facile pour les modèles génératifs actuels.
Mais lorsqu'il est ramassé, reposé, voire poussé jusqu'au bord de la table, le modèle doit également suivre en continu la position spatiale, les relations entre objets et les changements d'état, et prédire les résultats physiques tels que les collisions et les chutes.
En d'autres termes, entre générer une vidéo conforme à l'intuition physique et prédire de manière fiable les changements environnementaux provoqués par une action, il subsiste un problème de modélisation de l'état du monde.
Et c'est justement là que les modèles du monde excellent.
En juin de cette année, l'équipe de Li Feifei a publié un article intitulé « A Functional Taxonomy of World Models ».
L'article divise les modèles du monde en trois types du point de vue fonctionnel, et permet ainsi d'expliquer plus clairement quelles sont les véritable « capacités » des modèles du monde —
- Moteur de rendu : responsable du mondeOn dirait queÀ quoi cela ressemble, en produisant des images visuelles destinées aux humains, dont l'objectif principal est le réalisme de l'image et l'expressivité visuelle.
- Simulateur : responsable du mondeEffectivement...est, en maintenant un état de scène conforme à la géométrie et à la causalité physique.
- Planificateur : chargé de déterminer la prochaine action de l'agentAction, en se basant sur l'état actuel du monde et les objectifs établis, de produire une action raisonnable.
Ce qui est fascinant dans cette classification, c'est qu'elle explique précisément pourquoi, alors que l'IA est déjà capable de générer des vidéos d'un réalisme troublant, nous devons encore déployer tant d'efforts pour étudier les modèles de monde.
De la génération d'images visuelles réalistes, au maintien d'un état d'environnement conforme aux lois de la physique, jusqu'au soutien de la prise de décision et de l'action autonomes des agents —
les capacités de représentation spatiale, de prédiction dynamique et de planification d'actions impliquées derrière tout cela sont précisément les défis techniques que les modèles génératifs multimodaux traditionnels n'ont pas encore pleinement résolus.
Or aujourd'hui, ces conceptions de modèles de monde qui semblaient assez inaccessibles dans les articles de recherche commencent à être « fabriquées » petit à petit par l'IA.
△ Source de l'image : l'article « A Functional Taxonomy of World Models »
Prenons par exemplel'émission scientifique《2026 美好奇妙夜》du Groupe Douyin, où l'on a présenté cette opération cybernétique de création d'univers réalisée à partir des modèles d'IA de ByteDance.
Générer une image à partir d'une simple phrase n'a plus rien d'extraordinaire de nos jours.
Mais lorsqu'une personne pénètre réellement dans cette scène générée par l'IA et peut s'y déplacer librement, ce que le modèle doit traiter s'étend alors de la génération de cette seule image devant les yeux au maintien de la structure spatiale de toute la scène.
Peu importe la direction dans laquelle la personne se déplace ou l'angle sous lequel elle observe, le terrain, les objets et leurs positions relatives dans la scène doivent conserver une cohérence géométrique suffisante.
Ce qui se cache derrière cela, c'est précisément lacapacité de représentation spatialedu modèle monde, qui constitue également la base permettant à une scène générée par une IA de vraiment résister à une exploration répétée.
Si l'on veut une cuillère, l'IA peut la générer à partir de rien, et l'on peut même ramper le long de la cuillère pour une interaction en temps réel avec les actions.
Derrière ces quelques opérations en apparence simples se trouvent pourtant les capacités du modèle monde en matière degénération instantanée, de modélisation de l'état de l'environnement et de prédiction dynamique——
. Le modèle doit mettre à jour en temps réel les objets et les relations spatiales de la scène en fonction des actions de l'utilisateur, tout en prédisant continuellement les changements environnementaux provoqués par les actions, afin de maintenir la cohérence des états successifs.
Mieux encore, l'espace lui-même peut être transformé à volonté : dessinez une « porte magique » et vous pouvez directement relier une pièce réelle à l'espace extra-atmosphérique.
À ce stade, les capacités du modèle monde s'étendent à un niveau supplémentaire :la reconstruction de scènes en trois dimensions, l'édition spatiale contrôlable et la modélisation de la continuité entre scènes.
Le modèle peut, tout en préservant la structure spatiale de la scène d'origine, recomposer dynamiquement les relations géométriques entre différentes scènes, prenant en charge l'exploration continue entre scènes et l'interaction en temps réel :
Du maintien de la structure spatiale à la réponse aux interactions en temps réel, puis à la prise en charge de l'édition de scènes et de la recomposition inter-espaces, les capacités du modèle IA de ByteDance convergent toutes vers la caractéristique fondamentale du modèle monde :
l'IA ne génère plus seulement du contenu ; ce qu'elle génère est un monde numérique capable de persister, de changer et d'interagir en continu.
Au cours des dernières années, les grands modèles de langage n'ont cessé d'étendre la capacité de l'IA à traiter le langage et les connaissances, tandis que les modèles multimodaux ont étendu la capacité de génération aux images, aux sons et aux vidéos.
Aujourd'hui, avec le développement des modèles monde, l'IA commence à explorer plus avant la structure spatiale, l'état de l'environnement et leurs lois d'évolution.
Le développement technologique de l'IA générative passe également du critère du réalisme des images à celui de la capacité d'un environnement généré à persister, à répondre aux interactions, voire à simuler le fonctionnement du monde réel.
Le modèle monde : permettre à l'IA d'acquérir de « vraies compétences » dans le monde virtuel
Bien entendu, si le modèle monde ne servait qu'à laisser les humains explorer le cybermonde dans tous les sens, ce serait quelque peu sous-utiliser son potentiel.
Dans un cadre industriel plus large, il possède une valeur encore plus riche en imagination :
permettre aux machines de s'entraîner massivement dans le monde virtuel, d'essayer et de se tromper à répétition, puis de transférer les compétences acquises dans le monde réel.
Après tout, le développement des IA physiques telles que les robots et la conduite autonome est depuis longtemps limité par des contraintes concrètes : coût élevé de la collecte de données réelles, longs cycles d'essais et d'erreurs, et difficulté à reproduire des scènes dangereuses ou extrêmes.
Le modèle monde offre une nouvelle voie : transformer l'environnement réel en un terrain d'entraînement virtuel générable, contrôlable et vérifiable à répétition.
De la génération de données d'entraînement rares à la simulation d'environnements complexes et à la validation de stratégies d'action, certaines étapes d'entraînement qui dépendaient auparavant de l'environnement réel pourraient être transférées dans le monde virtuel.
Cela permet également au modèle monde de s'étendre de la génération de contenu aux étapes d'entraînement et de validation des IA physiques, devenant ainsi un axe d'exploration technologique majeur dans des domaines tels que la robotique et la conduite autonome.
△Généré par IA
Commençons par parler de la question des « données d'entraînement ».
Pour les systèmes d'IA physique comme la conduite autonome, plus les scènes extrêmes sont critiques, plus les données d'entraînement correspondantes sont rares.
Par exemple, des scènes à faible fréquence et haut risque comme des accidents soudains ou des conditions météorologiques extrêmes peuvent ne se présenter que rarement même après de nombreux kilomètres parcourus ; or le modèle monde est précisément capable de générer et de simuler ces scènes à la demande, de façon répétée.
Lors de l'émission scientifique 《2026 美好奇妙夜》 du groupe ByteDance, ils ont présenté une démonstration de conduite autonome de ce type :
une ambulance surgissant soudainement, des piétons traversant la chaussée, un agent de la circulation dirigeant sur place.
Diverses conditions de circulation complexes sont introduites dans une route virtuelle générée par IA ; le véhicule peut y simuler sa conduite, faire face aux situations imprévues, et analyser ses performances de conduite grâce à des relectures multi-caméras.
Les scènes de longue traîne, dont l'accumulation exigeait autrefois de nombreux essais routiers réels, peuvent désormais être générées en masse grâce au modèle monde et utilisées pour l'entraînement et la validation répétés des systèmes de conduite autonome.
Outre les données d'entraînement, la valeur industrielle des modèles du monde se manifeste dans un autre aspect essentiel :l'amélioration de l'efficacité de l'entraînement et de la validation de l'IA physique.
Tout le monde sait que les robots réels doivent exécuter des actions et attendre des retours à chaque entraînement, et qu'en cas d'échec, une réinitialisation manuelle peut être nécessaire, avec le risque d'endommager le matériel.
Mais dans un monde en trois dimensions, ce processus d'essais et d'erreurs qui prenait énormément de temps peut se transformer en expériences de simulation répétables et parallélisables.
La démonstration de robot domestique présentée lors de l'émission scientifique « 2026 Nuit des Merveilles » du groupe Douyin reflète une démarche similaire.
Dans un environnement familial virtuel généré par l'IA, les robots peuvent s'entraîner à des tâches ménagères telles que saisir, transporter et ranger des objets, et également ajuster leurs stratégies d'action face à des positions d'objets et des agencements spatiaux en constante évolution, en essayant d'accomplir leurs missions.
Même en cas d'échec d'une opération, ils peuvent rapidement reproduire le problème dans l'environnement virtuel, ajuster leur stratégie, et s'entraîner et se vérifier de manière répétée.
Par rapport aux opérations répétées dans le monde réel avec remise en état manuelle à chaque fois, les modèles mondiaux donnent aux robots la possibilité de tester et de se tromper en parallèle dans différents scénarios, acquérant ainsi, à moindre coût et plus rapidement, la capacité de faire face à l'environnement réel.~
À l'échelle de l'ensemble du secteur, les géants de la technologie ont en réalité déjà commencé à explorer, dans différentes directions, l'application industrielle des modèles mondiaux.
En mars de cette année,Nvidiaa combiné le modèle mondial Cosmos avec la plateforme de simulation Isaac, permettant aux robots de générer des données et de s'entraîner de manière répétée dans un environnement virtuel.
Et cette solution de simulation industrielle devrait réduire considérablement le coût du passage de l'entraînement au déploiement réel des robots.
△ Source de l'image : site officiel de Nvidia
Plus remarquable encore, cette vague d'engouement a même entraîné les géants des puces en amont.
Au mois de septembre (9) qui vient tout juste de s'écouler,AMD a annoncé l'acquisition de World Labs de Fei-Fei Li pour la somme colossale de 8,2 milliards de dollarsdans le but d'anticiper la demande de puissance de calcul des modèles mondiaux et de préparer le terrain pour le développement de la prochaine génération de puces.
De l'entraînement virtuel des robots à la simulation industrielle, jusqu'à l'entrée en scène directe des géants des puces.
La concurrence industrielle autour des modèles mondiaux s'étend tout au long de la chaîne industrielle, depuis les capacités des modèles et les applications pratiques, jusqu'aux architectures de calcul sous-jacentes.
Course mondiale aux modèles mondiaux : les acquis technologiques des acteurs chinois commencent à porter leurs fruits
Les modèles mondiaux sont bel et bien en plein essor, mais derrière cette vague, un phénomène industriel assez intéressant se dessine progressivement.
Les fabricants nationaux et étrangers explorent tous la construction de mondes tridimensionnels spatialement stables et capables d'interactions en temps réel, mais les acquis technologiques, les priorités de recherche et les trajectoires d'application de chacun présentent des différences notables —
les objectifs technologiques convergent progressivement, mais les voies de réalisation ont chacune leurs spécificités.
Prenons l'exemple de l'étranger : Genie de Google DeepMind et World Labs de Fei-Fei Li explorent tous deux des capacités de simulation mondiale généralistes, axées sur la structure spatiale, la modélisation dynamique des environnements et la génération de scènes interactives.
Cosmos de Nvidia, quant à lui, est plus proche des besoins concrets de l'IA physique, en combinant modèles mondiaux, simulation robotique et génération de données synthétiques, dans le but de relier l'entraînement virtuel aux applications réelles.
Ces différentes voies ont chacune leurs orientations, mais toutes convergent finalement vers un objectif :permettre aux environnements virtuels générés par l'IA de posséder progressivement la capacité de simuler le monde réel.
Portons maintenant notre regard sur la Chine.
Un avantage méritant l'attention est que, par rapport à la voie explorée à l'étranger, axée sur la simulation mondiale généraliste, les capacités technologiques accumulées ces dernières années par les fabricants chinoisdans les domaines de la génération d'images et de vidéos offrent aux modèles mondiaux une autre voie d'évolution tout à fait compétitive.
En juillet de cette année,Seedance 2.5a étendu la durée d'une génération vidéo unique à 30 secondes, tout en renforçant le contrôle par références multimodales, les mouvements de caméra et les capacités de narration continue.
Le modèle de génération d'images publié à la même période,Seedream 5.0 Prorenforce en outre la compréhension des positions spatiales, la cohérence structurelle et l'édition interactive de précision.
L'utilisateur cercler un emplacement sur l'image, voire y tracer quelques traits au hasard, et le modèle peut modifier la zone désignée — vraiment : on dessine où l'on veut, et c'est modifié là.
De la cohérence de la structure spatiale, à la continuité dynamique sur de longues séquences temporelles, jusqu'à la réponse précise aux opérations externes, tout cela constitue précisément les problèmes techniques incontournables pour construire un monde tridimensionnel interactif.
Les technologies accumulées ces dernières années par les fabricants chinois en génération visuelle et en édition contrôlable commencent aujourd'hui à révéler leur potentiel d'extension vers des modèles de monde généralistes.
En 1895, les frères Lumière portaient sur l'écran un train entrant en gare.
Les gens de l'époque avaient sans doute du mal à imaginer que cette nouvelle invention allait, dans les décennies et les siècles qui suivirent, transformer radicalement la manière dont l'humanité enregistre et représente le monde.
Plus d'un siècle plus tard, avec l'apparition successive de l'infographie et de la réalité virtuelle, l'humanité a commencé à tenter de passer de l'observation d'un monde à l'écran à l'expérience immersive et à l'exploration de mondes numériques.
Aujourd'hui, l'avènement des modèles de monde donne un nouveau tournant à cette évolution technique qui dure depuis plus de cent ans —
les machines commencent à apprendre la structure spatiale et les lois de fonctionnement du monde réel, et tentent de générer des environnements virtuels capables d'être explorés en continu, d'interagir en temps réel, voire de servir à simuler la réalité.
Il y a plus de cent ans, l'humanité a appris à enregistrer le monde par l'image.
Plus de cent ans après, nous commençons à tenter de faire de l'image un monde dans lequel on peut réellement entrer, et même modifier la réalité.
Plus de cent ans ont passé, et cette fois, nous commençons enfin à tenter d'entrer dans les images que nous avons nous-mêmes créées.