
Les applications qui acheminent des requêtes, sélectionnent des actions d'agents ou attribuent des résultats de politiques ont souvent besoin de scores sur un ensemble fixe de choix plutôt que de texte en forme libre. Le déploiement de ces modèles de décision avec llama.cpp sur Amazon SageMaker AI vous offre un chemin géré pour servir des modèles quantisés sur une infrastructure CPU ou GPU.
Cet article poursuit une série consacrée aux AWS Deep Learning Containers (DLC) spécialisés pour l'inférence en IA générative. Les articles précédents portent sur WhisperX, vLLM-Omni – Part 1, et vLLM-Omni – Part 2.
Dans cet article, vous utilisez d'abord le AWS DLC pour llama.cpp pour servir des complétions de chat compatibles avec OpenAI via SageMaker AI InvokeEndpoint. Vous étendez ensuite le même runtime avec SemIf, anciennement OpenJev, qui renvoie des probabilités sur des options déclarées sans décoder un jeton de réponse. L' exemple de code accompagnant inclut des options de déploiement CPU et GPU.
Vue d'ensemble de la solution
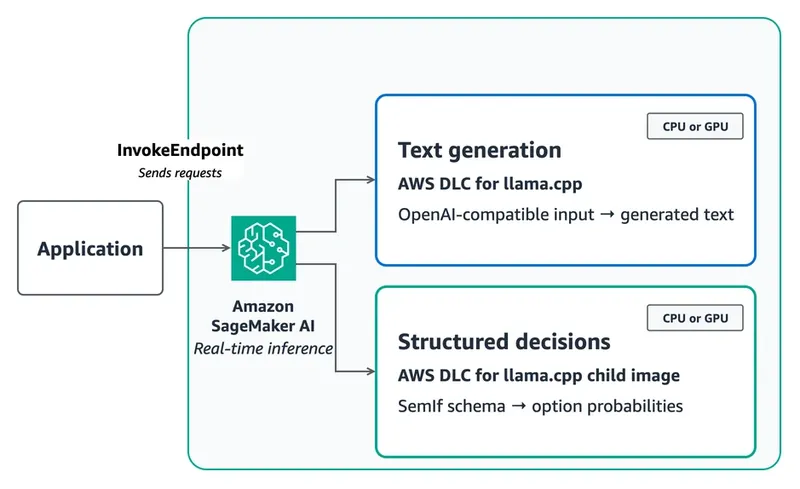
La figure 1 montre deux chemins de déploiement à partir du même modèle empaqueté. Le chemin de génération de texte utilise le AWS DLC pour llama.cpp et renvoie les réponses générées via l'API compatible OpenAI. Le chemin de décision structurée construit une image enfant qui remplace le serveur par défaut par un adaptateur SemIf et renvoie des probabilités pour les options déclarées.
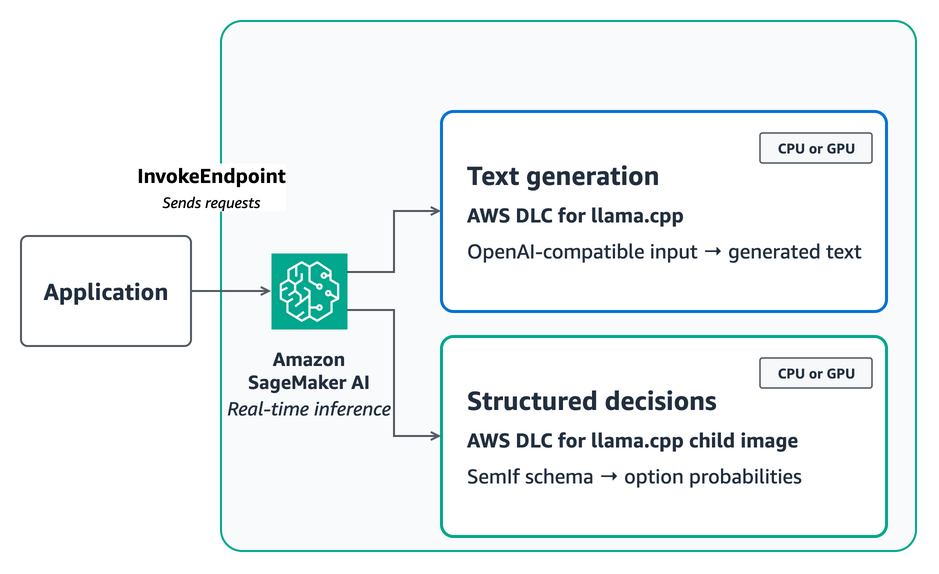
Figure 1 : Exécutez le AWS DLC pour llama.cpp ou l'image enfant SemIf sur CPU ou GPU, selon les exigences d'API et de latence de votre charge de travail
Pour le chemin standard, empaquetez le modèle comme model.tar.gz dans Amazon Simple Storage Service (Amazon S3) et référencez directement l'image DLC publiée. Le conteneur trouve le premier .gguf fichier sous /opt/ml/model, mappe POST /invocations vers llama-server sur /v1/chat/completions, et transmet SM_LLAMA_CPP_* des variables d’environnement aux arguments de llama.cpp.
L’ llama-server API HTTP n’expose pas les logits de position finale ni les opérations d’état que SemIf utilise. Le chemin de décision structurée utilise donc AWS CodeBuild pour construire une image enfant et la stocker dans Amazon Elastic Container Registry (Amazon ECR). L’image enfant conserve les bibliothèques CPU ou CUDA compilées du DLC tout en remplaçant son point d’entrée par un adaptateur compatible avec SageMaker.
Comprendre les schémas d’entrée et de sortie
Le DLC AWS pour llama.cpp accepte le schéma OpenAI Chat Completions. Envoyez un tableau messages avec role et content, ainsi que des contrôles de génération tels que max_tokens et stream:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
. La réponse utilise le tableau choices compatible OpenAI. Lisez le texte généré à partir de choices[0].message.content.
. SemIf utilise un schéma de décision contrainte au lieu de messages de conversation. La requête contient un ID défini par l’appelant, un état non structuré, une question et une liste ordonnée d’options autorisées :
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
La réponse renvoie option_ids, probabilities, et les option_logits bruts dans le même ordre, ainsi que les métadonnées de prompt, de temporisation et de modèle épinglé. Avec des ID d’options stables, votre application peut appliquer des seuils, des solutions de repli et des vérifications de stratégie sans analyser la prose générée.
SemIf appartient à une classe plus large de modèles de décision qui évaluent des résultats définis par l’application à partir d’un état non structuré. Parmi les autres implémentations figurent Jev, le modèle de décision de TypeSafe et son /v1/systemone API ; Kev, un serveur de modèles conçu pour la compatibilité avec l’API de TypeSafe ; et Strands Decider 2B, un modèle conçu spécifiquement pour les workflows d’agents avec des sorties étalonnées.
Choisir les bons workflows de décision
Utilisez ce modèle lorsque votre application définit les choix autorisés au moment de la requête et a besoin qu’un modèle interprète un contexte non structuré. Parmi les exemples figurent le routage d’un dossier vers une file d’attente, l’extraction d’une valeur d’un ensemble connu, l’attribution d’une priorité à un incident, la vérification du résultat d’une stratégie ou la sélection d’une action d’agent. Conservez l’autorisation et les règles métier déterministes en dehors du modèle, et validez les probabilités du modèle avant de les considérer comme une confiance opérationnelle.
Utilisez le parcours standard de génération de texte de SageMaker AI lorsque vous avez besoin de complétions de chat compatibles avec OpenAI via InvokeEndpoint. L'image SageMaker AI correspond POST /invocations à la llama-server /v1/chat/completions endpoint. Ne créez une image enfant que si votre application a besoin d'un comportement que cette interface ne fournit pas, comme l'accès direct aux logits et à l'état de SemIf.
Supprimer la génération de jetons de réponse ne supprime pas l'inférence du modèle. Le modèle traite toujours l'état complet, la question et les descriptions d'options avant que SemIf ne lise les logits finaux. Gardez les invites ciblées et évaluez le modèle choisi avec des décisions étiquetées issues de votre application avant une utilisation en production.
Optimisez en fonction de vos objectifs de latence et de qualité
Le benchmark suivant s'applique à l'extension SemIf, et non au point de terminaison de génération de texte. La taille du modèle, la quantification, la longueur du prompt, le runtime et le nombre de threads CPU influencent chaque décision. Pour quantifier ces compromis, nous avons envoyé les mêmes 231 publics JevBench exécute les tâches en série vers un point de terminaison CPU et un point de terminaison GPU.
| Configuration | AWS DLC pour llama.cpp | Réponses valides | Précision | Client p50 | P95 client |
Qwen3.5-4B Q4_K_M, ml.c6i.8xlarge, 32 threads |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715 secondes | 19.291 secondes |
Qwen3.5-4B Q4_K_M, ml.g6e.xlarge, déchargement GPU complet |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352 secondes | 0.599 seconde |
Par rapport à la configuration CPU, le point de terminaison GPU était 4.9 fois plus rapide à p50 et 32.2 fois plus rapide à p95. L’exemple utilise la fonctionnalité de pools d’instances SageMaker AI pour lister les types d’instances GPU compatibles par ordre de priorité, afin que SageMaker puisse sélectionner une alternative lorsque le premier choix n’est pas disponible. Le pool ordonnait g6e, g6, g5, puis g4dn. SageMaker sélectionné ml.g6e.xlarge, et les journaux de démarrage confirmaient que llama.cpp avait déchargé les 34 couches du modèle sur une NVIDIA L40S. Les images CPU et GPU utilisaient des builds llama.cpp différents et ont produit des prédictions différentes sur six tâches difficiles. Considérez la différence de précision à réponse unique comme une variation d'exécution, et non comme la preuve que le déchargement GPU améliore la qualité du modèle.
Les modèles plus petits ont réduit la latence médiane, mais les candidats 2B et 0.8B ont atteint une précision de 66.7 pour cent et 58.4 pour cent. L'échantillon conserve donc le modèle 4B Q4_K_M comme choix par défaut privilégiant la qualité. Ces mesures incluent la latence réseau et ne constituent pas des garanties de service.
Évaluez la configuration complète du modèle et de l'infrastructure par rapport à vos propres décisions. Utilisez le CPU pour les charges de travail en arrière-plan, hors ligne ou à faible débit qui ne sont pas sensibles à la latence et peuvent tolérer des délais de réponse de plusieurs secondes. Utilisez le GPU pour les décisions interactives, les longues invites ou les charges de travail avec des objectifs stricts de latence de queue. Gardez les descriptions d'états et d'options concises, regroupez les décisions partageant le même état dans une seule requête, et dimensionnez les instances du point de terminaison pour la concurrence. La notation à état partagé réutilise le préfixe d'invite commun, tandis que l'adaptateur renvoie des erreurs HTTP 503 des réponses au lieu d'autoriser une file d'attente illimitée autour de son contexte stateful llama.cpp.
Prérequis
Vous avez besoin de :
- Un compte AWS et un compartiment S3 dans votre Région AWS de déploiement.
- Python 3.10 ou version ultérieure, Git et l'AWS Command Line Interface (AWS CLI).
- Un rôle de service CodeBuild dédié à un usage spécifique pour l'extension facultative SemIf.
- Un rôle AWS Identity and Access Management (IAM) que SageMaker AI peut assumer.
- Des autorisations pour SageMaker AI, Amazon ECR, Amazon S3, CodeBuild, les actions IAM pass-role et Amazon CloudWatch Logs.
- Un quota pour un point de terminaison SageMaker en temps réel compatible avec un processeur x86 ou un GPU NVIDIA.
L'exemple de génération de texte utilise le DLC CPU et une instance CPU fixe. L'extension SemIf conserve le CPU comme option par défaut pour les charges de travail non sensibles à la latence et propose une image CUDA facultative avec des pools d'instances ordonnés. Consultez les tarifs de SageMaker AI avant de créer un point de terminaison.
Déployer un modèle de décision et l'étendre avec SemIf
Utilisez la procédure suivante pour déployer le point de terminaison standard de génération de texte, puis créer l'extension facultative SemIf pour des décisions structurées sur CPU ou GPU.
- Clonez l’exemple de code et installez ses dépendances.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - Définissez les valeurs de déploiement pour votre compte.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - Empaquetez le modèle GGUF épinglé et son tokenizer avec CodeBuild.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
Attendez que l’identifiant de build renvoyé atteigne
SUCCEEDED. La build enregistre les révisions de la source et les sommes de contrôle dansmodel-manifest.jsonet s’arrête si la somme de contrôle du GGUF diffère de la valeur validée. - Déployez le modèle GGUF avec l’AWS DLC pour llama.cpp.
Résolvez une image
server-sagemaker-cpu-v1épinglée par digest depuis la documentation de l’AWS DLC pour llama.cpp, puis créez le modèle SageMaker AI, la configuration du endpoint et le endpoint :export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"Sélectionnez une image
server-sagemaker-cpu-v1ouserver-sagemaker-cuda-v1plutôt que l’image EC2 correspondante. Les images SageMaker AI implémentent le contrat de conteneur/pinget/invocationset mappent les charges utiles d’invocation sur des complétions de chat.Cette procédure fournit le modèle GGUF via l’artefact du modèle SageMaker AI dans Amazon S3. Comme alternative, vous pouvez configurer
SM_LLAMA_CPP_HF_REPOetSM_LLAMA_CPP_HF_FILEpour télécharger un fichier GGUF depuis Hugging Face lorsque le endpoint dispose d’une sortie réseau.Vous n’avez pas besoin d’un Dockerfile ni d’un référentiel ECR pour ce chemin. Attendez que le endpoint passe à l’état
InService, puis envoyez une requête de chat compatible OpenAI :python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - Construisez l’image enfant SemIf facultative et résolvez son digest immuable.
Pour le CPU :
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
Pour le GPU, construisez plutôt l’image enfant CUDA :
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
Une fois la build réussie, construisez l’URI d’image immuable :
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
Le script de déploiement rejette les tags d’image mutables.
- Déployez le endpoint SemIf.
La configuration CPU utilise un type d’instance fixe :
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
Attendez que le nom de endpoint renvoyé passe à l’état
InService. Ce chemin définitn_gpu_layers=0. L’adaptateur sérialise l’inférence autour d’un seul contexte llama.cpp à état ; effectuez donc la mise à l’échelle avec des instances de endpoint après avoir mesuré votre charge de travail plutôt que de supposer une inférence parallèle au sein d’un même conteneur.Pour l’image GPU, fournissez des pools d’instances ordonnés et demandez un déchargement complet du modèle :
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
Les pools d'instances sont des solutions de repli ordonnées pour le placement, et non un équilibrage de charge d'inférence. SageMaker sélectionne un type disponible pour la variante. La création du point de terminaison peut prendre plus de temps pendant que SageMaker AI parcourt le pool. Vérifiez les journaux de démarrage pour le GPU sélectionné et un message confirmant que toutes les couches du modèle ont été déchargées.
- Invoquez le point de terminaison SemIf avec l'exemple de décision.
La requête déclare des identifiants stables pour chaque option autorisée :
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"La réponse préserve l'ordre des options et inclut les probabilités conditionnelles, les logits bruts, les métadonnées de jetons et de prompt, ainsi que l'identité du modèle épinglé :
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
Appliquez des seuils et des solutions de repli au niveau applicatif. N'utilisez pas une décision de modèle comme substitut à l'autorisation.
Nettoyage
Supprimez le point de terminaison SageMaker AI, la configuration du point de terminaison et le modèle :
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
Le script supprime uniquement les ressources SageMaker AI explicitement nommées. Supprimez les projets CodeBuild, le dépôt ECR, les objets de modèle et de source dans Amazon S3, les journaux et les rôles IAM à usage spécifique lorsque vous n'en avez plus besoin.
Conclusion
Le DLC AWS pour llama.cpp vous offre une base gérée pour servir des modèles de décision sur SageMaker AI sur des instances CPU et GPU. Il peut charger des modèles GGUF à partir des artefacts de modèle SageMaker AI ou d'un dépôt Hugging Face configuré, puis servir des complétions de chat compatibles OpenAI via InvokeEndpoint sans nécessiter de conteneur personnalisé. Lorsque votre application a besoin d'un accès direct aux logits et aux opérations sur l'état du modèle, vous pouvez étendre le DLC avec un adaptateur SemIf. Choisissez le CPU pour les charges de travail insensibles à la latence, et le GPU lorsque le préremplissage du prompt et la latence de queue affectent l'expérience de l'application.
Consultez le code d'exemple, documentation du DLC AWS pour llama.cppet le contrat de conteneur d'inférence personnalisée de SageMaker AI pour adapter le déploiement à votre charge de travail.