
Cet article montre comment déployer un grand modèle de langage (LLM) sur deux nœuds GPU sur Amazon Elastic Kubernetes Service (Amazon EKS) avec le multi-nœud Conteneurs Deep Learning Ray LLM« . Il utilise des nœuds de préremplissage (prefill) et de décodage (decode) séparés derrière un point de terminaison compatible OpenAI. Ce type de configuration multi-nœuds est courant pour le parallélisme de tenseurs, de pipeline et de données, ainsi que pour les charges de travail d'inférence avec disjonction prefill/decode. Dans une » article précédent, nous avons présenté le Ray Serve DLC et l'a utilisé pour déployer un petit modèle derrière un point de terminaison HTTP sur un seul nœud GPU. Vous disposiez d'un point d'inférence fonctionnel, et le conteneur maintient la compatibilité de la pile GPU, y compris les bibliothèques CUDA, de sorte que vous n'aviez pas besoin d'écrire de code passe-partout.
Ray est un framework de calcul distribué, les déploiements Ray Serve peuvent donc s'étendre sur plusieurs nœuds. Les clients utilisent Ray Serve multi-nœuds pour plusieurs raisons. Certains souhaitent exécuter des modèles de fondation ou à poids ouverts trop volumineux pour un seul GPU. D'autres ont besoin d'un débit supérieur à ce qu'une seule réplique peut offrir. D'autres encore veulent séparer les deux phases de l'inférence pour améliorer les performances. Dans chaque cas, les clients doivent construire eux-mêmes la chaîne de dépendances : choisir des bibliothèques compatibles pour la pile GPU et déboguer les problèmes lorsqu'un composant se désaligne. Il s'agit d'un travail sans valeur ajoutée qui détourne du temps et des efforts de la mise en service des modèles.
Conteneurs AWS Deep Learning Les DLC (Deep Learning Containers) résolvent depuis longtemps ce type de problème pour les charges de travail d'entraînement et d'inférence. Les DLC sont des images Docker préconstruites et optimisées pour les performances qui regroupent un framework, ses dépendances et la pile GPU dans une combinaison testée et corrigée que vous pouvez récupérer et utiliser immédiatement. Avec le lancement du Ray LLM DLC pour les déploiements multi-nœuds, cette même approche s'étend désormais à l'inférence multi-nœuds. Vous obtenez un conteneur conçu spécifiquement pour servir des modèles derrière un point de terminaison HTTP, maintenu et testé par AWS, avec la pile d'inférence complète déjà assemblée.
Cet article décrit la mise en œuvre d'une inférence désagrégée multi-nœuds à l'aide du multi-node Ray LLM DLC : déploiement d'un seul grand modèle de langage sur deux nœuds équipés de GPU sur Amazon EKS collaborant derrière un point de terminaison unique. Pendant que l'un des nœuds GPU gère la phase de préremplissage, l'autre nœud GPU gère la phase de décodage. La séparation des phases empêche les longues requêtes gourmandes en calcul de bloquer la génération de tokens pour les requêtes déjà en cours. Cette approche convient bien à des charges de travail telles que la génération augmentée par récupération (RAG), la synthèse de documents et les applications agentiques. Nous utilisons le DLC Ray LLM multi-nœuds, qui est livré Ray Serve LLM, NVIDIA Inference Transfer Library (NIXL), et le Elastic Fabric Adapter (EFA) stack, et expose une API compatible OpenAI sans code applicatif. Le code complet est disponible dans le dépôt accompagnant.
Pourquoi la désagrégation préremplissage/décodage (PD)
L'inférence des LLM comporte deux phases distinctes. Préremplissage traite l'ensemble du prompt d'entrée en parallèle et construit le cache clé-valeur (KV). Décoder genère ensuite la réponse un jeton à la fois, en lisant et en étendant ce cache. Le préremplissage (Prefill) est limité par la puissance de calcul, et le décodage (Decode) est limité par la bande passante mémoire. Lorsque les deux phases partagent un même GPU, elles se disputent les mêmes ressources, et le travail de préremplissage, par à-coups et gourmand en calcul, interfère avec le travail de décodage, régulier et sensible à la latence. Séparer la phase de préremplissage de la phase de décodage permet de sélectionner le matériel et les propriétés de service pour chaque phase, améliorant ainsi les performances globales à grande échelle.
La désagrégation PD place les deux phases sur des nœuds distincts, de sorte que chaque phase s'exécute sans interférer avec l'autre et peut être mise à l'échelle de manière indépendante. Le compromis est que le KV cache construit pendant le prefill doit être transféré au nœud de décodage, et ce transfert doit être suffisamment rapide pour ne pas annuler le bénéfice. C'est précisément pourquoi l'interconnexion entre les nœuds est importante.
Ce que le DLC LLM de Ray fournit
Les AWS DLC sont des images Docker préconstruites et optimisées pour les performances qui regroupent un framework, ses dépendances et la pile GPU dans une combinaison testée et corrigée que vous pouvez récupérer et utiliser immédiatement. Tous les composants sont validés ensemble avant chaque version, ce qui évite toute dérive de version entre le runtime CUDA, le framework et la couche de service. Les correctifs de sécurité sont appliqués au moment de la construction.
Le Ray LLM DLC étend cela au service LLM distribué. Il intègre vLLM comme moteur d'inférence, le HTTP de Ray Serve comme couche de service, NIXL pour le transfert du KV-cache entre nœuds, et la pile EFA (libfabric et aws-ofi-nccl) pour la communication haut débit entre nœuds. Parce que Bibliothèque LLM de Ray Serve comprend un générateur d'applications intégré : toute l'application de service est un bloc YAML. Il n'y a pas de classe de gestionnaire, pas d'archiveur de modèle et pas d'image personnalisée à construire. Un simple utilitaire, build_pd_openai_app, prend une configuration de prefill et une configuration de decode et câble le transfert du KV-cache entre elles derrière un seul point de terminaison compatible OpenAI.
Architecture
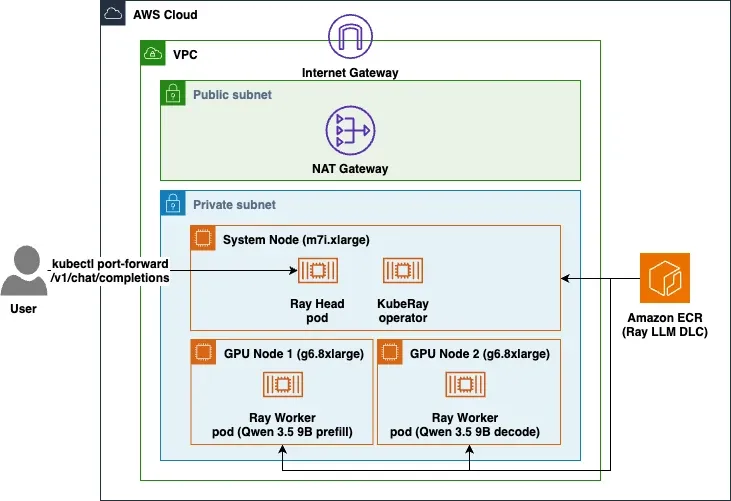
Le diagramme suivant montre comment le déploiement est organisé sur Amazon EKS. Une requête utilisateur atteint la tête Ray sur le nœud système CPU, et les deux nœuds de travail GPU exécutent les phases de prefill et de decode du modèle.
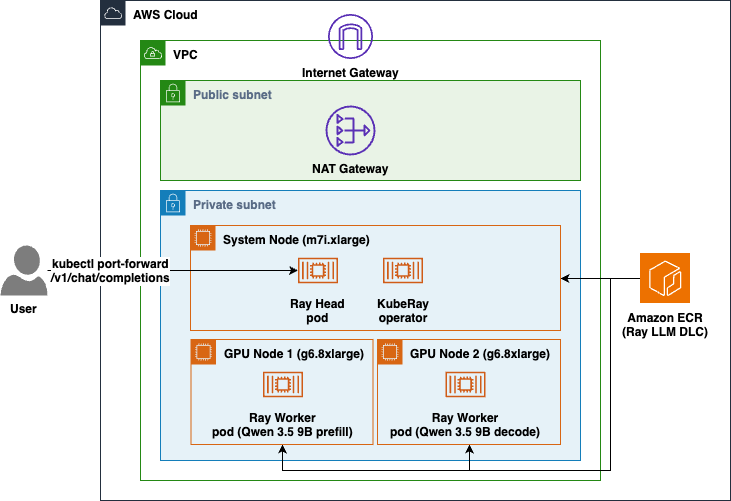
Figure 1 : Architecture d'inférence multi-nœuds sur Amazon EKS, avec la tête Ray sur un nœud système CPU et les phases de préfill et de décodage sur deux nœuds de travail GPU
Le déploiement est un cluster EKS à l'intérieur d'un cloud privé virtuel (VPC). Les nœuds s'exécutent dans des sous-réseaux privés avec un accès sortant via une passerelle NAT. Un CPU nœud système (m7i.xlarge) héberge les charges de travail système, le KubeRay opérateur, et le pod head Ray, qui est CPU uniquement. Deux GPU nœuds de travail (g6.8xlarge) exécutent les workers Ray : l'un sert la phase de préfill, et l'autre la phase de decode. Les deux nœuds récupèrent le Ray LLM DLC depuis Amazon Elastic Container Registry (Amazon ECR).
KubeRay surveille le RayService que vous appliquez et configure automatiquement la connexion head-to-worker. Ray Serve place les déploiements de prefill et de decode sur les deux GPU workers. Le KV cache transite du worker de prefill vers le worker de decode via NIXL, en utilisant EFA à travers le backend libfabric de NIXL. Le groupe de nœuds GPU est épinglé à une seule Availability Zone (AZ) car EFA ne peut pas traverser les AZ.
Prérequis
Pour suivre ce billet, vous avez besoin de :
- Un compte AWS avec la facturation activée.
- Un quota de service suffisant pour exécuter deux instances g6.8xlarge (au moins 64 vCPU) dans la Région cible.
- AWS Interface de ligne de commande (AWS CLI) avec des identifiants configurés.
- kubectl CLI pour communiquer avec le plan de contrôle d'un cluster Kubernetes.
- eksctl CLI pour créer et gérer des clusters sur EKS.
- helm (gestionnaire de paquets pour Kubernetes) pour installer l'opérateur KubeRay.
- utilitaire envsubst (partie de GNU gettext) pour générer le manifeste.
Vérifiez que vos identifiants AWS sont actifs avec la commande suivante :
aws sts get-caller-identityUtilisez l'application pré-construite pour servir l'inférence
L'application est le bloc serveConfigV2 dans manifest/rayservice.yaml. Elle utilise build_pd_openai_app, qui prend un prefill_config et un decode_config et connecte le transfert de KV-cache entre eux :
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
Quelques paramètres portent l'essentiel du réglage. max_model_len: 4096 dimensionne le contexte pour correspondre au KV cache mesuré sur le GPU. dtype: bfloat16 et gpu_memory_utilization: 0.90 définissent la précision et la quantité de VRAM que vLLM peut revendiquer. enforce_eager: true désactive la capture des graphes CUDA pour réduire la mémoire GPU crête (selon le modèle et l'entrée). Le paramètre kv_transfer_config est ce qui fait fonctionner la désagrégation : les deux phases utilisent NixlConnector avec kv_role: kv_both et un engine_id distinct (prefill sur l'un, decode sur l'autre). Le paramètre critique est kv_connector_extra_config: { backends: ["LIBFABRIC"] }. Sans cette ligne, NIXL utilise UCX par défaut, qui fonctionne à la vitesse TCP même sur EFA.
Le reste du manifeste, en rayClusterConfig, décrit les pods. Le pod head est CPU uniquement (num-gpus: "0") et épinglé au groupe de nœuds système. Chaque pod worker demande un GPU et une interface EFA (nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1") et cible les nœuds GPU via nodeSelector: { role: gpu-worker }. Il s'exécute privileged: true car NIXL enregistre la VRAM CUDA auprès de la carte réseau EFA. La capacité IPC_LOCK seule ne suffit pas. Les workers définissent FI_PROVIDER=efa, lisent VLLM_HOST_IP depuis l'adresse IP du pod et montent un volume de mémoire partagée. Les limites de mémoire se situent bien au-dessus du checkpoint d'environ 18 GiB afin que le cache de pages de l'OS puisse le contenir. Pour le chargement du modèle Qwen3.5-9B sur un g6.8xlarge avec la configuration de cache précédente, le chargement des poids du modèle passe d'environ 145 secondes à environ 2 secondes au redémarrage.
Déployer sur Amazon EKS
Tous les scripts partagent un seul fichier de configuration, scripts/env.sh. Le script contient les valeurs par défaut pour CLUSTER_NAME, REGION, K8S_VERSION, et NAMESPACE. Les autres valeurs par défaut couvrent les groupes de nœuds système et GPU, la version de KubeRay et le modèle. Remplacez toute variable en l'exportant avant d'exécuter un script.
Depuis la racine du projet, définissez un répertoire de base, puis chargez les variables :
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
Étape 1 : Créer le cluster EKS
./deploy_cluster.shCe script provisionne le cluster EKS (VPC, fournisseur OIDC, add-ons principaux) et un groupe de nœuds système CPU qui exécute les workloads système, l'opérateur KubeRay et le head Ray. Les nœuds s'exécutent dans des sous-réseaux privés avec une sortie via une NAT Gateway, et les sous-réseaux du cluster sont placés dans les zones de disponibilité qui offrent le type d'instance GPU. Le script est idempotent et prend 15–20 minutes lors d'une première exécution.
Étape 2 : Ajouter les nœuds de travail GPU
./deploy_node_group.shCeci crée le groupe de nœuds GPU : deux instances g6.8xlarge avec EFA activé, attachées à une seule zone de disponibilité et étiquetées role=gpu-worker pour que les workers Ray les ciblent. L'activation d'EFA installe également le plugin de périphérique EFA, qui annonce vpc.amazonaws.com/efa sur chaque nœud. Cette étape prend environ 5 à 20 minutes, généralement plus longtemps lors d'une première exécution.
Étape 3 : Installer l'opérateur KubeRay
./install_kuberay.shCeci installe l'opérateur KubeRay à l'aide de Helm, attaché au groupe de nœuds système pour garder les nœuds GPU disponibles pour l'inférence. KubeRay surveille le RayService que vous appliquerez ensuite et configure automatiquement la jointure head-to-worker. Cette étape prend environ 1 à 2 minutes.
Étape 4 : Déployer le RayService
./deploy_ray_service.shCeci génère manifest/rayservice.yaml avec votre image, votre modèle et vos variables de nommage à l'aide d'envsubst, puis l'applique. KubeRay crée le pod head et deux pods worker, et Ray Serve LLM lance les déploiements de prefill et de decode. Le script attend que le head soit Ready, que les deux workers soient Running, et enfin que l'application Serve signale RUNNING. Comme chaque nœud charge le modèle, attendez-vous à ce que cette étape prenne plusieurs minutes.
Vérifiez l'état à tout moment, y compris sur quel nœud chaque pod s'est retrouvé et la capacité GPU disponible :
./deploy_ray_service.sh statusInvoquer le modèle
Une fois l'application Serve saine, KubeRay crée un Service <rayservice-name>-serve-svc stable. Redirigez le port vers celui-ci :
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000Comme le DLC expose une API compatible OpenAI, vous pouvez lister les modèles et envoyer une requête de chat-completion standard sans schéma personnalisé :
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
Vérifier qu'EFA est utilisé
NIXL revient à un transport à vitesse TCP s'il ne peut pas utiliser libfabric, et le fait sans lever d'erreur, il vaut donc la peine de confirmer le backend qu'il a choisi. Faites un grep dans les logs des workers :
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh affiche déjà le nombre de vpc.amazonaws.com/efa par nœud lorsqu'il crée le groupe. Pour obtenir un chiffre de bande passante inter-nœuds, le DLC est livré avec un benchmark préconstruit de la NVIDIA Collective Communications Library (NCCL) à /usr/local/bin/all_reduce_perf.
Nettoyage
Pour éviter des frais continus, supprimez les ressources dans l'ordre inverse :
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
Conclusion et prochaines étapes
Vous avez servi un seul modèle sur deux nœuds GPU avec désagrégation prefill/decode, et l'application entière était un bloc YAML, sans code de gestionnaire, sans archiveur de modèle et sans pile GPU et EFA assemblée à la main. Le DLC Ray LLM multi-nœuds a fourni la pile d'inférence testée, KubeRay a orchestré le cluster Ray, et NIXL sur EFA a transporté le KV cache entre les nœuds. Votre travail était de le configurer, pas de le construire.
Les modèles courants pour l'inférence multi-nœuds incluent le parallélisme de tenseurs et de pipeline (sharding d'un modèle trop grand pour une seule instance), le parallélisme de données (réplication d'un modèle pour le débit) et la désagrégation prefill/decode (séparation des deux phases d'inférence sur différents nœuds).
À partir de là, vous pouvez augmenter le nombre de réplicas de decode pour plus de débit, passer à des modèles plus grands avec du parallélisme de tenseurs ou de pipeline sur des instances GPU plus grandes, ou ajouter des bibliothèques supplémentaires à la même base testée pour les modèles qui en ont besoin. Pour le code complet, la liste actuelle des tags d'image et les mécanismes sous-jacents, consultez le dépôt accompagnant, la page des images disponibles du DLC Ray LLM, la documentation prefill/decode de Ray Serve LLM, et la documentation EFA.