IT之家 Informations du 13 octobre : la chaîne YouTube Jun Yamog a publié hier (12 octobre) une vidéo testant l'installation de 4 Tesla V100 sur une carte porteuse NVLink ; dans le benchmark Qwen3.8-Flash-Next,la vitesse de traitement des longs prompts est 230 % supérieure à celle du M5 Ultra et 40 % supérieure à celle de 2 DGX Spark.
D'après les informations publiques consultées par IT之家, la Tesla V100 est un GPU pour centres de données lancé par NVIDIA en 2017, basé sur l'architecture Volta, couramment utilisé pour l'entraînement et l'inférence AI. Sa version 32GB est équipée de mémoire HBM2, dont une bande passante de 900GB/s permettant une lecture rapide des paramètres des grands modèles et des données.
NVLink est la technologie d'interconnexion GPU haut débit de NVIDIA, utilisée pour transférer directement des données entre plusieurs GPU. Par rapport à la communication via PCIe, NVLink réduit les goulots d'étranglement d'interconnexion et est couramment utilisé dans les serveurs multi-GPU et les clusters de calcul AI.
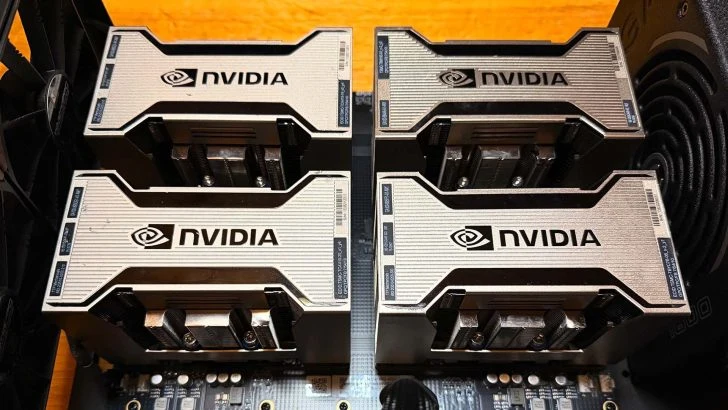
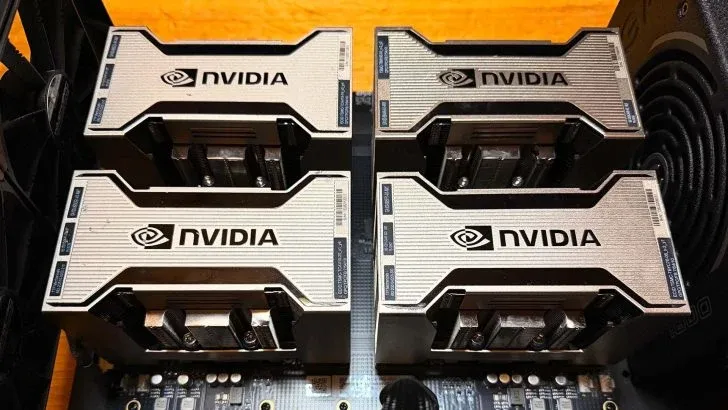
Cette carte porteuse NVLink offre une bande passante de 300GB/s et est équipée de 6 connexions NVLink 2.0. Pour accueillir 4 GPU indépendants, le testeur a modifié des dissipateurs NVIDIA A100 afin qu'ils puissent évacuer les environ 300W de consommation de chaque V100, et les a reliés à la carte via des interfaces PCIe x8.
Le vidéaste a testé avec le modèle Qwen3.8-Flash-Next quantifié en 4-bit, en comparaison avec 2 DGX Spark équipés de 128GB de mémoire unifiée LPDDR5X, ainsi qu'un Mac Studio doté de la puce M5 Ultra.
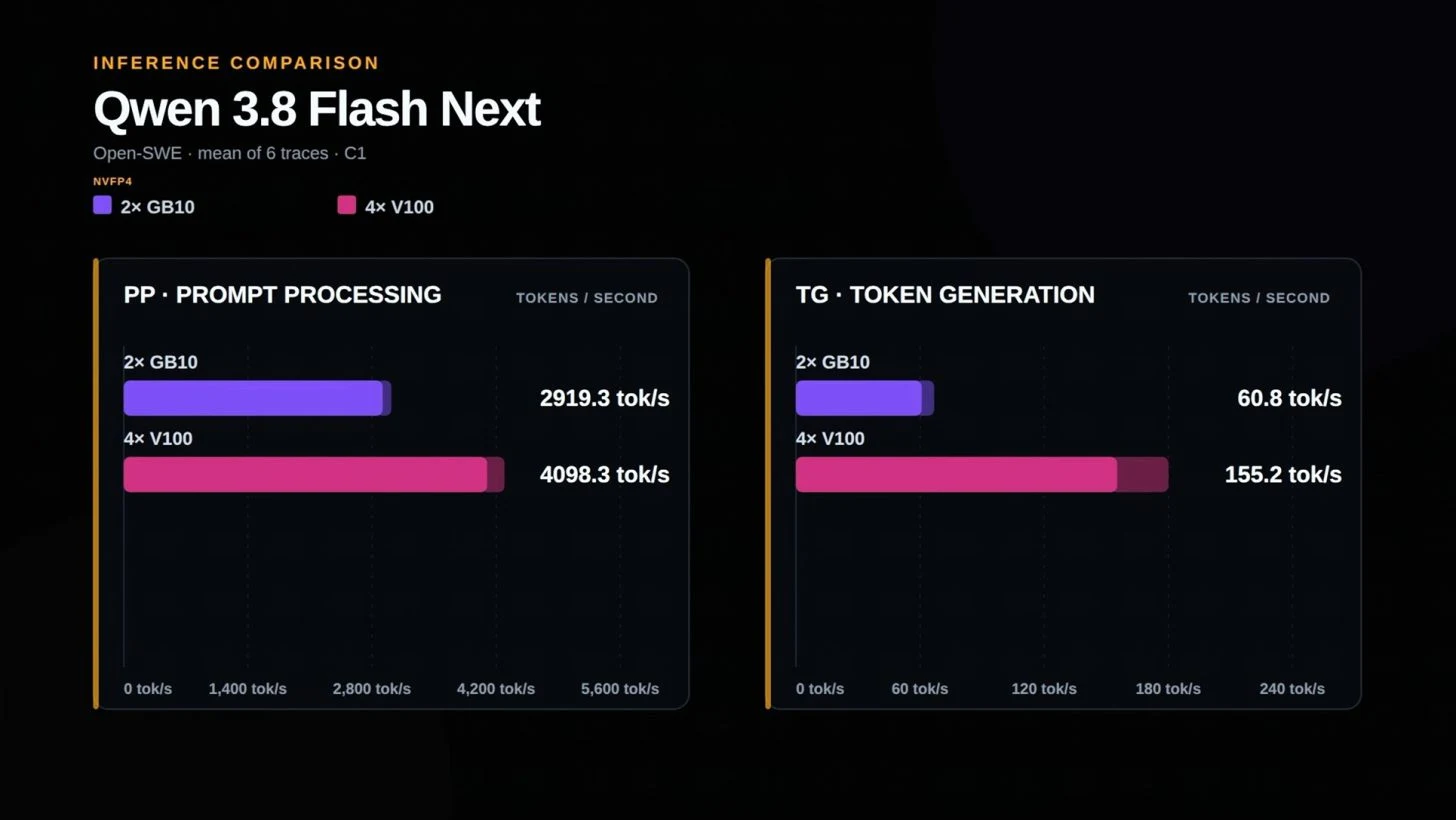
Dans le test de traitement des longs prompts, les 4 V100 sont 40 % plus rapides que le cluster DGX Spark et 230 % plus rapides que le M5 Ultra. Le testeur souligne que l'écart considérable avec Apple Silicon pourrait en partie provenir d'une optimisation logicielle insuffisante.
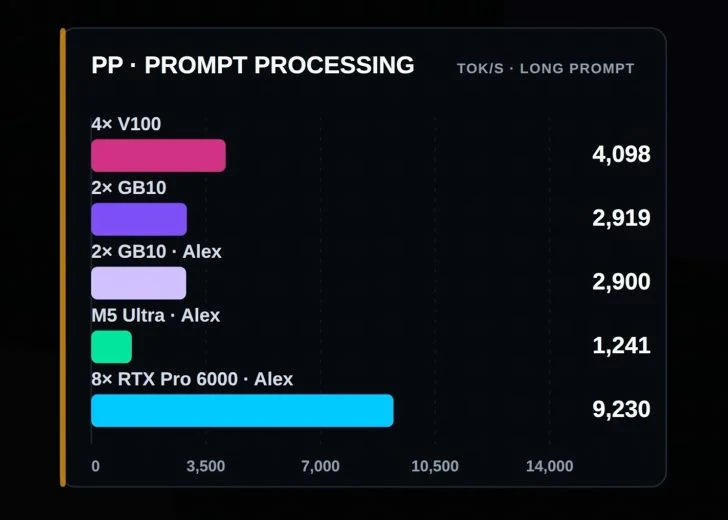
Dans le test de traitement des courts prompts, le cluster V100 conserve un avantage de vitesse de 40 % sur le DGX Spark et est 163 % plus rapide que le M5 Ultra. Ce résultat montre que les GPU de centres de données anciens conservent une capacité de débit élevée dans certaines charges d'inférence.
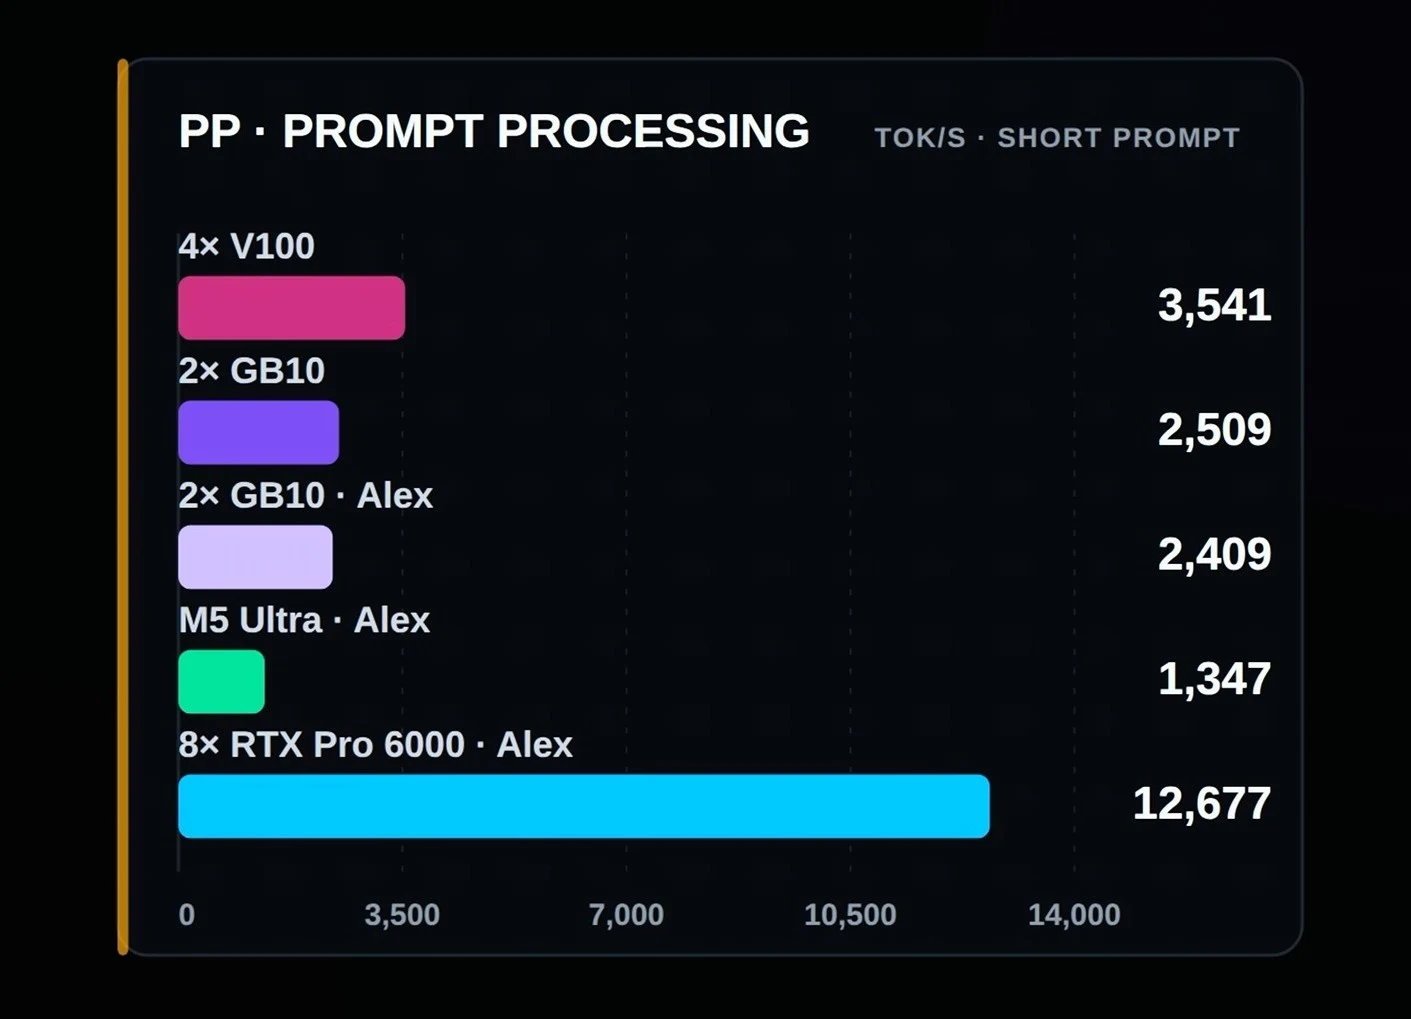
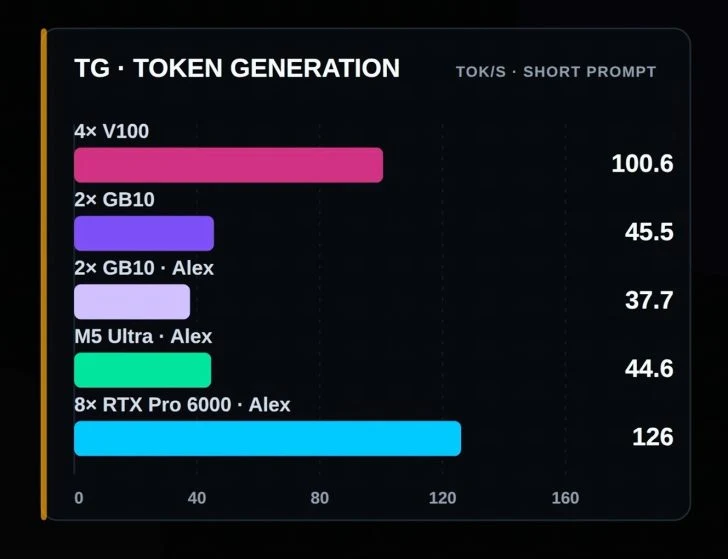
Dans le test de génération de tokens sur courts prompts, les 4 V100 atteignent 100.6 tok/s, soit 121 % de plus que 2 DGX Spark ; le M5 Ultra obtient 44.5 tok/s.