
Points clés
- Créer des agents longue durée exige une gestion constante du contexte, et prendre ces décisions avec un LLM de pointe est lent et coûteux. Les modèles de décodage contraint (CDM) de ScaleDown les rendent plus rapides et moins chers.
langchain-scaledownfacilite l'utilisation des modèles ScaleDown dans votre agent, et est livré avec des middlewares pour la résumé, la compression des résultats d'outils et l'extraction.- ScaleDown est désormais pris en charge dans la LangSmith LLM Gateway, de sorte que ses appels sont tracés et comptent dans vos dépenses et limites de débit.
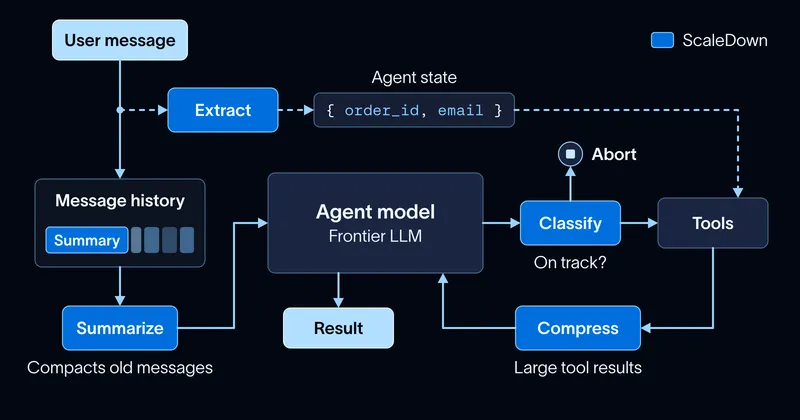
Créer des agents longue durée relève de l'art de la gestion du contexte : décider quelles informations vont dans la fenêtre de contexte, et quand. Cela signifie résumer l'ancien historique, compacter les grands résultats d'outils et extraire les bonnes données de longues entrées. Chacune de ces étapes est une décision. Historiquement, nous les prenions avec des LLM, ce qui est lent et coûteux au volume qu'un agent longue durée nécessite.
Pour rendre ces décisions plus rapides et moins chères, nous disposons désormais d'une langchain-scaledown intégration et d'un support dans la LangSmith LLM Gateway pour les modèles de décodage contraint (CDM) de ScaleDown. Là où un LLM à usage général écrit n'importe quelle chaîne un token à la fois, un CDM est entraîné pour une seule tâche et ne renvoie que les réponses que cette tâche permet, comme une étiquette de votre liste ou des fragments de l'entrée. Cela le rend beaucoup plus petit, rapide et économique : ScaleDown rapporte que ses modèles sont 200x plus rapides et 467x moins chers que les modèles de pointe sur ces tâches étroites.
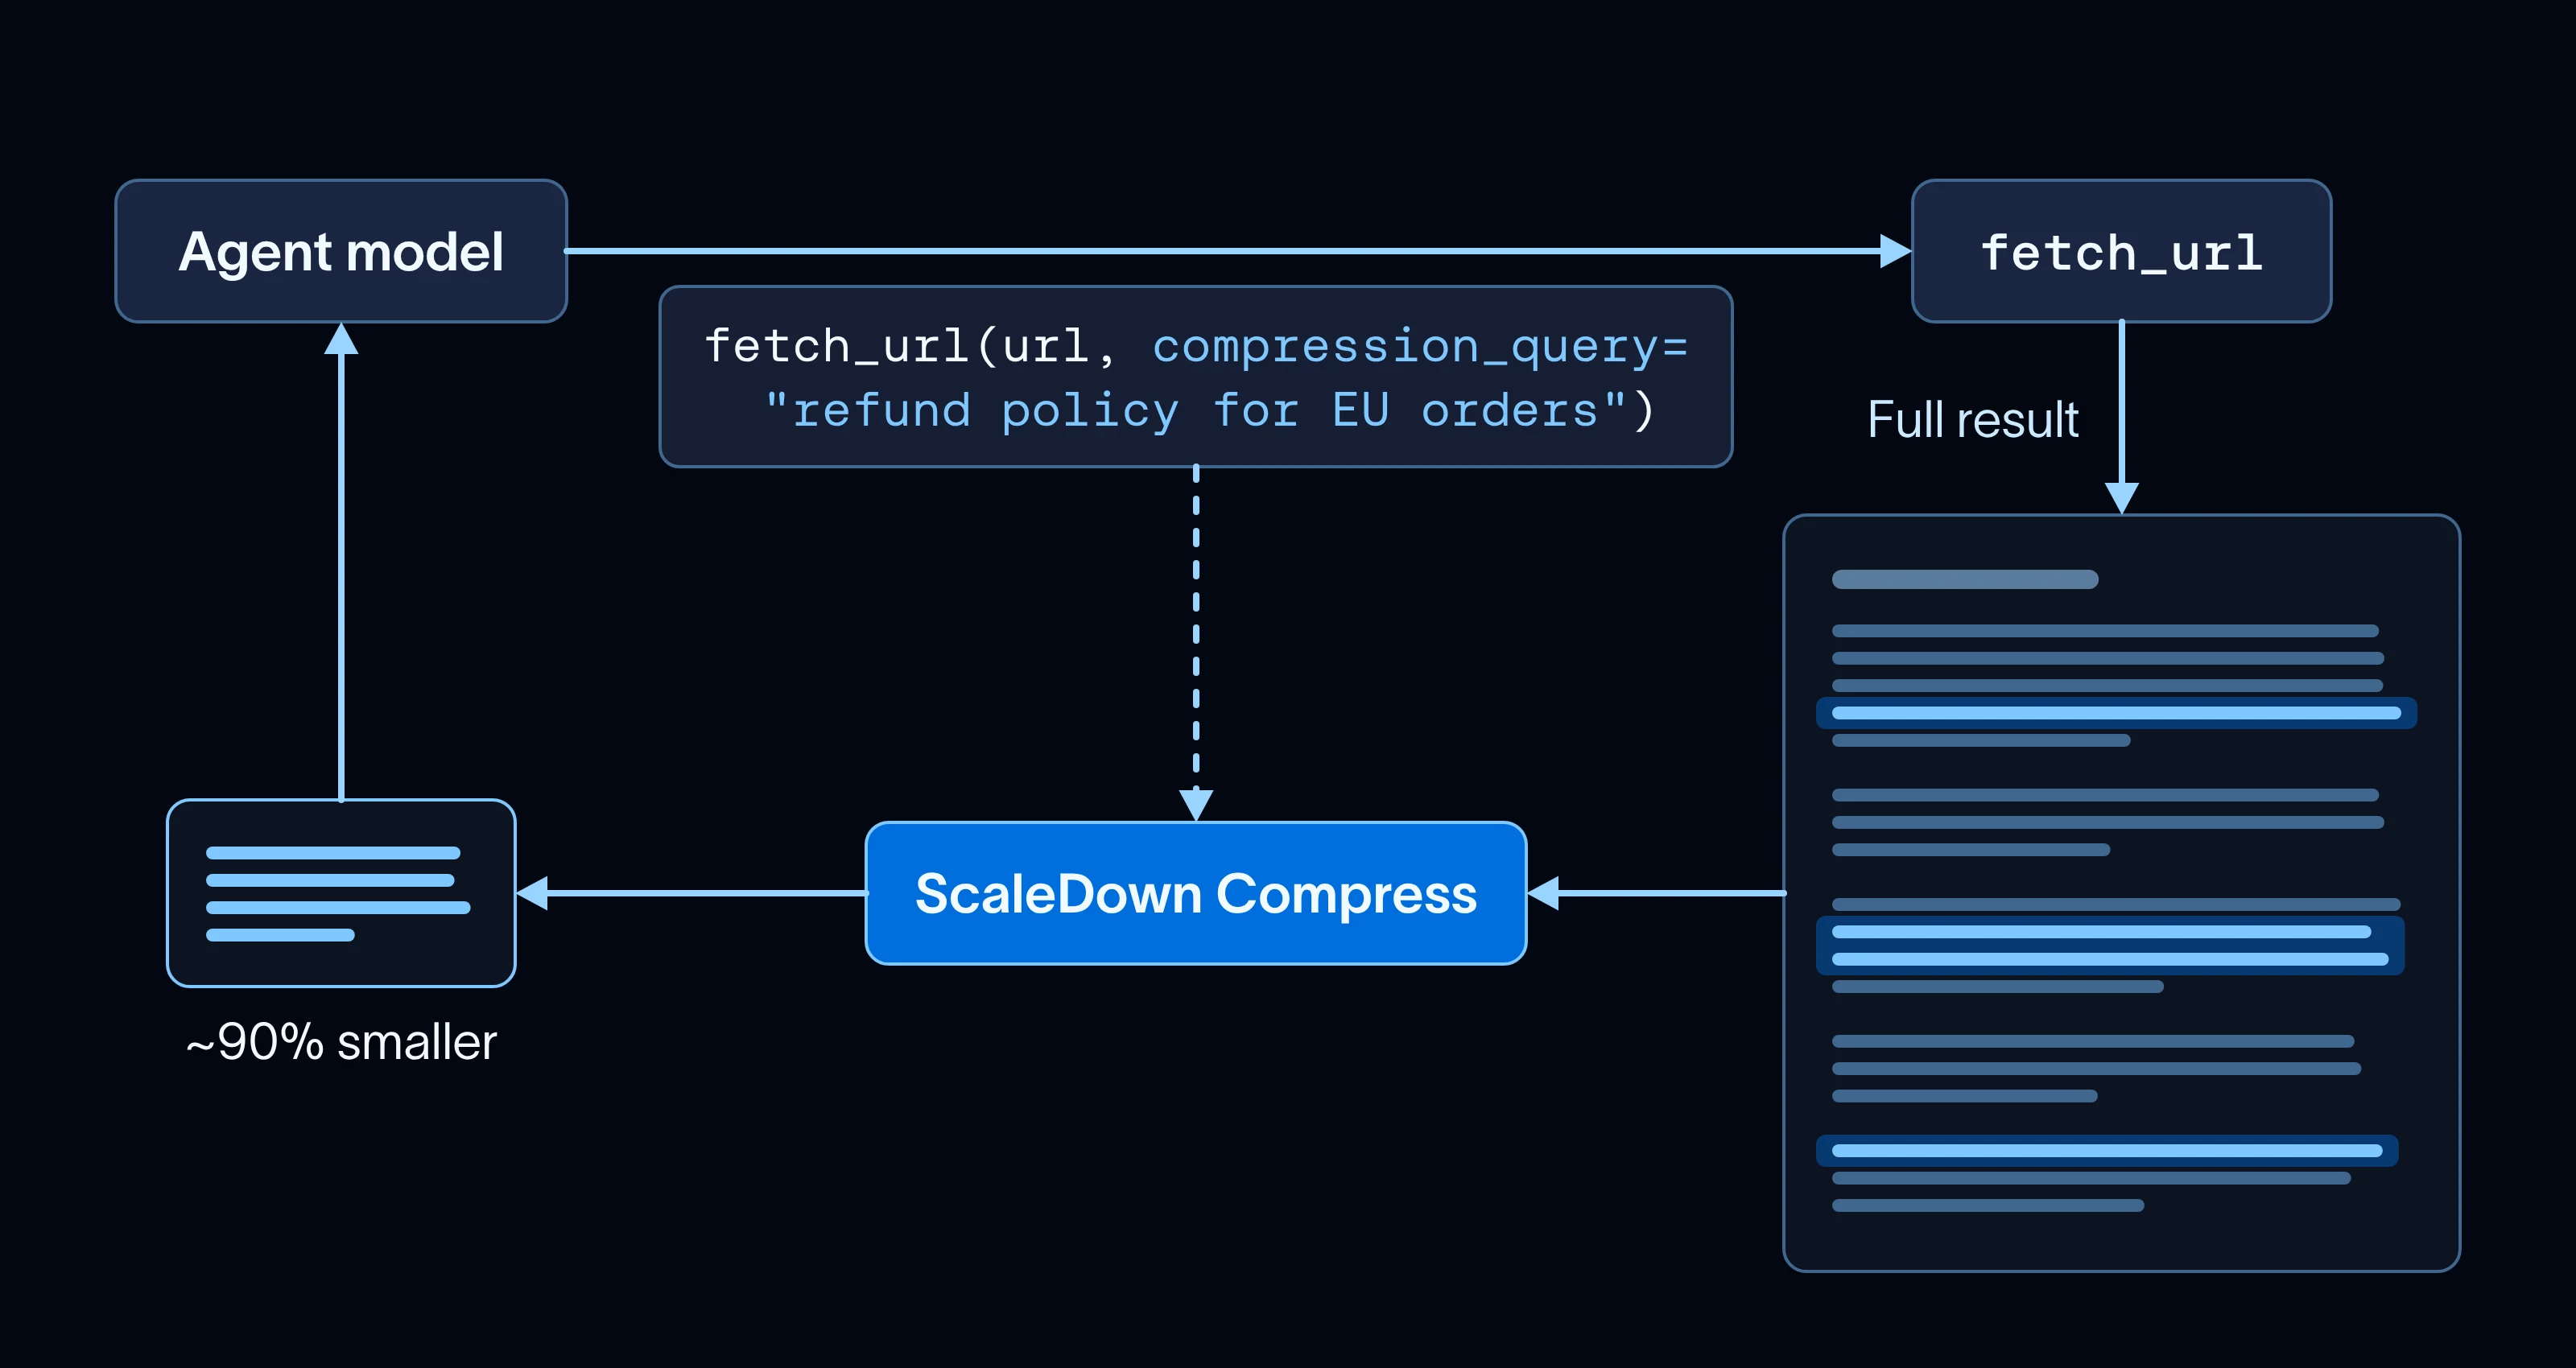
L'intégration est livrée avec trois middlewares pour LangChain et Deep Agents: l'un résume l'ancien historique, l'autre compresse les grands résultats d'outils, et le troisième extrait des données structurées de la conversation. Dans cet article, nous expliquons ce que sont les modèles de ScaleDown et comment les utiliser pour réduire le contexte de votre agent.
Quels modèles ScaleDown propose-t-il ?
ScaleDown propose quatre modèles, chacun entraîné pour une seule tâche, si bien que chacun peut être bien plus efficace qu'un LLM à usage général :
- Summarize rédige un court résumé d'un long texte.
- Compress réduit un bloc de contexte aux parties pertinentes pour une question.
- Extract extrait les champs que vous décrivez d'un texte, chacun avec un score de confiance et sa position dans la source.
- Classify évalue un texte par rapport à des étiquettes que vous définissez et renvoie une probabilité pour chacune. Vous pouvez décider de renvoyer ou non une raison en langage naturel expliquant pourquoi la classification a été effectuée.
Chaque modèle accepte jusqu'à 1M tokens en entrée, de sorte qu'un contrat complet, une longue page de politique ou une heure d'historique d'agent tient en un seul appel sans découpage. Ils sont aussi multimodaux: Extract, Summarize et Classify acceptent directement des images et des PDF numérisés en plus du texte non structuré, de sorte qu'une capture d'écran ou une facture numérisée fonctionne comme entrée.
D'après les benchmarks de ScaleDown lui-même, mesurés par rapport à la moyenne de GPT-5.5, GPT-5.4 Mini et GPT-5.4 Nano sur des jeux de données publics, Summarize est 41x moins cher et 2.7x plus rapide, et Compress est 138x moins cher et 1.8x plus rapide, tout en obtenant un score de précision supérieur pour les deux.
Si vous avez utilisé un modèle de décision comme Jev, ScaleDown Classify vous sera familier : les deux renvoient une réponse typée avec une probabilité. Jev accepte uniquement du texte, jusqu'à 32K tokens d'état par question. Classify accepte jusqu'à 1M tokens, images comprises, et ajoute une raison d'une phrase à chaque décision. Lorsqu'un agent achemine un ticket ou arrête une exécution en fonction d'une étiquette, la raison vous indique pourquoi, ce qui facilite le débogage de l'agent.
Résumé de l'historique des messages
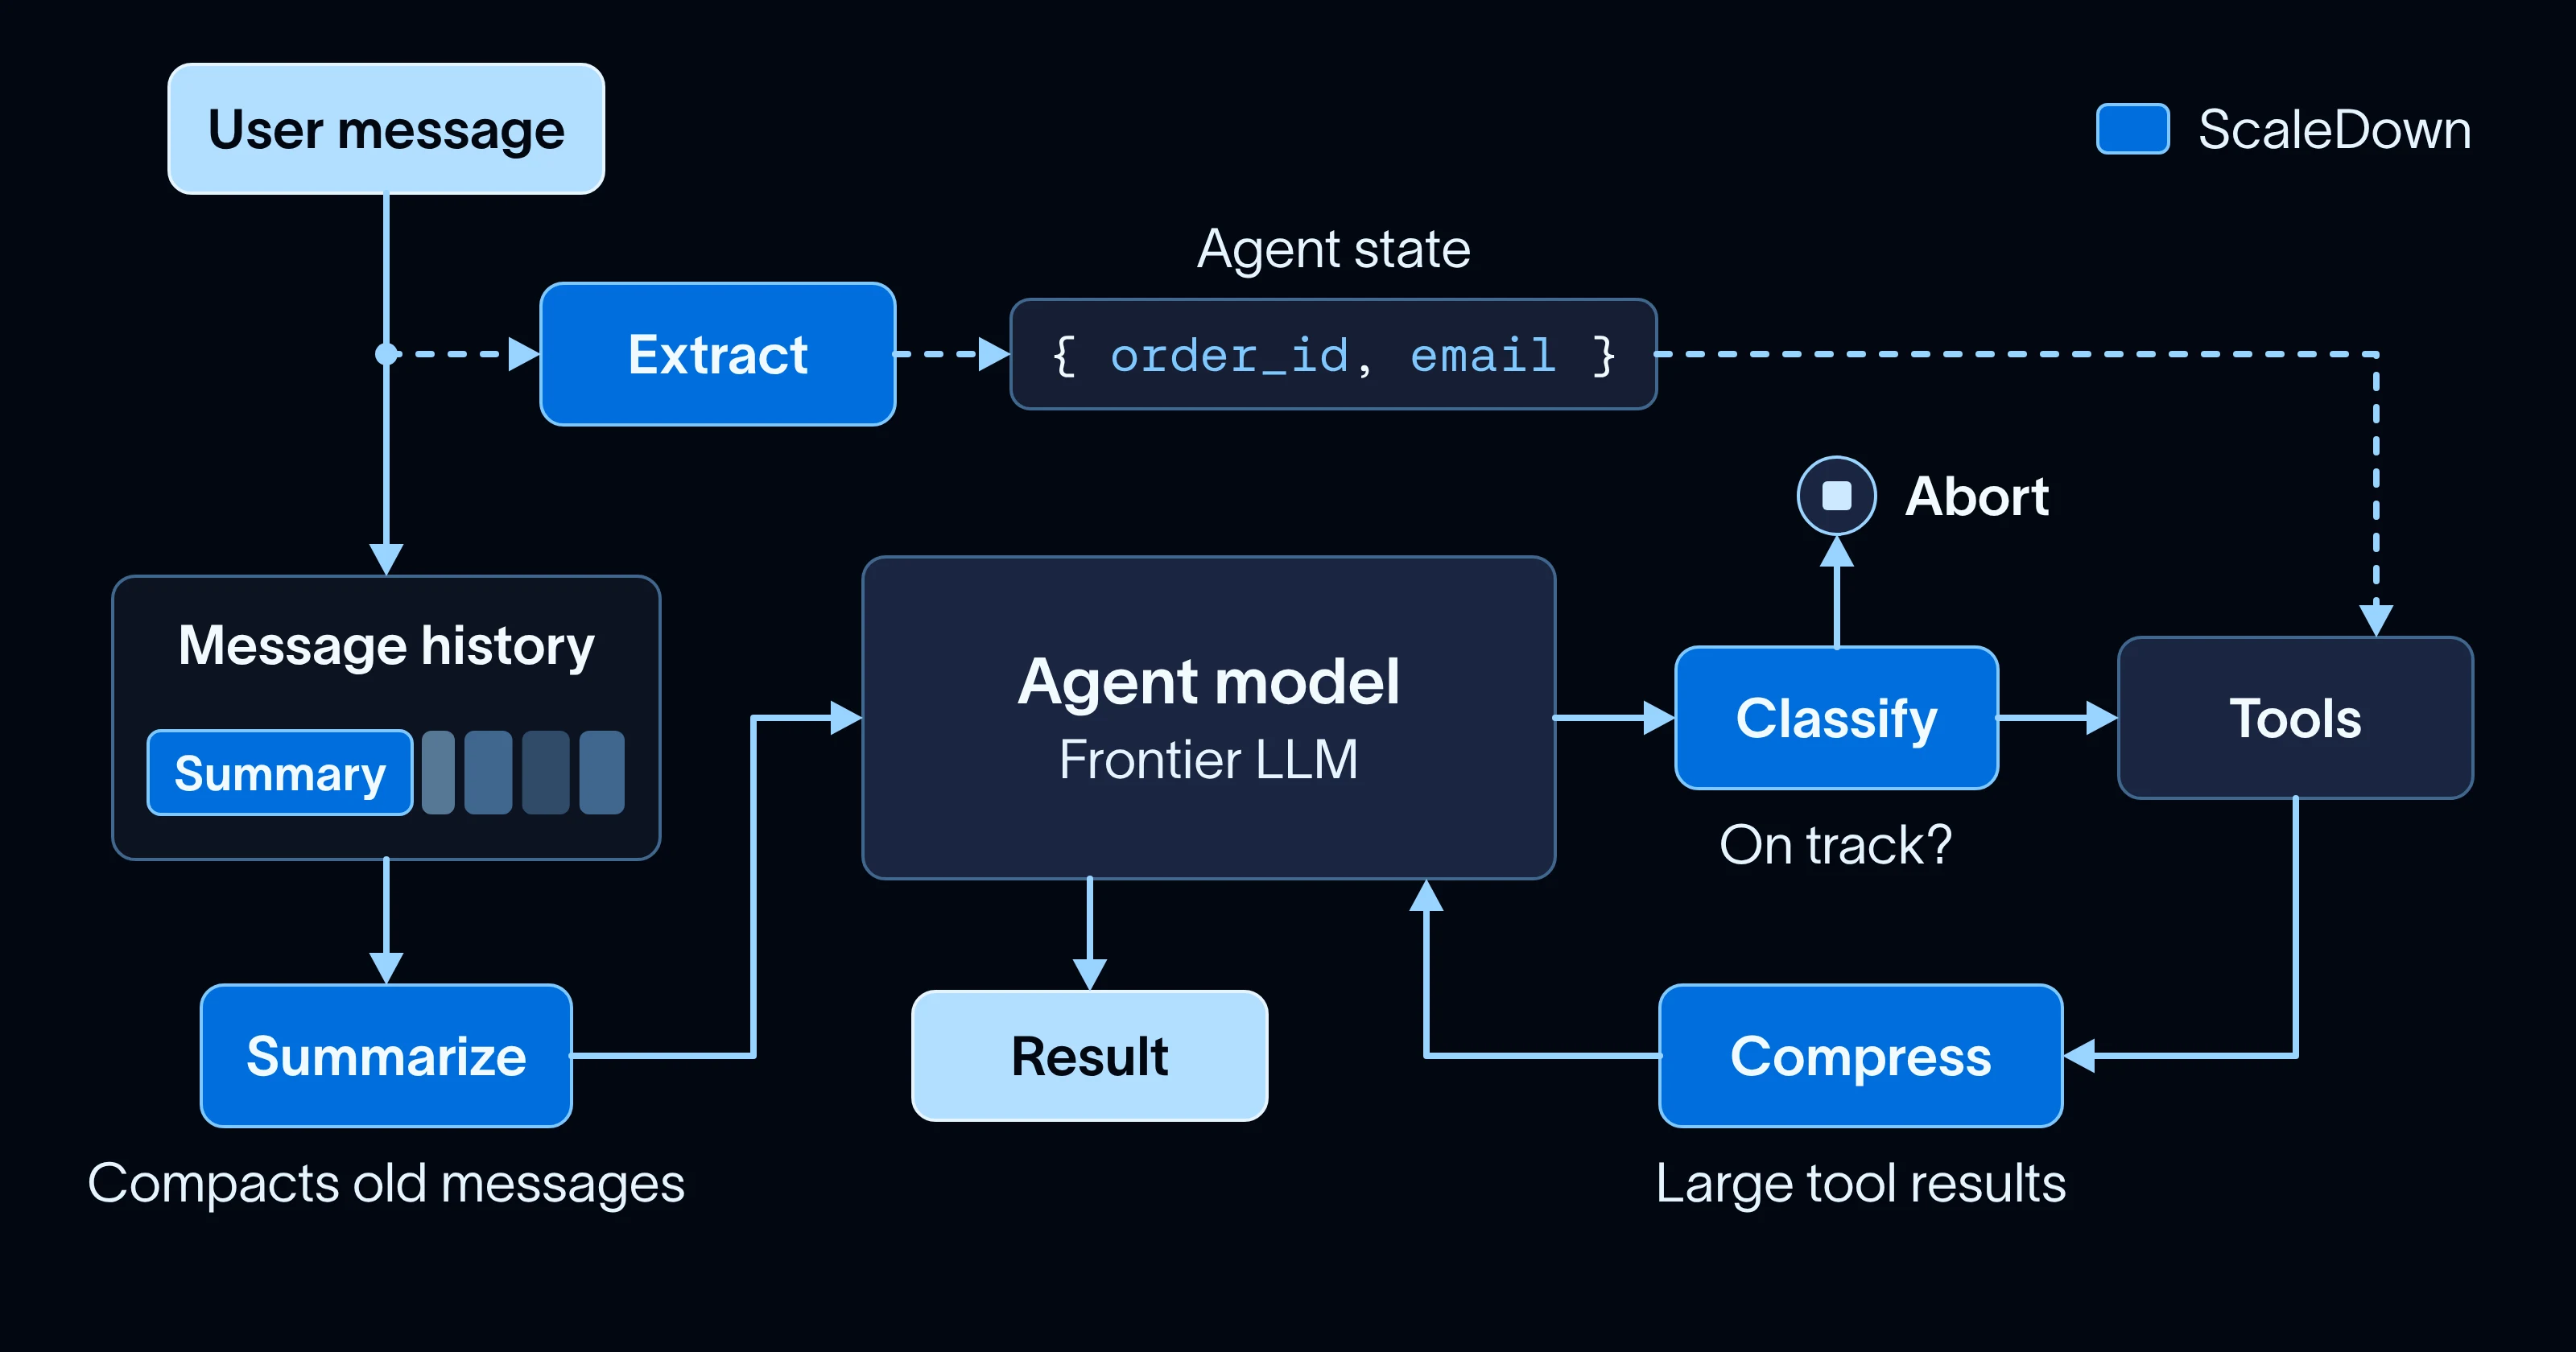
Les agents de longue durée ont besoin de résumé car leur historique finit par dépasser la fenêtre de contexte. Un agent de codage qui travaille depuis une heure a des dizaines de lectures de fichiers et de sorties d'outils dans son historique, dont la plupart ne sont plus nécessaires mot à mot. Les résumer avec un autre appel de modèle de pointe ajoute du coût et de la latence chaque fois que l'historique se remplit.
ScaledownSummarizationMiddleware remplace le middleware de summarizationintégré de Deep Agents. Il prend les mêmes options trigger et keep pour décider quand résumer et quels messages récents conserver, et ScaleDown rédige le résumé :
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-sol",
    tools=[run_tests],
    middleware=[
        ScaledownSummarizationMiddleware(
            "openai:gpt-6-sol",  # the agent’s model, used for its context window
            trigger=("fraction", 0.8),
            keep=("fraction", 0.1),
        ),
    ],
)
L'agent conserve son propre modèle pour la planification et l'écriture de code. Seul le résumé passe à ScaleDown, qui renvoie par défaut les mêmes sections que le prompt de résumé de LangChain (intent, summary, artifacts et next steps). Si un appel ScaleDown échoue, le middleware laisse l'historique tel quel et l'agent continue de fonctionner. Le même middleware fonctionne avec le create_agent.
Compression des résultats d'outils
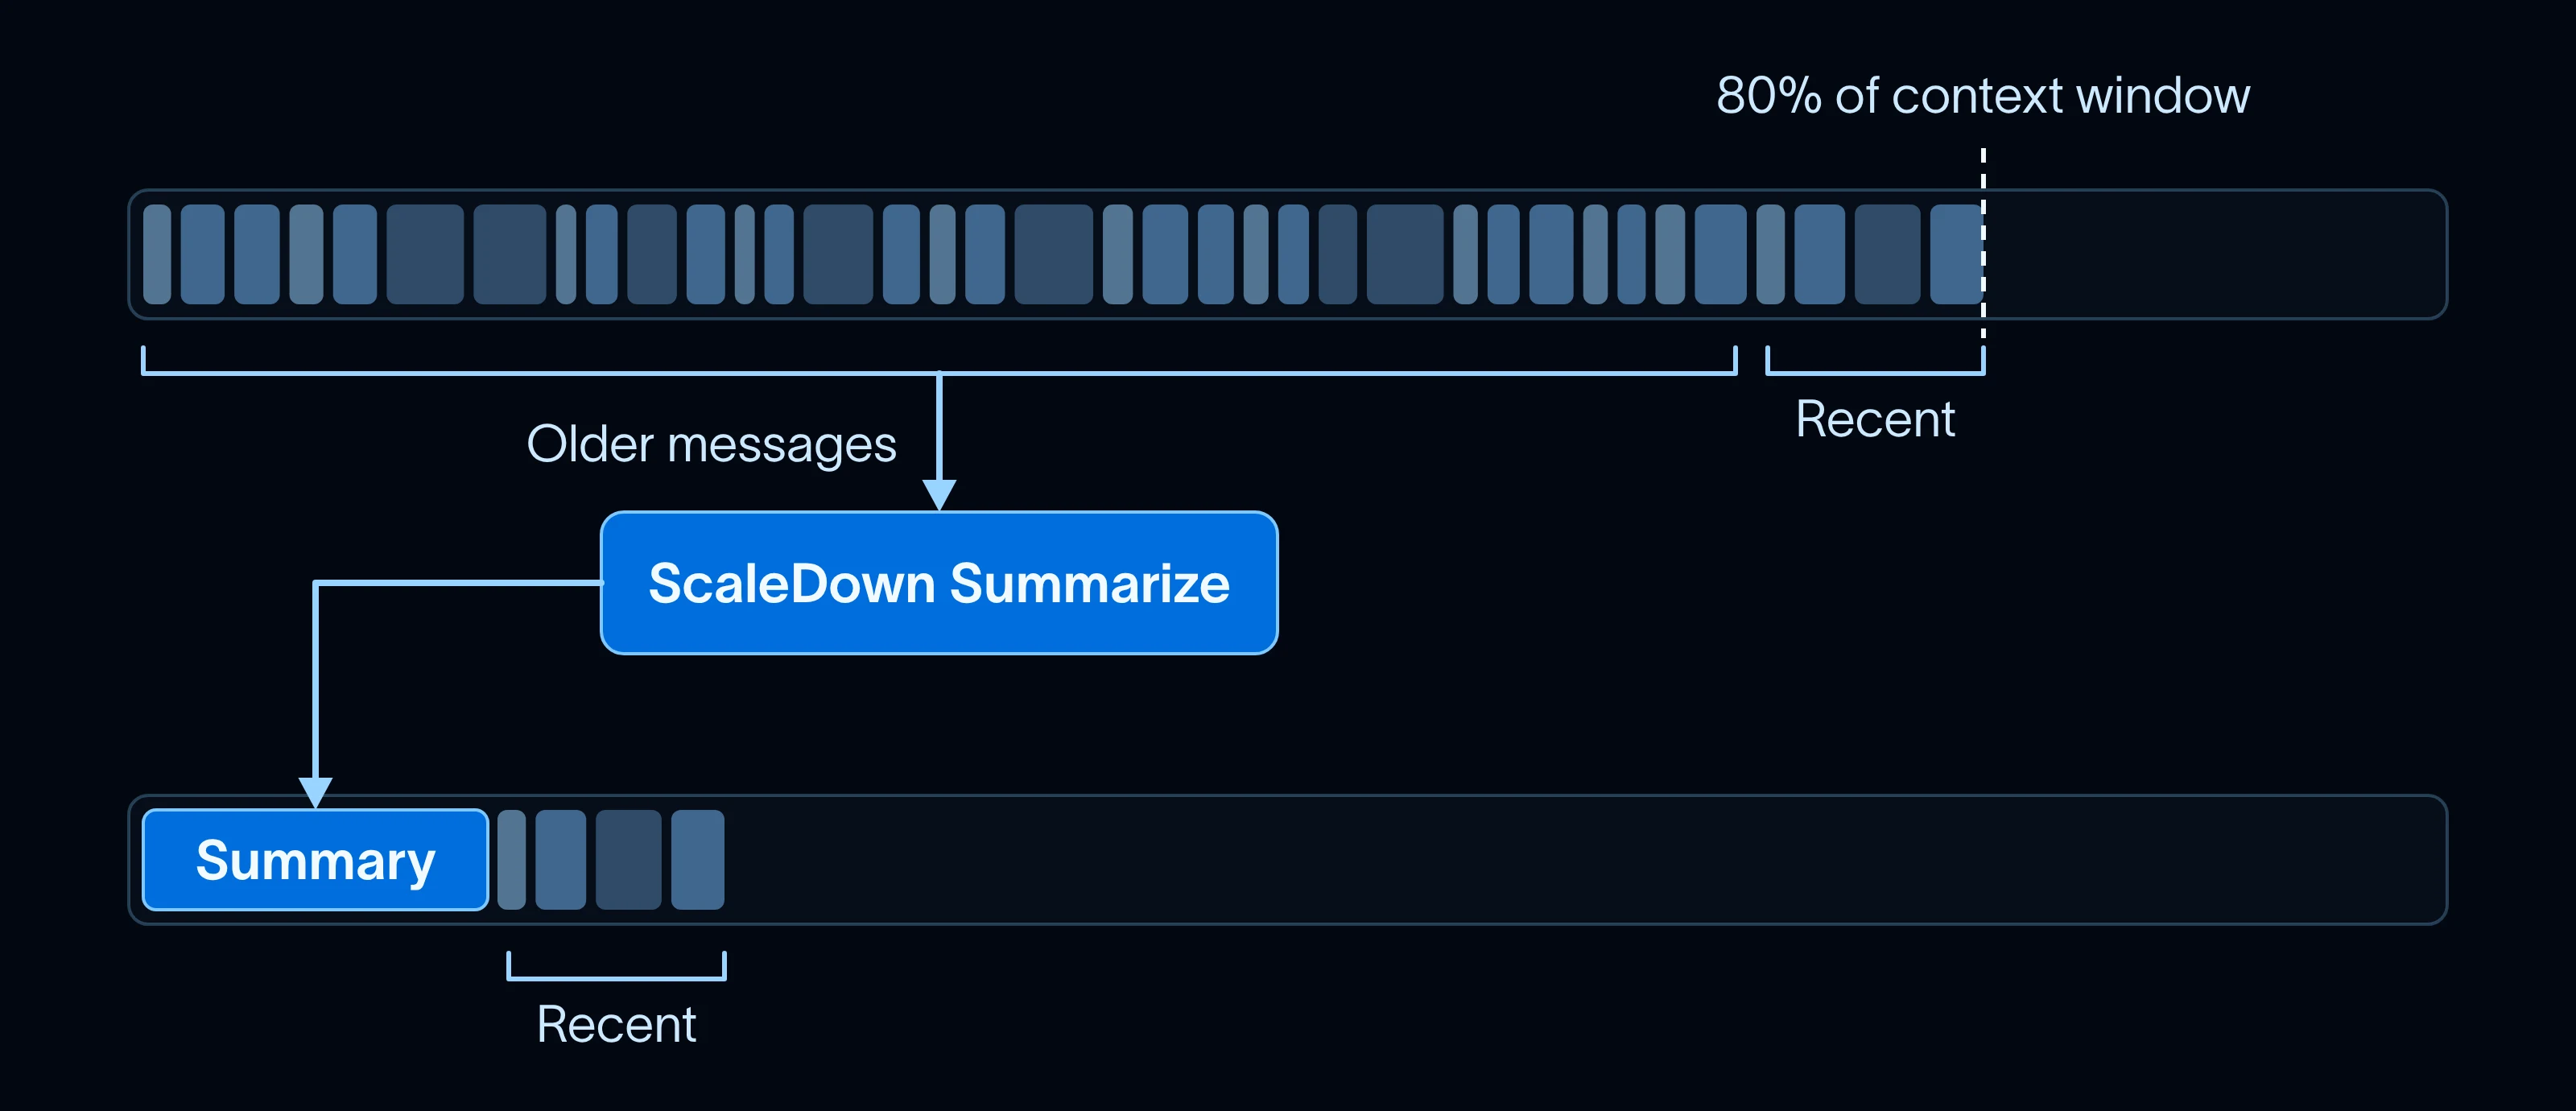
Les agents de longue durée appellent beaucoup d'outils, et chaque grand résultat reste dans le contexte pour le reste de l'exécution. Une page web récupérée peut atteindre des dizaines de milliers de caractères alors que l'agent n'a besoin que d'un paragraphe. Chaque étape suivante paie à nouveau ces tokens, et l'agent a de plus en plus de mal à rester concentré sur sa tâche à mesure que son context se remplit.
ScaledownToolCompressionMiddleware ajoute un paramètre optionnel compression_query à vos outils. Lorsque le modèle n'a besoin que d'une partie d'un résultat, il renseigne compression_query lors de l'appel d'outil, par exemple "refund policy for EU orders". Le middleware le retire avant l'exécution de l'outil, puis ScaleDown compresse la sortie aux parties pertinentes avant que le modèle ne la voie :
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownToolCompressionMiddleware

agent = create_deep_agent(
    model="openai:gpt-6-luna",
    tools=[search_docs, fetch_url],
    middleware=[ScaledownToolCompressionMiddleware(tools=["fetch_url"])],
)
Vos outils ne changent pas, donc cela fonctionne avec n'importe quel outil, y compris les outils MCP. Dans cette trace, ScaleDown a réduit une longue page de documentation de près de 90 % avant que le modèle ne la voie. Le résultat compressé commence par une note comme celle-ci, afin que le modèle puisse rappeler l'outil sans compression_query s'il a besoin de la page complète :
[Compressed by ScaleDown for "refund policy for EU orders":
 18,402 -> 3,110 chars.
 Call this tool again without `compression_query` for the full output.]
Extraction de données structurées
Les agents extraient constamment des valeurs spécifiques de ce qu'ils lisent, comme un ID, une date ou un champ nécessaire au prochain appel d'outil. Cette extraction se situe à l'intérieur de la boucle de l'agent, elle doit donc être assez rapide pour ne pas ajouter de latence à chaque tour, et assez exacte pour qu'un outil puisse utiliser la valeur telle quelle.
Par exemple, avant qu'un agent de support puisse créer un ticket, il a besoin du numéro de commande, du message d'erreur et de l'adresse e-mail du client. Le modèle principal pourrait les renseigner comme arguments d'outil, mais il peut plutôt paraphraser un code d'erreur ou mal taper une adresse e-mail au lieu de la copier exactement.
ScaledownExtractionMiddleware confie cette étape à ScaleDown. Vous décrivez chaque champ en langage naturel, et Extract copie la valeur depuis le texte. Un champ peut aussi être un ensemble de libellés, auxquels ScaleDown répond avec Classify, afin que le ticket puisse être routé par type de problème. Avant le premier appel de modèle d'une exécution, le middleware envoie les messages de l'utilisateur à Extract et enregistre les champs dans l'état de l'agent sous scaledown_extraction, où vos outils peuvent les lire :
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware

ticket = ScaledownExtractionMiddleware(
    entities={
        "order_id": "Order number the customer mentions",
        "error_message": "Exact error message or code the customer saw",
        "customer_email": "Customer's email address",
        "issue_type": {
            "labels": [
                {"name": "billing", "rubric": "Is this about a charge, refund, or payment?"},
                {"name": "technical", "rubric": "Is this about a bug or something not working?"},
                {"name": "account", "rubric": "Is this about login, password, or account settings?"},
            ]
        },
    },
    context_chars=0,  # skip evidence snippets to keep state small
)


@tool
def file_ticket(runtime: ToolRuntime) -> str:
    """File a support ticket with the details gathered so far."""
    fields = runtime.state.get("scaledown_extraction", {}).get("fields", {})
    return crm.create_ticket(**fields)  # your ticketing system


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[file_ticket], middleware=[ticket])
Extract ne lit que les messages de l'utilisateur, jamais les réponses de l'agent, de sorte que chaque valeur est quelque chose que le client a réellement dit. Avec un checkpointer, l'extraction est relancée à chaque tour, de sorte que le dossier se complète à mesure que le client ajoute des détails. Pour « La commande A-1042 a échoué avec ERR_PAYMENT_DECLINED. J'ai déjà essayé une autre carte. », les champs reviennent comme suit :
{
    "order_id": "A-1042",
    "error_message": "ERR_PAYMENT_DECLINED",
    "customer_email": None,  # not mentioned yet
    "issue_type": "billing",
}
Classification dérive
Un agent décide de sa prochaine étape en fonction de son état actuel, comme savoir si la tâche est terminée ou si le dernier appel d'outil a fonctionné. La classification de cet état se produit à chaque tour, elle doit donc être peu coûteuse et rapide.
Un état qui mérite d'être détecté dans les agents à exécution longue est la dérive : boucler sur le même appel d'outil qui échoue, ou rester bloqué dans un cycle improductif. Il n'existe pas de middleware préconstruit pour cela, mais vous pouvez appeler n'importe quel modèle ScaleDown depuis votre propre middleware personnalisé. Voici un disjoncteur qui s'exécute après chaque appel de modèle, envoie l'historique à ScaleDown Classify et arrête l'exécution lorsqu'elle déraille :
import os

import requests
from deepagents import create_deep_agent
from langchain.agents.middleware import after_model
from langchain_core.messages import AIMessage, get_buffer_string

LABELS = [
    {"name": "progressing", "rubric": "Is the agent making new progress on the user's task?"},
    {"name": "looping", "rubric": "Is the agent repeating the same steps without new results?"},
    {"name": "drifting", "rubric": "Is the agent working on something the user did not ask for?"},
]


@after_model(can_jump_to=["end"])
def circuit_breaker(state, runtime):
    result = requests.post(
        "https://api.scaledown.xyz/classify",
        headers={"x-api-key": os.environ["SCALEDOWN_API_KEY"]},
        json={"text": get_buffer_string(state["messages"]), "labels": LABELS},
    ).json()

    label = result["top_label"]
    if label != "progressing" and result["scores"][label] > 0.8:
        return {"jump_to": "end", "messages": [AIMessage(f"Stopped: {result['reasoning']}")]}
    return None


agent = create_deep_agent(model="openai:gpt-6-sol", tools=[run_tests], middleware=[circuit_breaker])
Classify renvoie une probabilité pour chaque étiquette, ce qui vous permet de choisir le niveau de confiance requis avant que le disjoncteur ne se déclenche. Sa raison en une ligne apparaît dans le message final, ce qui vous permet de comprendre pourquoi l'exécution s'est arrêtée. Une version plus douce ne met pas fin à l'exécution au premier déclenchement : elle ajoute la raison à la conversation pour inciter à changer de cap, et ne s'arrête que si l'agent dérive à nouveau.
Ces quatre sections montrent quelques endroits où les modèles de ScaleDown s'intègrent, et la liste n'est pas exhaustive. Vous pouvez les combiner librement, par exemple en exécutant extract / summarize sur de longs résultats d'outils, ou en utilisant la classification pour le routage des modèles à l'exécution. Consultez ScaleDown Cookbooks pour découvrir d'autres façons d'utiliser les modèles CDM sur différents types de données.
ScaleDown dans la LangSmith LLM Gateway
La passerelle LLM LangSmith vous permet d'appeler des modèles chez différents fournisseurs avec une seule clé API LangSmith, trace chaque appel et applique vos dépenses et limites de débit. ScaleDown est désormais l'un de ses fournisseurs d'accès direct aux modèles, au /scaledown chemin.
Un administrateur ajoute votre clé ScaleDown aux secrets de fournisseur de l'espace de travail en tant que SCALEDOWN_API_KEY une seule fois. Ensuite, pointez langchain-scaledown vers la passerelle et authentifiez-vous avec votre clé LangSmith :
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
Chaque appel ScaleDown apparaît alors comme une trace LangSmith et compte dans les mêmes limites que vos autres appels de modèle.
Quand ne pas utiliser ScaleDown
Gardez un LLM à usage général pour la génération ouverte, comme écrire du code, rédiger des réponses et planifier. Cela suit l'approche « pas cher par défaut, frontal en exception » de nos articles Jev: utilisez un grand LLM à usage général pour les parties difficiles, et des modèles spécialisés pour les étapes à fort volume qui l'entourent.
ScaleDown est assez rapide et peu coûteux pour être exécuté à chaque tour, de sorte que votre agent peut prendre les décisions structurées dont dépend la gestion du contexte sans ralentir la boucle principale ni payer les prix frontaux pour cela. Dans un agent de longue durée, ces décisions se produisent à presque chaque tour, donc les économies s'accumulent rapidement.
Commencer
Installez l'intégration et définissez votre clé API ScaleDown:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
Les nouveaux comptes ScaleDown reçoivent 50M de jetons gratuits. Les Documentation d'intégration de ScaleDown couvrent les options de configuration de chaque middleware. Essayez-le langchain-scaledown et dites-nous ce que vous en pensez sur le forum LangChain, Xou GitHub.