
Points clés
- L’IA Search permet désormais aux utilisateurs de trouver des conversations en se basant sur une compréhension sémantique des traces, comme « l’utilisateur a-t-il été frustré ? » ou « des données personnelles sensibles ont-elles été divulguées ? »
- Décrivez un comportement en langage simple, et un modèle de décision rapide lit les traces et renvoie ceux où cela s’est produit.
- LangSmith utilise les trajectoires pour normaliser les traces, réduire la surcharge de contexte et fournir rapidement les résultats des requêtes.
Agent traces sont volumineux, multimodaux et riches en informations. Ils capturent des détails clés tels que les entrées utilisateur, la manière dont les agents réagissent et les erreurs logiques. Cela rend les traces particulièrement précieuses pour comprendre le comportement de l’utilisateur et améliorer les performances des agents, mais les plateformes de données traditionnelles ne sont pas conçues pour gérer de tels en-têtes volumineux et non structurés.
Pour que les données de trace soient utiles, les équipes ont besoin d’une infrastructure capable de soutenir l’ensemble du cycle de vie : ingérer et stocker des volumes élevés de traces, effectuer des requêtes flexibles et transformer ces données en visualisations pour le débogage, l’analyse de produit et les workflows opérationnels. C’est pourquoi nous avons créé SmithDB, une base de données conçue spécifiquement pour les données de trace dans LangSmith, et plus récemment Custom Apps, qui permettent aux équipes de créer des visualisations personnalisées basées sur leurs traces.
Aujourd’hui, nous ajoutons AI Search, une nouvelle méthode pour interroger les traces en utilisant le langage naturel.
Pourquoi avons-nous développé la recherche en intelligence artificielle
Chaque trace contient les entrées utilisateur, le raisonnement de l’agent, les appels aux outils et les réponses, ainsi que toutes les informations nécessaires pour comprendre où les agents performent bien et où ils échouent. Les équipes utilisant LangSmith exploitent souvent leurs traces d’agents afin de découvrir des exemples pour une évaluation dataset ou des conversations pour un réviseur dans une annotation queue.
Cependant, découvrir les bons indices peut être laborieux. Des questions telles que « est-ce que des PII ont fuilli ? » ou « l’utilisateur s’est-il frustré ? » ne se rapportent pas clairement à un attribut de trace comme les tags ou les métadonnées, et ne peuvent pas être répondu par une recherche de texte complet. Il faut comprendre le contenu du trace. Jusqu’à présent, cela impliquait de mettre en place un évaluateur à l’avance ou de parcourir manuellement les traces.
C’est pour cela que nous avons créé l’IA Search. Vous décrivez le comportement que vous recherchez, et LangSmith répertorie les traces où cela s’est produit. Cela vous permet de trouver les traces difficiles à repérer et de rechercher les patterns problématiques en temps réel.
Ce que vous pouvez rechercher
Vous pouvez rechercher tout ce qui apparaît dans le contenu d’un trace. Vous pourriez chercher un agent qui a déclaré avoir terminé une tâche mais n’en a pas fait, un utilisateur qui semblait frustré ou qui remettait en question une réponse, une demande à un modèle qui a généré des données personnelles identifiables (PII), ou quelqu’un qui essaie de annuler sa souscription. Les équipes de produit peuvent rechercher « demandes d’intégration que nous ne supportons pas », « concurrents mentionnés » ou « utilisateurs confus quant à l’onboarding » et voir où le produit manque, dans les mots des utilisateurs eux-mêmes.
La recherche IA fonctionne également en complément des filtres que vous utilisez déjà, de sorte qu’une recherche ne peut se faire que sur les traces qui ont échoué, ou uniquement avec un tag spécifique.
Comment nous l’avons construit
Pourquoi un modèle lit chaque trace
La recherche vectorielle est la méthode habituelle pour rechercher par sens plutôt que par mots exacts. Elle transforme votre requête et chaque trace en un emboîtement, une courte liste de nombres qui capture ce dont parle le texte. Ensuite, elle renvoie les traces dont l’emboîtement est le plus proche de votre requête. Cela fonctionne bien pour la recherche de sujets, comme trouver des conversations sur les factures. Mais un emboîtement contient tout un texte dans un seul vecteur court, et cette compression est perdue. Les détails importants liés à votre requête peuvent être perdus. Un enregistrement où l’agent effectue le travail avec succès et un autre où il ne dit simplement qu’il l’a fait peuvent avoir presque la même embedding. Pour les distinguer, il faut un modèle qui lit les mots exacts de l’enregistrement ainsi que votre question, afin de pouvoir raisonner sur ce qui s’est passé.
Jusqu’à récemment, effectuer cela lors de la recherche était trop lent et trop coûteux. Les modèles de décision rapides ont changé cette situation. Ils répondent à une question précise concernant une entrée en peu de temps et à un coût suffisamment faible pour être utilisés à grande échelle. AI Search combine l’inférence du modèle de décision avec SmithDB, notre couche de données pour l’observabilité des agents. Lorsque les traces arrivent, SmithDB les transforme en trajectoires. Lors de la recherche, vos filtres réduisent le nombre de candidats, et le modèle de décision vérifie chaque trajectoire restante contre votre description.
Les traces sont grandes et se présentent sous de nombreux formats
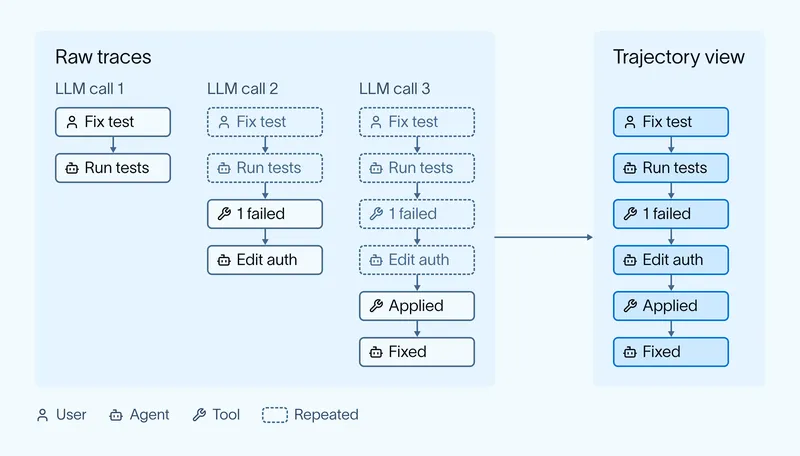
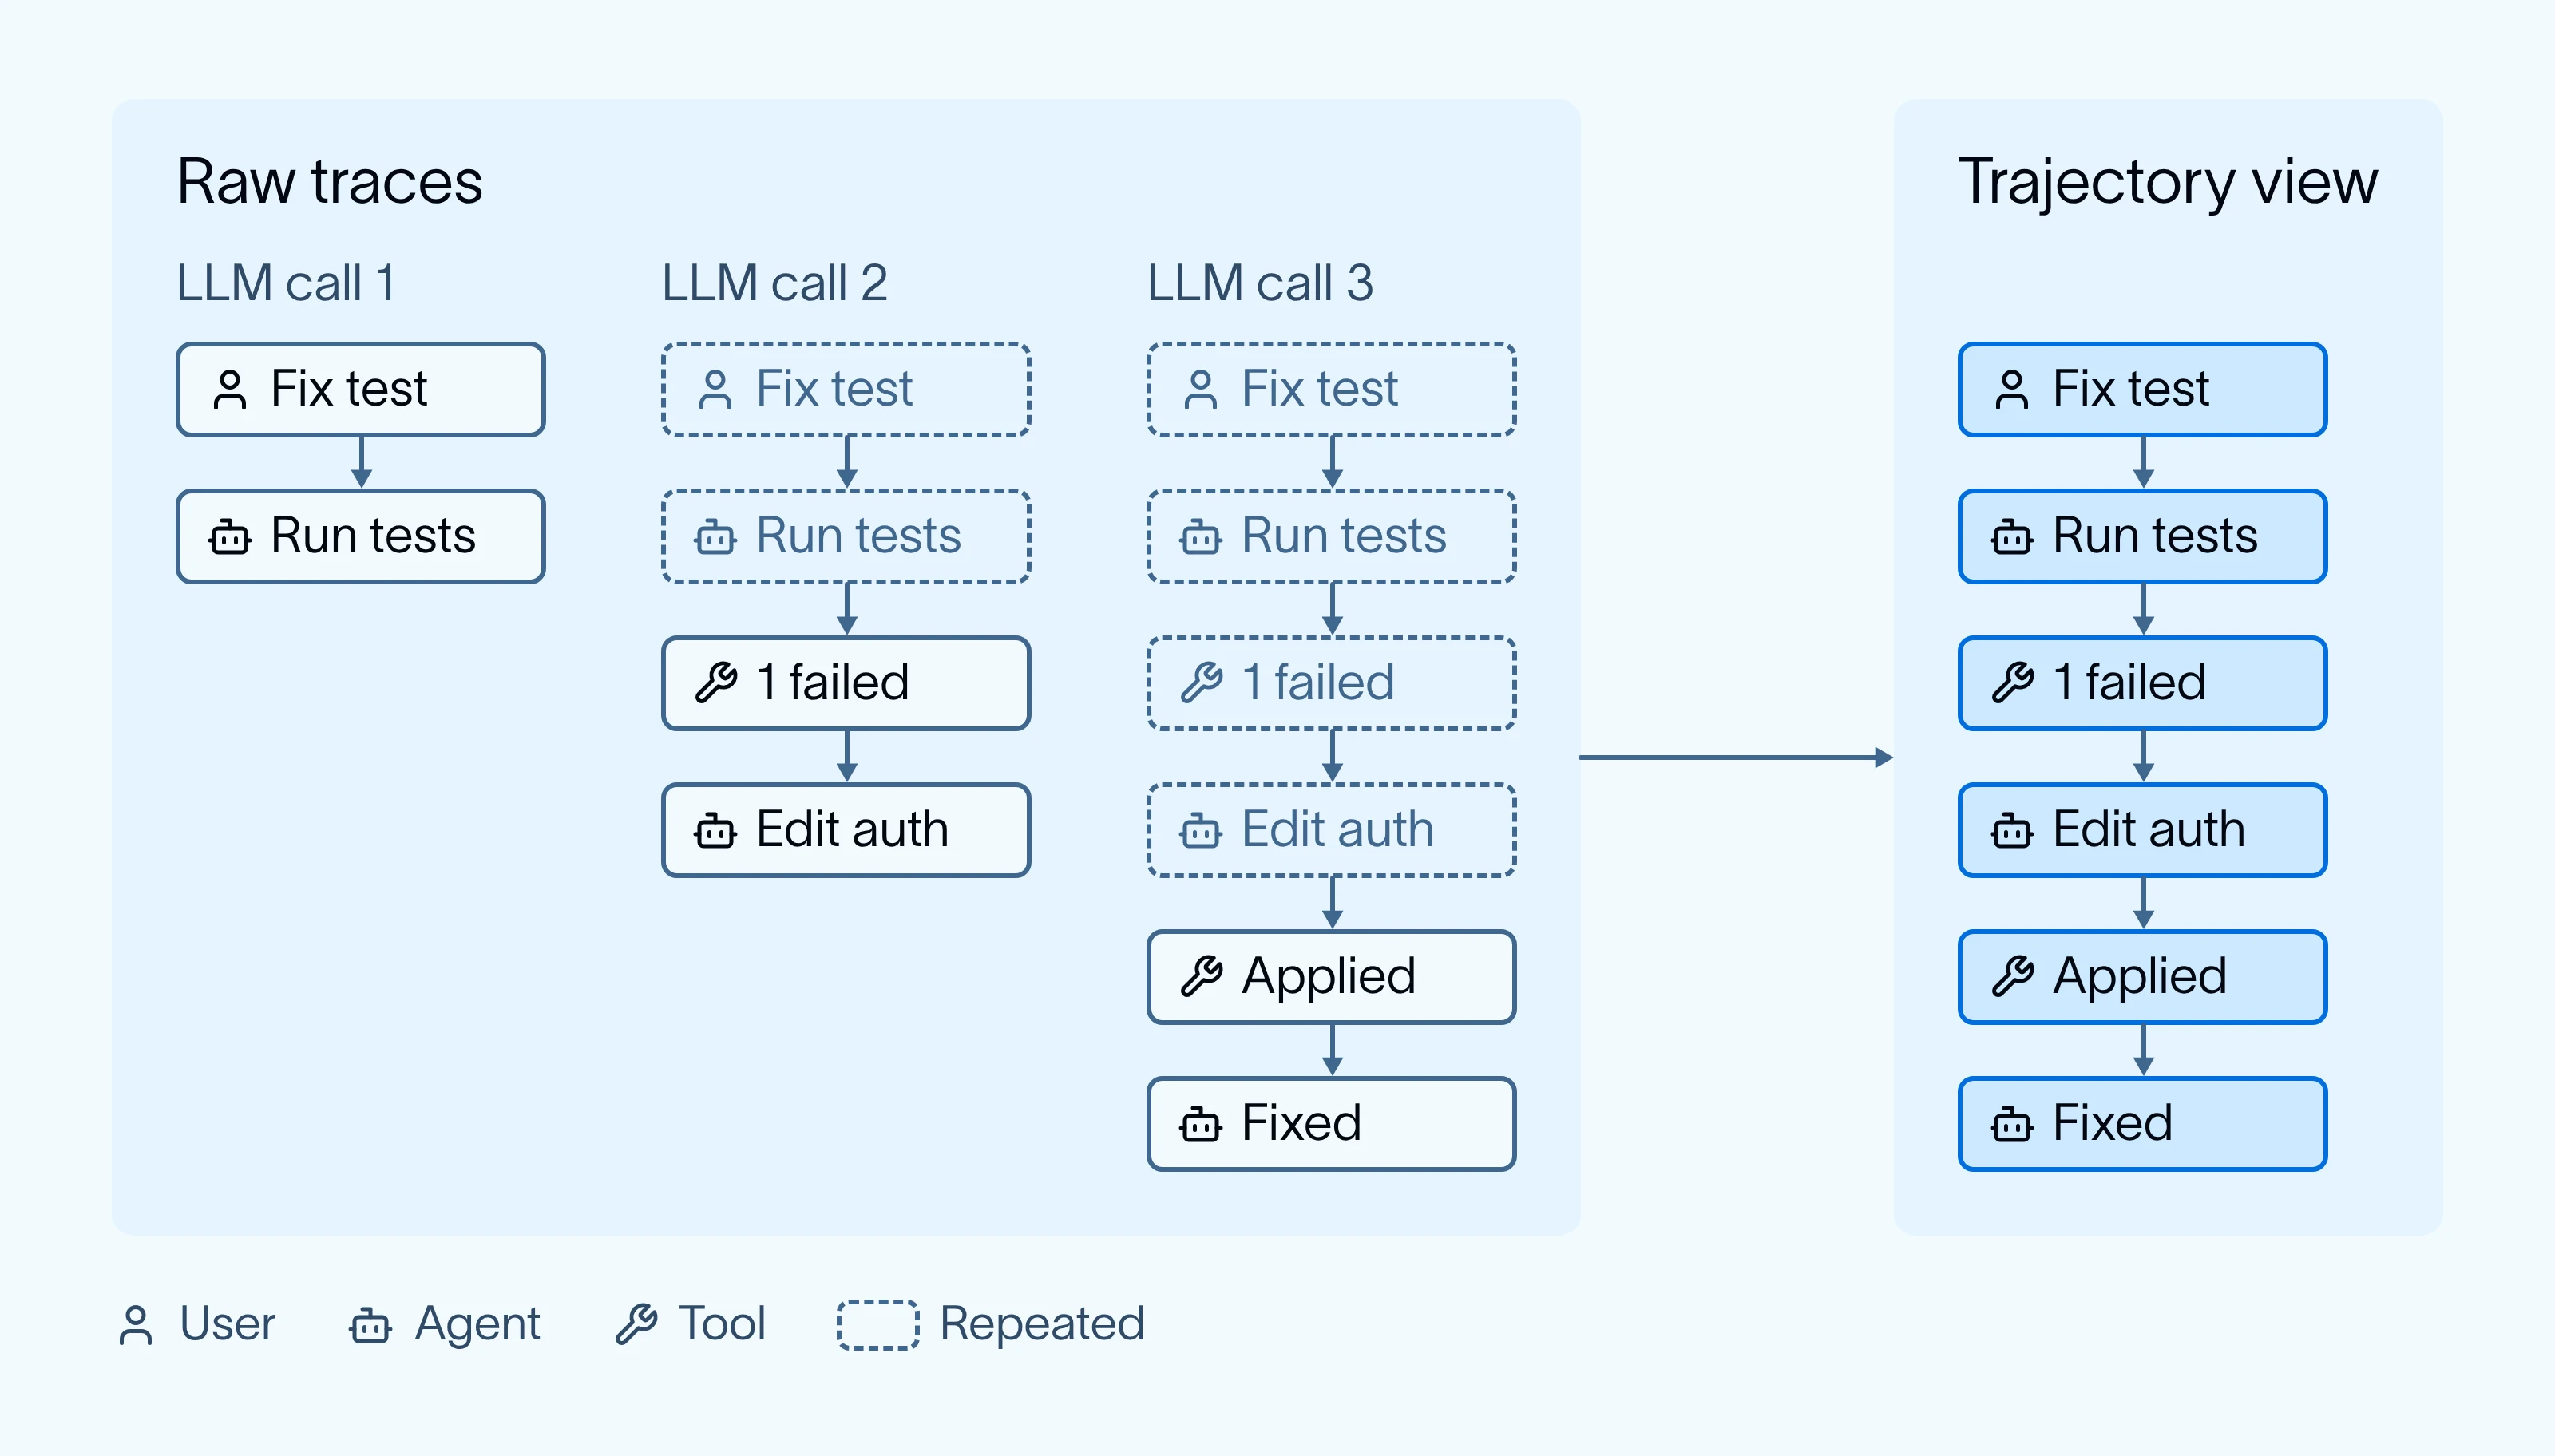
Les traces proviennent de nombreuses sources : les SDK OpenAI et Anthropic, LangChain, LangGraph, le SDK AI de Vercel, OpenTelemetry, et bien d’autres. Chacun enregistre les messages de manière légèrement différente. Les traces se répètent également. Les agents transmettent souvent à nouveau l’histoire de la conversation à chaque appel au LLM, de sorte que le premier message apparaît à nouveau dans chaque appel ultérieur.
SmithDB transforme ces traces en une trajectoire pour chaque session. Une trajectoire représente une vue condensée du travail de l’agent : chaque message, appel d’outil et résultat d’outil sont listés une seule fois. SmithDB la construit lorsque les traces arrivent et transforme tous les formats supportés en une même forme.
L’analyse de recherche par l’IA examine les trajectoires plutôt que les traces brutes. Comme tous les formats ont la même forme de trajectoire, une seule recherche fonctionne entre des agents construits avec différents SDK. En supprimant les messages répétés, l’encombrement du contexte est réduit, ce qui permet aux recherches de se dérouler plus rapidement. Une trajectoire couvre également toute la session ; par exemple, si vous cherchez « l’utilisateur a tenté d’annuler », le modèle comprend ce que l’utilisateur a demandé, ce que l’agent a fait et comment la conversation s’est terminée.
Les trajectoires sont toujours longues
Enlever les duplications aide, mais les trajets des agents sont toujours longs. Pour avoir une idée de la durée, nous avons extrait 150 conversations aléatoires depuis Open SWE, l’agent de codage open source que l’équipe LangChain utilise quotidiennement. Chaque tâche s’exécute dans son propre sandboxed avec accès à la shell et peut confier le travail à des sous-agents, ce qui fait que les conversations deviennent longues.
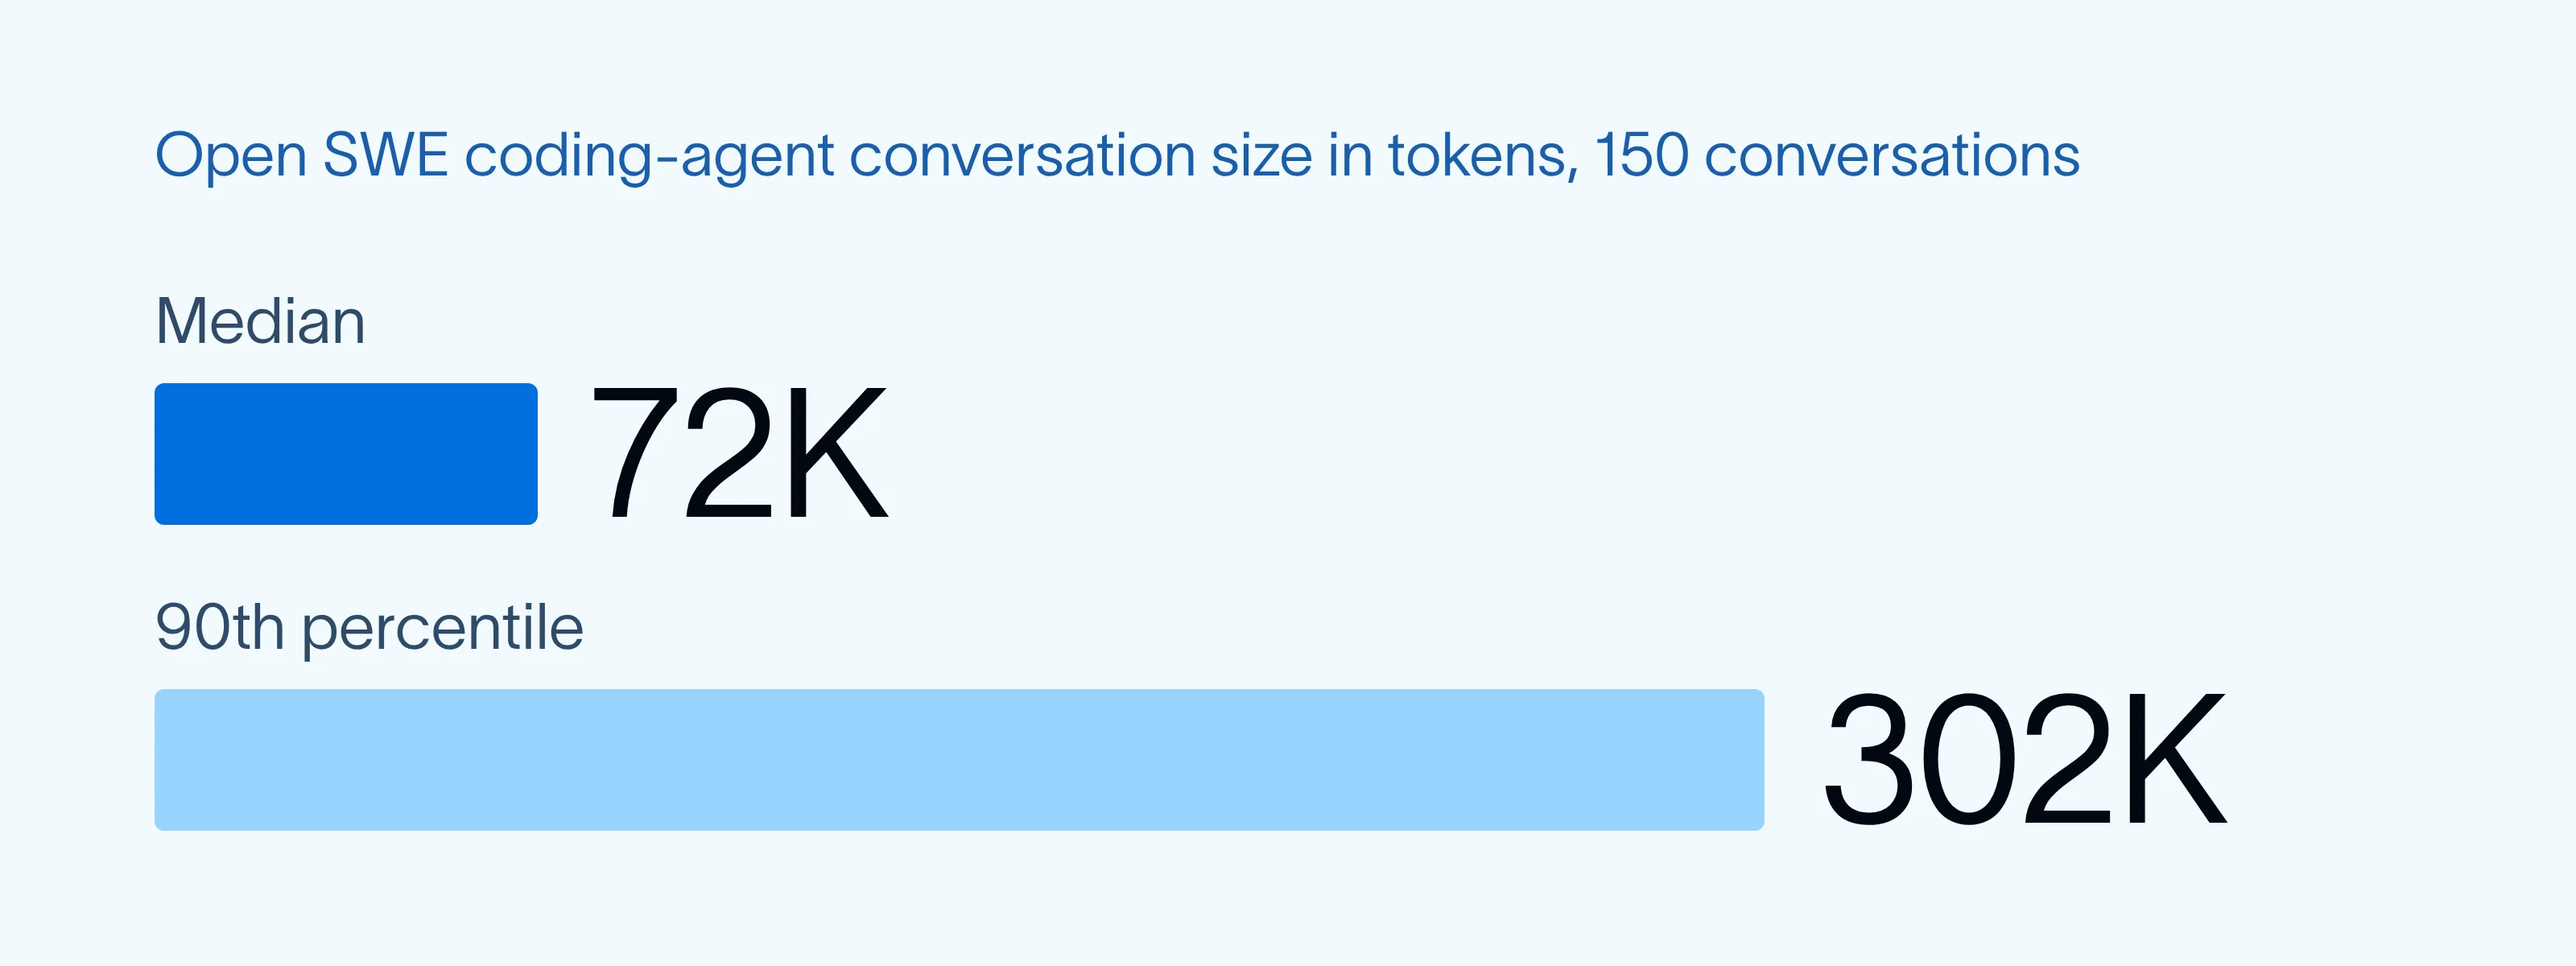
Quelques d’entre eux ont dépassé un million de tokens, même dans un échantillon si petit. La recherche d’un comportement rare signifie lire de nombreuses conversations, donc la recherche en IA rencontre régulièrement des cas de cette taille et ne peut pas lire chaque token.
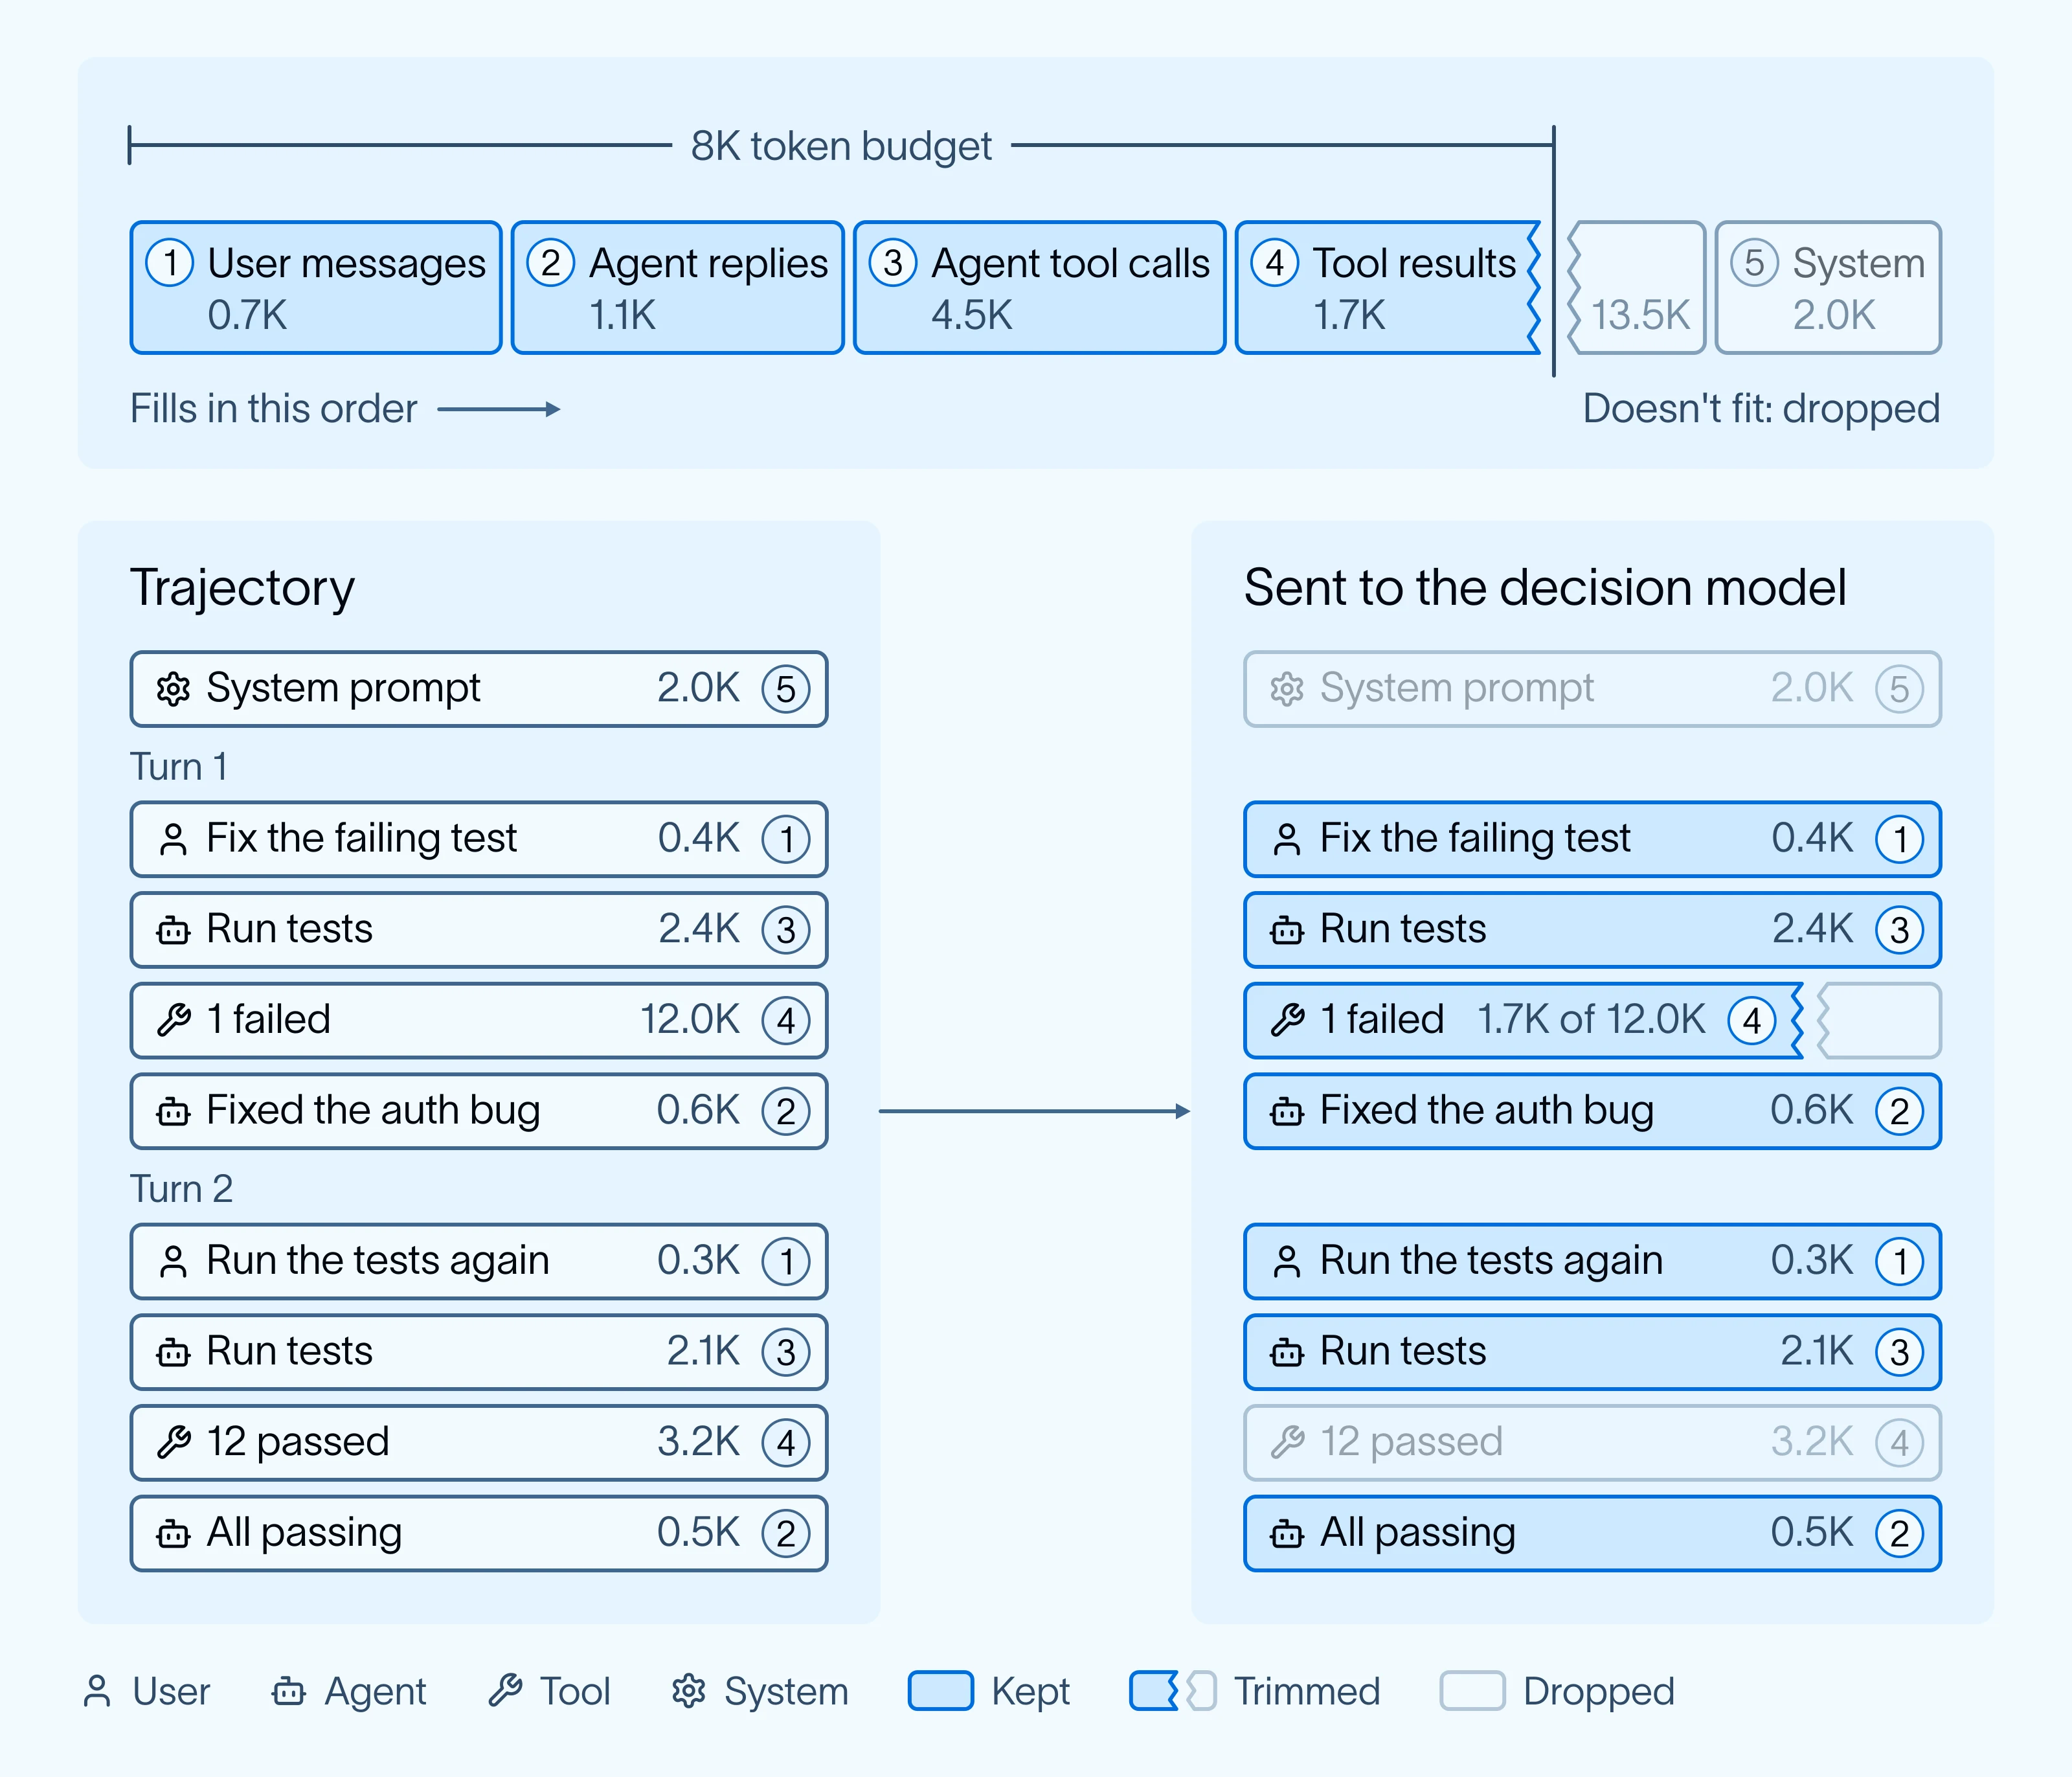
La plupart des questions ne nécessitent pas tous ces tokens. De nombreuses questions portent sur ce que l’utilisateur demande et la manière dont l’agent répond. Dans une conversation moyenne, environ 2K de ses 72K tokens proviennent des messages de l’utilisateur et des réponses de l’agent. Environ 85 % sont des résultats produits par les outils, principalement des lectures de fichiers et des commandes shell.
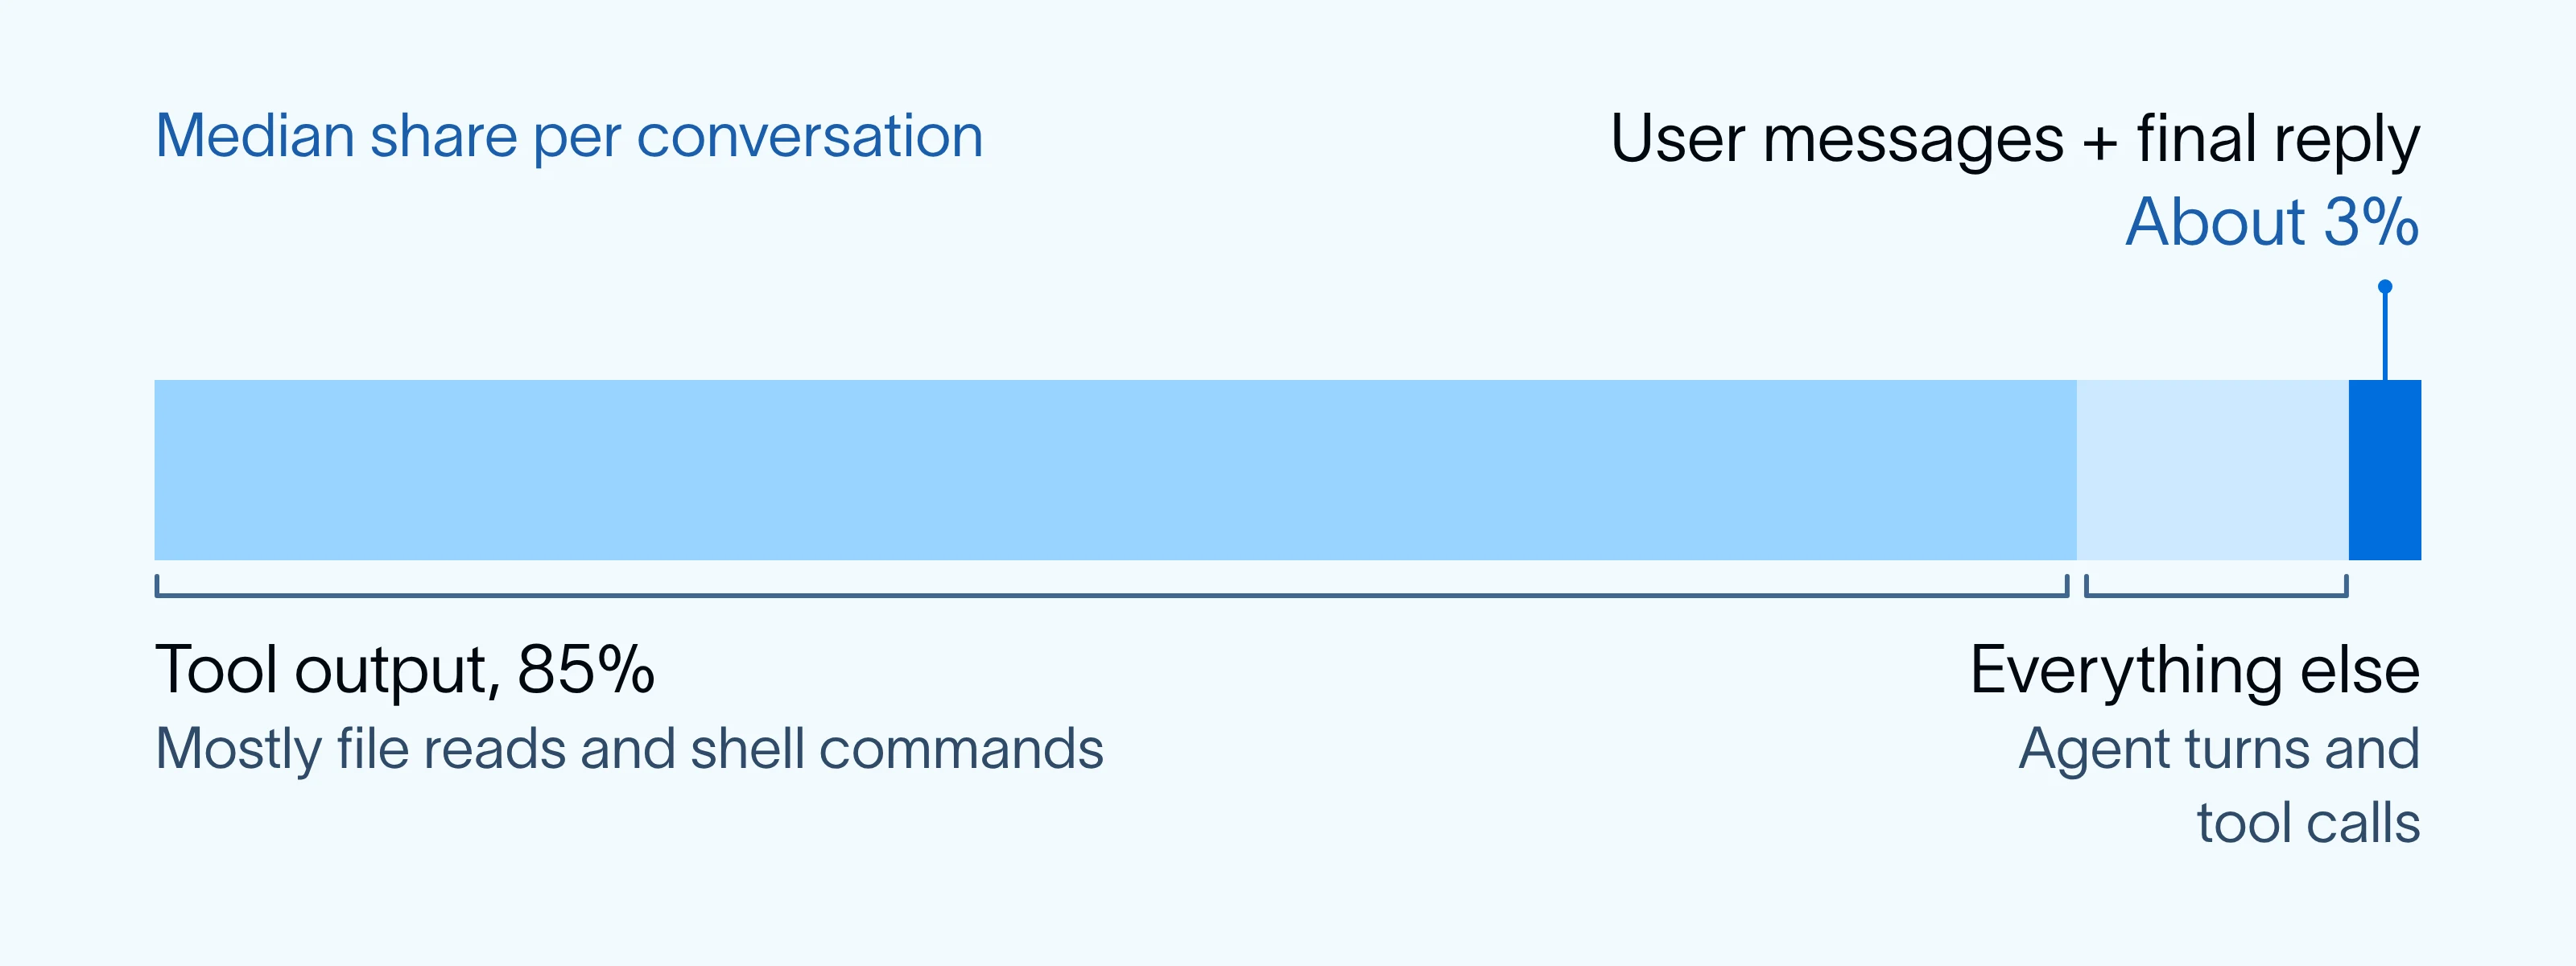
Chaque trajet reçoit un budget de tokens fixe, qui est utilisé selon l’ordre de priorité. Les messages utilisateur et les réponses de l’agent à l’utilisateur vont en premier. Le reste du budget est alloué à tout le reste : les messages d’IA intermédiaires (le raisonnement de l’agent et les appels aux outils), les résultats des outils et les messages système. Si le prochain message ne peut être entièrement utilisé, il est réduit pour remplir le budget, et tout ce qui suit est supprimé.
Les recherches doivent rester rapides à grande échelle
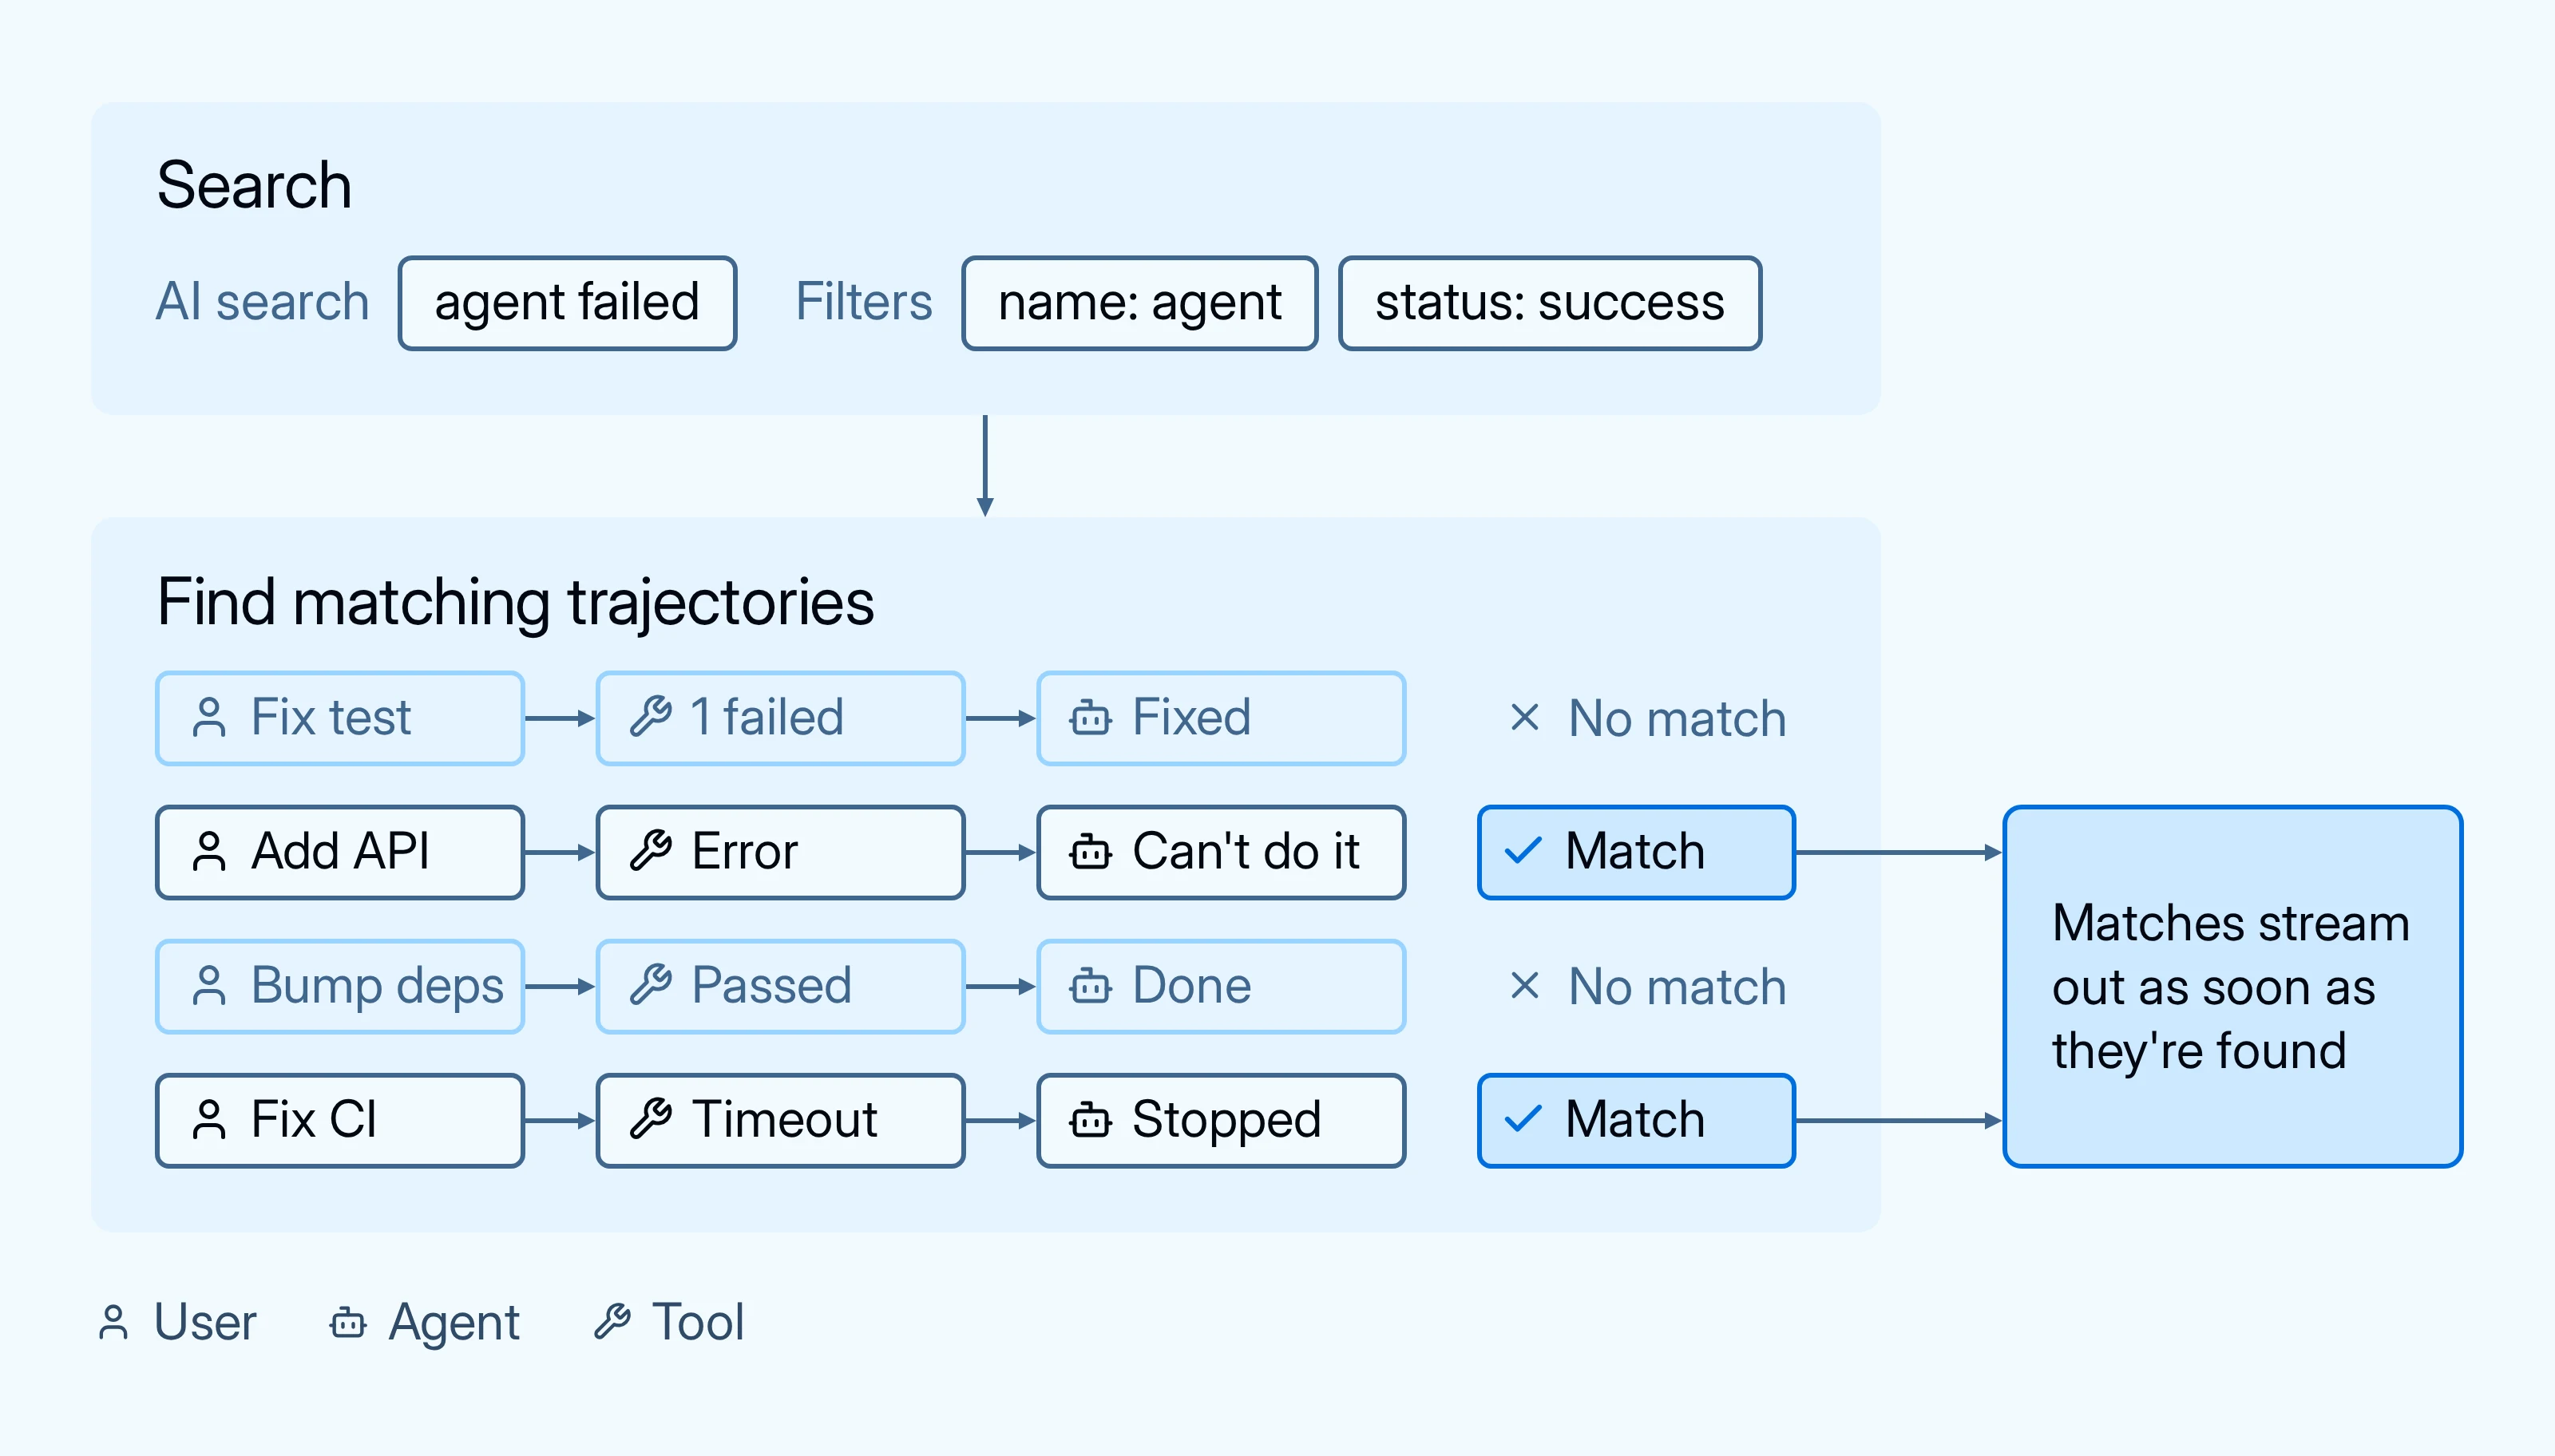
SmithDB est conçu pour ingérer et scanner de grandes quantités de données de traçage des agents. Lorsque vous effectuez une recherche, vos filtres structurés éliminent d’abord les candidats potentiels. Le modèle de décision vérifie ensuite chaque trajectoire restante contre votre description, en parallèle. Pendant que le modèle vérifie un lot de trajectoires, SmithDB récupère et prépare déjà le lot suivant. Les correspondances sont renvoyées en continu dès qu’elles sont trouvées, vous évitant ainsi d’attendre une scan complète.
Qu’est-ce qui suit
Nous continuons d’apprendre quelles questions les gens posent le plus souvent. Les conversations les plus difficiles à classer sont celles présentant des différences subtiles. Identifier « l’utilisateur a abandonné » par rapport à « l’utilisateur a obtenu ce dont il avait besoin et est parti » peut dépendre de quelques échanges dans une longue trajectoire. Nous voulons voir si un modèle entraîné sur des traces permet de les distinguer plus fiablement.
Le budget de token fonctionne bien lorsque la réponse se trouve dans ce que l’utilisateur et l’agent ont dit. D’autres questions nécessitent des preuves différentes. Un agent qui ignore une erreur du outil apparaît uniquement dans les résultats de l’outil. Nous explorons des moyens de choisir le contexte en fonction de la question, ainsi que les signaux indiquant que le modèle est incertain, afin qu’il puisse passer une deuxième fois avec plus de contexte.
Nous aimerions également passer par une liste simple des matchs en regroupant les résultats similaires ou en résumant ce qu’ils ont en commun.
Commencez
La recherche IA est en beta publique sur LangSmith Cloud dans les régions GCP US, EU et APAC, sans coût supplémentaire. Les administrateurs d’organisation peuvent l’activer dans les paramètres, et elle apparaît alors sur la page de traçage. Les documents sur la recherche IA contiennent les détails. Dites-nous ce que vous cherchez à rechercher.