
Mixture-of-Experts (MoE) est une architecture à activation clairsemée qui accroît la capacité des grands modèles de langage (LLM) tout en maintenant un faible coût de calcul par jeton. Comme ses opérations représentent une grande part du temps de calcul total, leurs inefficacités augmentent directement la latence et le coût des requêtes. Par conséquent, l'optimisation des opérations MoE par l'ingénierie des noyaux offre la plus grande opportunité de gains de performance.
Le MoE fusionné (fused MoE) est une technique d'optimisation clé pour l'architecture MoE. Un système MoE fusionné regroupe le routage des jetons, le brassage des données et les calculs spécialisés du réseau en une seule opération par lot sur le GPU. Cela remplace l'exécution du routage et des calculs d'experts en tant qu'opérations de boucle séparées et séquentielles. Bien que cette approche apporte des avantages en termes de latence, elle introduit également une complexité dans l'implémentation des noyaux et le débogage. Une utilisation élevée du GPU pour cette architecture nécessite des optimisations spécifiques au matériel.
Dans cet article, nous décrivons les différentes optimisations de noyaux que nous avons implémentées pour les modèles MoE fusionnés et vous montrons comment vous pouvez bénéficier de ce travail. Nous avons utilisé un modèle MoE représentatif comme exemple principal.
Swap-AB pour l'utilisation de WGMMA
Pour maximiser le débit de traitement tensoriel, l'architecture NVIDIA Hopper repose sur le protocole d'instruction Warp Group Matrix Multiply Accumulate (WGMMA), qui s'exécute collectivement sur un warpgroup coopératif de 128 threads. Cette asymétrie des opérandes est fondamentalement une propriété au niveau du jeu d'instructions (ISA). Dans la définition en wgmma.mma_async assembleur sous-jacente, le matériel fixe la dimension des lignes de la matrice (M) à une échelle constante de 64 pour définir sa topologie de mappage parallèle des threads. La dimension des colonnes (N) reste hautement variable. L'opérande A est strictement mappé sur cette dimension M fixe (en utilisant des registres ou la mémoire partagée), et l'opérande B est mappé sur la dimension N variable (via un descripteur de mémoire partagée). Ces emplacements d'opérandes sont donc structurellement non interchangeables. Par conséquent, l'utilisation maximale des tuiles matérielles est régie par ces encodages rigides de formes, exigeant que la dimension M soit égale ou supérieure à 64 pour empêcher les unités d'exécution de calcul de rester inactives.
Cette préférence structurelle découle de la manière dont les Tensor Cores de Hopper partitionnent les blocs mémoire. Le matériel impose une forme de mise en page minimale fixe pour la dimension de tête du premier opérande, verrouillant la hauteur du bloc à exactement 64 (M=64). Lorsqu'une matrice mathématique possède une grande dimension de tête continue dans cet emplacement principal, les ordonnanceurs matériels internes de Hopper peuvent proprement mapper et distribuer les données sur la grille de calcul physique.
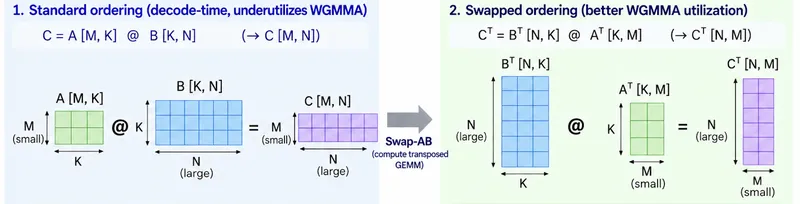
Cette asymétrie structurelle devient un goulot d'étranglement sévère de performance pendant la phase de décodage des réseaux MoE. Dans une couche MoE standard, l'algèbre linéaire régissant le calcul des experts est formulée en notation matricielle traditionnelle :
A[M,K] x B[K,N] —> C[M,N]
Où (M) représente le nombre de lignes de jetons (ou la taille du lot), (K) représente la dimension des caractéristiques cachées, et (N) représente la vaste dimension de sortie de l'expert.
Pendant la phase de décodage, le système ne traite qu'un seul jeton par séquence utilisateur à la fois. Par conséquent, l'espace du lot ou la taille des lignes de jetons est extrêmement mince, tombant régulièrement à un profil où (M < 64), et fréquemment à une seule ligne (M = 1). Avec cette mise en page structurelle standard :
La matrice (A) se transforme en un vecteur horizontal mince et fragmenté (par exemple, 1 x 4096).
La matrice (B) (les poids essentiels de l'expert) reste dans un grand bloc vertical dense (par exemple, 4096 x 8192).
Comme le nombre de lignes (M) est minuscule, la matrice (A) est physiquement incapable de remplir le compartiment fixe de mise en page à (64) lignes du matériel pour l'opérande A. Lorsque l'instruction WGMMA s'exécute sur cette mise en page, elle laisse une vaste partie de la capacité physique des Tensor Cores complètement inutilisée. Le silicium passe des cycles d'horloge à traiter des emplacements spatiaux vides, ce qui entraîne une mauvaise utilisation du matériel.
Dans une couche LLM dense standard, les matrices de poids sont statiques, unifiées et parfaitement contiguës. Dans une couche MoE, en revanche, la charge de travail est répartie sur une flotte de sous-réseaux indépendants (experts). Cela crée des goulots d'étranglement uniques de mémoire et de mise en page qui la rendent hypersensible aux contraintes WGMMA du GPU Hopper. Dans une couche dense standard, la multiplication matricielle multiplie un vecteur de jetons par une seule matrice de poids de couche. La dimension de sortie (N) est la taille cachée du modèle (par exemple, 4096).
Dans un noyau MoE fusionné, le GPU ne multiplie pas seulement contre un seul expert. Il regroupe et exécute les calculs pour tous les experts actifs simultanément afin d'éviter de lancer des noyaux individuels pour chaque expert. Pour une couche dense standard, N est la taille cachée (4,096). Pour une couche MoE fusionnée, N est le nombre d'experts choisis multiplié par la taille intermédiaire de l'expert. Pour un modèle exécutant une topk=8 routine, la dimension N effective à l'intérieur du noyau fusionné explose en dizaines ou centaines de milliers de paramètres. Comme la dimension N est si disproportionnée par rapport à la taille minuscule des jetons de décodage (M=1), l'asymétrie de mise en page devient extrême. La transposition des matrices déplace cette grande dimension MoE combinée vers l'emplacement principal, débloquant un préchargement matériel à une échelle que les couches denses standard ne peuvent égaler.
Pour résoudre ce désalignement matériel sans altérer l'intégrité mathématique sous-jacente du modèle, nous exploitons la propriété algébrique de la transposition de matrice :
BT[N,K] x AT[K,M] —> CT[N,M]
Figure 1 : Swap-AB pour l'utilisation de WGMMA
En inversant programmatiquement la multiplication matricielle avant qu'elle n'atteigne la couche d'assemblage PTX, nous avons réaligné le logiciel pour qu'il corresponde à la topographie exacte du silicium Hopper. Cette transposition déclenche deux avantages architecturaux immédiats sur le GPU. Premièrement, elle sature la disposition physique. La vaste dimension experte (N = 8192) est promue à la position du premier opérande (BT"), et parce que (N) est grand, il dépasse facilement le seuil obligatoire de (64) lignes du matériel. Les Tensor Cores fonctionnent alors à une densité locale maximale sans cycles d'exécution gaspillés. Deuxièmement, il active la prélecture asynchrone. Les moteurs de copie matériels dédiés de Hopper peuvent prélecture des adresses mémoire de manière asynchrone depuis la mémoire partagée directement vers les registres avant que le bloc d'exécution mathématique ne se déclenche. Le placement des blocs de poids continus et volumineux (BT") dans l'emplacement de tête permet à ces moteurs de suivre la disposition des données de manière fluide et de maintenir le pipeline de calcul saturé sans intervention du CPU. Cela a produit une amélioration de 2 à 4 pour cent du débit de sortie de bout en bout sur des modèles MoE à grande échelle sur H200. Nous avons intégré cette optimisation en amont dans vLLM, et elle est disponible dans la version 0.24.0 ou ultérieure.
Routage backend pour la quantisation des tenseurs FP8
Au-delà des internes du noyau, le choix du backend qui exécute le calcul du MoE a un effet important sur les performances. L'oracle MoE de vLLM route les différents schémas de quantification vers Triton, FlashInfer+CUTLASS ou d'autres backends. Le profilage a révélé que pour les modèles quantifiés en FP8 tensor sur Hopper, le backend Triton surpasse constamment le backend par défaut FLASHINFER_CUTLASS chemin.
Le backend Triton surpasse CUTLASS dans les charges de travail MoE à faible concurrence principalement parce qu'il remplace les configurations rigides de calcul matriciel au niveau du framework par une fusion de registres personnalisée au niveau des opérateurs. CUTLASS repose sur des structures de modèles C++ standards qui traitent la mise à l'échelle des tenseurs FP8, la multiplication matricielle et l'agrégation d'experts comme des opérations mathématiques discrètes. Le backend Triton consolide au contraire l'ensemble de ce pipeline en une seule passe matérielle. Les données sont extraites de la mémoire globale à large bande passante (HBM) exactement une fois et traitées entièrement dans les registres SRAM locaux ultra-rapides du GPU et ses fichiers d'exécution de calcul. Elles sont ensuite renvoyées en flux vers la destination matricielle finale. Cela élimine les allers-retours lents de lecture/écriture en VRAM globale qui pénalisent CUTLASS lorsqu'il est contraint de passer constamment par des étapes intermédiaires de mise à l'échelle des tenseurs.
De plus, cette fusion au niveau des registres est spécifiquement associée à des dispositions d'ordonnancement dynamique conçues autour d'un token bucketing à variable, résolvant ainsi un grave défaut structurel des modèles de compilation traditionnels. CUTLASS est optimisé nativement pour des dimensions de matrice denses, grandes et prévisibles. Lorsqu'il rencontre les profils de batch fluides et ultra-minces (M < 64 ou M = 1), typiques de la phase de génération de décodage en direct, ses structures par défaut de block-tiling et de mappage de threads deviennent profondément inefficaces. Il en résulte une sous-utilisation importante des warps ou un coût mémoire élevé lié au padding. À l'inverse, le backend Triton MoE excelle dans le mappage dynamique de ces petits tableaux de tokens fragmentés à travers les frontières physiques des poids d'experts actifs. Cela permet de maintenir pleinement saturés les flux de préchargement internes du matériel et les pipelines des Tensor Core, même lors du traitement de charges de travail très instables à de très faibles tailles de batch.
La mise à jour de la politique de routage est un changement purement configurationnel, sans aucune modification du code du noyau. Pourtant, elle a produit un Amélioration de 10 % du débit de bout en bout pour les modèles MoE fusionnés quantifiés en FP8 sur H200. Cette amélioration est disponible dans le conteneur AWS Large Model Inference (LMI) v28.
Élimination de la recompilation JIT de Triton
L'une des pathologies de performance les plus impactantes en inférence GPU est aussi l'une des moins évidentes : la recompilation inutile de kernels. Triton, le framework de compilation qui sous-tend beaucoup de kernels personnalisés de vLLM, spécialise les arguments entiers par défaut. Chaque fois qu'un kernel est invoqué avec une valeur jamais vue auparavant pour un paramètre spécialisé, Triton déclenche une nouvelle compilation juste-à-temps (JIT). Dans les charges de travail de service où les longueurs de séquence et les tailles de batch varient en continu, cela crée un flux constant de surcoût de compilation qui gonfle la latence, en particulier le Time to First Token (TTFT).
Dans le service de modèles MoE, le _fused_inv_rope_fp8_quant_per_head kernel (responsable de l'encodage de position rotatif fusionné et de la quantification FP8) était recompilé à chaque nouveau num_tokens valeur. Ajouter do_not_specialize les annotations sur les paramètres à longueur variable ont complètement supprimé ces recompilations, améliorant le TTFT de 9 pour cent sur H200 avec un tensor parallelism à 8 voies (PR #42849).
Dans un cluster multi-GPU, les 8 GPU doivent exécuter leurs kernels dans une synchronisation parfaite au niveau de la microseconde. Si un seul GPU doit s'arrêter pour recompiler son local _fused_inv_rope_fp8_quant_per_head noyau, car son nombre local de lots de jetons a changé, les sept autres GPU restent inactifs et l'attendent. En éliminant les recompilations sur l'ensemble du cluster, nous avons lissé la surcharge de coordination multi-GPU, ce qui a apporté une accélération de 9 pour cent sur la latence de la première réponse de l'utilisateur. Le principe ici est de traiter le compilateur comme une surface d'optimisation de premier ordre. Comprendre comment Triton spécialise les sémantiques et reconnaître quand les paramètres sont morts ou variables permet d'obtenir des améliorations de latence avec un minimum de modifications de code.
Nous avons intégré cette optimisation en amont dans vLLM, et elle est disponible à partir de la version 0.22.0 ou ultérieure.
Conclusion
Grâce à notre collaboration avec la communauté vLLM, nous avons implémenté et publié en open source plusieurs optimisations de noyaux pour les modèles MoE fusionnés. Nous appliquons ces optimisations dans le LMI Deep Learning Container sur Amazon SageMaker AI. Ensemble, ces optimisations ont permis d'obtenir un débit supérieur allant jusqu'à 10 pour cent et un TTFT plus rapide allant jusqu'à 9 pour cent. Pour commencer avec l'hébergement de modèles personnalisés, consultez la documentation d'hébergement Amazon SageMaker AI.