
Cet article a été rédigé en collaboration avec Kenneth Salmon, Edward Boswell, Jack Armstrong, Robert Bahn et Nick Ciubotariu de ShipStation Global.
Répondre aux mêmes questions IT et traiter les tickets de routine consomme du temps que les équipes IT pourraient consacrer ailleurs. Pour le récupérer, l'équipe d'ingénierie de ShipStation Global a construit Deckhand, un agent de service d'assistance IT basé sur l'IA pour Slack, sur Amazon Bedrock AgentCore.
ShipStation Global est la plateforme de référence en matière d'expédition et de logistique intelligentes pour les expéditeurs de petite et moyenne taille, et elle fonctionne selon une conviction simple : plus ses équipes sont efficaces, mieux elle sert ses clients. Deckhand met cette conviction en pratique. Il répond aux questions IT et aux questions d'entreprise courantes à partir d'une base de connaissances organisée, lit les captures d'écran de messages d'erreur, et crée et met à jour des tickets Jira Service Management.
Dans cet article, nous expliquons comment ShipStation a architecturé Deckhand, ce qui a permis de résoudre 97,5 pour cent des requêtes entrantes sur le canal tout en obtenant un taux de retours positifs de 96 pour cent de la part des employés (Figure 1).
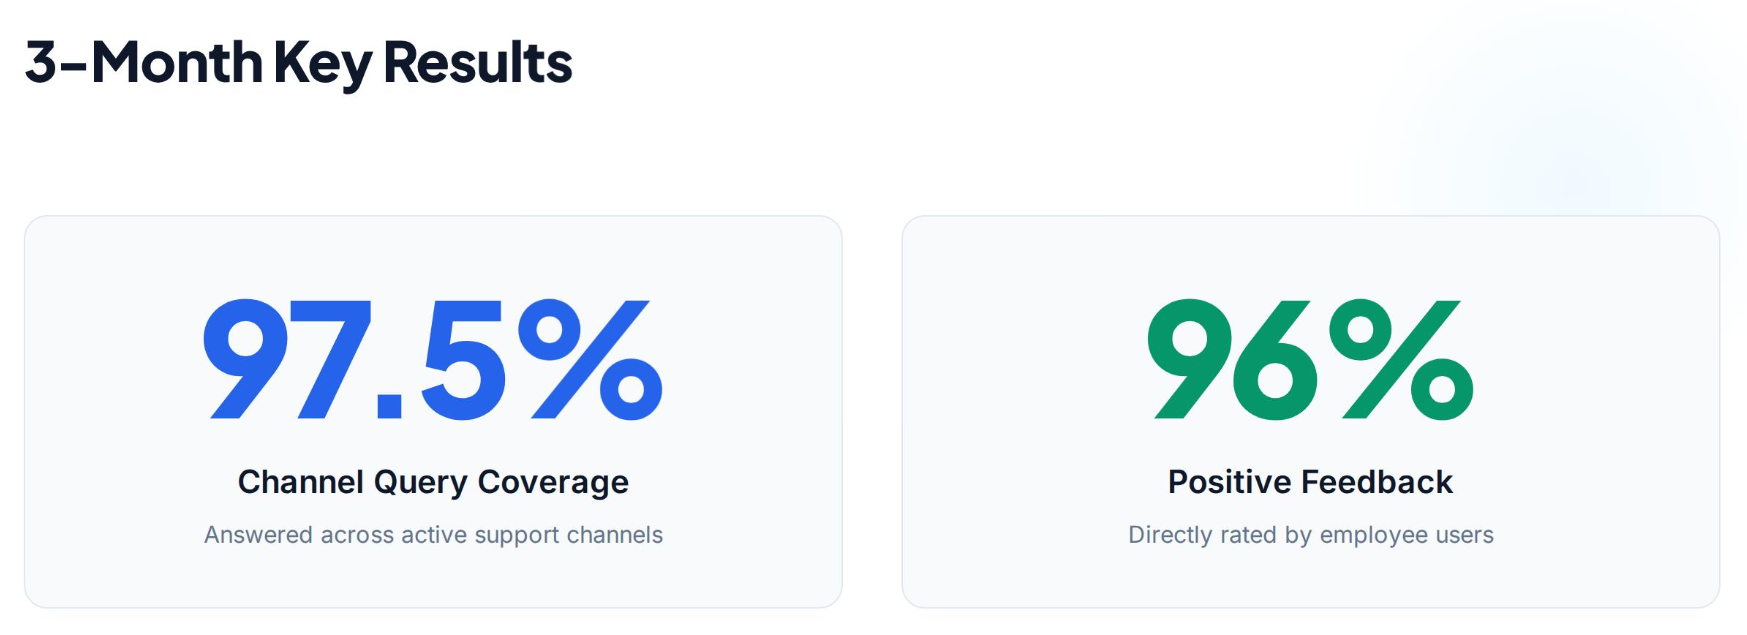
Figure 1 : couverture du canal et retours positifs sur 3 mois
Défi métier
Le problème que Deckhand résout est celui que chaque équipe IT reconnaîtra : les mêmes questions sont posées régulièrement, des messages d'erreur sont publiés en dehors des heures de travail, et des informations doivent être recueillies auprès de différentes équipes. Chez ShipStation Global, ces conversations avaient lieu dans un canal Slack de service d'assistance très actif, où les employés posaient des questions et l'équipe IT répondait, un fil à la fois. Les réponses existaient généralement déjà dans un article de mode d'emploi Confluence, sur une page intranet de l'entreprise, ou dans un fil vieux de huit mois. Les trouver était la partie difficile.
Les données du canal ont rendu l'ampleur concrète. Dans les 12 mois précédant le lancement :
- Les employés ont publié plus de 1,500 fils, et le volume n'a cessé de croître.
- Avec des employés aux États-Unis, au Royaume-Uni, en Espagne, en Pologne, en Australie et aux Philippines, plus d'un cinquième des questions arrivaient en dehors des heures de travail américaines.
- Les réponses étaient réparties en différents endroits : articles Confluence, pages intranet et PDF, guides tenus par l'équipe IT, et l'historique du canal lui-même.
- Les questions répétitives consommaient du temps que des étapes structurées de libre-service auraient pu gérer.
« Nous avons créé Deckhand parce qu'obtenir de l'aide devrait être aussi simple que de poser une question dans Slack, et non déchiffrer un formulaire de ticket ou envoyer un e-mail dans le vide. Nous pensons que les tickets sont le signe d'une friction opérationnelle, et non de productivité. Deckhand résout les questions courantes sur place et, lorsqu'il n'y parvient pas, convertit la conversation en un ticket entièrement contextualisé en un seul clic, améliorant l'expérience des employés et libérant notre équipe de la répétition sans fin de la phrase : « Veuillez créer un ticket. » »
— Chris Collins, Senior Director IT chez ShipStation Global
Présentation de la solution
Deckhand fonctionne dans Slack comme n'importe quel collègue — rejoignant des canaux, lisant la conversation et tirant du contexte des profils Slack pour répondre aux questions IT sur place. Nous l'exécutons sur Amazon Bedrock AgentCore, une plateforme pour construire, connecter et optimiser des agents à grande échelle, avec n'importe quel framework ou modèle. AgentCore runtime, une capacité d'Amazon Bedrock AgentCore, héberge l'agent dans des sessions isolées, de sorte que nous n'exécutons ni serveurs ni conteneurs.
La solution comporte quatre composants principaux, illustrés dans la Figure 2 :
- Service Slack : Une application FastAPI et Slack Bolt, hébergée sur AWS App Runner. Elle reçoit les événements Slack, décide si le bot doit répondre, et construit une charge utile de contexte utilisateur à partir du profil Slack du demandeur, incluant le nom, l'e-mail, le fuseau horaire et le responsable.
- Service d'agent : Un agent Strands, déployé en tant que conteneur sur Amazon Bedrock AgentCore runtime, gère la boucle d'agent multi-tours avec outils en utilisant Claude d'Anthropic dans Amazon Bedrock.
- Outils et connaissances : Une seule fonction AWS Lambda , exposée sous forme d'outils Model Context Protocol (MCP) via AgentCore Gateway, une capacité d'Amazon Bedrock AgentCore, classifie les demandes, crée et met à jour des tickets Jira et analyse des images. Une base de connaissances Amazon Bedrock indexe le contenu provenant de Confluence, de l'intranet de l'entreprise, de Slack et des pages marketing, en le stockant dans Amazon Simple Storage Service (Amazon S3).
- Opérations et retours d'expérience. Amazon DynamoDB stocke les retours, AWS X-Ray trace les chemins de requêtes à l'aide d'OpenTelemetry, et les services journalisent dans Amazon CloudWatch.
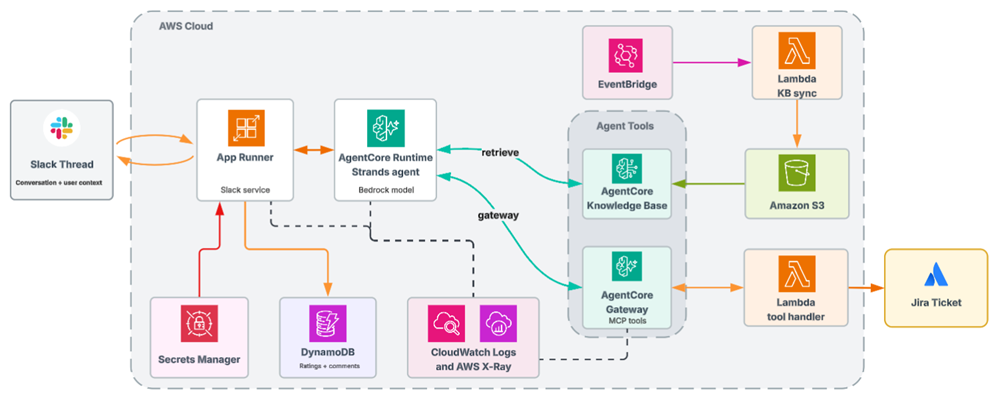
Figure 2 : diagramme d'architecture montrant les événements Slack entrant dans le service Slack et le runtime Amazon Bedrock AgentCore, avec des chemins séparés vers une base de connaissances Amazon Bedrock, des outils Lambda adossés à AgentCore Gateway, Jira Service Management et les retours DynamoDB.
Lorsqu'un employé publie dans un canal dont Deckhand est membre, le service Slack assemble l'historique complet du fil et le contexte utilisateur. Il invoque ensuite l'agent via l'API du runtime AgentCore. L'agent recherche dans la base de connaissances et appelle les outils selon les besoins. Lorsqu'il trouve une réponse, il renvoie une réponse finale (Figure 3). Sinon, il pose une question de clarification ou propose de créer un ticket (Figure 4).
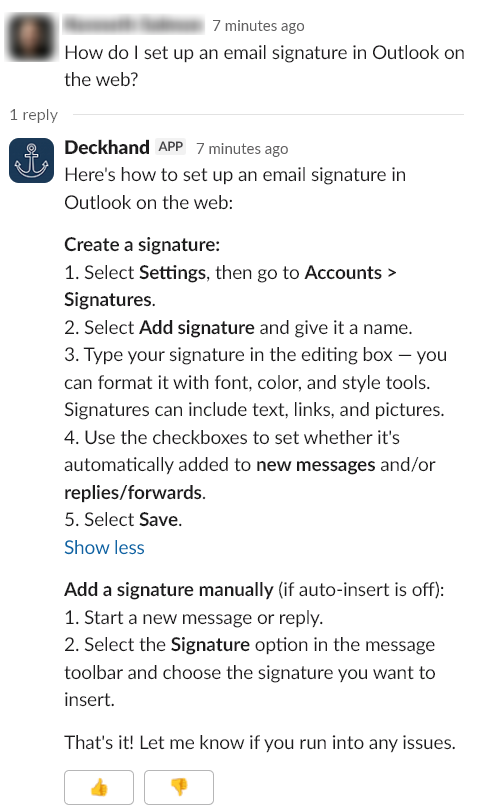
Figure 3 : Deckhand répond avec des étapes en libre-service
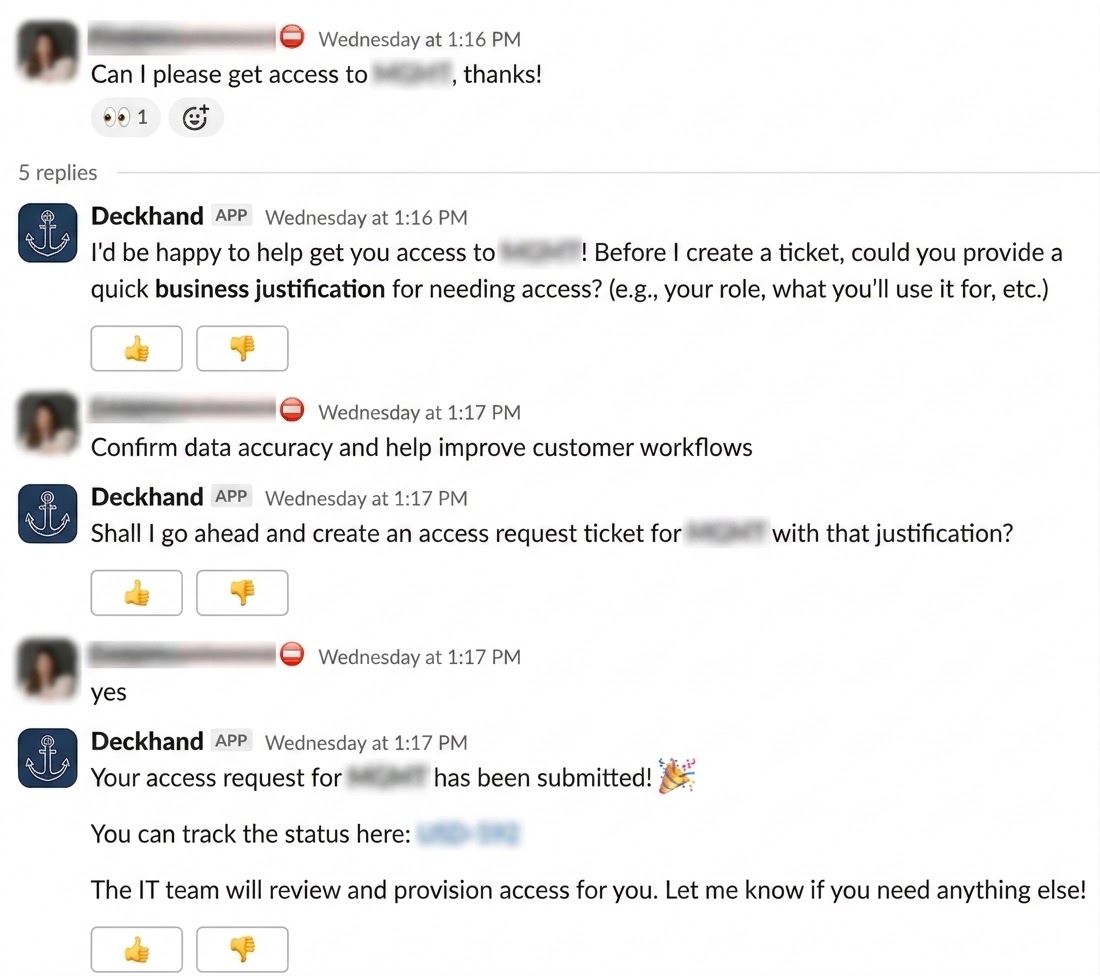
Figure 4 : Deckhand propose de créer un ticket
Flux de travail de Deckhand
Cette section décrit comment Deckhand est implémenté, des prérequis à un déploiement fonctionnel.
Prérequis
Pour implémenter ce modèle, vous avez besoin des éléments suivants :
- Un compte AWS avec accès à Amazon Bedrock, au runtime AgentCore et à AgentCore Gateway.
- Une application Slack avec des abonnements aux événements, un secret de signature et un jeton de bot adapté à votre cas d'usage.
- Un registre d'images de conteneurs tel qu'Amazon Elastic Container Registry (Amazon ECR).
- Un bucket Amazon S3 et une base de connaissances Amazon Bedrock.
- Des rôles AWS Identity and Access Management (IAM) adaptés à chaque runtime et outil, et des entrées AWS Secrets Manager pour les identifiants tiers.
Construction de l'agent avec Strands Agents et AgentCore
L'agent est volontairement léger. En utilisant le SDK open source Strands Agents SDK, un agent se compose d'un modèle, d'un ensemble d'outils et d'un prompt système. Le SDK gère la boucle de raisonnement, permettant au modèle de sélectionner des outils, de traiter les résultats et d'itérer jusqu'à produire une réponse. Le service d'agent de Deckhand est implémenté en quelques lignes de Python.
from strands import Agent
from strands.models import BedrockModel
from strands.tools.mcp import MCPClient
from strands_tools import retrieve
from mcp.client.streamable_http import streamablehttp_client

model = BedrockModel(
    model_id=MODEL_ID,
    max_tokens=2048,
    temperature=0.3,
)

gateway = MCPClient(lambda: streamablehttp_client(url=GATEWAY_URL))

agent = Agent(
    model=model,
    tools=[gateway, retrieve],
    system_prompt=SYSTEM_PROMPT,
)
L'ID du modèle est défini via une variable d'environnement, ce qui permet de changer de modèle sans modifier le code applicatif.
Les outils sont intégrés à l'agent de deux manières. La récupération via Amazon Bedrock Knowledge Bases est un outil natif de Strands qui prend en charge la recherche dans la base de connaissances avec un seul import. Les autres fonctions, notamment la classification, la gestion des tickets, la résolution des utilisateurs et l'analyse d'images, sont gérées par une fonction Lambda enregistrée sur AgentCore Gateway. Le Gateway les expose comme outils MCP, et la Lambda achemine chaque invocation par nom d'outil. Cette séparation permet de mettre à jour la logique des outils de manière indépendante, et l'agent peut accéder aux nouveaux outils du Gateway sans nécessiter de reconstruction.
Le runtime AgentCore héberge l'agent sous forme de conteneur, évitant la gestion de serveur ou de session. Le service Slack appelle l'agent de manière synchrone pour chaque message, en fournissant la transcription du fil et le contexte utilisateur, puis publie la réponse finale. Comme le contexte, y compris le profil de l'employé, est inclus dans chaque requête, l'agent peut compléter automatiquement les détails du ticket.
Conception de la base de connaissances et routage des réponses
Deckhand répond à partir d'une seule base de connaissances Amazon Bedrock avec des sources de données principales adossées à S3 :
- Articles synchronisés depuis Confluence.
- Pages internes, PDF et événements synchronisés depuis l'intranet de l'entreprise.
- Fils de support résolus extraits de Slack (abordés dans la section suivante).
Chaque document inclut des métadonnées telles que le titre, l'URL source, le type de contenu et les dates d'événements. Cela permet à l'agent de filtrer le contenu, par exemple lorsque les utilisateurs demandent des informations sur les événements à venir ou les menus du déjeuner hebdomadaires du bureau d'Austin.
Exploiter l'historique Slack avec les Recursive Language Models (RLMs)
La source de données la plus précieuse est l'archive des fils de support résolus. Avant que Deckhand n'existe, Slack était l'endroit où les problèmes étaient résolus : des années d'employés décrivant des incidents et l'équipe IT les guidant vers les correctifs. Cet historique est une base de connaissances organique, validée par le meilleur relecteur possible : la personne dont le problème a été résolu. Il est aussi bruité : un export brut mêle plaisanteries, alertes automatisées et fils qui n'ont jamais été réellement résolus. Indexer un correctif non vérifié ou un résumé confus signifie que la base de connaissances présente une réponse incorrecte avec la même confiance qu'une réponse correcte, donc l'extraction doit être précise.
Le processus d'exploitation suit un pipeline en trois étapes (Figure 5) :
- Un script exporte l'historique complet du canal via l'API Slack, récupérant les réponses complètes de chaque fil et écrivant un dump structuré qui inclut les marqueurs de fil, les horodatages et le nombre de réponses.
- Le Recursive Language Model (RLM) de DSPy, exécutant Claude sur Amazon Bedrock, traite cet export comme un espace mémoire navigable dans une boucle read-eval-print (REPL) Python sandboxée plutôt que comme une invite unique. En travaillant de manière itérative sur les données, il classe chaque fil comme résolu, non résolu ou escaladé et filtre les annonces et les messages qui ne sont pas des questions. Des critères stricts maintiennent une qualité élevée : un fil n'est considéré comme résolu que lorsque le correctif complet et fonctionnel est visible dans le fil lui-même.
- Pour chaque fil résolu, le RLM orchestre des appels récursifs de sous-LLM (grand modèle de langage) afin d'extraire des champs structurés, chacun validé par rapport à un modèle Pydantic. Les champs comprennent un résumé du problème, la question d'origine et la résolution. Ils capturent également si la correction est en libre-service ou nécessite un ticket, les étapes de libre-service, l'application et le système concernés, les messages d'erreur et les étiquettes. Lorsqu'un appel de sous-LLM renvoie un contenu qui ne respecte pas le schéma, la boucle basée sur le code du RLM intercepte l'erreur de validation dans l'interpréteur et réessaie. Les résultats sont écrits dans un document markdown organisé par problème. Le pipeline le téléverse sur Amazon S3 pour que la base de connaissances puisse l'indexer.
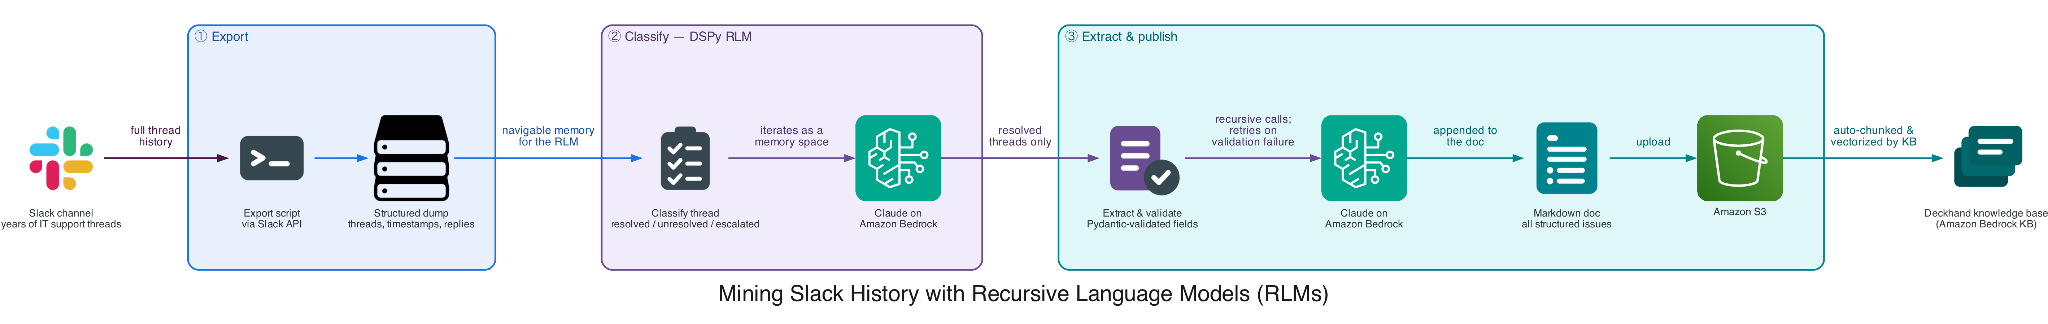
Figure 5 : flux de travail d'exportation, de classification et d'extraction de la conversation Slack
Nous avons choisi RLM parce qu'il conserve tout l'historique Slack dans un espace de variables persistant de type sandbox, ce qui permet un raisonnement itératif sur l'exportation et une structure de sortie cohérente. Ainsi, lorsqu'un employé rencontre un problème déjà résolu par un collègue, Deckhand fournit la solution éprouvée, souvent sous forme d'étapes numérotées exploitables.
Savoir quand ne pas répondre
Un bot IA dans un canal partagé échoue sur le plan social avant d'échouer sur le plan technique. La logique la plus aboutie de Deckhand décide quand rester silencieux :
- La première décision de l'agent pour chaque message est de déterminer s'il s'agit d'une annonce, d'un message social ou d'une conversation entre personnes. Si c'est le cas, il produit « SKIP », et le service Slack supprime la réponse.
- Dans les fils de discussion, il ne répond qu'à l'auteur du message d'origine.
- Si la dernière réponse provient d'un autre assistant humain, il reste silencieux, car une personne a pris le relais.
- Si une réponse commence par mentionner une personne avec @, le message ne s'adresse pas au bot.
Recueillir les commentaires
Chaque réponse inclut des boutons de feedback. Un pouce levé est enregistré directement, tandis qu'un pouce baissé invite à remplir brièvement un champ « qu'est-ce qui s'est mal passé ». Les évaluations sont stockées dans DynamoDB avec la question d'origine et la réponse du bot.
Les commentaires négatifs constituent un jeu de données précieux, utilisé pour améliorer le prompt système et le comportement de l'agent, ainsi que pour mettre à jour les informations incorrectes de la base de connaissances.
Sécurité et validation
Les règles de prompt améliorent le comportement mais ne remplacent pas les contrôles d'accès. L'application des règles est gérée par le code et l'infrastructure :
- La création de ticket nécessite une confirmation explicite. Lorsque Deckhand propose de créer un ticket, le service Slack ajoute un bouton Create Ticket , et sa sélection envoie la confirmation via l'agent. Les mises à jour de tickets n'acceptent que des clés valides correspondant au modèle du projet du service d'assistance et rejettent les commentaires vides.
- La classification est validée avant toute action. La classification des demandes s'exécute comme un appel séparé à l' Amazon Bedrock Converse API qui renvoie des champs de ticket structurés, validés avec Pydantic avant que quoi que ce soit n'atteigne Jira.
- L'outil d'images est limité au téléchargement depuis l'hébergeur de fichiers de Slack uniquement. Il s'authentifie avec le jeton du bot, limite chaque demande à cinq images de 5 Mo maximum chacune et envoie les fichiers à un modèle de vision via l'API Converse.
- Les identifiants restent hors du code. Les jetons Slack, le secret de signature et les identifiants Jira sont stockés dans AWS Secrets Manager, et chaque service et outil s'exécute sous son propre rôle IAM à périmètre limité.
- Le prompt impose des garanties comportementales : ne jamais demander de mots de passe ni de codes d'authentification multifacteur (MFA), ne jamais écrire d'identifiants dans les commentaires de tickets et ne jamais exposer les métadonnées de profil utilisées pour les champs de tickets.
Résultat
Deckhand a été lancé en avril 2026. Il a démarré à environ 30 messages par jour et a atteint jusqu'à 100 au début de l'été. Au cours de ses trois premiers mois, il a traité 1,935 messages, lancé 1,221 conversations d'agent et ouvert 409 tickets Jira. Il a répondu à 97.5 pour cent des messages. Un tiers des questions est arrivé en dehors des heures de travail, quand personne de l'équipe informatique ne travaillait, et Deckhand a répondu à 94 pour cent d'entre elles. Les personnes qui auraient attendu le lendemain matin ont obtenu une réponse dès le soir même.
Les commentaires se sont améliorés à mesure que l'équipe travaillait dessus. Les évaluations positives sont passées de 82 pour cent en avril à 96 pour cent en juin, après la révision du prompt système et de la base de connaissances pour corriger ce que les gens reprochaient.
La victoire la plus nette a été la déviation des tickets. Une conversation d'agent est une question qui serait autrement devenue un ticket Jira. Sur les 1,221 conversations, seules 409 se sont transformées en tickets. Les 812 autres ont été traitées dans le chat. Le dépôt d'un ticket, puis son traitement et sa clôture prennent environ 30 minutes. Ces 812 conversations représentent environ 406 heures sur trois mois, soit environ 1,600 heures par an. Les employés ont gardé ce temps pour leur propre travail, et l'informatique ne l'a jamais consacré à la prise de demandes.
Conclusion
Deckhand a soustrait les questions informatiques répétitives de l'assiette des employés et rendu du temps aux employés comme à l'équipe informatique. Cela fonctionne parce que chaque partie de la pile a une seule tâche et s'exécute en tant que service géré : AgentCore runtime héberge l'agent, AgentCore Gateway transforme une fonction Lambda en outils MCP que l'agent peut appeler, et Amazon Bedrock Knowledge Bases gère la récupération. L'équipe l'a livré sans déployer de serveurs ni maintenir de code d'orchestration.
Pour créer une solution similaire, commencez par une source de connaissances bien maintenue et une action clairement définie. Reportez-vous à la documentation d'Amazon Bedrock AgentCore et au Strands Agents SDK pour le développement d'agents, ainsi qu'à la documentation d'Amazon Bedrock Knowledge Bases pour connecter des sources de contenu.
Pour discuter d'un cas d'usage d'IA agentique pour votre organisation, contactez votre équipe de compte AWS.