
Grok 4.7 de SpaceXAI est désormais disponible sur Amazon Bedrock, qui offre un choix de modèles de fondation (FM) provenant de plusieurs fournisseurs. Selon SpaceXAI, Grok 4.7 est entraîné pour travailler plus longtemps sur des tâches plus difficiles et sait quand vérifier son propre travail. C'est ce qui compte le plus pour les agents, qui mènent une tâche à travers de nombreuses étapes et doivent vérifier ce qu'ils découvrent en chemin.
Un agent qui travaille de cette manière doit faire plus que simplement rechercher des informations. Il doit former une réponse candidate, la vérifier par rapport à ce qu'il a appris, et la raffiner jusqu'à ce qu'elle convienne. Grok 4.7 expose un paramètre d'effort de raisonnement qui contrôle l'ampleur de la délibération avant chaque réponse, et pour les charges de travail d'agents, une question pratique est de savoir quel niveau utiliser.
Dans cet article, nous créons un agent capable d'appeler des outils sur Grok 4.7 et l'évaluons sur trois tâches qui nécessitent une recherche plutôt qu'une simple consultation. Les tâches consistent à diagnostiquer une panne touchant deux services à partir de ses alertes, à planifier une maintenance sous des contraintes qui interagissent, et à choisir un ensemble optimal de migrations sous un budget. Chaque tâche a exactement une seule réponse correcte, vérifiée par force brute. Nous avons exécuté les trois tâches à chaque niveau d'effort de raisonnement, six fois chacune, soit 72 exécutions d'agent.
L'agent a répondu correctement dans 67 des 72 exécutions. À xhigh il a répondu correctement aux 18, et à low il a répondu correctement à 15 sur 18 tout en utilisant environ un huitième des jetons de sortie. Cela donne un compromis clair que vous pouvez ajuster par requête, et nous montrons comment le mesurer sur vos propres tâches et comment le surveiller en production.
Nous rapportons des comptes de jetons plutôt que des montants en devise tout au long de l'article. Les prix des jetons changent, et les comptes sont ce à partir de quoi vos propres coûts sont calculés, donc une mesure exprimée en jetons reste valide.
Ce que SpaceXAI rapporte à propos de Grok 4.7
Selon SpaceXAI, Grok 4.7 utilise un modèle de base plus grand que Grok 4.6 et a été entraîné avec une exécution d'apprentissage par renforcement plus longue sur un mélange de tâches plus difficile. Ce mélange est pondéré vers des problèmes qui prennent de nombreuses heures à résoudre. SpaceXAI rapporte que le modèle est meilleur pour vérifier son propre travail et pour gérer un contexte plus long.
Les résultats de référence publiés par SpaceXAI suivent cette orientation. Les plus grands gains rapportés par rapport à Grok 4.6 apparaissent dans les catégories qui mesurent un travail soutenu plutôt que des réponses en un seul tour.
| Référence | Catégorie | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | Travail en terminal sur plusieurs heures | 20.3% | 37.6% |
| EEBench | Génie électrique | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | Travail juridique | 15.8% | 19.6% |
| CursorBench 4.0 | Programmation de longue durée | 40.4% | 46.3% |
| HealthBench Professional | Raisonnement clinique | 48.5% | 56.7% |
| AA Briefcase v1.1 | Travail de bureau sur plusieurs heures | 1,546 | 1,657 |
Source : SpaceXAI, Introducing Grok 4.7 (https://x.ai/news/grok-4-7). Les scores sont ceux publiés par SpaceXAI au moment du lancement du modèle.
Les benchmarks montrent les performances d'un modèle sur des tâches standard. Pour votre propre charge de travail, l'étape utile suivante consiste à mesurer sur des tâches semblables aux vôtres, et c'est ce que le reste de cet article vous guide pour faire.
SpaceXAI indique une fenêtre de contexte de 500K tokens pour Grok 4.7, avec une entrée texte et image et une sortie texte. Sur Amazon Bedrock, le modèle prend en charge un effort de raisonnement configurable, l'appel d'outils et la sortie structurée.
Comment accéder à Grok 4.7 sur Amazon Bedrock
Grok 4.7 s'exécute sur le bedrock-runtime point de terminaison et est accessible via un profil d'inférence multi-régions . Deux profils sont disponibles :
| Profil d'inférence | Routage | À utiliser lorsque |
| us.xai.grok-4.7 | Au sein de la zone géographique des États-Unis | Vous avez des exigences de résidence des données aux États-Unis |
| global.xai.grok-4.7 | Régions AWS commerciales | Vous n'avez aucune contrainte de résidence et vous souhaitez la plus large capacité |
L'inférence multi-régions achemine les requêtes à travers plusieurs régions AWS, ce qui vous offre un débit plus élevé sans avoir à gérer la capacité région par région. Les requêtes désignent l'un des profils d'inférence plutôt qu'un identifiant de modèle simple.
Le modèle prend en charge les API Chat Completions et Responses compatibles avec OpenAI, ainsi que l'API Amazon Bedrock Converse. Sur Converse, le raisonnement est renvoyé sous forme de reasoningContent bloc à côté du text bloc. Dans inferenceConfig, défini maxTokens seulement, et placez les paramètres propres au modèle, tels que l'effort de raisonnement, dans additionalModelRequestFields.
Pour la liste actuelle des Régions prises en charge, des niveaux de service et des prix des tokens, consultez la fiche technique du modèle Grok 4.7 dans le Guide de l'utilisateur Amazon Bedrock et la page de tarification d'Amazon Bedrock (https://aws.amazon.com/bedrock/pricing/).
Prérequis
- Un compte AWS avec accès à Amazon Bedrock, et l'accès aux modèles activé pour Grok 4.7.
- Python 3.9 ou version ultérieure, avec
openai,boto3, etaws-bedrock-token-generatorinstallés. - Identifiants AWS configurés dans votre environnement.
Votre identité AWS Identity and Access Management (IAM) a besoin de bedrock:InvokeModel à la fois sur le profil d'inférence et sur le projet par défaut de votre compte :
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7ou songlobal.équivalent.arn:aws:bedrock:{region}:{account-id}:project/default.
Incluez les deux ressources dans la déclaration de politique. L'autorisation sur le projet par défaut est requise en plus de celle sur le profil d'inférence.
Se connecter au modèle
Pour une utilisation en production, nous recommandons de générer un jeton porteur de courte durée à partir de vos identifiants AWS existants, afin que l'authentification reste liée à votre identité IAM et qu'aucun secret de longue durée ne soit stocké :
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
Les jetons de raisonnement comptent comme des jetons de sortie et consomment max_completion_tokens avant que le texte de la réponse ne soit produit, donc dimensionnez la limite de manière à laisser de la place pour les deux. Si la limite est atteinte pendant le raisonnement, la réponse est renvoyée sans texte de réponse, vérifiez donc la présence de contenu vide dans le code de l'agent et augmentez la limite si vous le constatez. Nos exécutions ont utilisé une limite de 32,768 tokens, ce qui laissait une marge à chaque niveau d'effort.
Grok 4.7 prend en charge quatre niveaux d'effort : low, medium, high, et xhigh. Les niveaux d'effort peuvent changer d'une version de modèle à l'autre, il vaut donc la peine de les vérifier auprès du service plutôt que de coder en dur une liste :
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
Des tâches de conception qui nécessitent du raisonnement
De nombreuses évaluations d'agents testent la rigueur : lire un enregistrement, le filtrer, en faire la somme. Ces tâches sont utiles, mais pour voir ce qu'apporte l'effort de raisonnement, une tâche doit exiger une recherche : la réponse ne peut pas être lue directement dans les données, elle doit être proposée puis vérifiée.
Nous avons construit un environnement synthétique de 20 services, exposés au travers de sept outils, et trois tâches par-dessus. Chaque tâche a exactement une seule réponse correcte, et chacune est conçue pour qu'une heuristique rapide ne suffise pas à la trouver.
| Tâche | Ce que l'agent doit faire | Ce qui en fait une tâche de raisonnement |
| two_fault_diagnosis | Deux services sont tombés en panne silencieusement à 03:00 et 12 autres ont émis des alertes. Identifier les deux qui sont tombés en panne | Les services en panne ne déclenchent aucune alerte, donc la réponse ne figure pas parmi les services d'alerte. 190 paires possibles, et une seule explique exactement les alertes observées |
| maintenance_schedule | Mettre à jour huit services sur quatre nuits, deux par nuit, sous dix contraintes et une règle selon laquelle deux services d'une même équipe ne partagent jamais une même nuit | 2,520 plannings possibles, un seul valide. La règle d'équipe dépend de données que l'agent doit consulter |
| migration_budget | Choisir les candidats à migrer qui maximisent la réduction des risques dans un budget donné, y compris les prérequis transitifs | 53 ensembles faisables, un seul optimal. Choisir d'abord le meilleur ratio donne un ensemble inférieur de neuf points à l'optimum |
Quatre pratiques maintiennent la fiabilité d'une mesure comme celle-ci, et elles s'appliquent à la plupart des évaluations d'agents.
Énoncer chaque règle sur laquelle s'appuie le correcteur. Si l'invite laisse un cas particulier ouvert, une réponse raisonnable peut être notée comme erronée, et l'évaluation finit par mesurer la spécification plutôt que le modèle. L'invite de diagnostic, par exemple, indique explicitement qu'un service en panne ne déclenche aucune alerte propre.
Prouver que chaque tâche a une seule réponse. Chaque environnement est suffisamment petit pour être énuméré, nous avons donc vérifié chaque réponse candidate avant toute exécution. Pour le planning, cela tient en quelques lignes :
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1  # the rule matters
Noter une ligne finale obligatoire, et non la réponse entière. Chaque invite demande à l'agent de terminer par une ligne telle que FINAL: auth, checkout. Le correcteur ne lit que cette ligne, de sorte qu'une réponse qui discute d'autres candidates tout en expliquant son raisonnement est notée sur sa conclusion :
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
    return lines[-1] if lines else None
Suivre le format séparément de l'exactitude. Une ligne finale manquante est un signal différent d'une ligne incorrecte. Dans nos exécutions, les 72 réponses comprenaient une ligne finale évaluable.
Contraindre les paramètres d'outils avec un enum lorsque les valeurs valides sont connues, afin que chaque appel d'outil cible une ressource réelle :
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
Le prompt système est volontairement court et demande à l'agent de vérifier sa réponse avant de la donner :
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
La boucle de l'agent est une boucle standard d'appels d'outils : appeler le modèle avec le reasoning_effort défini, exécuter chaque appel d'outil renvoyé, ajouter le résultat associé à la clé tool_call_id, et répéter jusqu'à ce que le modèle cesse de demander des outils. Le suivi du prompt_tokens et du completion_tokens au fil de la boucle fournit les décomptes de tokens présentés dans la section suivante.
Résultats
Six exécutions de chaque tâche à chaque niveau d'effort, 72 exécutions au total. L'agent a répondu correctement 67 fois.
| Tâche | low | medium | high | xhigh |
| two_fault_diagnosis | 5 sur 6 | 6 sur 6 | 6 sur 6 | 6 sur 6 |
| maintenance_schedule | 5 sur 6 | 5 sur 6 | 5 sur 6 | 6 sur 6 |
| migration_budget | 5 sur 6 | 6 sur 6 | 6 sur 6 | 6 sur 6 |
| Les trois tâches | 15 sur 18 | 17 sur 18 | 17 sur 18 | 18 sur 18 |
| Par exécution | faible | moyen | élevé | très élevé |
| Nombre moyen de tokens de sortie | 1,184 | 6,430 | 6,778 | 9,147 |
| Tokens de sortie par rapport à faible | 1.0x | 5.4x | 5.7x | 7.7x |
| Nombre moyen d'appels d'outils | 17.2 | 18.7 | 17.8 | 18.1 |
| Temps écoulé médian | 18 s | 98 s | 89 s | 106 s |
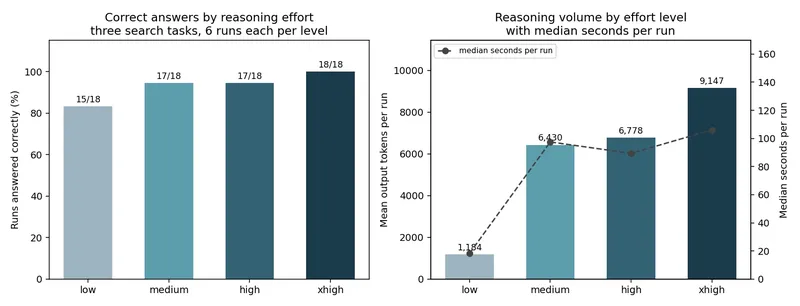
Figure 1 : Part des exécutions résolues correctement à chaque niveau d'effort de raisonnement (à gauche), et nombre moyen de tokens de sortie par exécution avec les secondes médianes par exécution superposées (à droite)
Trois observations.
xhigh a répondu correctement à chaque exécution. Les 18 exécutions réparties sur les trois tâches ont été correctes à xhigh, et medium et high a répondu correctement à 17 des 18 à chaque fois. Avec six exécutions par tâche et par niveau, les différences entre les niveaux sont indicatives plutôt que statistiquement concluantes, et la direction était cohérente sur les trois tâches.
L'effort modifie la quantité de raisonnement de l'agent, pas sa capacité d'exploration. Les appels d'outils sont restés essentiellement stables, entre 17.2 et 18.7 par exécution à chaque niveau. L'agent a recueilli les mêmes faits quel que soit l'effort, et ce qui a changé, c'est la quantité de raisonnement qu'il y a appliqué, avec des tokens de sortie passant de 1,184 à low à 9,147 à xhigh.
low offre un excellent rapport coût-qualité. À low, l'agent a répondu correctement à 15 des 18 exécutions en utilisant environ un huitième des tokens de sortie de xhigh, avec une exécution médiane de 18 secondes. Lorsqu'un taux de complétion légèrement inférieur est acceptable, ou lorsque les réponses sont revues en aval, low est un choix efficace. Lorsque chaque réponse doit être correcte du premier coup, les niveaux supérieurs constituent le choix par défaut le plus sûr.
Comment le niveau d'effort façonne la réponse
Les tâches ont été conçues autour d'un type de difficulté spécifique, et l'examen de la façon dont chaque niveau d'effort les a traitées clarifie quand le raisonnement supplémentaire en vaut la peine.
Optimisation. La tâche de migration récompense la prise en compte de combinaisons plutôt que le classement des options une par une. Sélectionner les candidats ayant les meilleurs ratios individuels produit une réponse raisonnable qui est inférieure de neuf points à l'optimum. À medium et au-dessus, l'agent a trouvé l'ensemble optimal dans les 18 exécutions.
Test d'hypothèses. La tâche de diagnostic exige de vérifier une paire de candidats dans les deux sens : chaque alerte doit être expliquée, et chaque service resté silencieux doit être cohérent avec la réponse. À medium et au-dessus, l'agent a identifié la bonne paire dans les 18 exécutions.
Satisfaction de contraintes. La tâche de planification combine dix contraintes listées avec une règle d'équipe qui dépend de données de propriété recherchées. xhigh a produit le planning valide à chaque exécution, et c'était la tâche où le niveau le plus élevé a fait la différence la plus nette.
Le schéma qui se dégage des trois est que l'effort de raisonnement supplémentaire est le plus précieux lorsque l'agent doit peser plusieurs réponses candidates l'une contre l'autre, plutôt que de suivre un chemin unique vers le résultat.
Surveiller le raisonnement en production
En production, vous n'avez pas de réponse connue à laquelle comparer, mais vous savez combien de tokens de sortie et d'appels d'outils chaque exécution a utilisés. Cela vous donne un signal opérationnel utile.
Les exécutions correctes à chaque niveau restent au-dessus d'un plancher clair de volume de raisonnement. Chaque exécution correcte à medium et au-dessus a utilisé au moins 1,739 tokens de sortie, et une exécution typique en a utilisé plusieurs milliers. Une exécution qui ne fait aucun appel d'outil, ou qui produit beaucoup moins de sortie que la normale pour son niveau, mérite d'être signalée pour examen :
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
Étalonnez la référence à partir des exécutions que vous avez notées, par tâche et par niveau d'effort, puis appliquez-la aux exécutions que vous n'avez pas notées. Considérez un signalement comme une invitation à inspecter ou à relancer. À low, où chaque exécution est brève, le volume de sortie est un signal plus faible, associez-le donc à des contrôles ponctuels.
Demander à l'agent de vérifier sa réponse dans le prompt système vaut la peine d'être conservé, car cela rend le raisonnement de l'agent facile à suivre lorsque vous examinez une exécution. Associez-le à une notation automatisée chaque fois qu'une réponse connue existe, afin que la qualité soit mesurée indépendamment de la transcription.
Choisir un effort de raisonnement
Ces résultats suggèrent quelques règles pratiques.
Adaptez l'effort au type de tâche. Les tâches qui impliquent une recherche, une optimisation ou le test d'une hypothèse bénéficient le plus de medium ou plus. Les tâches qui suivent un chemin unique, ou dont les réponses sont examinées en aval, peuvent fonctionner efficacement à low.
Définissez l'effort par requête, pas par agent. L'effort est un paramètre de requête, ainsi un agent peut exécuter ses étapes de planification et de vérification à un niveau supérieur et ses étapes mécaniques, comme le formatage d'un résultat d'outil, à low. Cela combine une grande partie de la fiabilité d'un niveau supérieur avec un coût en tokens inférieur.
Mesurez sur vos propres tâches, avec des répétitions. Une seule exécution par configuration donne une seule observation. Répéter chaque configuration plusieurs fois montre à quel point elle est constante.
Surveillez le volume de raisonnement. Les tokens de sortie et les appels d'outils par exécution, suivis par niveau d'effort, vous donnent un signal précoce pour examiner une exécution avant que son résultat ne soit utilisé.
Limites de cette mesure
Six exécutions par tâche et par niveau d'effort. Assez pour montrer une direction cohérente sur trois tâches, pas assez pour un intervalle de confiance. Considérez les différences entre les niveaux comme indicatives.
Un environnement synthétique. Les outils lisent des données générées dans le code, ce qui permet de prouver que chaque tâche a exactement une réponse et d'évaluer automatiquement. Les outils réels ajoutent de la latence, des résultats partiels et des erreurs, aucun de ces aspects n'étant testé ici.
Des minutes, pas des heures. Le temps d'exécution médian variait de 18 secondes à low à 106 secondes à xhigh. Il s'agit d'un proxy à échelle réduite du travail à long terme. La méthode se transfère. Les chiffres absolus, non.
Une version de modèle, une Région, une invite par tâche. Des formulations différentes d'une même tâche peuvent modifier les résultats, ce qui explique en partie pourquoi il importe d'énoncer explicitement chaque règle.
Des comptages de tokens, pas des coûts. Pour convertir en monnaie, appliquez les tarifs actuels de votre profil d'inférence et de votre niveau de service depuis la page de tarification d'Amazon Bedrock. Les profils Global et US Geo sont tarifés différemment, et les niveaux de service Flex et Priority appliquent des multiplicateurs.
Contrôles opérationnels pour les charges de travail d'agents
Intégrez des tentatives de nouvelle tentative. Les agents qui émettent un volume élevé d'appels devraient traiter les nouvelles tentatives comme faisant partie de la conception. Définissez un délai d'expiration de requête, ne retentez que les erreurs retentables, appliquez un backoff exponentiel avec gigue et honorez un en-tête Retry-After lorsqu'il est renvoyé :
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
Le débit à la demande augmente avec le temps, donc montez progressivement en charge une nouvelle charge de travail à volume élevé plutôt que de démarrer au débit maximal.
Auditer une exécution. La journalisation des invocations de modèle écrit les données de requête et de réponse dans Amazon Simple Storage Service (Amazon S3) ou Amazon CloudWatch Logs. Cela vous donne la transcription complète des exécutions que vous souhaitez examiner a posteriori.
Surveiller le volume de raisonnement à grande échelle. Les métriques Amazon CloudWatch vous donnent une vue agrégée de l'utilisation des tokens, ce qui permet de transformer les références par niveau décrites précédemment en éléments sur lesquels vous pouvez déclencher des alarmes.
Attribuer les dépenses entre les agents. L'atomisation des coûts dans AWS Cost Explorer et le rapport AWS Cost and Usage Report détaille l'utilisation par modèle, ce qui, combiné aux comptages de tokens par tâche, vous donne à la fois l'économie unitaire et la facture globale.
Adapter le coût à l'urgence. Les niveaux de service sont définis par requête, ainsi un même déploiement peut envoyer une analyse de nuit via le niveau Flex et une requête interactive via Priority. Pour une charge de travail s'exécutant à un niveau d'effort plus élevé, le choix du niveau constitue un levier supplémentaire sur le coût.
Choisir un profil de routage. L'inférence inter-Régions élargit le pool de capacité sur lequel une longue exécution s'appuie. Le profil Global sert depuis la Région AWS commerciale de votre choix et est généralement facturé moins cher par token que le routage géographique. Le profil US maintient le traitement aux États-Unis. Choisissez en fonction de vos exigences de résidence des données ainsi que du coût.
Nettoyage
Les exemples de cet article ne créent pas de ressources AWS facturables au-delà de l'utilisation de tokens par requête. Si vous avez généré une clé API Amazon Bedrock à long terme, supprimez-la dans la console Amazon Bedrock une fois terminé, car elle reste valide jusqu'à sa révocation. Les tokens à court terme générés à partir d'informations d'identification IAM expirent d'eux-mêmes.
Si vous avez activé la journalisation des invocations de modèle vers Amazon S3 pendant vos tests, examinez le bucket et supprimez les objets dont vous n'avez plus besoin.
Conclusion
SpaceXAI a entraîné Grok 4.7 à travailler plus longtemps sur des tâches plus difficiles et à savoir quand vérifier son propre travail. Sur trois tâches nécessitant une recherche plutôt qu'une simple consultation, l'agent a répondu correctement dans 67 des 72 exécutions, et chaque exécution à xhigh. Comme le niveau d'effort de raisonnement est défini par requête, vous pouvez choisir où chaque étape d'un agent se situe sur le compromis entre exhaustivité et coût en tokens.
Trois points méritent d'être retenus pour votre propre évaluation. Concevez des tâches avec une seule réponse prouvable et énoncez chaque règle dont l'évaluateur dépend. Répétez les exécutions, afin de voir la cohérence de chaque configuration. Et surveillez les tokens de sortie et les appels d'outils par niveau d'effort, afin d'avoir un signal opérationnel en complément de vos mesures de qualité.
Pour aller plus loin
- Introducing Grok on Amazon Bedrock
- Grok 4.7 est désormais disponible sur Amazon Bedrock
- Router les requêtes d'inférence de modèle à travers les Régions AWS avec l'inférence inter-Régions
- Premiers pas avec Amazon Bedrock
- Chat Completions API
- Tarification d'Amazon Bedrock
- Présentation de Grok 4.7 (SpaceXAI)