
Les analystes de sécurité ont besoin de réponses rapides sur leur infrastructure cloud sans maîtriser en profondeur des langages de requête spécifiques à un domaine. Orca SecurityL’outil couvre plus de 900 modèles de cloud (les types de ressources que Sonar suit, comme une instance Amazon Elastic Compute Cloud (Amazon EC2) ou un bucket Amazon Simple Storage Service (Amazon S3)). L’interrogation de ces données exigeait des noms de modèles précis, une navigation dans des relations imbriquées et un choix parmi 18 opérateurs (des fonctions de comparaison comme equals ou contains utilisées pour filtrer les résultats).
Pour résoudre ce problème, Orca Security s’est associé à AWS pour créer Discovery AI, un agent de requêtes en langage naturel sur Amazon Bedrock. Orca fournit une sécurité contextuelle pour le cloud, le code et l’IA, et Sonar est son système de requêtes spécifique au domaine où les utilisateurs recherchent, filtrent et explorent l’ensemble du graphe de données.
Dans cet article, nous partageons l’architecture et les résultats de Discovery AI, qui convertit une question en langage naturel en une requête Sonar. Ainsi, Orca a réduit les coûts de requête de 90 %, les tokens d’entrée de 93 % et la latence de 75 % par rapport à la référence initiale.
Faire le pont entre le langage naturel et les requêtes structurées
Le système de requêtes Sonar d’Orca Security prend en charge plus de 900 modèles d’infrastructure et d’applications cloud avec des relations complexes entre eux. Pour interroger ces données, les utilisateurs construisent des objets JSON qui spécifient des noms de modèles exacts, sélectionnent parmi 18 opérateurs et parcourent des hiérarchies parent-enfant entre fournisseurs de cloud. Bien faire cela nécessite une connaissance approfondie du schéma Sonar.
Pour créer cette capacité, l’équipe Orca s’est lancée dans la construction d’une interface en langage naturel capable de générer des requêtes Sonar valides à partir de texte brut.
Leur première preuve de concept chargeait l’intégralité du schéma Sonar dans une seule invite sur le plus grand modèle disponible. Cela incluait plus de 900 définitions de modèles, chaque type de relation et un large ensemble de requêtes d’exemple. La qualité des résultats était bonne (les partenaires de conception et les utilisateurs internes ont réagi positivement), mais trois inconvénients importants sont apparus à l’échelle de la production.
La consommation de tokens était inefficace, avec environ 2 millions de tokens d’entrée par charge de travail, ce qui augmentait les coûts. La latence était élevée, avec des temps de réponse de bout en bout d’environ 60 secondes par charge de travail. La précision sur les requêtes complexes multi-modèles était limitée, car les relations imbriquées et les requêtes à conditions multiples nécessitaient souvent un affinage supplémentaire.
L’équipe Orca a validé que le concept fonctionnait. Le défi suivant était de le rendre assez rentable, rapide et précis pour la production. Pour y parvenir, l’équipe Orca a conçu et déployé une solution qui traite des milliers de requêtes par jour avec des temps de réponse de 15 secondes en utilisant Amazon Bedrock.
Présentation de la solution
Orca a conçu Discovery AI comme une solution hybride sur Amazon Bedrock qui combine la génération augmentée par récupération (RAG) avec une construction de requêtes consciente du schéma. Le système convertit les questions en langage naturel en filtres Discovery valides grâce à un pipeline multi-étapes, chaque étape étant associée au modèle Amazon Bedrock le plus approprié.
Orca a choisi Amazon Bedrock car il offre un accès multi-modèles via une seule API, permettant à l’équipe d’allouer différents modèles de fondation à chaque étape du pipeline sans gérer d’intégrations séparées. Amazon Bedrock hérite également des contrôles de gouvernance AWS via AWS Identity and Access Management (IAM), les points de terminaison de cloud privé virtuel (VPC) et AWS CloudTrail, répondant aux exigences de sécurité d’Orca. L’architecture indépendante des modèles signifiait que l’équipe pouvait remplacer par des versions de modèles plus récentes dès leur disponibilité sans réarchitecturer le pipeline.
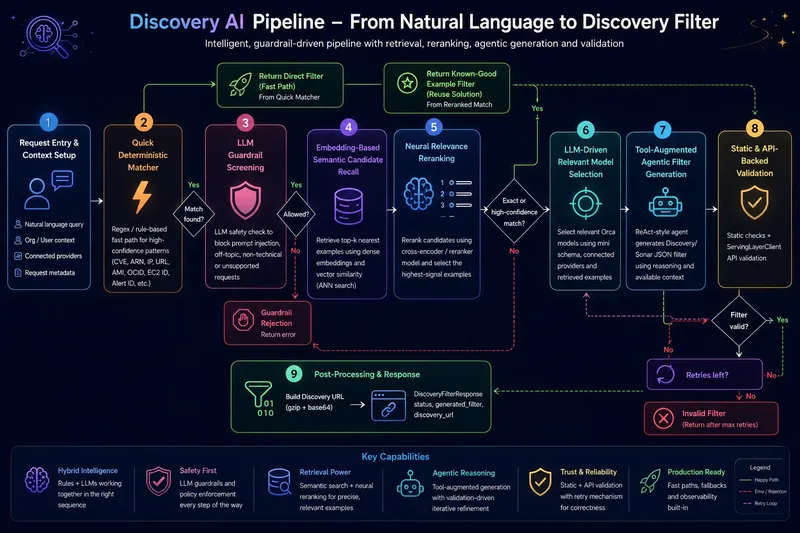
Le diagramme suivant illustre l’architecture du pipeline à neuf étapes.
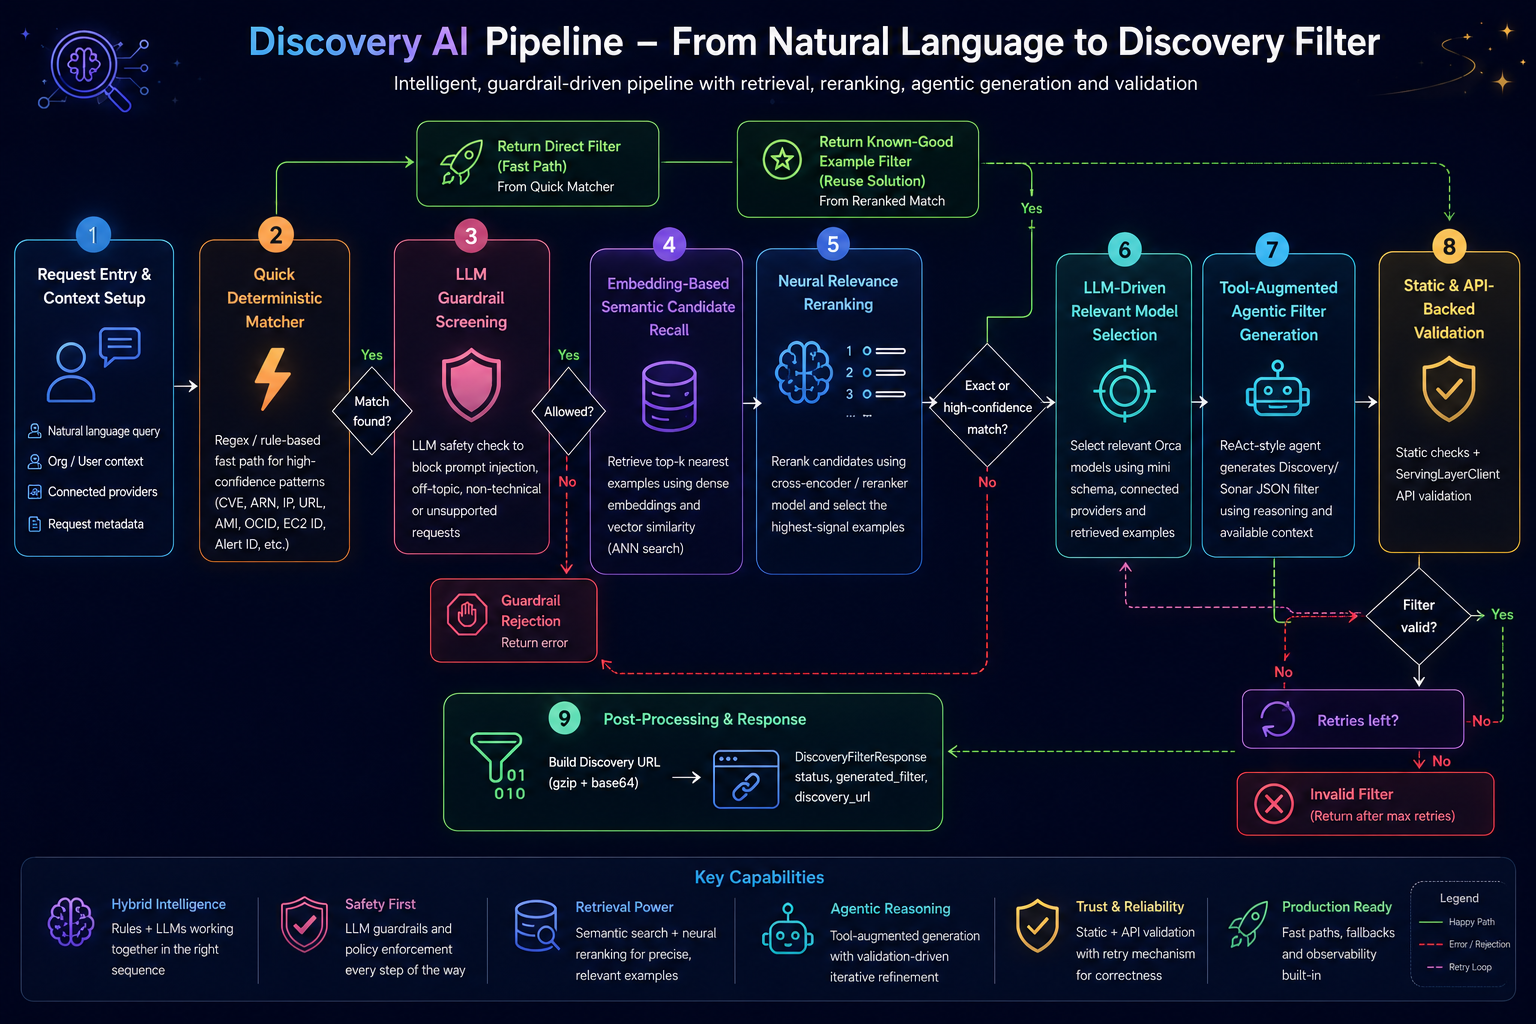
Figure 1 : Architecture du pipeline Discovery AI multi-étapes montrant le flux depuis l’entrée en langage naturel jusqu’aux requêtes de filtres Discovery validées à l’aide de modèles de fondation sur Amazon Bedrock
Le pipeline Discovery AI convertit une requête en langage naturel en un filtre Discovery validé en neuf étapes.
- Entrée de requête et configuration du contexte : le pipeline commence par combiner la requête en langage naturel de l’utilisateur avec le contexte pertinent, notamment l’organisation de l’utilisateur, les fournisseurs de cloud connectés et les métadonnées de la requête. Ce contexte aide le pipeline à interpréter la requête avec précision et à générer un filtre Discovery correspondant à l’environnement du client.
- Correspondance déterministe rapide : le Quick Matcher identifie les entrées structurées telles que les adresses IP, les Common Vulnerabilities and Exposures (CVE), les ARN, les hachages de fichiers, les identifiants Amazon Machine Image, les Oracle Cloud Identifiers, les identifiants EC2, les URL et les identifiants d’alerte. Il utilise des expressions régulières et une correspondance basée sur des règles pour détecter des motifs à haute confiance. Lorsqu’une correspondance est trouvée, le pipeline peut renvoyer un filtre Discovery prédéfini via un chemin rapide, sans utiliser d’inférence de grand modèle de langage (LLM). Lorsqu’aucune correspondance n’est trouvée, la requête passe à l’étape suivante.
- Filtrage par garde-fous LLM : le composant Guardrail vérifie si la requête est sûre, pertinente, technique et prise en charge. Il bloque les tentatives d’injection d’invite, les requêtes hors sujet et les entrées non prises en charge avant qu’elles n’atteignent le reste du pipeline. Les requêtes qui échouent aux vérifications des garde-fous sont rejetées avec une erreur appropriée. Les requêtes approuvées passent à la récupération d’exemples.
- Rappel de candidats sémantique basé sur les embeddings : le pipeline recherche des exemples de requêtes précédemment validées et pertinents à l'aide des Amazon Titan Text Embeddings. Il récupère les 20 exemples les plus proches du magasin de vecteurs en fonction de la similarité sémantique. Ces candidats fournissent au pipeline des exemples de la façon dont des requêtes en langage naturel similaires ont été précédemment traduites en filtres Discovery.
- Reclassement de pertinence neuronal : les candidats récupérés sont reclassés à l'aide de Cohere Rerank 3.5 sur Amazon Bedrock. Il identifie les exemples les plus pertinents par rapport à la requête actuelle et sélectionne les cinq exemples au signal le plus fort. Lorsqu'une correspondance exacte ou à haute confiance est trouvée, le pipeline peut réutiliser directement le filtre connu comme fiable. Sinon, les exemples reclassés sont transmis aux étapes génératives.
- Sélection de modèles pertinents pilotée par LLM : la sélection de modèles réduit plus de 900 modèles Sonar au petit ensemble pertinent pour la requête. Elle prend en compte la requête de l'utilisateur, les fournisseurs connectés et les exemples récupérés lors de la sélection des modèles appropriés. Les modèles sélectionnés sont fournis au Generator en utilisant le niveau de schéma approprié, allant de micro-schémas compacts à des mini-schémas plus détaillés. Cela réduit le contexte inutile et rend la génération plus efficace.
- Génération de filtres agentique augmentée par outils : le Generator utilise un agent augmenté par outils pour construire le filtre Discovery final. Il raisonne sur les schémas des modèles sélectionnés, les exemples récupérés, le contexte utilisateur et les outils disponibles. L'agent peut affiner itérativement le filtre au fur et à mesure qu'il travaille vers une représentation valide de la requête de l'utilisateur.
- Validation statique et par API : le filtre généré est vérifié pour son exactitude syntaxique et sémantique. Le pipeline applique d'abord une validation statique, puis vérifie le filtre auprès de l'API Sonar d'Orca. Lorsque la validation échoue, l'erreur de validation est renvoyée au Generator afin que l'agent puisse corriger le filtre et réessayer. Si le nombre maximal de tentatives est atteint sans produire de filtre valide, le pipeline renvoie une réponse de filtre invalide. Le Generator est contraint aux exemples reclassés et aux schémas sélectionnés. La validation statique rattache chaque modèle, champ et opérateur à ces définitions de schéma. Chaque erreur de validation est renvoyée à l'agent avec l'élément en cause identifié, de sorte que les tentatives reposent sur des bases plutôt que de deviner à nouveau.
- Post-traitement et réponse : après qu'un filtre valide a été produit, que ce soit via le Quick Matcher, la réutilisation d'un exemple connu comme fiable ou une génération agentique, le pipeline prépare la réponse finale. L'équipe a alloué différents modèles de fondation sur Amazon Bedrock aux composants en fonction des exigences de chaque étape. Anthropic Claude Haiku 4.5 alimente le Model Selector et le Generator. Ces composants nécessitent un raisonnement puissant pour une construction de requête précise. Amazon Nova 2 Lite gère le Guardrail et le Validator, où l'inférence rapide à moindre coût est priorisée. Amazon Titan fournit les embeddings pour la recherche sémantique dans le composant Example Retrieval. Cohere Rerank 3.5 reclasse les candidats récupérés pour maximiser la pertinence. Pour la disponibilité des modèles par région AWS, consultez disponibilité régionale par modèles.
Maximiser la pertinence et la diversité dans la récupération d'exemples
La récupération d'exemples s'est révélée être le plus grand levier de précision du pipeline. De bons exemples apprennent au Generator comment traduire les questions en requêtes Sonar plus efficacement que les schémas seuls ; l'équipe Orca a donc évalué plusieurs stratégies de récupération sur Amazon Bedrock. Chaque stratégie faisait des compromis différents entre pertinence, diversité ou vitesse, et leur comparaison directe a montré quelle combinaison fonctionnait le mieux.
La recherche sémantique pure en top-K sur les embeddings Amazon Titan était rapide, mais elle avait tendance à renvoyer des exemples quasi dupliqués qui privaient le Generator de diversité. La Maximal Marginal Relevance (MMR) a amélioré la diversité, mais elle faisait un compromis sur la pertinence lorsque le meilleur candidat était en fait la bonne réponse. Récupérer un ensemble de candidats plus vaste puis le reclasser permettait d'attirer un pool plus large et d'utiliser un reclasser pour sélectionner le sous-ensemble le plus pertinent, ce qui pointait vers l'approche gagnante.
Le gagnant fut la récupération des 20 plus proches voisins en utilisant les embeddings Amazon Titan. Orca a ensuite reclassé ces résultats avec Cohere Rerank 3.5 pour ne garder que les cinq premiers. Cette approche donne au Generator un petit ensemble d'exemples diversifié et hautement pertinent sans forcer un compromis entre couverture et précision au moment de la récupération.
Charger plus de 900 modèles dans le contexte
Une contrainte fondamentale a façonné l'architecture. Il n'était pas possible d'inclure plus de 900 schémas de modèles Sonar dans chaque prompt. Même avec des modèles à long contexte, cela dégrade à la fois le coût et la précision.
Le Model Selector résout ce problème. Fonctionnant sur Anthropic Claude Haiku 4.5, il travaille avec des représentations compactes et riches sémantiquement de chaque modèle (nom, objectif, champs clés et relations clés). Étant donné la question de l'utilisateur, il renvoie uniquement les modèles dont le Generator a réellement besoin. Le Generator reçoit alors le détail complet des schémas uniquement pour ces modèles sélectionnés, plus les relations qui les relient.
Méthodologie d'évaluation
Pour itérer en toute confiance, l'équipe Orca a construit très tôt dans le projet un harnais d'évaluation continue. Le harnais combine un jeu de données organisé, une couche de notation automatisée et une approche de mesure par tranches, afin que l'équipe puisse faire confiance à chaque changement avant sa mise en production. Ensemble, ces éléments font de l'évaluation une étape de routine plutôt qu'une réflexion après coup.
L'ensemble de données d'évaluation organisé couvre les types de questions, les familles de modèles et les niveaux de complexité observés en production, de sorte qu'il reflète l'utilisation réelle. Une couche de notation LLM-as-judge évalue les requêtes générées sur leur exactitude, leur complétude et leur équivalence sémantique par rapport à une requête de référence, ce qui donne à l'équipe un signal de qualité cohérent. La méthodologie de mesure décompose ensuite les écarts par segment, permettant à l'équipe d'identifier précisément où se produisent les régressions et ce qu'il faut corriger.
Chaque modification d'un prompt, d'un modèle, d'un paramètre de récupération ou d'un exemple passe par le harnais avant d'être déployée en production.
Système d'étiquetage avec expert du métier dans la boucle pour une amélioration continue
Maintenir la précision à mesure que les environnements clients évoluent et que de nouveaux schémas de questions émergent exigeait plus qu'un déploiement initial solide. L'équipe Orca a construit un outil d'étiquetage interne destiné aux chefs de produit, aux ingénieurs support et aux chercheurs en sécurité. Avec cet outil, ils peuvent signaler des requêtes, corriger des sorties et pousser des corrections dans la banque d'exemples en une seule action. De plus, le système collecte automatiquement les requêtes de production dont les exemples correspondants sont de faible confiance et les achemine vers l'expert du métier approprié pour un étiquetage quotidien. À la prochaine exécution du pipeline, le nouvel exemple est récupéré via Cohere Rerank 3.5, et la précision sur cette classe de questions s'améliore dès cet instant, sans déploiement.
« L'interface d'étiquetage est l'investissement le plus important que nous ayons fait pour la qualité à long terme. Elle transforme Discovery AI d'un déploiement statique en un système vivant, que nos experts du métier améliorent en continu dans le cadre de leur flux de travail habituel. »
— Or Gabay, Directeur de l'IA, Orca Security
Combinée à l'observabilité de bout en bout du pipeline et à des tableaux de bord partagés entre les équipes produit, ingénierie et relation client, cette boucle de rétroaction est ce qui permet à Discovery AI de continuer à s'améliorer après le lancement initial.
Résultats
Après le déploiement de Discovery AI en production, la nouvelle solution a surpassé le référentiel initial en termes de coût, de latence et de précision. L'utilisation de jetons d'entrée a diminué de 93 pour cent, passant d'environ 2 millions de jetons à 140,000 jetons pour une charge de travail comparable. Le coût global a diminué de 90 pour cent, grâce à cette consommation réduite de jetons associée à une allocation de modèle par étape sur Amazon Bedrock.
La latence s'est également améliorée, les temps de réponse de bout en bout baissant de 75 pour cent, passant d'environ 60 secondes à 15 secondes. La précision sur les requêtes complexes multi-modèles s'est également améliorée, mesurée en continu grâce au harnais d'évaluation de l'équipe.
Discovery AI traite désormais des milliers de requêtes par jour en production depuis mars 2026, avec une qualité validée par des experts internes et les retours des clients.
Conclusion
Dans cet article, nous avons partagé comment Orca Security a construit Discovery AI sur Amazon Bedrock. La solution a réduit les coûts de requête de 90 pour cent, l'utilisation de jetons d'entrée de 93 pour cent et la latence de 75 pour cent par rapport au référentiel initial. La solution combine plusieurs technologies clés. Celles-ci incluent la récupération d'exemples basée sur RAG avec Cohere Rerank 3.5, l'allocation de modèle par étape entre Anthropic Claude Haiku 4.5 et Amazon Nova 2 Lite, et la recherche sémantique propulsée par Amazon Titan. De plus, un système d'étiquetage continu avec humain dans la boucle assure une amélioration permanente. Cette combinaison a permis à Orca de transformer un prototype fonctionnel en une solution de qualité production, à la fois moins coûteuse à exécuter et plus précise.
Pour commencer à créer des solutions similaires, explorez Amazon Bedrock pour l'accès aux modèles de fondation (FM), Cohere Rerank on Amazon Bedrock pour l'optimisation de la récupération, et Amazon Titan pour les embeddings. Pour en savoir plus sur l'outil de sécurité cloud d'Orca Security, visitez orca.security.
Pour en savoir plus sur la manière dont Orca Security applique l'IA à l'ensemble de son cadre, consultez how Orca drives security outcomes with AI et how Orca secures AI adoption, including Amazon Bedrock.
Pour en savoir plus sur les techniques utilisées dans cet article, lisez les articles connexes sur le AWS Machine Learning Blog.