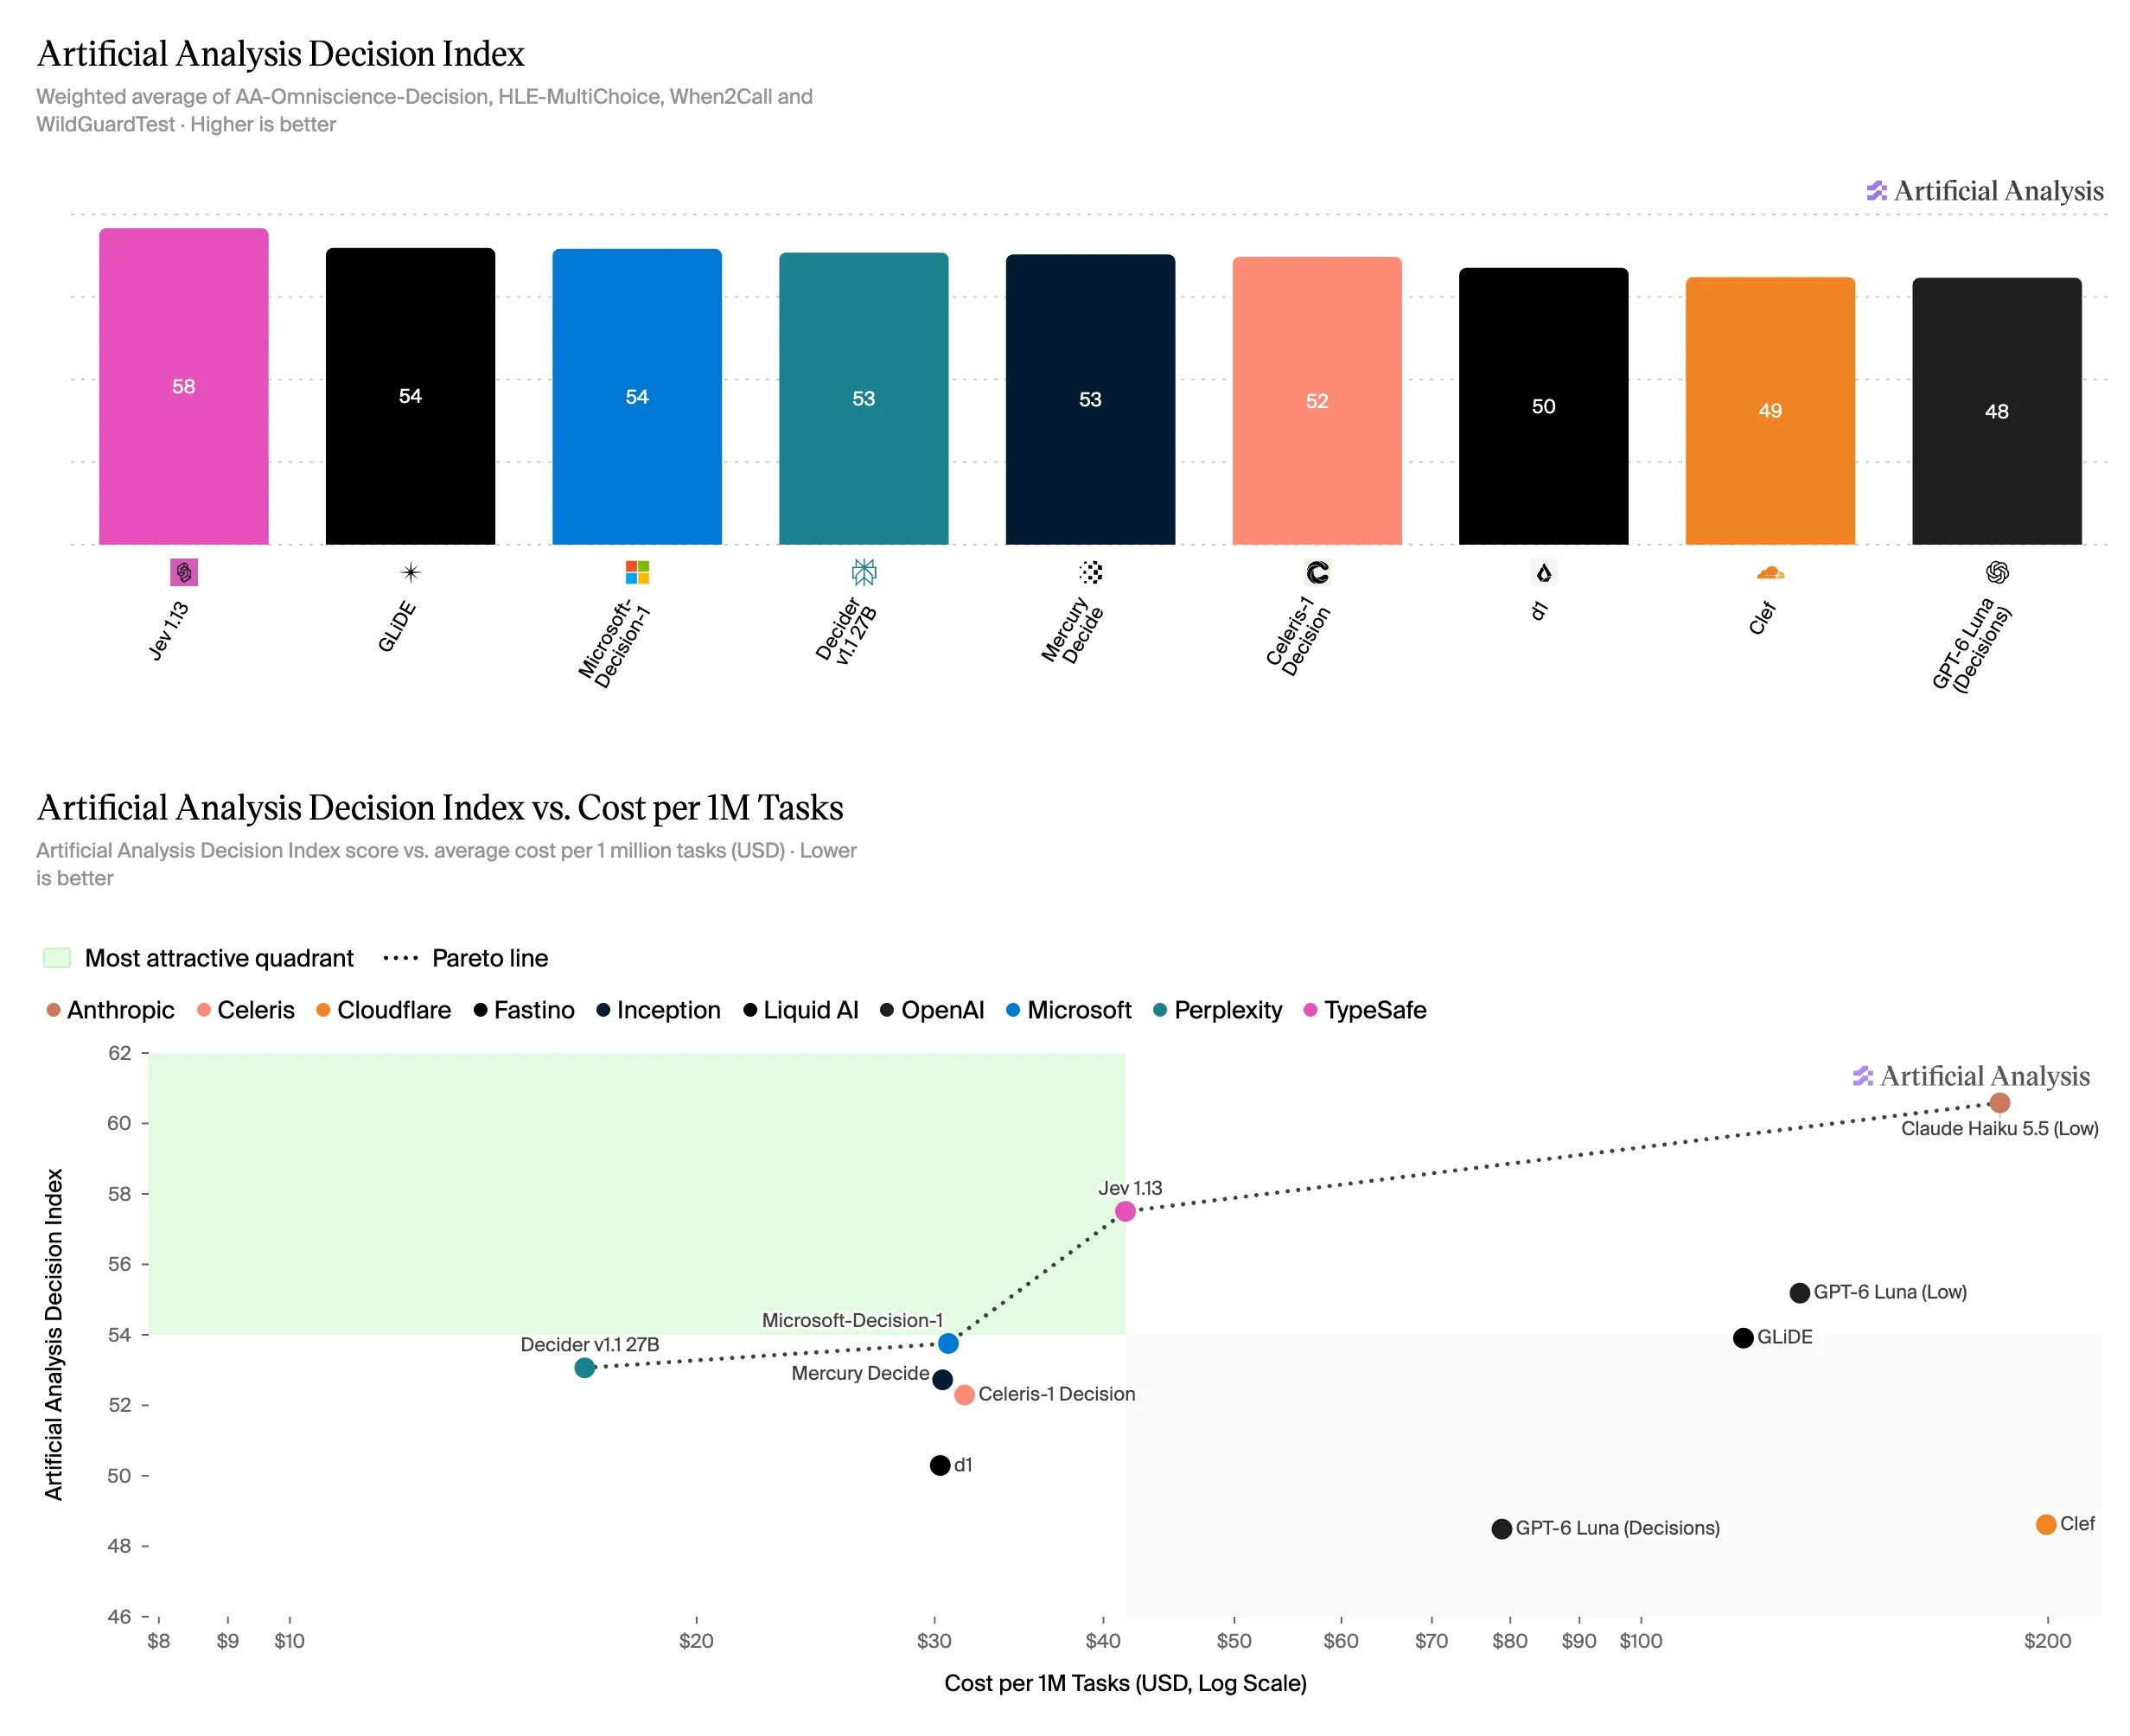
Présentation de l’Indice de Décision d’Analyse Artificielle, permettant d’évaluer les modèles de décision dans les domaines de classification, d’appel de outils, de connaissances et de raisonnement. Jev se classe parmi les modèles de décision ; les modèles de langage tels que Claude Haiku 5.5 offrent encore une précision plus élevée, mais à un coût et une latence beaucoup plus importants.
Les modèles de décision fournissent des réponses structurées ou des classifications accompagnées de probabilités associées, offrant des réponses plus rapides et des coûts plus faibles que l’utilisation de modèles linguistiques. L’Indice de Décision d’Analyse Artificielle v1.0 compare la capacité, le coût et la vitesse des modèles de décision, ainsi que les modèles linguistiques.
Bonnets dans l’Indice de décision d’analyse artificielle v1.0 :
➤ AA-Omniscience-Decision : Un jeu de données privé comprenant 500 questions, adapté du benchmark propriétaire AA-Omniscience, qui mesure les connaissances et la tendance à inventer des informations des modèles de décision
➤ HLE-MultiChoice : 513 questions de choix multiples uniquement en texte provenant de Humanity’s Last Exam, évaluant les capacités de raisonnement des modèles de décision
➤ When2Call : Un benchmark de appel d’outil de NVIDIA, qui teste si les modèles peuvent déterminer correctement s’ils doivent appeler un outil, demander des précisions, refuser de répondre ou répondre directement, en évaluant les capacités liées aux workflows agents et au routage des outils
➤ WildGuardTest : Un point de comparaison de sécurité qui évalue les capacités de classification des modèles face aux demandes nuisibles des utilisateurs, aux refus de l’assistant et aux réponses dommageables. Nous utilisons un sous-ensemble de 835 lignes de test originales de 1 725, où les trois annotateurs humains étaient d’accord sur toutes les étiquettes, après exclure les questions qui provoquent systématiquement un refus du modèle.
Résultats clés :
➤ Jev 1.13 occupe la première place dans l’Indice de Décision, et se trouve sur la frontière Pareto entre Capacité et Coût : Jev 1.13, fourni par @typesafeai, obtient une note de 58 dans l’Indice de Décision d’Analyse Artificielle, devant GLiDE (54) fourni par @fastinoAI et Microsoft-Decision-1 (54) fourni par @Microsoft. Decider v1.1 27B, fourni par @perplexity_ai, a le coût le plus bas pour 1M de tâches, à 17 $, et Microsoft-Decision-1 (31 $) ainsi que Jev 1.13 (42 $) se trouvent également sur la frontière Pareto entre Capacité et Coût. La décision Celeris-1 a le temps le plus rapide par tâche à 0,06 secondes, soit plus de 2 fois plus rapide que Jev 1,13 (0,13 seconde par tâche).
➤ Les modèles de décision sont mal calibrés pour les tâches de connaissances et de raisonnement : à presque tous les niveaux de probabilité des réponses choisies, l’exactitude est inférieure à celle attendue pour tous les modèles de décision. Cette différence est la plus grande pour AA-Omniscience-Decision et HLE-MultiChoice, tandis que la plupart des modèles sont relativement bien calibrés pour WildGuardTest (classification) et When2Call (appel d’outil).
➤ Les modèles de décision offrent des avantages en vitesse et en coût significatifs par rapport aux modèles de langage, mais ils sont inférieurs en termes de connaissances et de raisonnement : pour les tâches de classification et d’appels à outils, les modèles de décision performant de manière comparable aux modèles de langage, tout en étant beaucoup plus rapides et moins coûteux. Cependant, les modèles de langage surpassent considérablement en termes de connaissances et de raisonnement. Claude Haiku 5.5 (Bas) obtient 61 points sur l’Indice de Décision, 3 points de plus que Jev 1.13, mais met 1,4 seconde par tâche. 0,13 secondes (11 fois plus lent) et coûte 184 $ par 1 M de tâches, contre 42 $ pour Jev 1,13 (4,4 fois plus cher)
Nous continuerons à développer l’Indice de Décision d’Analyse Artificielle afin d’aider les développeurs et les entreprises à comprendre plus bien quand et comment utiliser les modèles de décision.