
Choisir le modèle approprié pour une application spécifique nécessite une méthode pratique pour le tester avec des entrées représentatives. Amazon SageMaker JumpStart offre un catalogue étendu de modèles déjà pré-entraînés. Dans cet article, nous montrons comment déployer un modèle disponible via SageMaker JumpStart, effectuer un test de performance léger et reproductible en utilisant le SDK Python de SageMaker, et supprimer l’endpoint une fois le test terminé. Pour les modèles pris en charge et la capacité disponible, ce flux de travail offre une voie d’évaluation reproductible, bien que le temps de déploiement varie en fonction du modèle, du type d’instance, du quota et de la région AWS.
En 2026, SageMaker JumpStart a introduit deux améliorations qui simplifient la découverte et le déploiement de modèles. Dans la section Model Hub de l’interface Amazon SageMaker AI, vous pouvez consulter le catalogue SageMaker JumpStart, voir des notebooks d’exemple et les ouvrir directement dans SageMaker Studio. Les options de déploiement d’endpoint pré-configurées offrent des configurations nommées optimisées pour des priorités telles que le faible coût, la faible latence ou les charges de travail à usage général, dans une gamme de modèles d’IA générative, y compris des configurations optimisées par Neuron. De plus, vous pouvez désormais passer de la découverte de modèles Hugging Face à le déploiement de l’IA SageMaker en un seul clic, grâce à l’intégration nouvelle du deep link.
Aperçu de la solution
Notre approche utilise un script Python réutilisable qui effectue trois étapes :
- Découvrez et déploiez un modèle via SageMaker JumpStart.
- Exécutez les prompts d’exemple spécifiques au modèle et mesurez la latence, la longueur approximative de l’output, ainsi que le taux de génération par requête unique.
- Nettoyer l’endpoint.
Ce modèle fonctionne pour de nombreux modèles SageMaker JumpStart compatibles, bien que les formats de contenu, les types d’instances requis, les exigences du contrat de licence pour l’utilisateur final (EULA) et les schémas de réponse puissent nécessiter des ajustements spécifiques au modèle.
Prérequis
- Un compte AWS avec les droits de SageMaker AI.
- Python 3+ avec le SDK Python de SageMaker v3 installé (
pip install "sagemaker>=3,<4"). - Quota d’instances GPU suffisant pour le modèle que vous souhaitez tester ou demander une augmentation du quota.
Étape 1.a : Découvrir les modèles disponibles
Piste de l'interface utilisateur pour trouver les modèles dans SageMaker JumpStart :
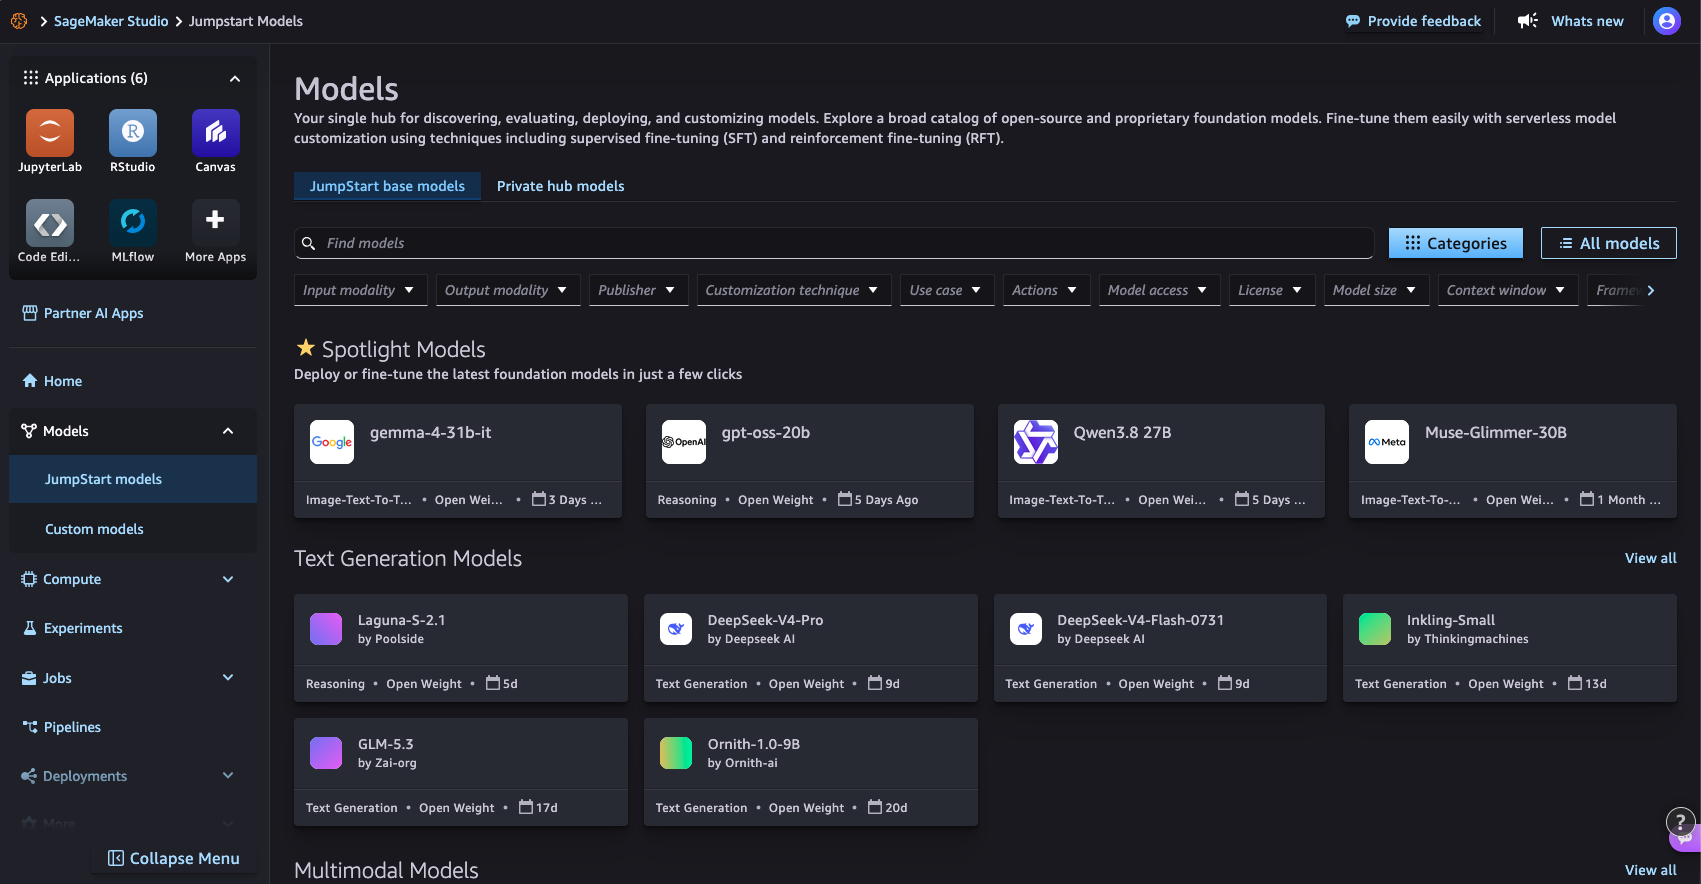
Figure 1 : Consultation du catalogue de modèles sur la page SageMaker JumpStart Models dans SageMaker Studio
Chemin de code utilisant le SDK Python de SageMaker :
from sagemaker.core.jumpstart.notebook_utils import (
    list_jumpstart_models,
)

REGION = "us-east-1"

models = list_jumpstart_models(
    filter="task == textgeneration",
    region=REGION,
    list_versions=True,
)

print(f"Found {len(models)} text generation models")

for model_id, model_version in models[:10]:
    print(
        f" - {model_id} "
        f"(version {model_version})"
    )
Ou recherchez par nom du modèle :
from sagemaker.core.jumpstart.notebook_utils import list_jumpstart_models

ids = list_jumpstart_models(
    filter="model_id contains qwen",
    region=REGION,
    list_versions=True,
)

print(f"{len(ids)} models matched in {REGION}\n")

for model_id, version in ids:
    print(f"{model_id:<55} v{version}")
Étape 1.b : Déployer le modèle
Piste de l’interface utilisateur pour déployer les modèles via SageMaker JumpStart :
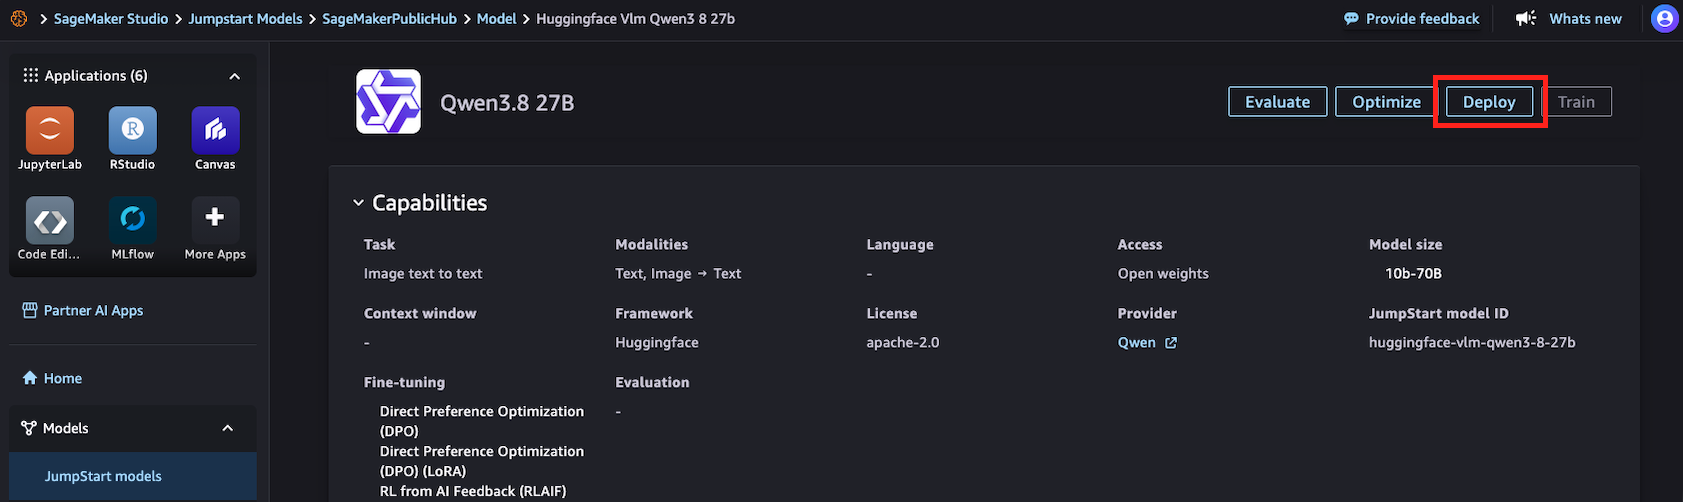
Figure 2 : Déploiement d’un modèle depuis la page détaillée du SageMaker JumpStart dans SageMaker Studio
Chemin de code utilisant le SDK Python de SageMaker :
import time

from sagemaker.core.jumpstart.accessors import JumpStartModelsAccessor
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve import ModelBuilder

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"
ACCEPT_EULA = False  # Set True only after reviewing the model terms

def get_field(value, name, default=None):
    if isinstance(value, dict):
        return value.get(name, default)
    return getattr(value, name, default)

# Resolve the JumpStart-recommended deployment configuration.
specs = JumpStartModelsAccessor().get_model_specs(
    region=REGION,
    model_id=MODEL_ID,
    version=MODEL_VERSION,
)

if isinstance(specs, list):
    if not specs:
        raise ValueError(
            f"No JumpStart specification found for {MODEL_ID}"
        )
    specs = specs[0]

recommended_instance_type = get_field(
    specs,
    "default_inference_instance_type",
)

if not recommended_instance_type:
    raise ValueError(
        f"No recommended instance type found for {MODEL_ID}"
    )

print(f"Model: {MODEL_ID}")
print(f"Region: {REGION}")
print(f"Recommended instance: {recommended_instance_type}")

start = time.time()

jumpstart_config = JumpStartConfig(
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    accept_eula=ACCEPT_EULA,
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(
        instance_type=recommended_instance_type,
        instance_count=1,
    ),
)

model = model_builder.build()
endpoint = model_builder.deploy()
deploy_time = time.time() - start

print(f"Deployed in {deploy_time:.1f} seconds")
print(f"Endpoint: {endpoint.endpoint_name}")
Étape 2 : Exécuter les prompts d’exemple et mesurer les performances
from sagemaker.core.payloads import retrieve_all_examples
import json
import time

MODEL_ID = "huggingface-vlm-qwen3-5-27b"
MODEL_VERSION = "1.13.0"
REGION = "us-east-1"

example_payloads = retrieve_all_examples(
    region=REGION,
    model_id=MODEL_ID,
    model_version=MODEL_VERSION,
    serialize=True,
)

#you can re-create the endpoint pointer using the endpoint name:
#from sagemaker.core.resources import Endpoint
#endpoint = Endpoint.get(endpoint_name="<your_endpoint_name>",region=REGION)

def read_response_body(result):
    body = result.body
    if hasattr(body, "read"):
        body = body.read()
    if isinstance(body, bytes):
        body = body.decode("utf-8")
    if isinstance(body, str):
        try:
            return json.loads(body)
        except json.JSONDecodeError:
            return body
    return body

def extract_output(response):
    """Handle common JumpStart text-generation response formats."""
    if isinstance(response, list):
        response = response[0] if response else ""
    if isinstance(response, dict):
        choices = response.get("choices")
        if choices:
            choice = choices[0]
            message = choice.get("message")
            if isinstance(message, dict):
                return message.get("content", "")
            return choice.get("text", "")
        for field in (
            "generated_text",
            "output_text",
            "text",
        ):
            if field in response:
                return response[field]
    return response

results = []

for payload in example_payloads or []:
    start = time.perf_counter()
    result = endpoint.invoke(
        body=payload.body,
        content_type=payload.content_type,
        accept=payload.accept,
    )
    latency = time.perf_counter() - start
    response = read_response_body(result)
    output = extract_output(response)
    if not isinstance(output, str):
        output = json.dumps(output, indent=2)
    # This is an estimate based on whitespace-separated words.
    output_words = len(output.split())
    results.append(
        {
            "request_preview": payload.body[:50],
            "latency_s": round(latency, 2),
            "estimated_output_words": output_words,
            "words_per_second": round(
                output_words / latency,
                1,
            ) if latency > 0 else 0,
        }
    )
    print("Input:\n", payload.body, end="\n\n")
    print("Output:\n", output, end="\n\n")
    print(
        f"Latency: {latency:.2f} seconds\n"
        f"Estimated output words: {output_words}\n"
        f"Estimated single-request output generation rate: "
        f"{output_words / latency:.1f} words/second\n"
    )
    print("-" * 80)

print("\nSummary:")
for result in results:
    print(result)
Résultat:
Input:
{"max_tokens": 256, "messages": [{"content": "What is deep learning?", "role": "user"}], "model": "/opt/ml/model"}
Output:
Here's a thinking process that leads to the explanation of deep learning:
1. **Deconstruct the Request:**
* **Question:** "What is deep learning?"
* **Intent:** The user wants a clear, comprehensive, yet accessible definition and overview of deep learning.
* **Target Audience:** Likely someone looking for a general understanding, possibly a student, tech
enthusiast, or professional exploring the field. The tone should be informative, structured, and
not overly jargon-heavy (though key terms need explanation).
2. **Initial Brainstorming & Key Concepts:**
* What is it? A subset of machine learning, which is a subset of AI.
* Core mechanism: Artificial Neural Networks (ANNs).
* "Deep" means many layers (hidden layers).
* How does it work? Learning representations from data (feature learning).
* Key applications: Image recognition, NLP, speech, self-driving cars.
* Why is it popular now? Big data, GPU power, better algorithms.
* Pros/Cons: High accuracy vs. black box, data hunger.
3. **Structuring the Answer:**
Latency: 9.07 seconds
Estimated output words: 153
Estimated single-request output generation rate: 16.9 words/second
--------------------------------------------------------------------------------
Summary:
{'request_preview': '{"max_tokens": 256, "messages": {"content": "What', 'latency_s': 9.07, 'estimated_output_words': 153, 'words_per_second': 16.9}
Étape 3 : Nettoyage
print(f"Deleting endpoint: {endpoint.endpoint_name}")
endpoint.delete()
endpoint.wait_for_delete()
print("Endpoint deleted")
Conclusion
Ce modèle fonctionne pour de nombreux modèles SageMaker JumpStart disponibles, mais le format de contenu, le type d’instance requis, le EULA et la parsing de la réponse peuvent nécessiter des ajustements spécifiques au modèle. En utilisant des prompts de test cohérents et en mesurant la latence, le débit et la qualité de l’output entre tous les modèles, vous pouvez comparer les options et choisir celui qui convient le mieux à votre charge de travail.
Essayez cette approche avec différents modèles de Amazon SageMaker JumpStart pour trouver le bon équilibre entre qualité, vitesse et coût pour vos applications.
Références
- Documentation du SDK Python de SageMaker
- Bilan et optimisation de la déploiement JumpStart SageMaker (article de blog)
- De Hugging Face à SageMaker Studio en un clic (article de blog)
- Amazon SageMaker JumpStart