

Les garde-fous IA conçus pour empêcher les hackers bloquent maintenant les défenseurs, et Orion-1 vise à combler ce vide.
 Jonathan Kemper
Voir le profil LinkedIn de Jonathan Kemper
14 octobre 2026
 Nano Banana Pro demandé par THE DECODER
Points clés
- Artemis Security a lancé Orion-1, un modèle d’IA qui enquête et répond de lui-même aux attaques cyber sur les réseaux d’entreprise.
- Il relie les données de journalisation dispersées provenant des réseaux, des points d’extrémité et des services cloud afin de retracer les attaques jusqu’à un seul acteur et déclencher des mesures de contre-mesure.
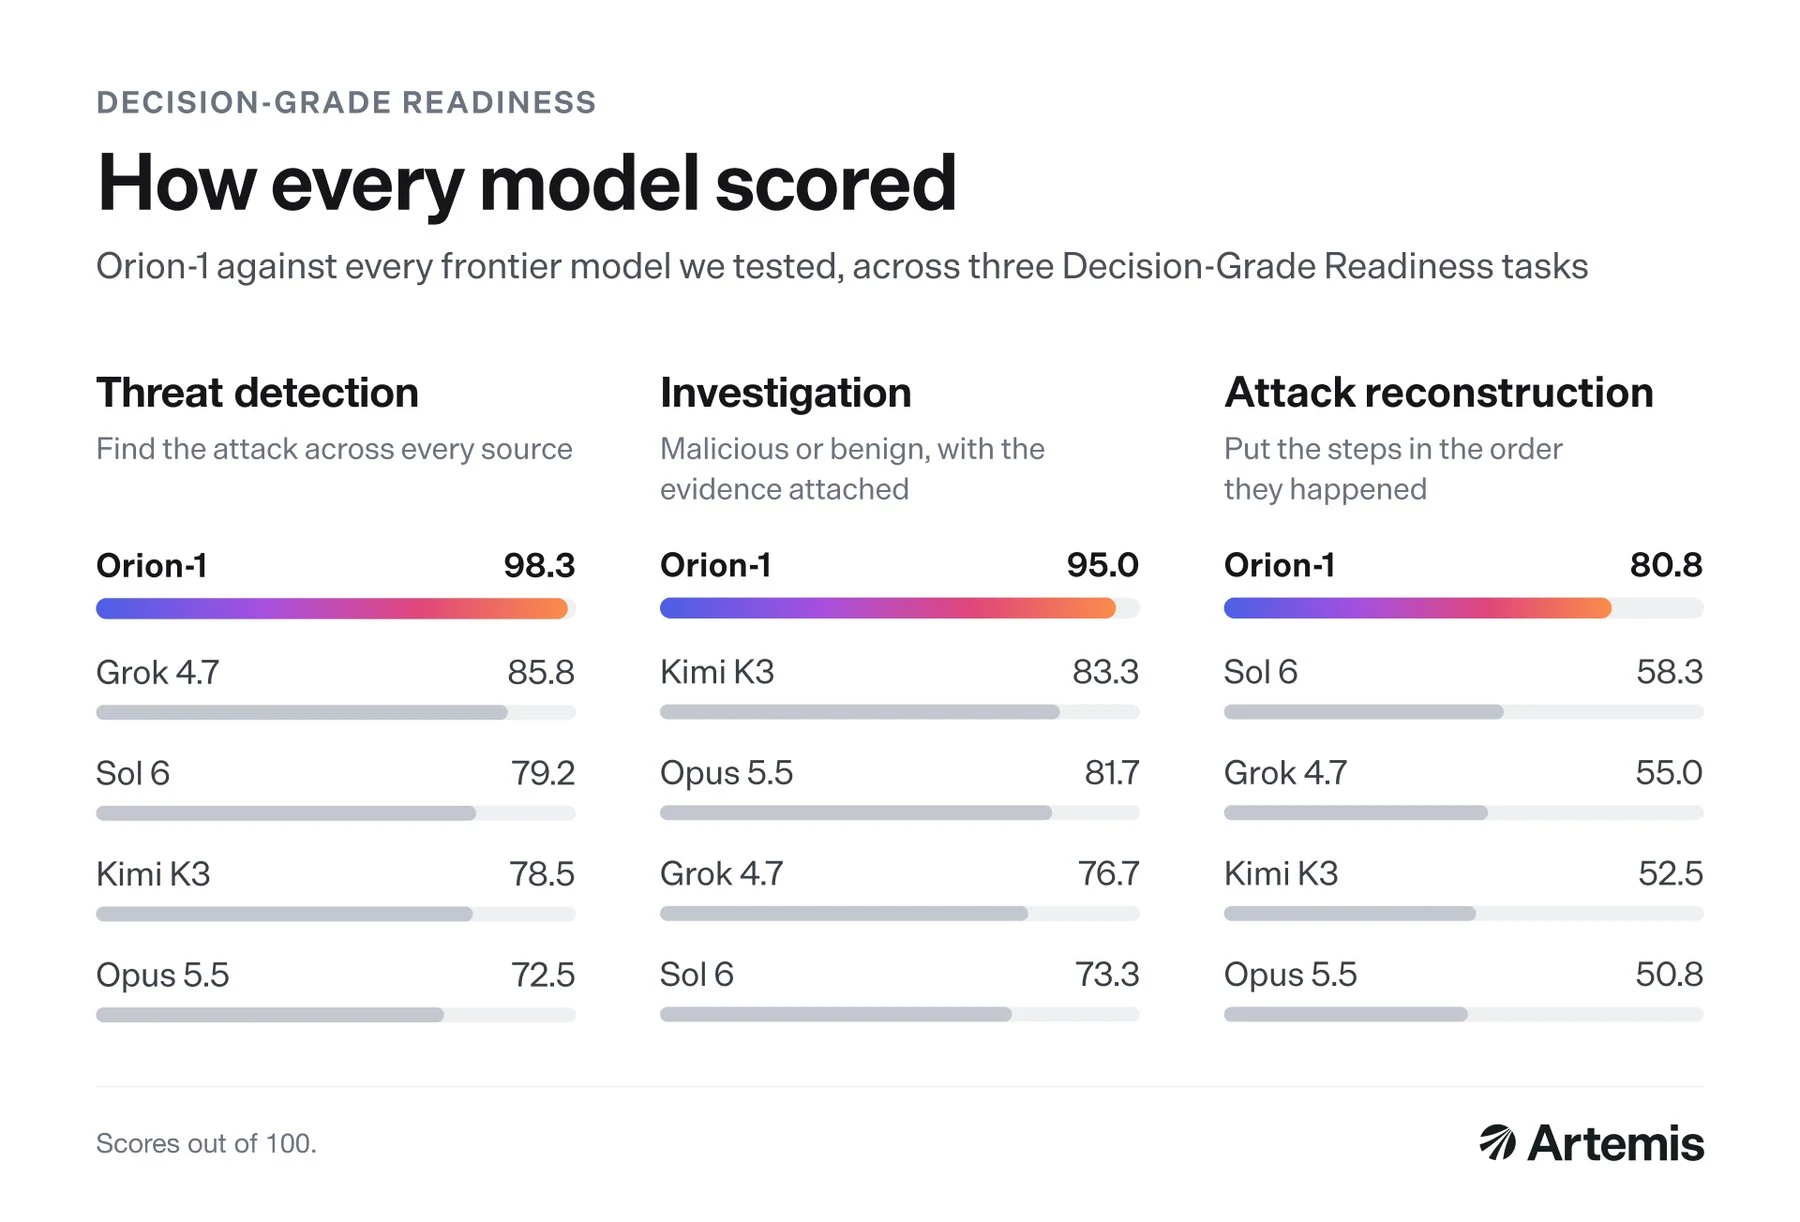
- Selon les critères de mesure de l’entreprise elle-même, Orion-1 dépasse les modèles polyvalents tels que Claude Opus 5.5 et GPT-6 Sol, avec la plus grande différence en reconstruction des attaques étant de 80.8 contre 58.3 points.
Les modèles d’IA polyvalents constituent un problème croissant pour les équipes de sécurité, car ces mêmes compétences sont également utiles aux attaquants. Artemis Security souhaite combler cette lacune avec un modèle conçu spécifiquement à cet effet.
La start-up américaine Artemis Security a lancé Orion-1, un modèle conçu pour enquêter et répondre seule aux attaques sur les réseaux d’entreprise, surpassant Claude Opus 5.5 et GPT-6 Sol selon les critères de mesure propres à l’entreprise. Orion-1 traite les données de logs provenant des services d’authentification, des installations cloud, des endpoints d’entreprise, des applications SaaS et du matériel réseau, puis relie les signaux individuels tels que l’inscription d’un compte d’entreprise, les nouvelles permissions cloud ou une règle de boîte mail créée récemment à un attaquant unique. Une fois qu’elle a une image claire de ce qui s’est passé, le modèle attribue un score de confiance, établit un verdict et recommande ou lance une réponse.
Selon Artemis, les modèles polyvalents perdent la trace lorsqu’ils sont soumis à des milliards d’événements, ou bien ils interprètent des activités inoffensives mais étranges comme des attaques. Artemis a affiné Orion-1 en s’appuyant sur les opérations de sécurité propres à l’entreprise, y compris la détection de schémas suspects dans les données de logs, la recherche de techniques d’attaque connues, l’élaboration de nouvelles règles de détection et la neutralisation des attaques en cours. Aucune donnée client n’a été utilisée pendant le entraînement, indique l’entreprise. Artemis qualifie Orion-1 de « modèle Frontier Foundation », mais cette affinement est décrite uniquement dans son article de blog ; il n’est pas clair si l’entreprise s’appuie sur un modèle existant d’un autre fournisseur.
Artemis a créé son propre indicateur de performance pour mesurer la confiance dans les décisions de sécurité
Artemis a développé un benchmark appelé « Decision-Grade Readiness » (DGR) pour la comparaison. La plupart des tests de sécurité existants se basent sur des techniques d’attaque ou demandent aux modèles de résoudre des énigmes de piratage, mais DGR donne à chaque modèle le même avertissement initial, les mêmes données environnementales et les mêmes outils qu’un équipe de sécurité aurait, puis lui demande de décider si une attaque est en cours. Les milliers de tâches ont toutes des résultats connus, et certaines ne contiennent aucune attaque ou incluent des données bénignes conçues pour sembler malveillantes. Les modèles sont évalués en fonction de leur verdict ainsi que des preuves qu’ils présentent.
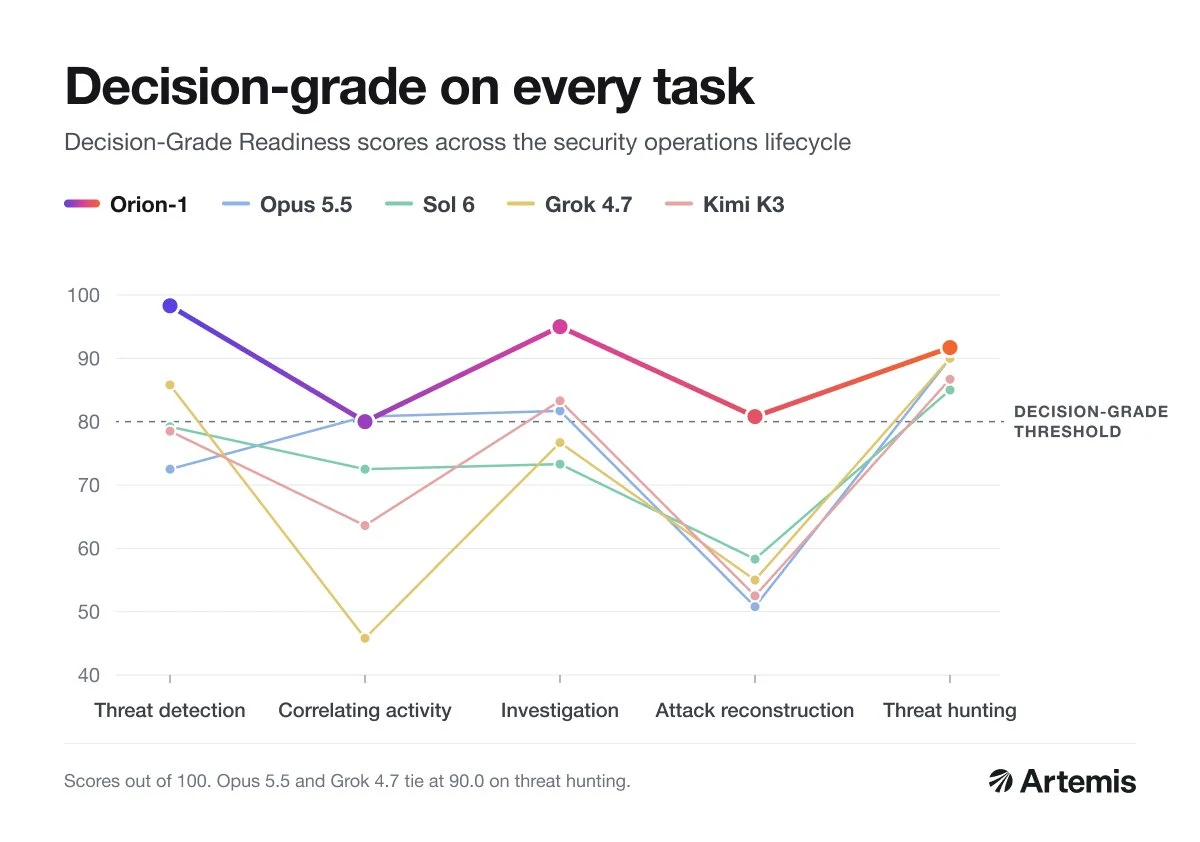
Artemis a rapporté les résultats pour cinq tâches et a testé Grok 4.7 et Kimi K3, ainsi que Opus 5.5 et GPT-6 Sol. La plus grande différence se manifeste dans la reconstruction des attaques : Orion-1 a obtenu 80,8, contre 58,3 pour le modèle le plus performant suivant.
Orion-1 est disponible en preview privée pour certains clients sur la plateforme Artemis, où les clients fixent des limites par type d’action concernant la capacité du modèle à décider lui-même. Les actions ayant un impact important nécessitent par défaut l’approbation humaine. Artemis est sortie de son mode caché en avril, révélant 70 millions de dollars provenant des rounds de financement seed et Series A environ six mois après la création de l’entreprise.
Les garde-fous destinés aux attaquants bloquent aussi les défenseurs
Les modèles de frontière large deviennent de plus en plus difficiles à utiliser pour les équipes de sécurité, car les fournisseurs continuent de renforcer leurs capacités cyber. OpenAI considère son modèle Astra comme le premier à pouvoir atteindre le niveau de risque cyber sécurité le plus élevé, où un modèle pourrait développer et exécuter des attaques cyber par lui-même. Claude Opus 5.5 envoie la plupart des tâches de cybersécurité au vieux Opus 4.8, et lorsque Hugging Face a tenté en juillet d’analyser une attaque IA entièrement autonome sur sa propre infrastructure en utilisant des modèles de frontière commerciaux, leurs contrôles bloquèrent complètement l’analyse des données d’attaque. L’équipe a finalement choisi le modèle ouvert GLM 5.2 qui fonctionne sur ses propres serveurs.
Pour la défense, les fournisseurs livrent des modèles spécialisés avec un accès restreint. OpenAI ne distribue que des modèles moins restrictifs GPT-5.5-Cyber pour les défenseurs vérifiés, et Anthropic adopte une approche similaire avec son modèle le plus puissant, exécutant Claude Mythos 5 Scanner de sécurité Claude et produits de sécurité partenaires. Les deux Mythe 5 et le modèle le plus puissant d’OpenAI GPT-6 Astra ne figure pas dans la comparaison Orion-1, et avec Opus 5.5, les résultats de test peuvent en grande partie refléter les données de l’ancien Opus 4.8.
Nouvelles en IA Sans Hysterie – Sélectionnées par des humains
Abonnez-vous à THE DECODER pour une lecture sans publicités, un bulletin informatif sur l’IA semaine par semaine, notre rapport exclusif « AI Radar » six fois par an, un accès complet à l’archive, et la possibilité d’interagir dans notre section de commentaires.
Source : Artemis Security