
Une équipe de services financiers consacre un temps considérable chaque semaine à créer manuellement des présentations PowerPoint destinées aux clients à partir de rapports trimestriels, de documents de conformité et d'analyses de marché. Chaque présentation nécessite de lire des centaines de pages, d'extraire les points de données clés, de structurer les diapositives et de générer des visuels d'appui. Cet article vous guide dans la construction d'un système d'agents IA utilisant Amazon Bedrock AgentCore qui automatise ce flux de travail, réalisé en moins de 90 secondes lors de nos tests internes. Cette approche réduit le temps de création des présentations tout en fondant le contenu sur les documents sources. La solution déploie un agent superviseur sur AgentCore runtime, une capacité d'Amazon Bedrock AgentCore, en utilisant le framework Strands Agents pour orchestrer les outils de génération et de résumé de documents. Anthropic Claude Sonnet 4.6 (disponible sur Amazon Bedrock) gère la création de contenu, Amazon Titan Text Embeddings v2 alimente la recherche vectorielle, et Stability AI Stable Image Inpaint (disponible sur Amazon Bedrock) génère les images des diapositives. Cet article inclut un dépôt public contenant les ressources de code.
Vue d'ensemble de la solution
La solution déploie un unique agent superviseur sur Amazon Bedrock AgentCore runtime qui choisit entre les outils de génération de documents et de résumé selon les demandes des utilisateurs. Un pipeline de génération augmentée par recherche (RAG) utilise Amazon OpenSearch Serverless pour le stockage vectoriel et la recherche sémantique sur du contenu multimodal.
La solution inclut une API REST construite avec .NET 8 minimal APIs, ce qui permet de l'intégrer à des applications d'entreprise existantes via des appels HTTP standard. AWS Lambda offre du calcul serverless, y compris des fonctions conteneurisées pour la génération de PowerPoint. La solution sécurise l'implémentation avec une isolation Amazon Virtual Private Cloud (Amazon VPC) , un chiffrement AWS Key Management Service (AWS KMS) et un contrôle d'accès au moindre privilège avec AWS Identity and Access Management (IAM) .
Concepts clés
Cette section couvre AgentCore runtime, le RAG et les garde-fous de sécurité du contenu tels qu'ils s'appliquent à cette solution.
Orchestration d'agents avec Amazon Bedrock AgentCore
Un agent IA unique générant des documents à partir de grandes bases de connaissances doit récupérer du contenu, structurer des plans, générer du texte, créer des images et assembler des fichiers. Plutôt que d'implémenter ces responsabilités concurrentes dans une fonction monolithique, la solution utilise une architecture basée sur des outils dans laquelle un agent superviseur achemine les requêtes vers des outils spécialisés.
Amazon Bedrock AgentCore runtime fournit une plateforme pour construire, connecter et optimiser des agents à grande échelle, avec n'importe quel framework ou modèle. Le code de l'agent s'exécute dans un conteneur isolé avec gestion des sessions, identité intégrée et observabilité. La solution utilise le framework Strands Agents (un SDK open source pour construire des agents IA) pour implémenter la logique du superviseur.
L'agent superviseur expose deux outils :
- generate_pptx : Crée des présentations PowerPoint en invoquant la fonction Lambda PPTX Generator, qui récupère le contenu de la base de connaissances, génère les plans des diapositives, crée des images par IA et assemble le document final.
- generate_summary : Extrait et synthétise des informations de la base de connaissances en utilisant le RAG pour fournir des réponses précises et fondées sur des sources.
L'agent détermine si une requête nécessite une génération de document, une synthèse de contenu, ou les deux, puis invoque l'outil approprié. Vous pouvez ajouter de nouvelles capacités en définissant de nouveaux outils dans le code de l'agent sans modifier ceux qui existent déjà.
Génération augmentée par recherche (RAG) pour les connaissances d'entreprise
Le RAG répond à un défi fondamental des systèmes d'IA : fournir des informations précises et à jour fondées sur les données de l'entreprise plutôt que de s'appuyer uniquement sur les données d'entraînement du modèle. L'implémentation utilise Amazon Bedrock Knowledge Bases, qui combinent la recherche vectorielle avec de grands modèles de langage (LLM) pour récupérer le contexte pertinent avant de générer les réponses.
Le pipeline RAG fonctionne comme suit :
- Vous téléchargez des documents d’entreprise vers Amazon Simple Storage Service (Amazon S3).
- Le système découpe et analyse les documents, en appliquant un traitement spécial pour le contenu multimodal, notamment les tableaux, les graphiques et les images.
- Amazon Titan Text Embeddings v2 convertit chaque segment en vecteurs de haute dimension qui capturent le sens sémantique.
- Amazon OpenSearch Serverless stocke les vecteurs, créant ainsi une base de données vectorielle interrogeable.
- Au moment de la requête, le système convertit la demande de l’utilisateur en embedding et effectue une recherche de similarité pour récupérer les segments de documents pertinents.
- Les segments récupérés fournissent le contexte au modèle de langage, qui génère des réponses ancrées dans le matériel source.
Cette approche est conçue pour aider à réduire le contenu halluciné en ancrant les documents générés dans les informations sources de la base de connaissances de l’entreprise.
Remarque : Le plan de données de la collection Amazon OpenSearch Serverless doit rester publiquement accessible car Amazon Bedrock Knowledge Bases accède à Amazon OpenSearch Serverless depuis une infrastructure gérée par AWS, et non par des points de terminaison VPC clients. Les politiques d'accès aux données IAM protègent la collection, et l'accès restreint au VPC limite le tableau de bord Amazon OpenSearch Serverless.
Amazon Bedrock Guardrails pour la sécurité du contenu
Les applications d'IA d'entreprise nécessitent une modération du contenu pour répondre aux normes organisationnelles et aux exigences de conformité. Amazon Bedrock Guardrails offre des mécanismes intégrés de filtrage du contenu et de sécurité, intégrés tout au long du pipeline de génération de documents.
Les Guardrails opèrent à plusieurs étapes :
- Traitement des entrées : Filtre les requêtes des utilisateurs pour aider à prévenir les problèmes d'injection et les contenus inappropriés.
- Génération des sorties : Surveille les sorties du modèle pour vérifier la conformité aux politiques de contenu.
- Gestion des informations personnellement identifiables (PII) : Détecte et anonymise ou bloque les PII.
L'implémentation crée des guardrails personnalisés via AWS Cloud Development Kit (AWS CDK), configurés avec des politiques spécifiques adaptées à la création de documents d'entreprise. L'agent applique les guardrails au niveau de l'invocation du modèle, offrant une sécurité de contenu cohérente sans nécessiter de configuration manuelle pour chaque déploiement.
Architecture de la solution
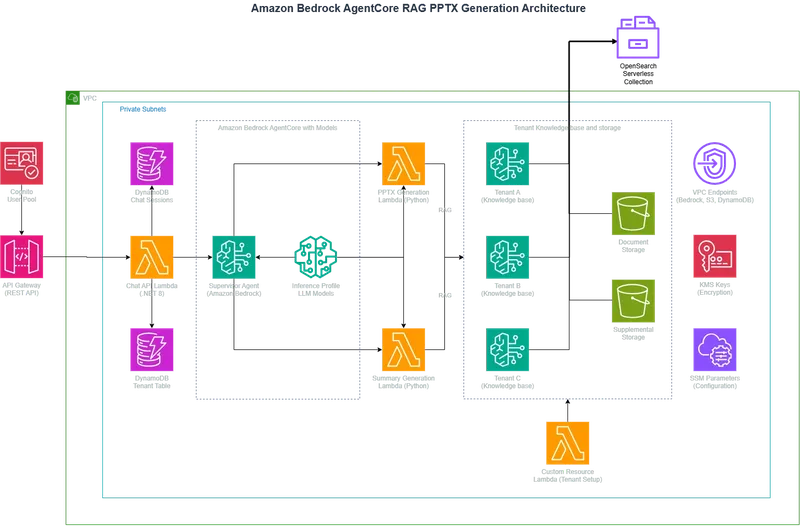
Le diagramme suivant illustre le système de génération de documents basé sur des agents.
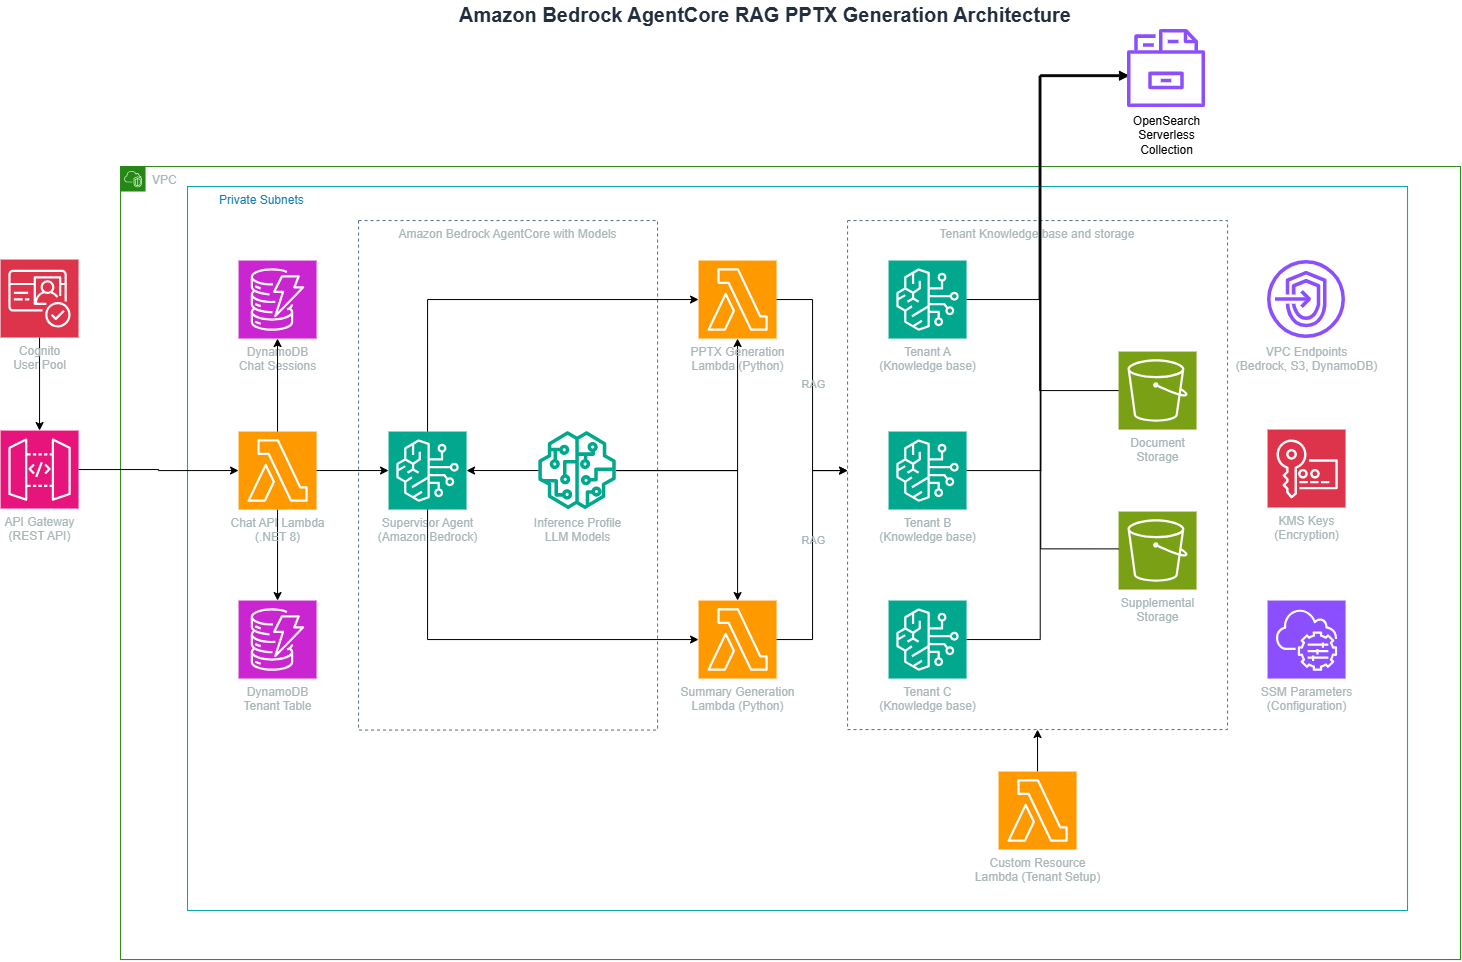
Figure 1 : Architecture du système de génération de présentations RAG Amazon Bedrock AgentCore
Le flux de données commence par les requêtes des utilisateurs qui arrivent via Amazon API Gateway, qui les achemine vers une API de chat basée sur .NET s'exécutant sur AWS Lambda. L'API maintient l'état de la conversation dans Amazon DynamoDB. Elle invoque ensuite l'agent superviseur hébergé sur le runtime Amazon Bedrock AgentCore.
L'agent superviseur analyse la requête et sélectionne l'outil approprié. Pour la génération de documents, il invoque la Lambda PPTX Generator (une fonction Python conteneurisée). Pour la synthèse, le superviseur invoque la Lambda Summary Generator, qui interroge la base de connaissances via l' retrieve_and_generate API.
Le système traite, découpe et intègre (embed) les documents stockés dans Amazon S3 à l'aide d'Amazon Titan Text Embeddings v2. Amazon OpenSearch Serverless indexe les embeddings pour une recherche sémantique rapide. Lorsque les outils interrogent la base de connaissances, Amazon OpenSearch Serverless récupère les chunks pertinents, qui sont ensuite fournis comme contexte à Anthropic Claude Sonnet 4.6 (sur Amazon Bedrock) pour générer des réponses fondées.
Le système stocke les documents générés dans Amazon S3 et renvoie des URL pré-signées pour un téléchargement sécurisé. Les mesures de sécurité comprennent :
- AWS WAF avec des ensembles de règles gérées et une limitation de débit basée sur IP sur Amazon API Gateway.
- Amazon Cognito avec le plan de fonctionnalités Plus et le mode de sécurité avancé pour la protection contre les menaces.
- Amazon Bedrock Guardrails provisionné via AWS CDK pour un filtrage cohérent du contenu.
- Amazon DynamoDB avec récupération à un instant donné, protection contre la suppression et chiffrement AWS KMS géré par le client.
- Compartiments Amazon S3 avec gestion des versions, journalisation d'accès au serveur et blocage de l'accès public.
- AWS X-Ray traçage sur les fonctions Lambda pour le débogage distribué.
- Validation des entrées avec vérification de l'ID de locataire et de l'ID de session basée sur des expressions régulières.
- Isolation des locataires via AWS Security Token Service (AWS STS) assumption de rôle par locataire.
Prérequis
Avant le déploiement, vous devez disposer des outils et accès suivants configurés dans votre environnement :
- Environnement AWS :
- Un compte AWS actif avec des autorisations pour déployer l'infrastructure.
- AWS Command Line Interface (AWS CLI) configuré avec des informations d'identification.
- Rôle IAM avec les politiques d'accès aux services appropriées.
- Outils de développement :
- .NET SDK 8 avec Amazon.Lambda.Tools installé globalement.
- Python 3.12 ou version ultérieure pour AWS CDK et les fonctions Lambda.
- Node.js et AWS CDK CLI pour le déploiement de l'infrastructure.
- Docker ou Finch pour la construction des images de conteneurs (prise en charge d'ARM64 requise).
- Accès aux services AWS :
- Amazon Bedrock avec accès aux modèles pour Anthropic Claude Sonnet 4.6, Amazon Titan Text Embeddings v2 et Stability AI Stable Image Inpaint (disponible via Amazon Bedrock). Pour la disponibilité des modèles par Région, consultez Modèles pris en charge par Région AWS dans Amazon Bedrock.
- Accès à Amazon Bedrock AgentCore activé dans votre compte.
- Délai d'expiration de l'intégration de l'API REST régionale Amazon API Gateway configuré à au moins 300 secondes. La valeur par défaut est 29 secondes. Pour plus d'informations, consultez Quotas d'API Gateway.
- Un Amazon VPC existant avec des sous-réseaux privés.
- Un compartiment Amazon S3 pour les artefacts de déploiement.
Configurer la solution
Le processus de configuration comprend la configuration des paramètres de déploiement et l'initialisation de l'environnement AWS CDK.
- Cloner le référentiel puis accédez au répertoire du projet :
git clone https://github.com/aws-samples/sample-generating-powerpoint-presentations-with-amazon-bedrock.git - Créez le fichier de configuration
pipeline-params.inià la racine du référentiel :environment=dev awscliprofile= ContainerRegistry=lambda-pptx-gen AgentContainerRegistry=agentcore-supervisor BucketDev=<amzn-s3-demo-bucket> VpcId=<your-vpc-id> ParsingInferenceProfileId=us.anthropic.claude-haiku-4-5-20251001-v1:0 AgentInferenceProfileId=us.anthropic.claude-sonnet-4-6 EmbeddingModelId=amazon.titan-embed-text-v2:0 ImageGenerationModelId=stability.stable-image-inpaint-v1:0 PPTXGenImageTag=latest AgentImageTag=latestDéfinissez
awscliprofilesur le nom de votre profil AWS CLI, ou laissez vide pour utiliser les informations d'identification des variables d'environnement. - Amorcez AWS CDK (une seule fois par compte et par Région) :
cdk bootstrapCela crée la pile AWS CloudFormation CDKToolkit requise pour les déploiements AWS CDK.
- Rendez les scripts de build exécutables :
chmod +x ./pipeline-build.sh
chmod +x ./pipeline-deploy.sh
chmod +x ./deploy-agentcore.sh
Build et déploiement
Le déploiement se compose de trois phases : la construction des artefacts, le déploiement de l'infrastructure et le déploiement de l'agent d'exécution AgentCore.
Phase de build
La phase de build compile le code de l'application et empaquète les artefacts de déploiement. Exécutez le script de build :
./pipeline-build.shCeci compile les projets .NET (Chat API) et les empaquète en paquets de déploiement Lambda. Il construit l'image du conteneur PPTX Generator à l'aide de Docker ou Finch et s'authentifie auprès d' Amazon Elastic Container Registry (Amazon ECR). Il pousse ensuite l'image du conteneur et stocke les artefacts de build dans le répertoire asset-output .
Phase de déploiement de l'infrastructure
Le déploiement de l'infrastructure crée les ressources AWS et configure les intégrations de services. Exécutez le script de déploiement :
./pipeline-deploy.shLe déploiement crée quatre piles AWS CloudFormation dans l'ordre des dépendances :
- VPCEndpointsStack : Configure les points de terminaison Amazon VPC pour les services AWS, y compris Amazon Bedrock AgentCore.
- OpensearchStack : Provisionne une collection Amazon OpenSearch Serverless pour le stockage vectoriel.
- AgentCoreStack : Crée les garde-fous, les fonctions Lambda, les rôles IAM et stocke la configuration dans AWS Systems Manager Parameter Store.
- ChatApiStack : Déploie Amazon API Gateway et la fonction Lambda Chat API.
Déploiement du runtime AgentCore
Une fois les piles d'infrastructure déployées, déployez l'agent superviseur sur le runtime AgentCore :
./deploy-agentcore.shCe script construit le conteneur de l'agent superviseur (ARM64), le pousse vers Amazon ECR, crée le runtime et le point de terminaison AgentCore, et met à jour le paramètre Systems Manager avec l'Amazon Resource Name (ARN) du point de terminaison. La Chat API référence cet ARN de point de terminaison pour acheminer les requêtes vers l'agent.
Après le déploiement, les sorties AWS CloudFormation incluent l'URL du point de terminaison Amazon API Gateway et les identifiants de ressources.
Configuration
La solution offre plusieurs points de configuration :
Instructions de l'agent
Modifier agent/app.py pour changer le prompt système et le comportement de l'agent superviseur. L'agent utilise Strands Agents avec deux outils définis dans agent/tools.py:
- generate_pptx : Invoque la Lambda PPTX Generator pour la création de documents.
- generate_summary : Invoque la Lambda Summary Generator pour les requêtes sur la base de connaissances.
Sélection du modèle
Dans pipeline-params.ini, ajustez les identifiants de modèle :
ParsingInferenceProfileId: Modèle pour l'analyse des documents de la base de connaissances (Anthropic Claude Haiku 4.5 recommandé pour l'efficacité des coûts).AgentInferenceProfileId: Modèle pour le raisonnement de l'agent (Anthropic Claude Sonnet 4.6 recommandé).EmbeddingModelId: Modèle d'embedding pour la recherche vectorielle (Amazon Titan Text Embeddings v2).ImageGenerationModelId: Modèle pour la génération d'images de diapositives (Stability AI Stable Image Inpaint).
Avec des profils d'inférence au lieu d'identifiants de modèle directs, les requêtes s'appuient sur un pool de capacité multi-Région plus étendu, ce qui augmente le débit et aide à maintenir des performances constantes sous charge.
Configuration Lambda
Ajustez les ressources de calcul dans les fichiers de la pile :
- Chat API : 128 MB de mémoire, délai d'attente de 29 secondes, concurrence réservée de 100 (dans
api.py). - PPTX Generator : 900 MB de mémoire, délai d'attente de 300 secondes, concurrence réservée de 50 (dans
pptx_gen.py). - Summary Generator : 512 MB de mémoire, délai d'attente de 300 secondes, concurrence réservée de 50 (dans
sum_gen.py).
Résultats
Lors des tests internes avec un PDF de 90 pages, Amazon 2024 Annual Report , la solution a produit les métriques de performance suivantes :
- Temps de génération de la présentation : 70–90 secondes de bout en bout (y compris la récupération depuis la base de connaissances, la génération de contenu, la création d'images et l'assemblage du fichier).
- Nombre de diapositives : Six diapositives aux formats titre, liste à puces, image+texte, image seule et point clé.
- Génération d'images : Deux images générées par IA par présentation à l'aide de Stability AI Stable Image Inpaint.
- Coût par génération : Environ 0,04 $ en coûts d'invocation de modèle au moment de la rédaction dans us-east-1 (génération de texte et d'images, la génération d'images représentant la majorité du coût).
- Ingestion de la base de connaissances : Moins de 2 minutes pour un seul document PDF de 1.3 Mo.
Présentations PowerPoint
Les figures suivantes montrent des exemples de diapositives issues d'une présentation générée.
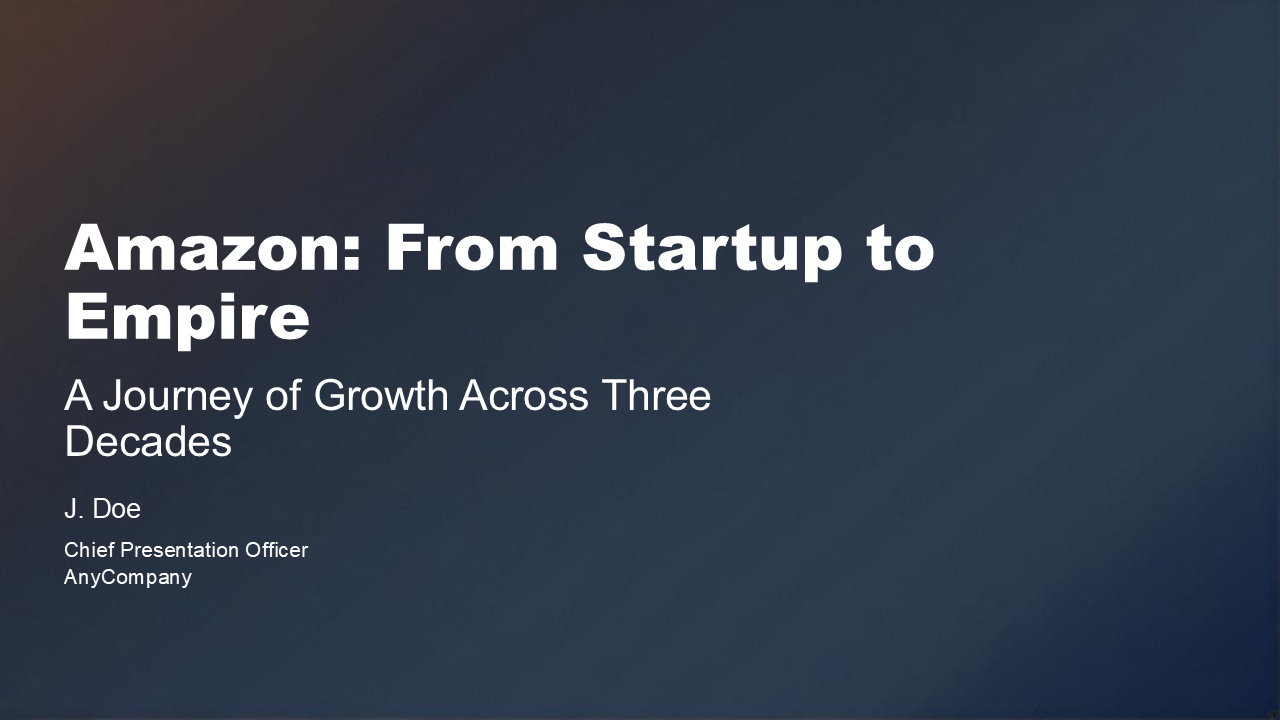
Figure 2 : Diapositive de titre générée avec une image de marque personnalisable
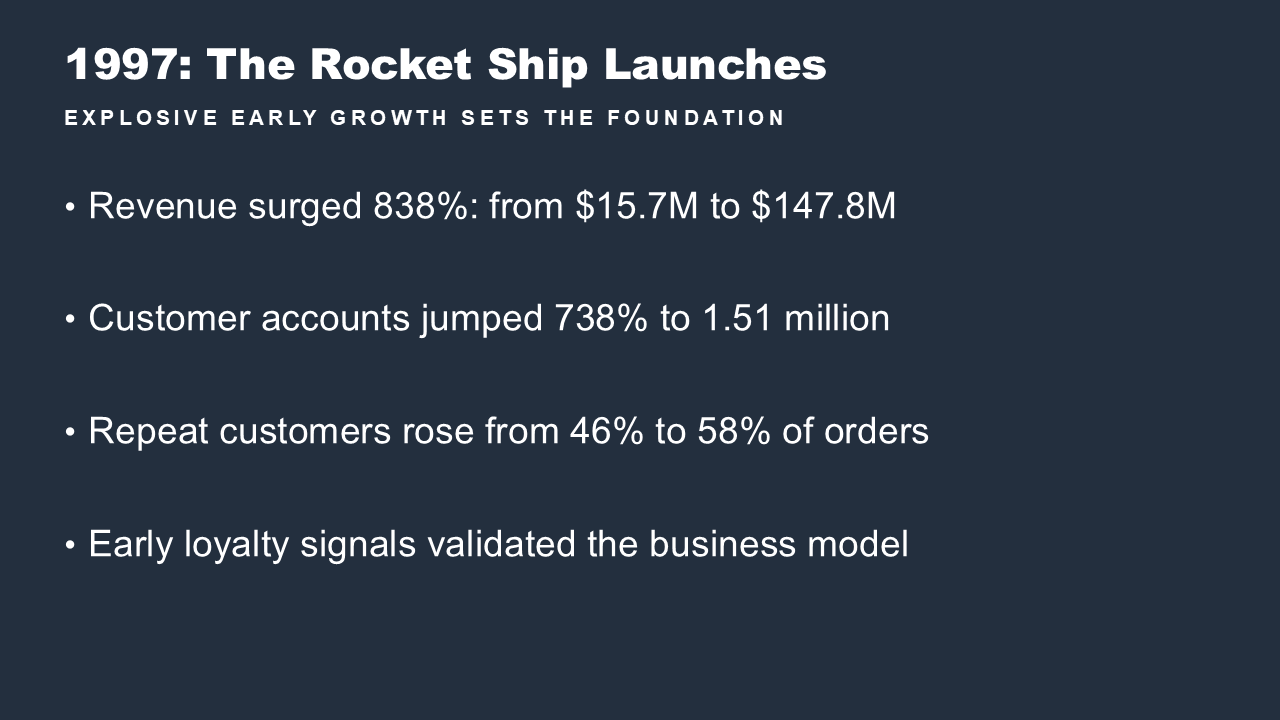
Figure 3 : Diapositive de contenu générée avec des puces
Figure 4 : Diapositive générée combinant du texte avec une image générée par IA
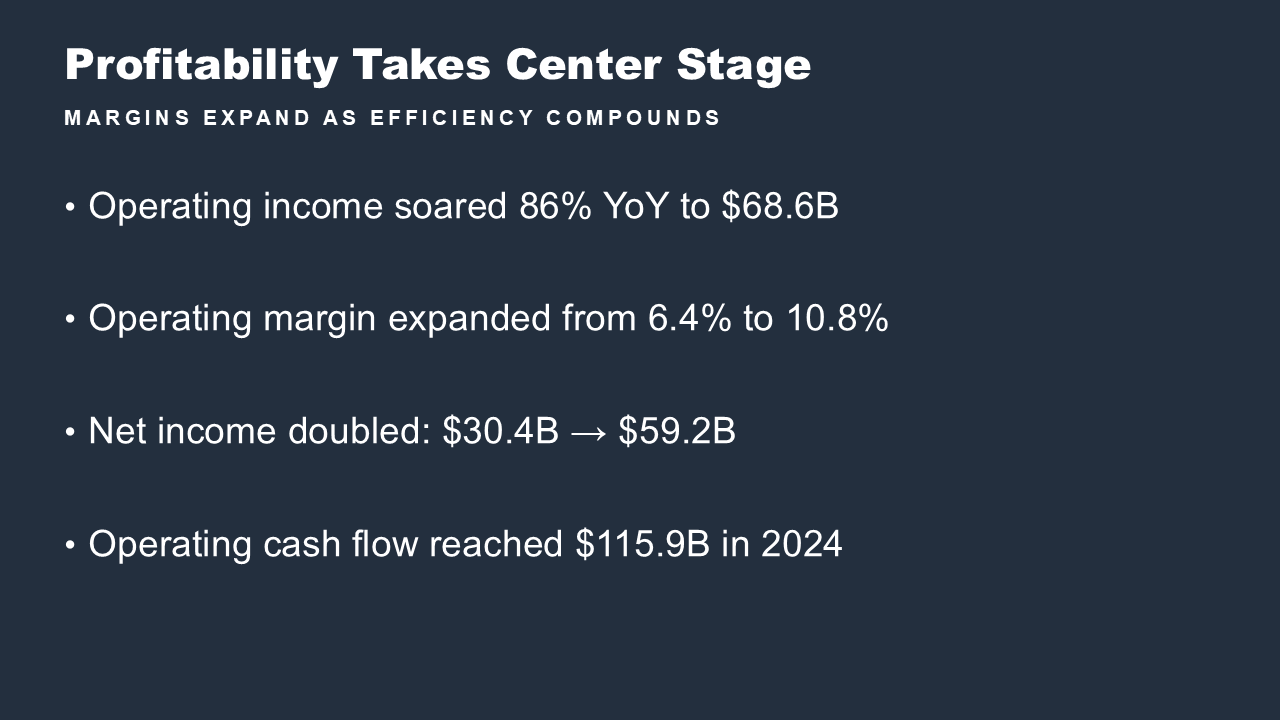
Figure 5 : Diapositive de contenu générée résumant les indicateurs de rentabilité
Figure 6 : Diapositive générée contenant uniquement une image avec un visuel généré par IA
Figure 7 : Diapositive de points à retenir générée
Les présentations générées comprennent :
- Des diapositives de titre avec une image de marque personnalisable.
- Des diapositives de contenu avec des puces et du texte structuré.
- Des diapositives d'images avec des visuels générés par IA via Stability AI Stable Image Inpaint (sur Amazon Bedrock).
- Des notes de présentateur avec des indications pour la présentation.
- Une mise en forme cohérente basée sur les modèles d'entreprise.
Résumés
Les sorties de résumé fournies à la base de connaissances comprennent :
- Une synthèse concise du contenu de la base de connaissances.
- Un suivi des citations vers les documents sources.
- Une mise en forme structurée avec les points clés mis en évidence.
Réponses de l'API
L'API Chat renvoie :
- Des réponses en streaming pour un retour en temps réel des utilisateurs. Les tests internes ayant montré que la génération de présentations prend 70 à 90 secondes (dépassant le délai d'expiration d'intégration par défaut de 29 secondes d'Amazon API Gateway), l'API Chat utilise un modèle d'invocation asynchrone. Utilisez le streaming ou le polling pour recevoir le résultat final plutôt que d'attendre un appel REST synchrone.
- Le maintien du contexte de conversation sur plusieurs tours.
- Des URLs pré-signées Amazon S3 pour le téléchargement des documents (expiration de 5 minutes).
Le contenu généré subit une validation par Amazon Bedrock Guardrails pour vérifier la conformité aux politiques de contenu avant la livraison.
Nettoyage
Pour éviter des frais continus, supprimez les ressources déployées :
- Supprimer le runtime AgentCore et le point de terminaison :
aws bedrock-agentcore-control delete-agent-runtime-endpoint \ --agent-runtime-id <runtime-id> \ --agent-runtime-endpoint-id <endpoint-id> aws bedrock-agentcore-control delete-agent-runtime \ --agent-runtime-id <runtime-id> - Désactiver la protection contre la suppression d'Amazon DynamoDB (obligatoire avant la suppression de la pile) :
aws dynamodb update-table --table-name chat-sessions-dev --no-deletion-protection-enabled aws dynamodb update-table --table-name tenant-table-dev --no-deletion-protection-enabled - Supprimer les piles AWS CloudFormation dans l'ordre inverse des dépendances :
aws cloudformation delete-stack --stack-name ChatApiStack aws cloudformation delete-stack --stack-name AgentCoreStack aws cloudformation delete-stack --stack-name OpensearchStack aws cloudformation delete-stack --stack-name VPCEndpointsStack - Vider les compartiments Amazon S3 avant leur suppression (AWS CloudFormation ne peut pas supprimer de compartiments non vides) :
aws s3 rm s3://amzn-s3-demo-bucket --recursive - Supprimer les dépôts Amazon ECR contenant des images de conteneurs :
aws ecr delete-repository --repository-name lambda-pptx-gen --force aws ecr delete-repository --repository-name agentcore-supervisor --force - Supprimer les sous-piles de bases de connaissances des locataires (créées par le provisionneur de locataires) :
aws cloudformation delete-stack --stack-name bedrock-kb-<tenant-id>
Considérations de sécurité
Cette solution utilise des variables d'environnement Lambda pour des valeurs de configuration telles que les identifiants de modèles, les noms de compartiments Amazon S3 et les identifiants de garde-fous. Il s'agit d'identifiants de ressources, et non de secrets. Pour les déploiements en production, utilisez AWS Secrets Manager pour les valeurs de configuration sensibles telles que les clés d'API et les identifiants de base de données.
L'agent d'exécution AgentCore s'exécute dans un conteneur isolé avec une isolation au niveau de la session. Chaque session utilisateur fonctionne dans un environnement dédié, ce qui aide à prévenir la contamination des données entre sessions.
Conclusion
Dans cet article, vous avez construit un système d'agents IA avec Amazon Bedrock AgentCore qui automatise la génération de documents d'entreprise. L'agent superviseur déployé sur le runtime AgentCore achemine les requêtes vers des outils spécialisés pour la création et la synthèse de documents, réduisant la création de présentations à environ 90 secondes lors d'un test interne.
Le pipeline RAG ancre le contenu généré dans les documents sources, et Amazon Bedrock Guardrails vérifie la conformité du contenu. Vous pouvez adapter cette architecture pour la génération automatisée de rapports dans les services financiers, la documentation technique pour les équipes d'ingénierie, ou la création de propositions pour les organisations commerciales.
Pour commencer, clonez le dépôt GitHub et suivez les instructions de configuration. Pour plus d'informations sur les services utilisés, consultez la documentation Amazon Bedrock AgentCore, Strands Agents SDK, et le AWS CDK Developer Guide.