
Présentation d'OpenCompute
Par Walker Hildebrand, Sherry Bai - 14 octobre 2026 - 7 minutes de lecture
Produit
Partager
Dans un monde où les agents peuvent travailler pendant votre sommeil, comment leur permettre de s'exécuter sur votre infrastructure ?
Lorsque l'agent vit dans une fenêtre de chat, la réponse est simple : il s'exécute sur la machine que vous avez configurée pour la session. Mais lorsque les agents enquêtent sur des alertes, répondent à des requêtes asynchrones, exécutent des Automations planifiées et traitent des problèmes tout au long de la journée, le problème devient celui du calcul à la demande. Vous n'avez plus seulement besoin d'un endroit où exécuter un agent. Vous avez besoin d'une flotte de calcul capable de suivre le rythme du travail.
Aujourd'hui, nous présentons OpenCompute, l'orchestrateur auto-hébergé de Factory pour les sandboxes d'agents sur le runtime de votre choix, désormais en préversion privée.
OpenCompute apporte le provisionnement à la demande et la gestion du cycle de vie à une infrastructure contrôlée par le client, intégré à l'expérience Factory à travers les Environments, Automations, et Remote Control. Vos agents obtiennent des ordinateurs quand ils en ont besoin. Vous choisissez où ces ordinateurs s'exécutent.
Il repose sur une conviction : adopter le développement logiciel autonome ne devrait pas exiger de remettre les clés de votre infrastructure à quelqu'un d'autre.
Alors, comment avons-nous construit en six semaines quelque chose qui nous a permis de déployer dans un environnement on-premises sur mesure en deux jours ?
Construire sur Remote Control
En avril 2026, nous avons présenté Droid Computers : des machines persistantes pour orchestrer les Droids. Les clients pouvaient créer un ordinateur dans le cloud de Factory ou enregistrer leur propre machine via Remote Control.
L'expérience Remote Control rend l'intégration avec Factory indépendante de la couche de calcul. Exécutez Droid sur n'importe quelle machine, connectez-la à Factory et travaillez avec elle à distance. Cette machine peut être une station de travail, une VM cloud ou un serveur au sein d'un réseau privé. Comme la boucle d'exécution de l'agent s'exécute sur cette machine, Droid peut travailler avec des dépôts privés, des registres de paquets et des services dans un environnement interne. Les clients n'ont pas à exposer publiquement ces systèmes pour les rendre accessibles à un agent. Notre prise en charge de BYOK et de l'inférence auto-hébergée offre un contrôle supplémentaire sur la souveraineté des données.
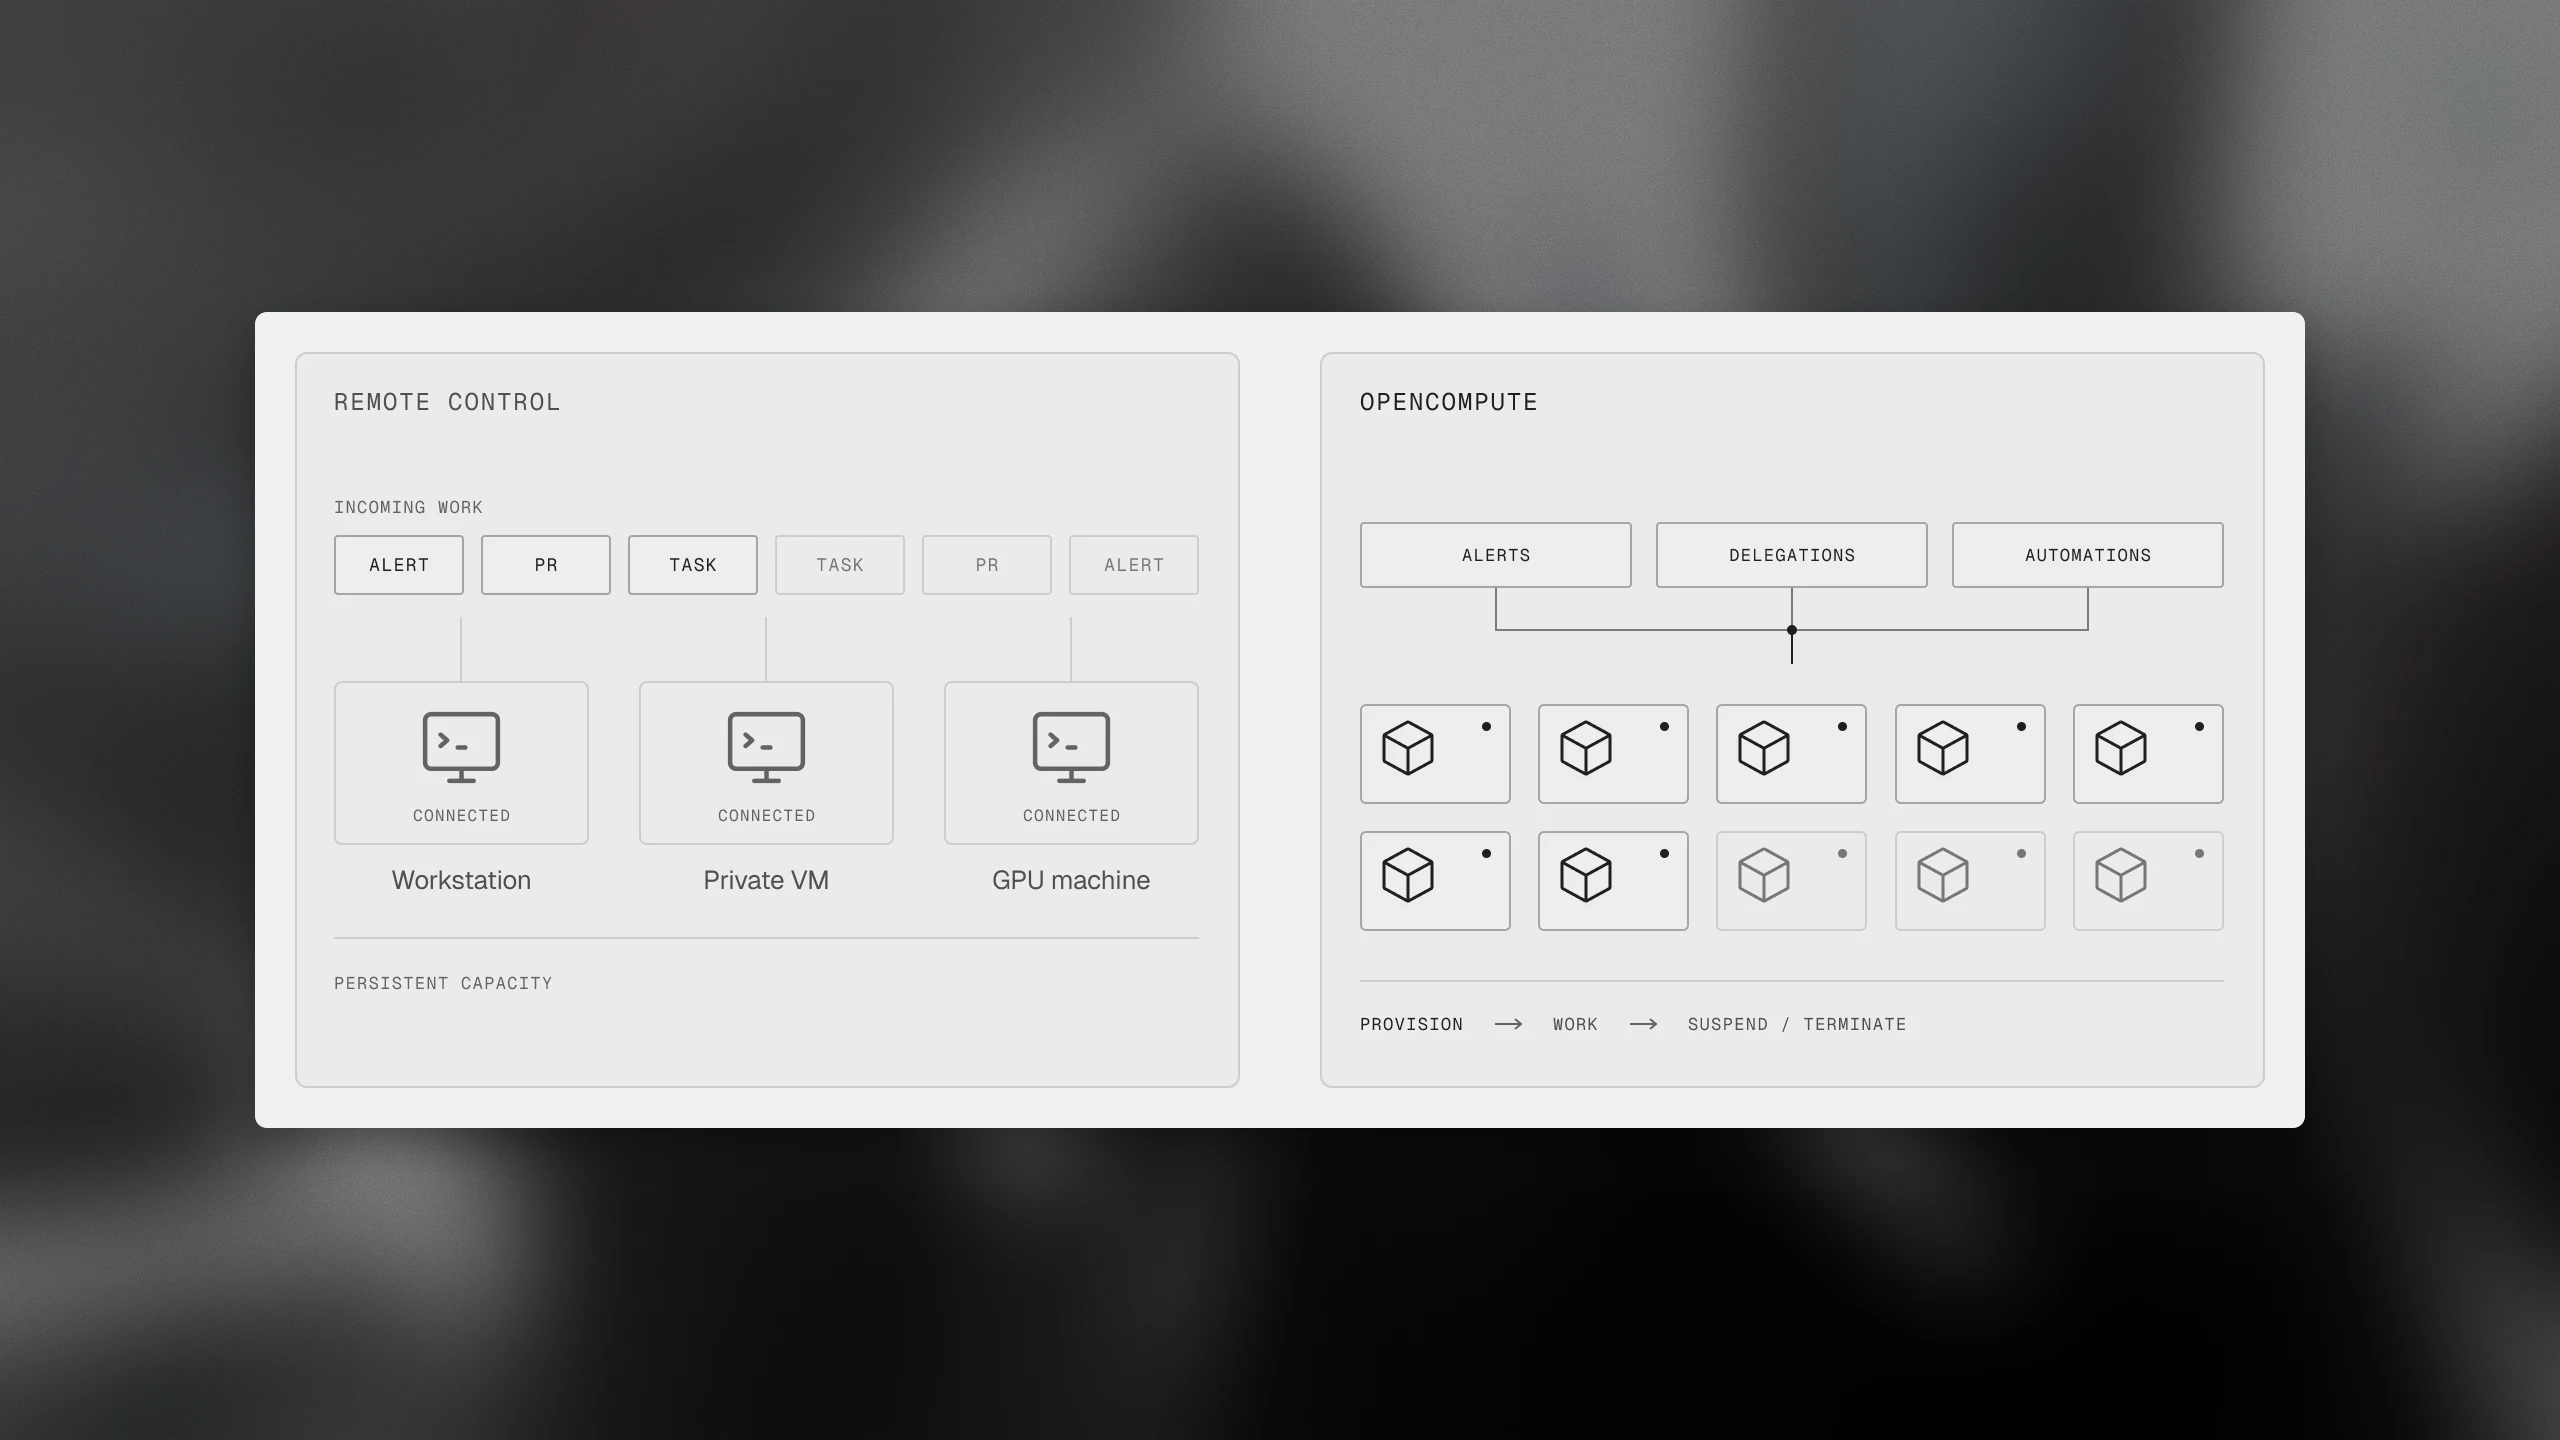
Remote Control a prouvé la valeur de ce modèle, et l'industrie dans son ensemble a évolué dans la même direction. Mais nous avons commencé à voir une autre lacune évidente : nos clients entreprises avaient besoin d'une solution pour gérer des flottes d'ordinateurs, et non un ordinateur à la fois.
Une machine n'est pas une flotte
Remote Control convient bien à une machine persistante associée à un utilisateur ou un service individuel : une station de travail configurée, une VM de développement ou une machine dotée d'un matériel spécialisé. Elle répond à la question : comment amener les agents là où j'en ai le plus besoin ?
Mais nous avions besoin d'un calcul répondant aux demandes d'organisations entières, prenant en charge des sessions interactives tout en permettant aux agents d'opérer de manière indépendante au fil du travail.
Une alerte devrait pouvoir déclencher une enquête sans que quelqu'un doive d'abord provisionner une VM. Une rafale de délégations Slack ne devrait pas laisser une équipe compter les machines disponibles. Une tâche terminée ne devrait pas laisser des ressources inutilisées s'exécuter indéfiniment.
Notre offre gérée prenait déjà en charge une partie de ce cycle de vie. Les machines auto-hébergées ne bénéficiaient pas de la même intégration native de provisionnement, de suspension et de reprise. Les clients pouvaient exécuter Droid où ils le souhaitaient, mais ils devaient gérer la flotte eux-mêmes.
Des sandboxes partout
Nous avons constaté une grande variation dans l'infrastructure cloud de nos clients. Certains voulaient des agents s'exécutant sur des clusters Kubernetes existants, d'autres sur du matériel spécialisé, et d'autres encore sur une plateforme interne dont leurs développeurs dépendaient déjà. D'autres mettaient en place une nouvelle infrastructure microVM ou cherchaient une solution.
Notre mission n'était pas seulement de fournir aux clients des flottes de sandboxes. Nous devions faire fonctionner la gestion de flotte sur n'importe quelle infrastructure. Nous devions apporter l'orchestration dans l'environnement du client, et non amener chaque client dans le nôtre.
Les travaux ne manquent pas sur les environnements sandbox pour agents. Les plateformes sandbox cloud tierces incluent E2B, Daytona et Modal. Des projets tels que Kubernetes Agent Sandbox, l'Agent Substrate de Google et les MicroVM d'AWS Lambda montrent également une demande croissante pour des solutions bring-your-own-cloud et bring-your-own-infrastructure.
Chaque plateforme fait des compromis différents entre isolation, persistance, vitesse de démarrage, simplicité opérationnelle et flexibilité de déploiement. Un backend adapté aux tâches de courte durée peut ne pas convenir à un environnement de développement persistant. Un service qui fonctionne bien pour une startup peut être indisponible dans le réseau d'une entreprise réglementée. Et la meilleure option dans six mois peut différer de la meilleure option aujourd'hui.
Nous avons décidé de construire une couche au-dessus de l'infrastructure de calcul. OpenCompute gère le cycle de vie commun : demander un ordinateur, l'amener à l'état souhaité, suivre son activité, et le suspendre ou le terminer selon la politique et les capacités du fournisseur. Le fournisseur possède les mécanismes d'infrastructure qui rendent ces opérations possibles. Cela nous permet de bénéficier des améliorations de tout l'écosystème sans faire attendre les clients pendant que nous remplaçons les fondations de notre produit.
Faire en sorte que les interfaces fassent le travail
Le développement d'OpenCompute a été agent-native dès le départ, en commençant par une Mission destinée à prouver le concept. Notre travail consistait à définir les frontières, spécifier le comportement et rendre la correction testable. Les Droids ont géré le reste sous direction humaine.
Cela rendait la conception des interfaces particulièrement importante. « Ajouter la prise en charge de ce fournisseur » est une mission sans limites. « Implémenter ce contrat et satisfaire ces tests de conformité » donne à un agent un problème délimité et une définition vérifiable du succès.
La même séparation qui rendait OpenCompute flexible pour les clients le rendait constructible. Un nouveau pilote, l'intégration propre à chaque fournisseur, pouvait se concentrer sur son fournisseur sans réécrire la gestion de flotte. Le plan de contrôle partagé pouvait s'améliorer sans devoir apprendre l'API d'un autre cloud.
Cette approche nous a permis de développer et d'évaluer des intégrations sur AWS Lambda MicroVMs, Kubernetes, EC2, Agent Sandbox, Agent Substrate et d'autres fournisseurs expérimentaux. Il ne s'agissait pas d'implémentations identiques ni de backends d'égale maturité. C'était le but : l'architecture pouvait accommoder les différences sans transformer chacune d'elles en un produit distinct.
Six semaines jusqu'au premier déploiement
L'épreuve la plus claire est venue de notre premier déploiement client. Le client avait besoin d'OpenCompute dans un environnement on-premises sur mesure avec une interface de fournisseur développée en interne. Juste avant d'embarquer dans notre vol pour rencontrer le client, nous avons lancé une Mission pour construire le pilote initial de son environnement avec les informations dont nous disposions.
Au moment où nous avons atterri, le pilote était construit. Après deux jours sur place, le client a provisionné son premier sandbox via OpenCompute. Du point de vue de l'utilisateur, cela ressemblait à la création d'un Droid Computer géré, mais le sandbox tournait dans le centre de données du client. Nous n'avons pas eu besoin d'inventer une nouvelle architecture pour ce client. Nous avons dû connecter son infrastructure à une interface que nous avions déjà définie.
Du premier prototype à ce premier déploiement client : six semaines.
Cette première intégration n'était pas la fin du travail d'ingénierie. La persistance, la récupération, les outils de déploiement et le durcissement opérationnel ont continué ensuite. Mais cela a validé le pari central : intégrer un nouveau fournisseur pouvait être un problème de pilote, et non une réécriture de la plateforme.
Vue d'ensemble de l'architecture
OpenCompute est un service auto-hébergé qui connecte le backend Factory au plan de calcul sous-jacent du client.
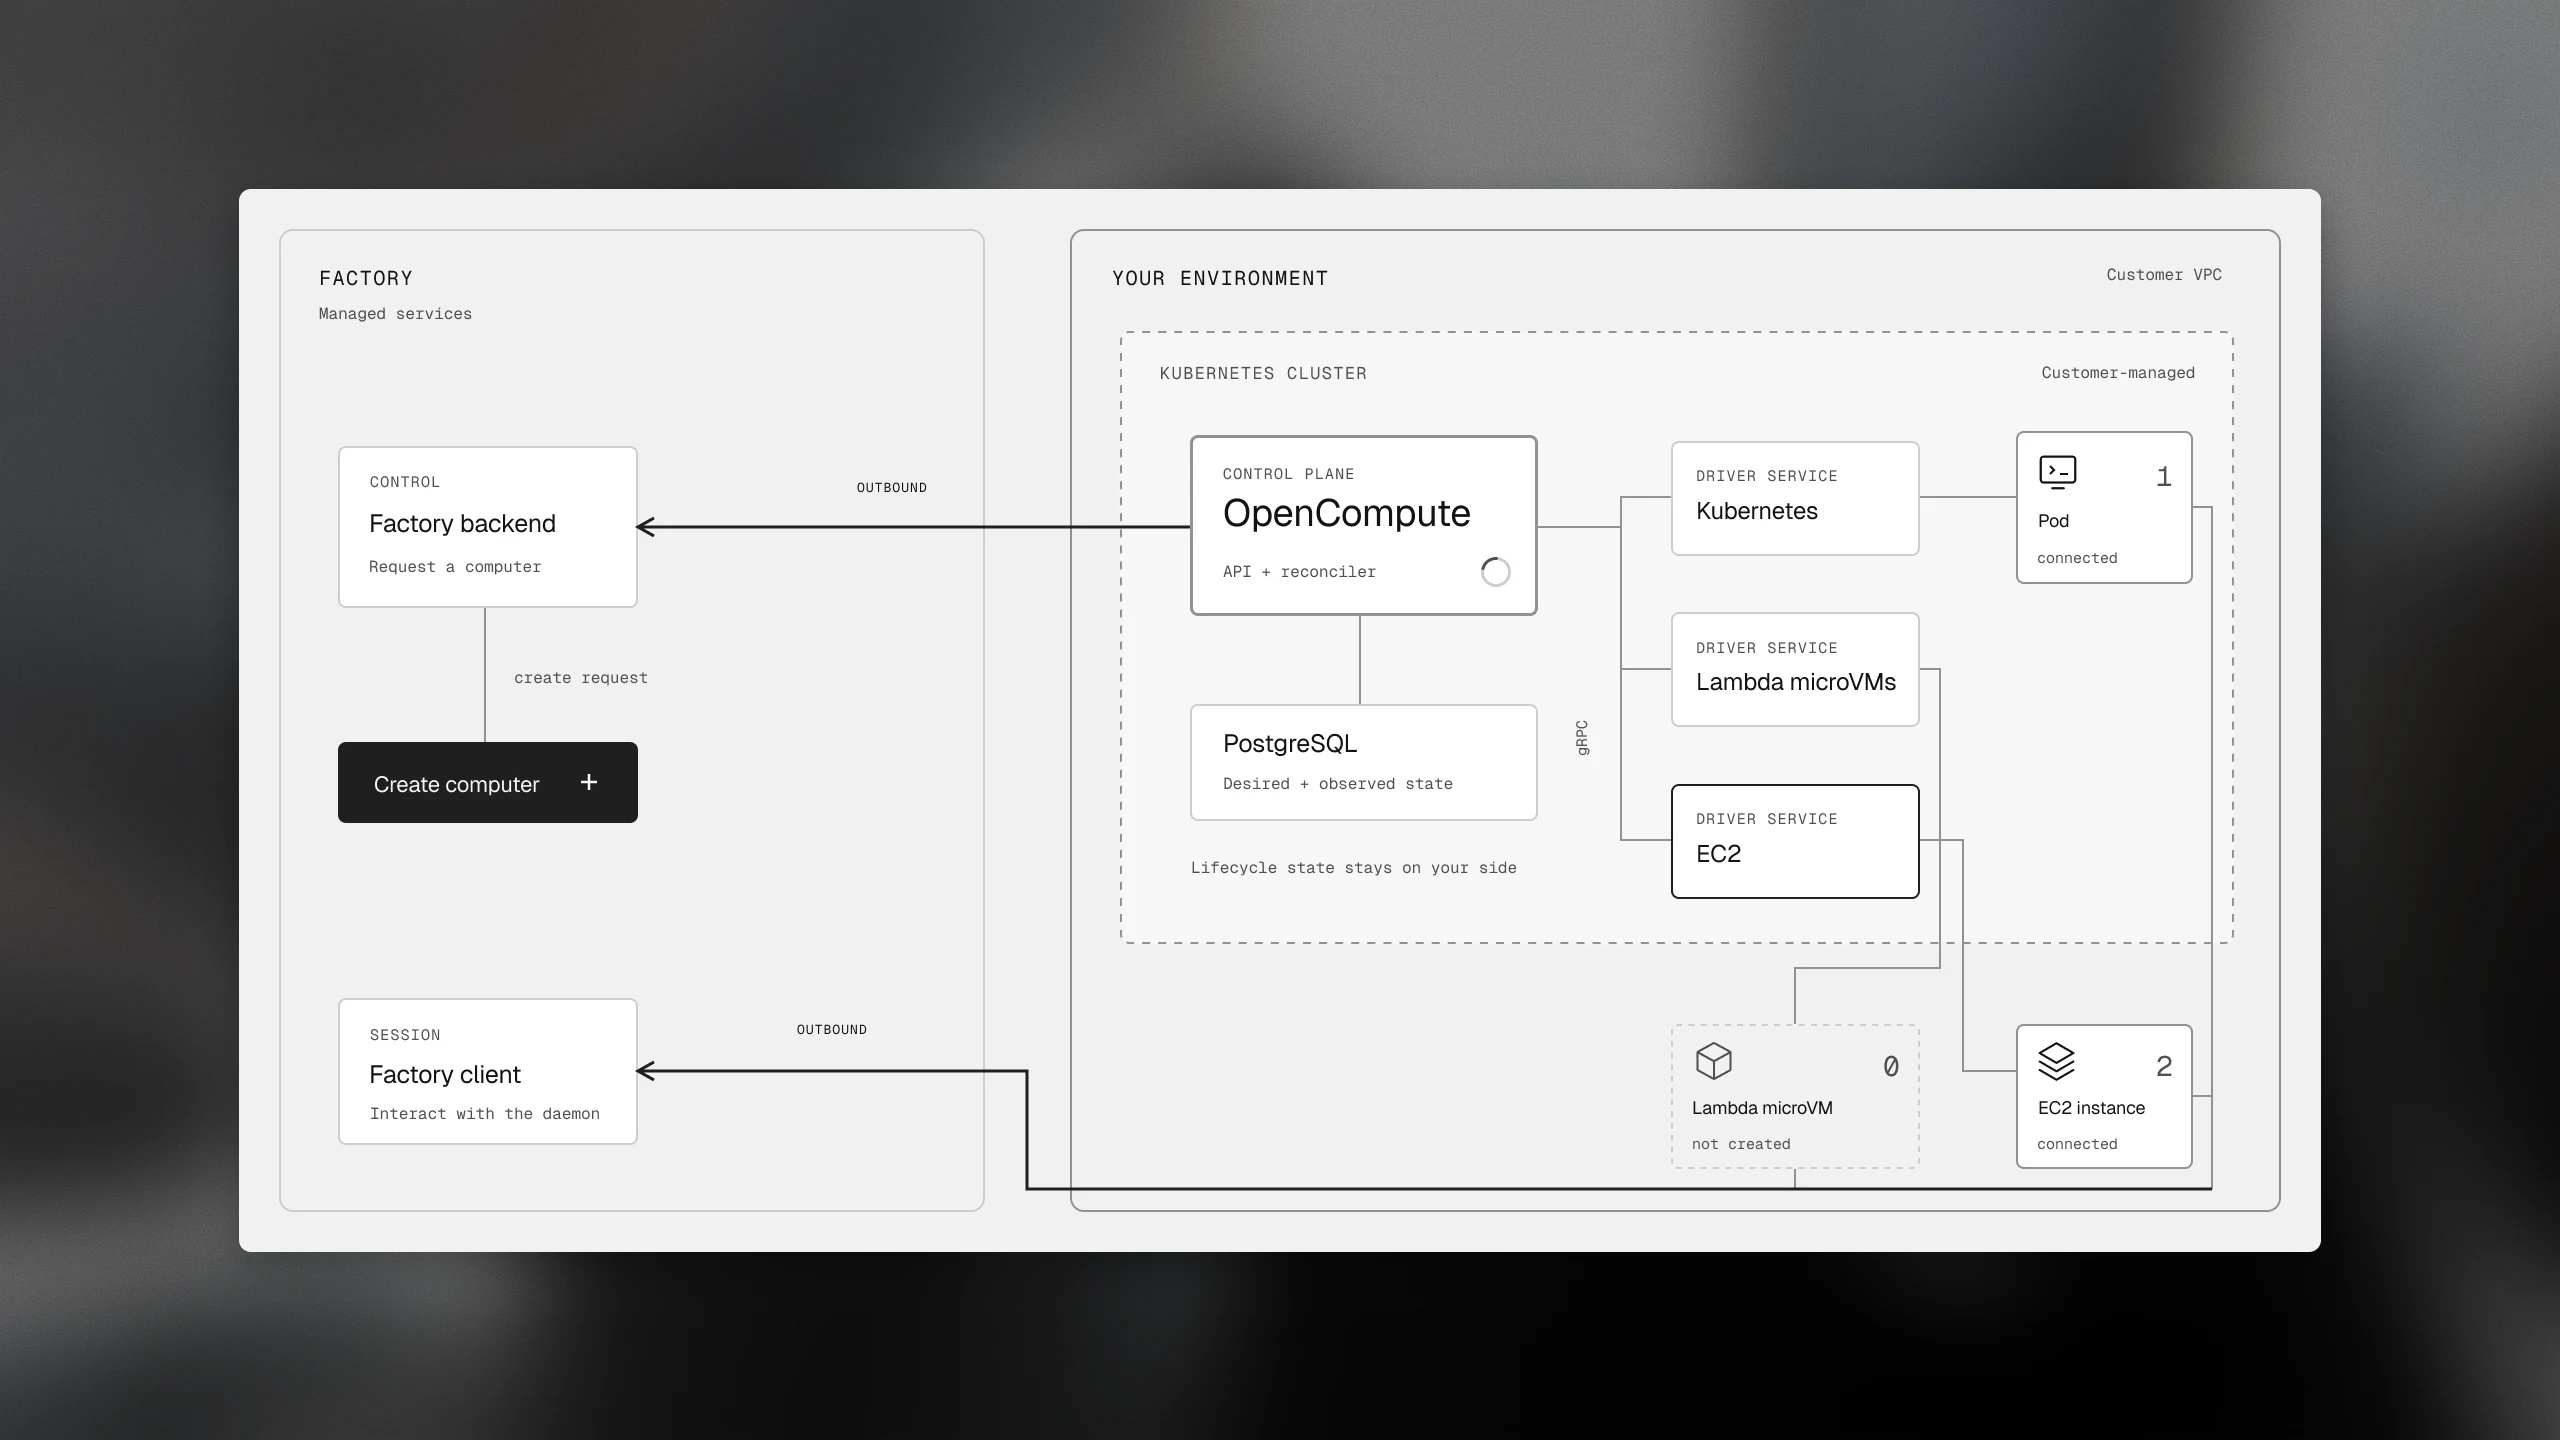
Connexion sortante, exécution à l'intérieur
OpenCompute s'exécute dans votre environnement et établit une connexion WebSocket sortante sécurisée par TLS vers Factory. Factory envoie des requêtes de calcul autorisées via cette connexion. Vous n'avez pas besoin d'exposer un point de terminaison OpenCompute public ni d'ouvrir un port de pare-feu entrant pour Factory.
Lors de l'enrôlement, votre déploiement OpenCompute enregistre une clé publique auprès de Factory. Lors de la connexion, il prouve la possession de la clé privée correspondante en signant un challenge frais. La clé privée reste sous votre contrôle et peut résider dans un KMS cloud pris en charge.
Chaque sandbox provisionné par OpenCompute établit sa propre connexion sortante vers Factory, exactement comme les ordinateurs contrôlés à distance aujourd'hui. Les dépôts internes et les services peuvent rester privés. Droid les atteint depuis l'intérieur de votre réseau.
Une remarque sur l'emplacement des données : Le placement du calcul est distinct du routage d'inférence et du stockage des sessions. Le fait de garder les données de session entièrement en local dépend de votre configuration d'inférence et de synchronisation.
Enregistrer l'intention, puis réconcilier
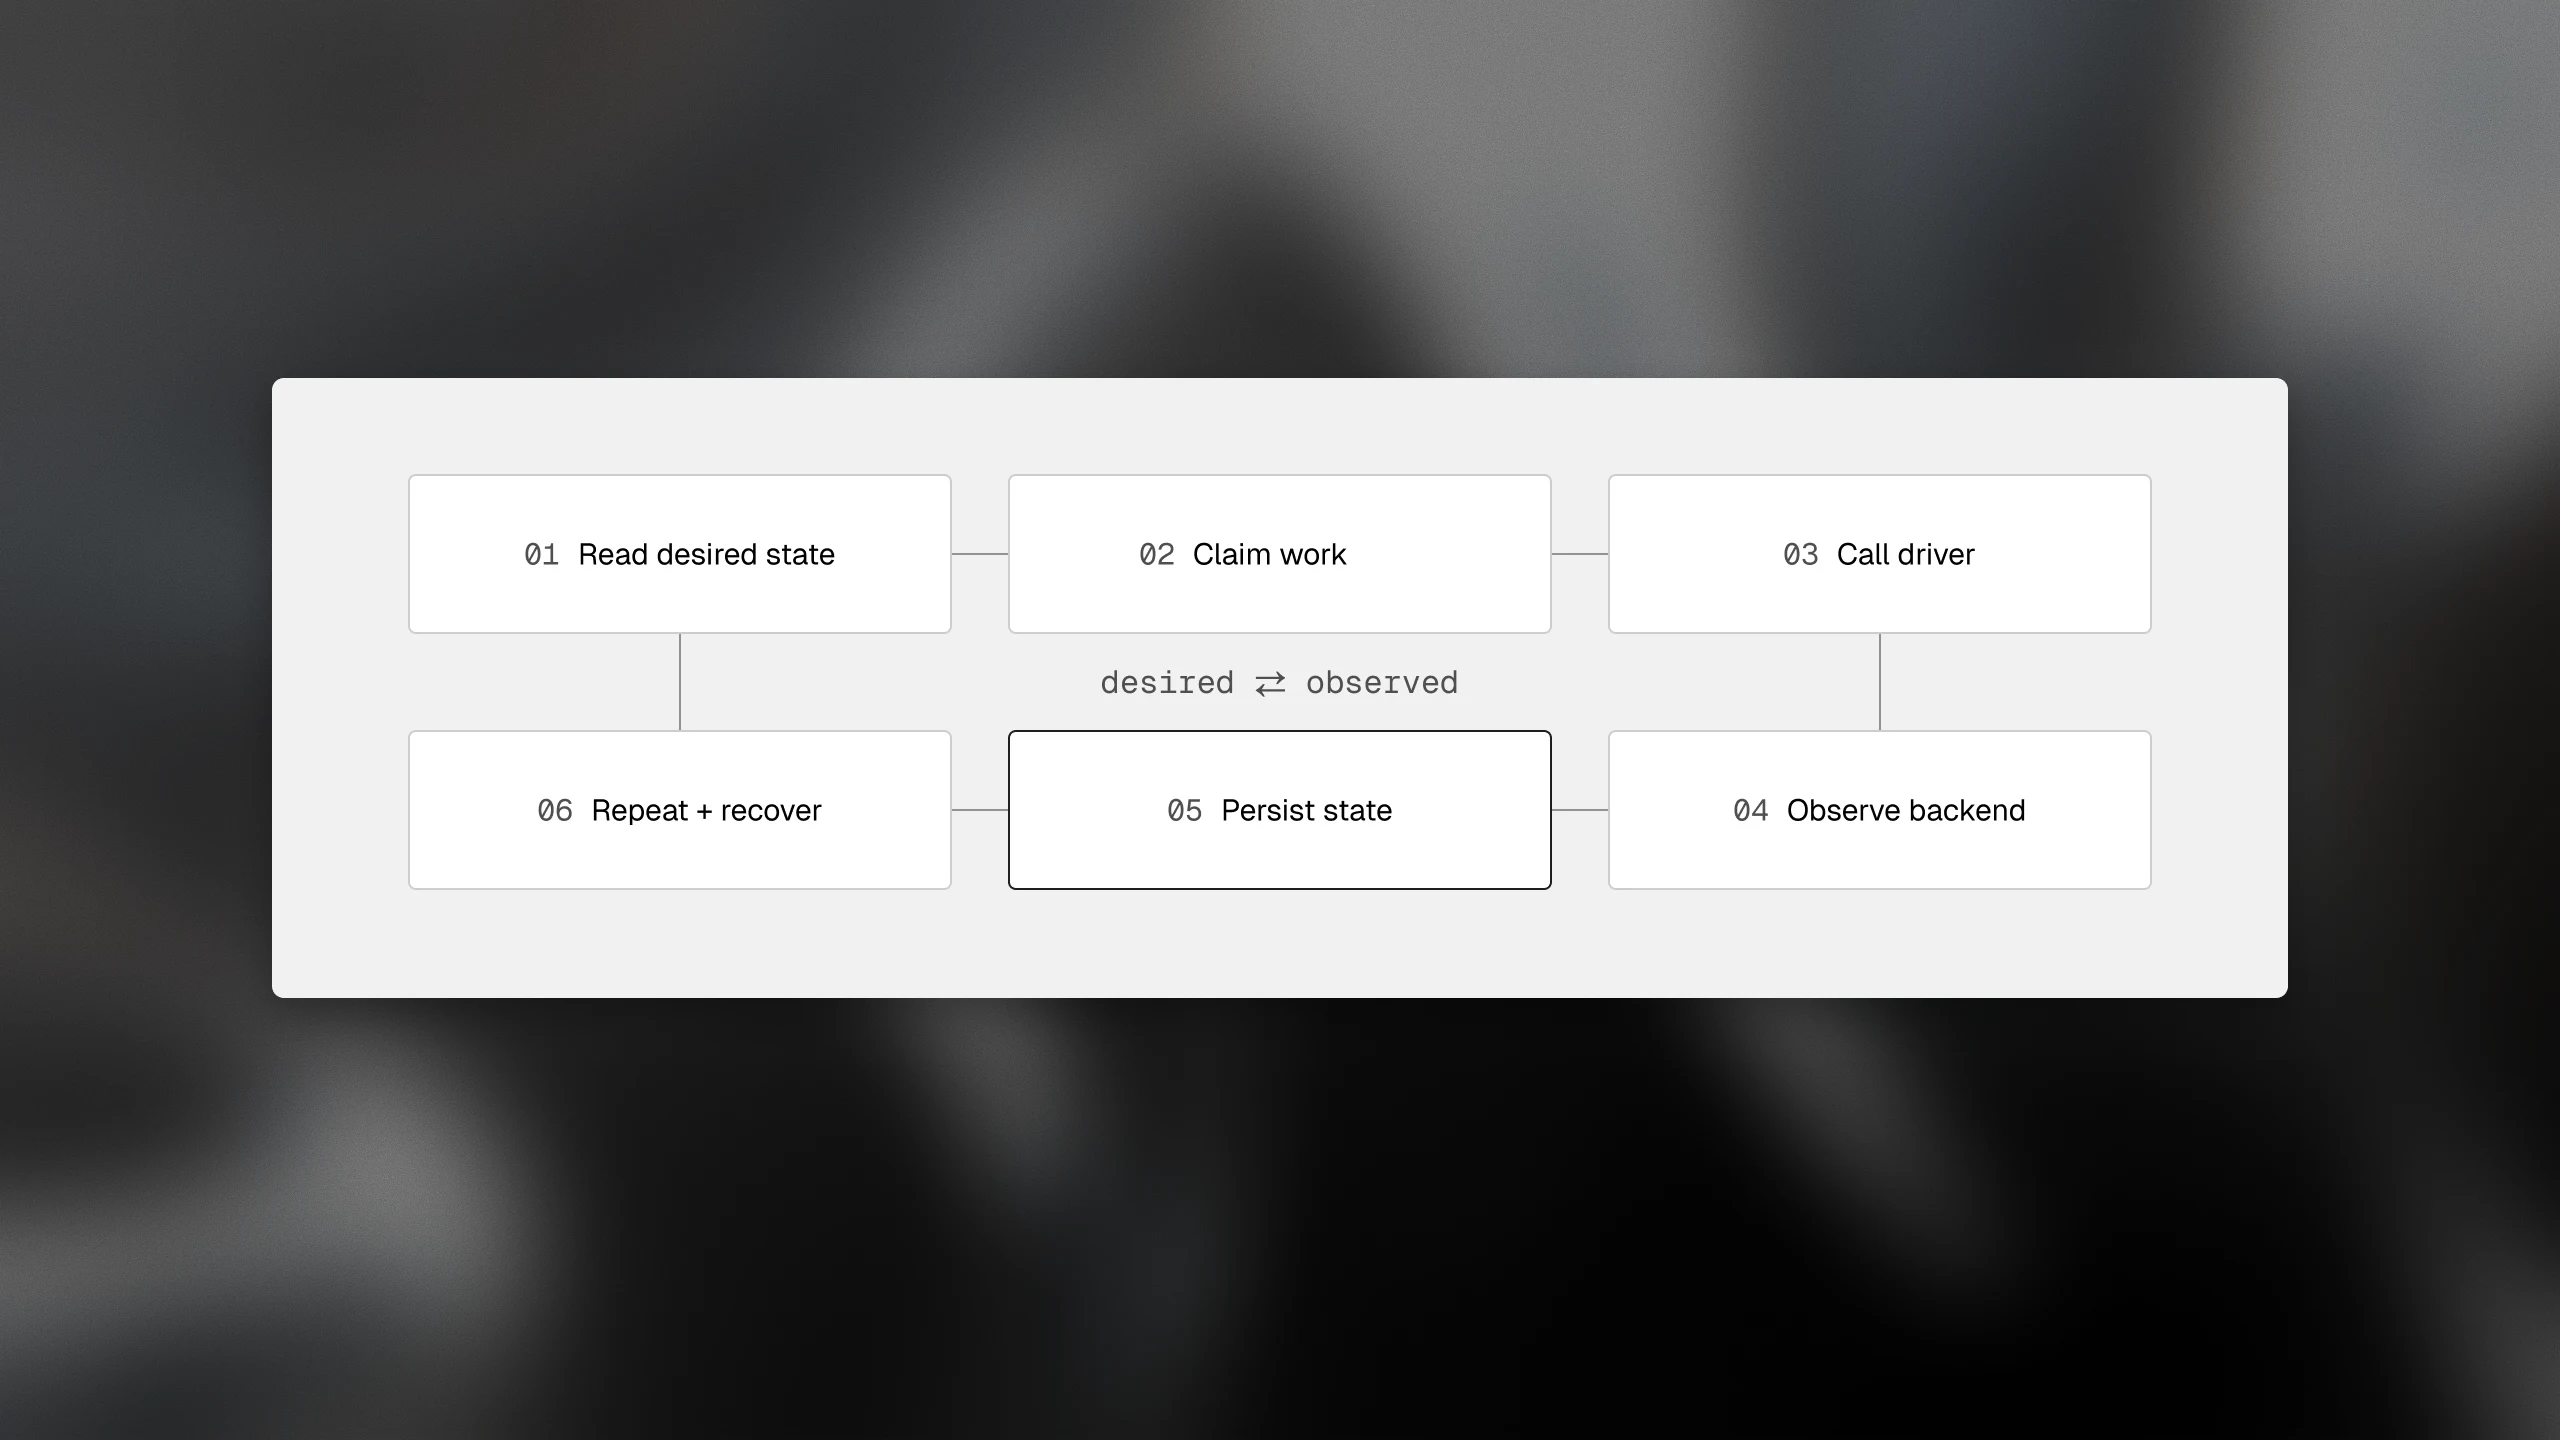
Le provisionnement n'est pas un simple appel API fiable, surtout lorsqu'on traite avec des fournisseurs peu familiers. Les connexions disparaissent. Les fournisseurs imposent un débit limité. Les processus redémarrent après qu'une requête a réussi mais avant l'arrivée de la réponse. OpenCompute traite cela avec un modèle de cycle de vie déclaratif. Son plan de contrôle en Go enregistre l'état souhaité et observé des ordinateurs dans une base de données Postgres exécutée dans votre environnement. Un reconciler travaille en continu pour amener l'ordinateur à l'état demandé.
La création d'un ordinateur enregistre une intention durable plutôt que de maintenir une requête ouverte jusqu'à ce qu'un fournisseur termine. Le reconciler gère le provisionnement et l'observation, réessaie les échecs récupérables et pilote les transitions de cycle de vie prises en charge. Comme l'intention est durable, un redémarrage du plan de contrôle n'efface pas le travail inachevé.
Les ordinateurs sont lancés à partir de Builds immuables, séparant la préparation de l'environnement de la création de la machine. Un stockage compatible S3 conserve les artefacts de build et les charges utiles des instantanés. Les signaux d'activité et les paramètres de cycle de vie par ordinateur indiquent au plan de contrôle quand maintenir un ordinateur en fonctionnement et quand entreprendre une action de cycle de vie.
Standardiser le comportement, pas l'infrastructure
Chaque intégration de fournisseur s'exécute comme un pilote gRPC autonome. Le pilote traduit les opérations communes dans les mécanismes natifs du backend pour créer, observer, exécuter des commandes sur et détruire des ordinateurs.
Le comportement propre à chaque fournisseur reste hors de la base de données et de la logique de réconciliation du plan de contrôle. Les pilotes peuvent utiliser le transport et le runtime appropriés à leur backend plutôt que d'adopter un guest agent obligatoire unique.
Mais une interface commune n'est utile que si elle est honnête quant aux différences. Tous les backends ne peuvent pas suspendre un ordinateur, prendre un instantané de son disque ou le dupliquer (fork). OpenCompute définit donc un profil de conformité Core obligatoire et des profils optionnels Suspend, Snapshot et Fork. Des tests boîte noire vérifient le comportement qu'un pilote prétend prendre en charge. Les requêtes non prises en charge sont rejetées avant toute modification d'état durable, plutôt que d'apparaître comme des erreurs à mi-chemin du provisionnement.
Le contrat est également neutre vis-à-vis des fournisseurs. Factory est un client possible d'OpenCompute, et les pilotes restent agnostiques aux fonctionnalités propres à Factory. OpenCompute expose sa propre API, son CLI et son panneau d'administration, car la couche qui gère votre calcul devrait être utile indépendamment du produit qui l'a d'abord demandée.
Et maintenant
Nous prévoyons d'open-sourcer OpenCompute. L'objectif n'est pas seulement de publier l'implémentation, mais de rendre les contrats, les tests de conformité et le modèle de pilote utiles aux personnes qui construisent des systèmes d'agents.
Nous le voyons également comme le fondement de l'avenir de Factory. Les sessions interactives, les Automatisations planifiées, les enquêtes sur les incidents et le travail délégué ne devraient pas chacun nécessiter leur propre infrastructure. Ils devraient pouvoir demander l'environnement dont ils ont besoin via la même couche de cycle de vie, que Factory ou le client l'exploite.
Nous sommes ravis de mettre ce fondement entre davantage de mains et de voir quels fournisseurs les gens connecteront ensuite.
L'avenir des charges de travail agentiques ne fonctionnera pas sur un seul type de machine dans le cloud d'une seule entreprise. OpenCompute est notre manière de construire pour cet avenir.
OpenCompute est désormais en préversion privée. Si vous souhaitez explorer OpenCompute, contactez votre gestionnaire de compte chez Factory.