
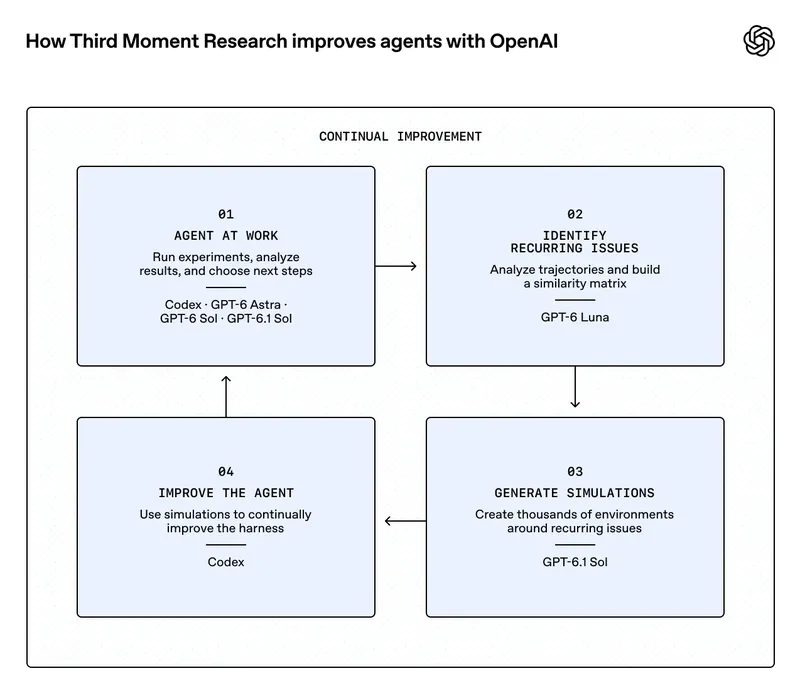
Chaque entreprise a ses propres flux de travail, outils, cas limites et définitions du succès. (s'ouvre dans une nouvelle fenêtre)Third Moment Research(s'ouvre dans une nouvelle fenêtre) estime que les meilleurs agents devraient être vraiment doués pour ce travail spécifique et devraient améliorer leurs capacités plus ils sont utilisés.
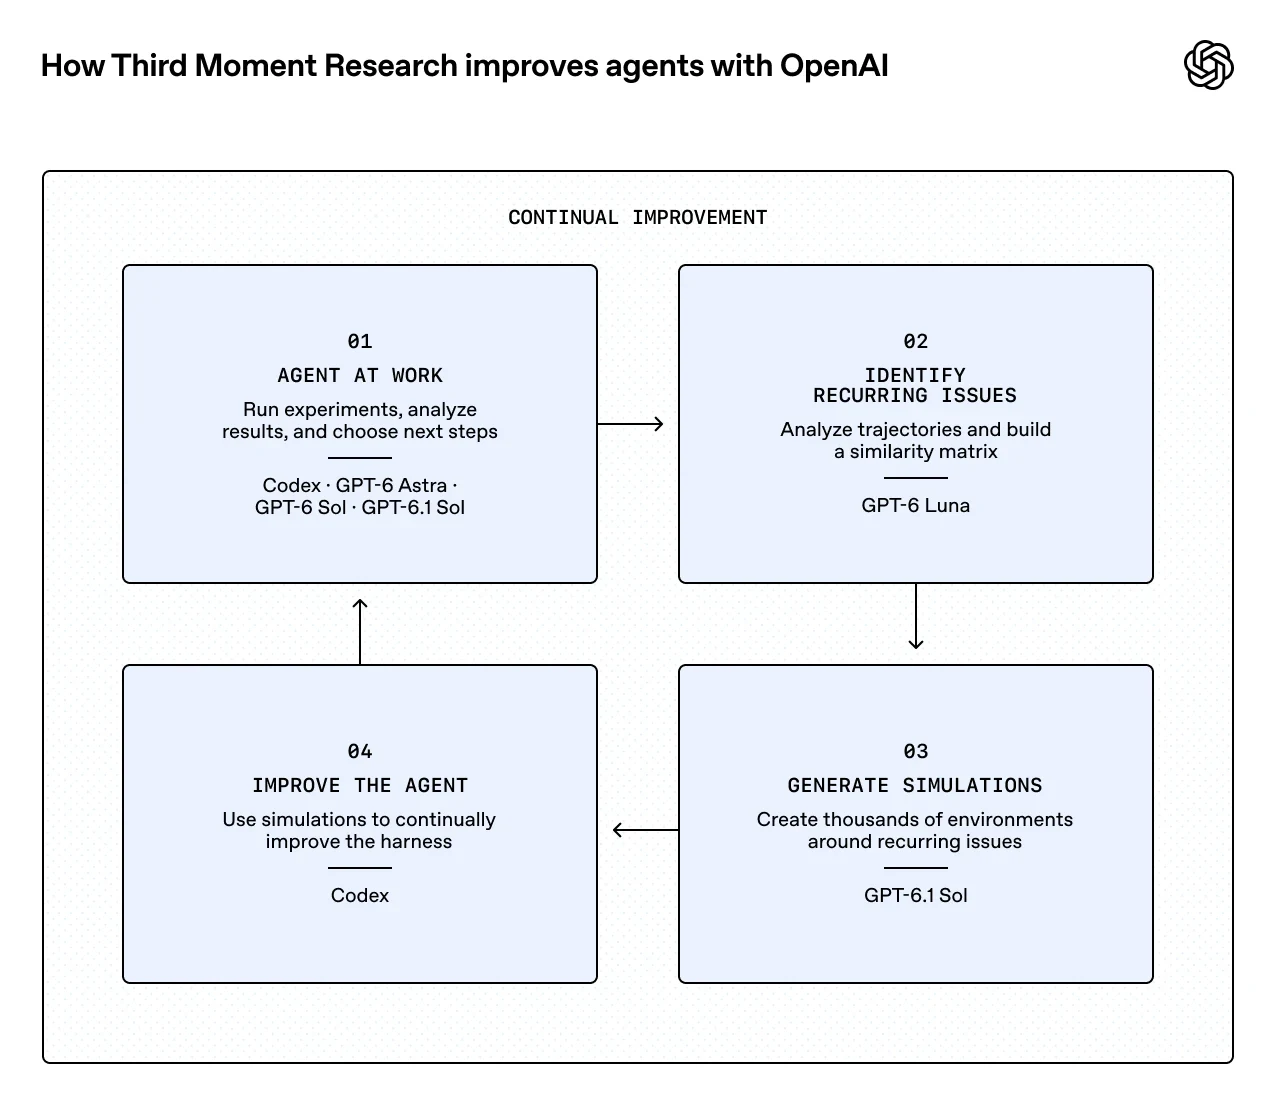
L'entreprise construit un système d'IA auto-améliorant autour de cette idée, en utilisant les derniers modèles d'OpenAI pour comprendre le comportement des agents, identifier les faiblesses récurrentes et créer automatiquement des milliers de scénarios synthétiques autour de ces problèmes. L'équipe utilise ces scénarios pour améliorer les agents, en répétant le processus à mesure que de nouveaux problèmes apparaissent.
Codex, GPT‑6 Astra, GPT‑6 Sol et GPT‑6.1 Sol prennent en charge les travaux de recherche et de calcul du système, permettant à Third Moment de faire tourner 10,000 agents à la fois sur des enquêtes durant 36 à 48 heures. L'entreprise utilise également Daybreak pour tester la sécurité des environnements où travaillent les agents.
« En une seule session, GPT-6.1 Sol est capable de maintenir un fil cohérent de recherche computationnelle sur plusieurs jours de calcul sans perdre le fil de l'analyse. »—Adam Khakhar, cofondateur, Third Moment Research
Réduire le temps d'exécution et le gaspillage de tokens avec Codex
L'une des premières applications de Third Moment se situe dans le domaine de la finance quantitative, étant donné la mesure claire du succès. Ce domaine fournit un cadre concret pour étudier comment les agents fonctionnent et où ils rencontrent des difficultés. L'équipe utilise Codex pour trouver et corriger les problèmes dans l'environnement de recherche.
À une occasion, elle a utilisé Codex avec GPT‑5.6, le dernier modèle GPT à l'époque, pour analyser des milliers de trajectoires de simulation enregistrées (les actions des agents et les réponses de l'environnement) ainsi que les horodatages et la base de code.
Codex a mis en évidence un goulot d'étranglement : le backtesting d'une stratégie de trading sur une année de données boursières américaines au niveau des ordres prenait plusieurs heures. En attendant, les agents interrogeaient repeatedly l'achèvement, gaspillant des tokens et remplissant leur contexte de vérifications de statut.
Après avoir profilé le backtest et analysé ses entrées et son utilisation, Codex a identifié une optimisation par mise en cache et une technique de compression mémoire. Il a expérimenté des solutions et déployé le correctif en production, réduisant le backtest d'environ 3 heures à environ 3 à 5 minutes. Cela a réduit l'utilisation de tokens et la pollution du contexte, libérant une plus grande partie du budget de tokens des agents pour d'autres expériences.
Garder les agents concentrés sur leur tâche avec Codex et GPT‑6
Third Moment fournit à chaque agent les outils, les informations et l'environnement dont il a besoin pour une tâche spécifique. Pour la recherche quantitative, l'équipe exécute le harnais Codex par défaut dans un environnement Dockerisé. Les agents reçoivent un téraoctet de données, de la documentation et un dépôt de recherche avec des modules pour l'ingénierie des caractéristiques, l'entraînement de modèles sur GPU, les stratégies de trading et la simulation.
GPT‑6 Astra, GPT‑6 Sol et GPT‑6.1 Sol fournissent le raisonnement, tandis que le harnais Codex donne aux agents des outils pour agir, créer des plans, définir des objectifs, générer des sous-agents et compacter le contexte à mesure que le travail se poursuit.
Pour traiter les agents qui s'arrêtent avant de terminer une tâche, Third Moment traite Codex comme un sous-agent au sein d'un harnais externe propulsé par GPT‑6 Sol ou GPT‑6.1 Sol. Le harnais externe examine la trajectoire lorsqu'une tâche reste inachevée et détermine s'il faut réessayer, terminer le travail ou escalader vers une revue humaine.
« Le harnais Codex est extrêmement polyvalent, et il permet une utilisation dans de nombreux domaines différents. »—Adam Khakhar, cofondateur, Third Moment Research
Dans cet environnement de recherche, les agents s'efforcent d'améliorer un système de trading de référence construit par les ingénieurs de Third Moment. Ils testent des stratégies de trading sur des données historiques, évaluent si une amélioration est significative ou due au bruit, et utilisent chaque résultat pour choisir l'expérience suivante. Selon Adam, leur travail a amélioré le système de trading de référence.
Prolonger la recherche avec une meilleure efficacité de tokens
Avant GPT‑5.5, dit Adam, les modèles ne pouvaient exécuter que les expériences prescrites par un utilisateur. Avec GPT‑5.5 et GPT‑5.6, les modèles travaillant avec le harnais Codex pouvaient utiliser les résultats pour concevoir des expériences de suivi. Maintenant, avec GPT‑6 Astra, GPT‑6 Sol et GPT‑6.1 Sol, les agents peuvent enquêter sur les causes profondes à travers des centaines d'expériences exécutées en parallèle avec des sous-agents.
Cette progression a aidé les agents à explorer des directions de recherche que l'équipe n'avait pas anticipées. Lors d'une session, GPT‑6.1 Sol a identifié l'impact des transactions non affichées sur une bourse où ces transactions représentaient une part étonnamment importante du volume. « C'était un résultat non évident que notre équipe de recherche n'avait pas initialement pris en compte », dit Adam.
Third Moment évalue les modèles dans l'optimisation, les systèmes d'apprentissage automatique et la recherche quantitative. Il teste les versions de pointe à leurs réglages de raisonnement les plus élevés, en évaluant leur capacité à naviguer dans des dépôts, à écrire du code efficace et à soutenir une enquête. Les tests actuels incluent également GPT‑6 Luna.
« GPT-6.1 Sol est actuellement notre modèle le plus utilisé en raison de son efficacité en tokens. Il accomplit les tâches avec le moins de tokens tout en offrant des performances similaires à celles de GPT-6 Astra. »—Jeffrey Yan, cofondateur, Third Moment Research
L'un des benchmarks demande aux agents de réduire la latence de mise à jour d'un service de tableau de bord en direct tout en préservant ses sorties. L'équipe mesure l'accélération en divisant le temps d'exécution moyen d'une solution conçue par un expert par celui de la solution du modèle sur le même matériel, sous réserve d'exactitude. GPT‑6 Astra a réalisé la plus grande accélération, selon Adam.
Pour les travaux ciblés, y compris la vérification de faiblesses de sécurité spécifiques dans le système de simulation, l'équipe utilise des modèles plus efficaces comme GPT‑5.6 Terra. Pour la recherche approfondie, Adam estime qu'un raisonnement plus puissant peut justifier un coût plus élevé : « Dans le domaine de la finance quantitative, la valeur de la découverte d'un signal intéressant est extrêmement élevée. »
Automatiser les tests de sécurité avec Daybreak
Avec 10,000 agents fonctionnant de manière autonome, Third Moment a besoin d'un moyen de tester la sécurité de ses environnements de recherche à grande échelle. L'équipe utilise la plateforme de cybersécurité Daybreak pour automatiser ces tests avant le lancement des simulations.
Les tests vérifient si un agent pourrait s'échapper de son environnement de recherche et accéder au réseau plus large. « En utilisant Daybreak, nous pouvons faire en sorte que les agents eux-mêmes effectuent des tests d'intrusion sur la simulation et testent son infrastructure et sa sécurité », explique Adam.
« Sans Daybreak, nous ne pourrions pas tester cela de manière autonome à grande échelle. »—Adam Khakhar, cofondateur, Third Moment Research
Vers des centaines de milliers d'agents collaboratifs
L'ambition de Third Moment s'étend aux travaux spécialisés que les entreprises réalisent chaque jour. Pour un détaillant, cela pourrait signifier prendre de meilleures décisions en matière de chaîne d'approvisionnement lorsque les stocks sont insuffisants ou qu'un fournisseur est en retard. Pour une équipe d'ingénierie, cela pourrait signifier trouver des goulots d'étranglement de performance dans une grande base de code. Pour une entreprise fortement axée sur les documents, cela pourrait signifier identifier les endroits où les engagements d'un document ne correspondent pas aux résultats consignés dans un autre.
En s'appuyant sur les capacités de raisonnement de GPT‑6 Astra, GPT‑6 Sol et GPT‑6.1 Sol, Third Moment prévoit de passer d'enquêtes individuelles à des centaines de milliers de sous-agents collaboratifs. Sa feuille de route prévoit des trillions de tokens prenant en charge des chaînes de dizaines d'expériences dépendantes, avec pour objectif d'utiliser ces recherches pour améliorer automatiquement les agents à mesure que de nouveaux défis se présentent.
Pour Adam, cela donnerait aux gens une plus grande capacité à façonner la manière dont les agents apprennent et travaillent : « Les humains peuvent se retrouver dans une position beaucoup plus levier, où ils peuvent réfléchir à la façon de faire de la recherche et à optimiser la recherche elle-même au lieu de faire réellement la recherche. »