
La recherche d'IDC montre que les défis liés aux documents coûtent aux organisations 19,732 $ par travailleur de l'information chaque année et réduisent la productivité de 21.3 pour cent. Les organisations recevant des factures de centaines de fournisseurs sont souvent confrontées à des mises en page qui varient selon l'émetteur et changent sans préavis. Les systèmes basés sur des modèles exigent une maintenance constante à cette échelle. Le personnel peut consacrer jusqu'à 30 pour cent de son temps à des tâches liées aux documents, et les taux d'erreur de saisie manuelle des données varient de 1 à 4 pour cent. Les solutions conventionnelles de traitement intelligent de documents (IDP) atténuent une partie de cette charge, mais elles nécessitent une configuration initiale approfondie pour chaque format de document et tombent en panne lorsque les mises en page varient selon les fournisseurs.
Dans cet article, vous apprendrez à créer un système IDP agentique utilisant Amazon Bedrock AgentCore qui classe, extrait, valide et apprend à partir de documents d'entreprise avec une intervention humaine minimale. Amazon Bedrock AgentCore est une plateforme permettant de créer, de connecter et d'optimiser des agents à grande échelle, avec n'importe quel framework ou modèle. Vos agents gèrent automatiquement les nouveaux formats de documents, tels que les factures fournisseurs, les bons de commande, les demandes d'indemnisation d'assurance et les demandes de prêt. À la fin de cet article, vous pourrez :
- Déployer un système IDP multi-agents, souvent en moins de 20 minutes.
- Traiter de nouveaux types de documents sans configuration manuelle de modèles.
- Laisser les agents se former sur chaque nouveau format de document et réutiliser ce qu'ils ont appris, afin que les documents ultérieurs de ce type passent directement à l'extraction sans réentraînement.
Les défis du traitement de documents basé sur des règles
De nombreux pipelines IDP exigent que vous définissiez à l'avance des modèles, des règles d'extraction et une logique de validation pour chaque format de document. Lorsqu'un nouveau fournisseur envoie un bon de commande avec une mise en page différente, le pipeline tombe en panne. Cela crée trois défis majeurs :
- Rigidité des modèles : Chaque nouveau format de document nécessite une configuration manuelle, et même des changements mineurs de mise en page peuvent provoquer des échecs d'extraction.
- Aucun apprentissage : Les mêmes erreurs d'extraction se répètent sur des documents similaires, car le système ne conserve pas les connaissances issues des corrections précédentes.
- Charge de mise à l'échelle : Chaque nouveau fournisseur ou variante de document multiplie l'effort de maintenance, et les organisations traitant des documents provenant de centaines de sources font face à des coûts opérationnels continus.
Une approche agentique répond à ces défis. Au lieu de modèles statiques, des agents d'IA analysent chaque document, génèrent des instructions d'extraction, valident les résultats et apprennent automatiquement des corrections. Au fil du temps, votre système construit une base de connaissances des formats de documents, vous permettant ainsi de traiter des documents similaires avec une configuration supplémentaire minimale.
Aperçu de la solution
Dans cette solution, huit agents spécialisés collaborent au sein de deux workflows basés sur des graphes exécutés sur Amazon Bedrock AgentCore.
Le diagramme suivant montre le graphe de workflow multi-agents construit à l'aide de Strands Agents, un SDK open source pour créer des agents d'IA.
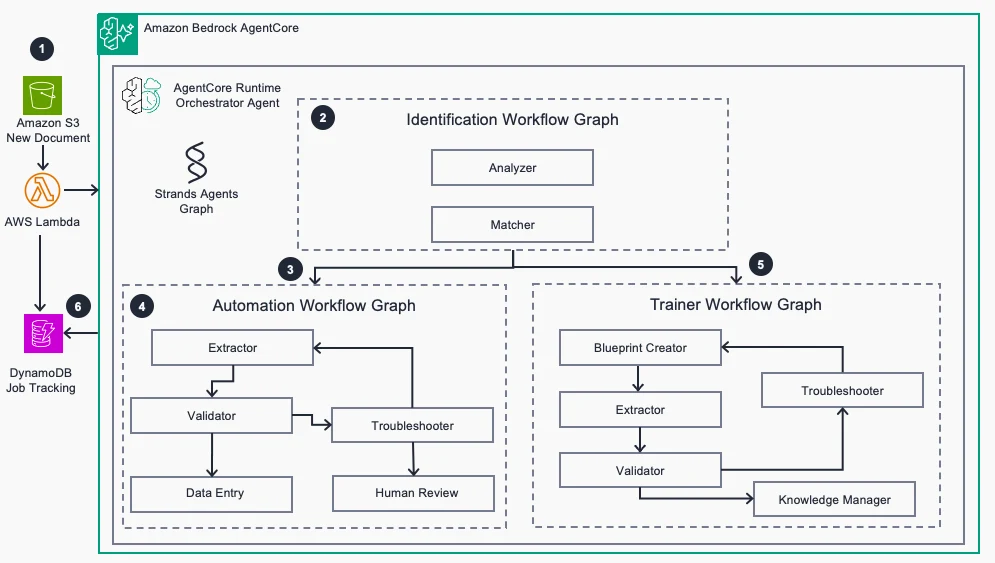
Figure 1 : Graphe du workflow d'orchestration multi-agents
- Workflow d'identification: L'agent Analyzer extrait le texte à l'aide d' Amazon Textract et identifie le type de document et l'expéditeur. L'agent Matcher recherche des documents similaires en utilisant la similarité vectorielle dans Amazon S3 Vectors, une fonctionnalité d'Amazon Simple Storage Service (Amazon S3).
- Workflow d'entraînement (nouveaux types de documents) : lorsqu'aucune correspondance n'est trouvée, l'agent Instructions génère des prompts d'extraction, l'agent Extractor extrait les données structurées, et l'agent Validator vérifie les résultats par rapport aux schémas et aux règles métier dans Amazon Aurora DSQL. Si la validation échoue, l'agent Instructions Fixer affine les prompts et réessaie. En cas de succès, l'agent Save Instructions conserve les instructions pour une réutilisation ultérieure.
- Workflow d'automatisation (types de documents connus) : lorsqu'une correspondance est trouvée, l'agent Extractor utilise les instructions existantes. Si la validation échoue, l'agent Troubleshooter corrige directement les données extraites sans modifier les instructions.
Fonctionnement
Le diagramme suivant montre l'architecture d'infrastructure de la solution.
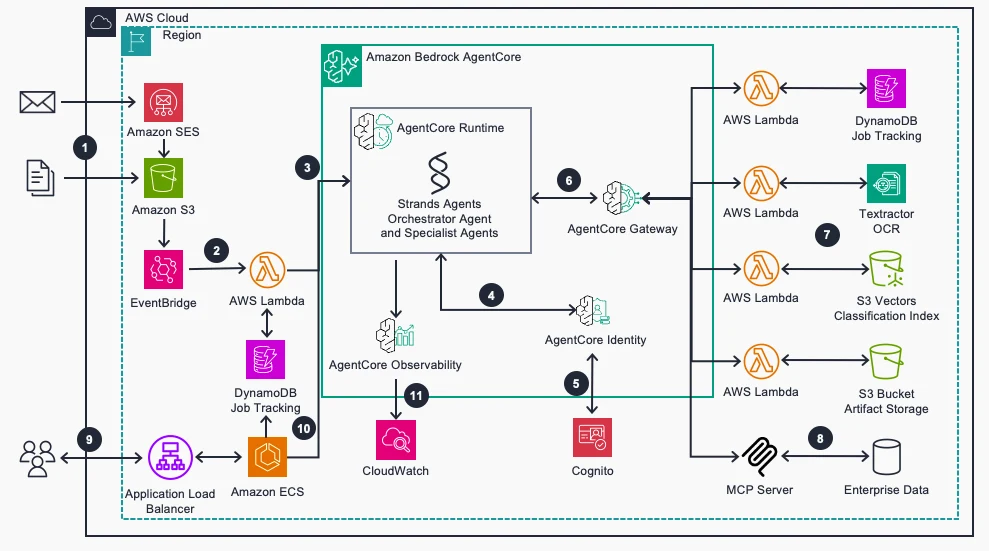
Figure 2 : architecture d'infrastructure IDP agentique sur AWS
- Les documents professionnels arrivent dans Amazon Simple Email Service (Amazon SES) ou par téléversement direct vers Amazon S3.
- Amazon EventBridge déclenche une fonction AWS Lambda qui crée une tâche de suivi dans Amazon DynamoDB et invoque AgentCore runtime, une fonctionnalité d'Amazon Bedrock AgentCore.
- AgentCore runtime orchestre le traitement des documents via Strands Agents.
- Vos agents accèdent de manière sécurisée aux ressources AWS via des identifiants machine à machine gérés par AgentCore Identity, une capacité d'Amazon Bedrock AgentCore, et Amazon Cognito.
- Vos fonctions Lambda deviennent des outils compatibles avec les agents grâce à l'interface Model Context Protocol (MCP) d'AgentCore Gateway, une capacité d'Amazon Bedrock AgentCore.
- Les agents extraient le texte avec Amazon Textract, classifient les documents à l'aide de vector embeddings dans S3 Vectors et valident les données par rapport aux règles métier dans Aurora DSQL.
- Les agents accèdent aux données d'entreprise via des serveurs MCP pour valider le contenu extrait par rapport aux règles métier.
- Vous surveillez l'état et résolvez les problèmes via un tableau de bord avec chat hébergé sur Amazon Elastic Container Service (Amazon ECS).
- Vous obtenez une visibilité sur les performances des agents grâce à AgentCore Observability, une fonctionnalité d'Amazon Bedrock AgentCore, et Amazon CloudWatch télémétrie.
Déployer la solution
Suivez ces étapes pour déployer l'infrastructure de la solution et l'interface web dans votre compte AWS.
Prérequis
Pour déployer cette solution, vous devez disposer de :
- Un Compte AWS.
- Accès à Amazon Bedrock avec les modèles Amazon Nova et Anthropic (Claude) activés. Pour connaître la disponibilité des modèles par Région AWS, reportez-vous à Modèles pris en charge par région AWS dans Amazon Bedrock.
- Accès à Amazon Bedrock AgentCore (Runtime, Gateway, Identity), à S3 Vectors et à Amazon Aurora DSQL dans un Région prise en charge.
- AWS Cloud Development Kit (AWS CDK) v2 installé.
- Docker installé et en cours d'exécution (nécessaire pour construire et déployer des images de conteneurs).
- Python 3.11+ et Node.js 18+.
- AWS Identity and Access Management (IAM) permettant de créer des compartiments S3, des fonctions Lambda, des tables DynamoDB, des pools d'utilisateurs Cognito, des dépôts Amazon Elastic Container Registry (Amazon ECR) et des services Amazon ECS.
- Clonez le dépôt et configurez l'environnement :
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - Déployez les piles :
uv run deploy.py --admin-email your-email@example.com
Ceci déploie six piles AWS CloudFormation : Core (S3, Cognito, DynamoDB), Gateway (outils Lambda, AgentCore Gateway), Aurora (Amazon Aurora DSQL), Agent (runtime AgentCore, conteneurs), UI Orchestrator (points de terminaison API) et Modern UI (application React sur Amazon CloudFront). Le déploiement prend environ 15–20 minutes.
- Vérifiez le déploiement en contrôlant que chaque pile affiche
CREATE_COMPLETEdans la console CloudFormation.
Traiter des fichiers et examiner les résultats
Après le déploiement, vous recevez un e-mail contenant l'URL CloudFront, le nom d'utilisateur et un mot de passe temporaire.
Traiter un document
- Connectez-vous à l'interface web et choisissez Process Document.
- Chargez un exemple de bon de commande depuis
infrastructure/sample_data/purchase_orders/training/. - Le document entre dans le flux de travail de l'agent :
- L'agent Analyzer extrait le texte et identifie l'expéditeur et le type de document.
- L'agent Matcher recherche des documents similaires dans le magasin de vecteurs.
- Pour un nouveau type de document, le flux de travail d'entraînement génère des instructions d'extraction, extrait les données, les valide et enregistre les instructions pour une utilisation future.
- Pour un type de document connu, le flux de travail d'automatisation extrait les données à l'aide des instructions existantes et les valide.
- Examinez les résultats dans l'onglet Review Jobs and Instructions pour vérifier les données extraites, les résultats de validation et les instructions générées.
Exemple : un nouveau type de document (workflow de formation)
Supposons que vous téléversez le premier bon de commande d'un nouveau revendeur, Two Wheel Store. L'agent Matcher interroge le magasin de vecteurs, ne trouve aucun document similaire et achemine la tâche via le workflow de formation.
L'agent Analyzer utilise Amazon Textract pour extraire le texte brut du document :
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
L'agent Instructions génère des prompts d'extraction à partir du schéma, et l'agent Extractor produit un JSON structuré :
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
L'agent Validator vérifie le résultat par rapport au schéma et échoue:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'
Le format de SKU du fournisseur (SB-004) ne correspond pas au format interne d'Acme Bikes (AB-SB-004). L'agent Instructions Fixer diagnostique la discordance et ajoute une règle explicite de transformation des SKU au prompt d'extraction : préfixer les SKU du fournisseur avec AB-. Au deuxième passage, les sept lignes de commande sont validées avec succès, et l'agent Save Instructions enregistre le prompt affiné dans le magasin de vecteurs. Temps de bout en bout pour cette première exécution : 3 minutes 49 secondes.
Exemple : un type de document connu (workflow d'automatisation)
Lorsqu'un deuxième bon de commande de Two Wheel Store arrive, l'agent Matcher retrouve les instructions stockées de la première exécution avec un score de confiance de 3.946 (seuil : 3.7) et achemine la tâche via le workflow d'automatisation :
- L'agent Extractor applique directement les instructions stockées, de sorte que l'orchestrateur ignore la génération de prompt. La règle de transformation des SKU apprise pendant la formation s'applique automatiquement (
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - Les trois lignes de commande sont validées dès le premier passage avec un total de commande de $5,979.19.
- Le traitement de bout en bout s'achève en 1 minute 30 secondes, contre 3 minutes 49 secondes lors de la première exécution.
Utiliser le chat interactif
Le tableau de bord inclut une interface de chat pour le dépannage :
- Demandez
what tools do you havepour voir les capacités disponibles des agents. - Demandez
list instructionspour consulter les instructions d'extraction stockées. - Demandez
what is the status of job XXXXpour vérifier l'avancement du traitement. - Demandez
what went wrong with job XXXX, how can we update the instructions?pour diagnostiquer les échecs.
Comprendre comment la précision s'améliore avec le temps
Le système s'améliore avec le temps grâce à deux boucles de rétroaction :
- Boucle de formation: lorsque l'agent Instructions Fixer affine les prompts d'extraction après des échecs de validation, les instructions améliorées sont enregistrées et réutilisées pour des documents similaires.
- Boucle de traitement: lorsque l'agent Troubleshooter corrige des erreurs d'extraction, il fournit une analyse détaillée qui aide à identifier les tendances dans les variations de format des documents.
Lors du changement de modèle, utilisez AgentCore Evaluations, une capacité d'Amazon Bedrock AgentCore, afin de confirmer que la qualité de l'extraction reste acceptable. La solution utilise déjà AgentCore Observability, elle dispose donc de l'instrumentation requise.
Coût estimé
Vous ne payez que ce que vous utilisez, car la solution fonctionne sur des ressources serverless et à la demande sans coûts d'inactivité. Pour une charge de travail de 10 documents d'entraînement et 1,000 documents traités chaque mois dans US East (N. Virginia), le coût estimé est d'environ $58 par mois. L'inférence du modèle de fondation (FM) via Amazon Bedrock représente environ 85 pour cent du coût total, à environ $0.055 par document. Le coût réel dépend en grande partie des modèles attribués à chaque agent. Les choix de modèles sont centralisés dans agents/orchestratorgraph/utils/config.py, ce qui vous permet d'utiliser des modèles moins coûteux pour les tâches simples et des modèles plus puissants là où c'est nécessaire. Pour des informations tarifaires détaillées, consultez la page Amazon Bedrock pricing .
Personnalisez la solution pour votre cas d'usage
Vous obtenez un cas d'usage de traitement de bons de commande avec un jeu de données synthétique d'une entreprise de vélos, un schéma JSON préconstruit et une fonction Lambda de validation qui vérifie les données extraites par rapport aux enregistrements de produits et de fournisseurs dans une base de données ERP fictive. Pour traiter vos propres documents, vous devez remplacer les schémas et la logique de validation inclus par les vôtres.
Définissez votre schéma de document
Créez un schéma JSON qui définit les champs que vous souhaitez extraire pour chaque type de document. Le schéma de bon de commande d'exemple dans agents/orchestratorgraph/doc_schema/purchase_order_schema.json sert de référence. Votre schéma doit préciser les noms des champs, les types de données, et si chaque champ est explicitement mentionné dans le document ou déduit du contexte.
Créez votre processus de validation
Le validateur inclus vérifie les données des bons de commande par rapport à des tables synthétiques de fournisseurs et de produits dans Aurora DSQL. Votre implémentation en production nécessite un processus de validation adapté à vos règles métier. Par exemple :
- Un validateur de factures pourrait vérifier les identifiants de fournisseurs par rapport à votre système de comptes fournisseurs et confirmer que les totaux des lignes correspondent au total de la facture.
- Un validateur de contrats pourrait vérifier que le document contient les clauses requises et que les dates et les noms des parties correspondent à vos enregistrements.
- Un validateur de réclamations pourrait vérifier les numéros de police, les limites de couverture et les informations du demandeur par rapport à votre système de gestion des polices.
Pour ajouter un nouveau validateur, créez une fonction Lambda qui accepte le JSON extrait et renvoie un résultat de réussite/échec avec des messages d'erreur détaillés, puis enregistrez-la comme outil dans AgentCore Gateway. Reportez-vous à gateway/tools/po_validator_tool/ pour le modèle d'implémentation.
Mettre à jour les prompts des agents
Les prompts des agents dans agents/orchestratorgraph/prompts/ font référence à la terminologie des bons de commande. Mettez à jour ces prompts pour refléter vos types de documents et vos exigences d'extraction. Les agents Orchestrator, Validator et Instructions contiennent chacun un langage spécifique au type de document que vous devez adapter.
Bonnes pratiques
Gardez ces recommandations à l'esprit lorsque vous entraînez et exploitez votre système IDP agentique.
- Commencer avec des échantillons représentatifs: Chargez 5 à 10 documents par type pendant l'entraînement, y compris des cas limites avec des variations de format, afin de créer des instructions d'extraction fiables.
- Utiliser la validation par règles métier: Connectez les validateurs à vos données de référence (listes de fournisseurs, catalogues de produits) dans Aurora DSQL pour détecter tôt les erreurs d'extraction.
- Surveiller les performances des agents: Utilisez AgentCore Observability et CloudWatch pour suivre les chemins d'exécution, identifier les goulots d'étranglement et mesurer la précision de l'extraction au fil du temps.
- Ajouter des types de documents de manière incrémentale: Créez un schéma JSON pour chaque nouveau type de document et une fonction Lambda de validation correspondante. Les agents s'occupent du reste.
- Ajouter des garde-fous pour la production: Appliquez Amazon Bedrock Guardrails pour imposer le filtrage du contenu et les vérifications d'ancrage sur les sorties des agents. Ceci est particulièrement important lorsque vous traitez des types de documents sensibles tels que des réclamations d'assurance ou des demandes de prêt.
- Consulter l'OWASP Top 10 pour les LLM: Consultez le OWASP Top 10 for LLMs and Generative AI Apps pour les considérations de sécurité lors de la création d'applications qui utilisent de grands modèles de langage (LLM).
Nettoyage
Important : Avant d'exécuter le nettoyage, exportez les données que vous souhaitez conserver. Le destroy.py script supprime définitivement les documents traités (S3), l'historique des tâches (DynamoDB), les données de validation (Aurora DSQL) et les instructions d'extraction apprises (magasin de vecteurs).
Pour éviter des frais continus, supprimez les ressources déployées :
uv run destroy.pyVérifiez sur la console que les six piles CloudFormation sont supprimées : AgenticIDP-Core-Dev, AgenticIDP-Gateway-Dev, AgenticIDP-Aurora-Dev, AgenticIDP-Agent-Dev, AgenticIDP-UIOrchestr-Dev et AgenticIDP-ModernUI-Dev.
Conclusion
Dans cet article, vous avez appris à construire un système de traitement de documents auto-améliorant à l'aide d'Amazon Bedrock AgentCore, où des agents IA spécialisés collaborent pour classer, extraire, valider et apprendre à partir de documents d'entreprise. Cette approche agentique s'adapte automatiquement aux nouveaux formats de documents et améliore la précision au fil du temps grâce à des boucles de rétroaction, remplaçant la configuration manuelle des modèles par un apprentissage autonome.
Comme prochaines étapes :
- Déployez le exemple de solution et testez avec les exemples de bons de commande inclus.
- Ajoutez vos propres types de documents en créant des schémas JSON et des règles de validation.
- Explorez comment intégrer les données extraites avec des systèmes en aval tels que des ERP, des CRM ou des outils de gestion de contenu.
Pour en savoir plus sur les services et les modèles utilisés dans cet article, reportez-vous aux ressources suivantes :
- Pour un examen approfondi du framework d'agents utilisé dans cette solution, reportez-vous à Strands Agents SDK : un examen technique approfondi des architectures d'agents et de l'observabilité.
- Pour comprendre comment AgentCore Gateway transforme les API en outils compatibles avec les agents, reportez-vous à Introducing Amazon Bedrock AgentCore Gateway: Transforming enterprise AI agent tool development.
- Pour en savoir plus sur le Model Context Protocol et sur la façon dont il s'intègre aux services AWS, reportez-vous à Unlocking the power of Model Context Protocol (MCP) on AWS.
- Pour découvrir comment les agents peuvent conserver le contexte entre les sessions, reportez-vous à Amazon Bedrock AgentCore Memory: Building context-aware agents.
- Pour plus de détails sur les capacités d'Amazon Bedrock AgentCore, reportez-vous à la documentation d'Amazon Bedrock AgentCore.
Pour bénéficier de conseils d'experts sur la création de solutions de traitement de documents, AWS Professional Services et AWS Partners peuvent vous aider.