
vLLM est un moteur d'inférence et de service open source pour les grands modèles de langage (LLMs). L'inférence des LLM comporte deux phases distinctes : le préremplissage (prefill), qui traite le prompt d'entrée et construit le cache clé-valeur (KV), et le décodage (decode), qui utilise ce cache pour générer la sortie un token à la fois. Ces phases présentent des caractéristiques de calcul, de mémoire et de mise à l'échelle différentes. Désagrégation préremplissage-décodage (P-D) les exécute sur des instances de moteur distinctes, permettant à chaque phase de scaler et d'être optimisée indépendamment. Cela peut améliorer l'utilisation des ressources, le débit et la latence sous charge. Cependant, cela nécessite également de transférer le KV cache de l'instance de prefill vers l'instance de decode avant que la génération de tokens puisse commencer, ce qui rend un transfert KV efficace critique pour le time-to-first-token (TTFT).
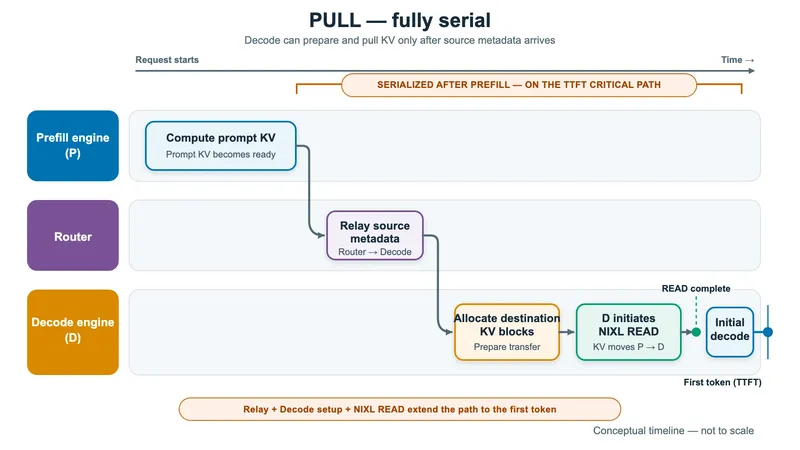
L'une des façons dont vLLM effectue ce transfert passe par la NVIDIA Inference Xfer Library (NIXL) connecteur, qui déplace les blocs KV sur des interconnexions compatibles RDMA telles que l'AWS Elastic Fabric Adapter (AWS EFA, le réseau RDMA à faible latence utilisé entre les serveurs dans AWS). Sur les types d'instances pris en charge, AWS EFA prend en charge GPUDirect RDMA et Neuron Direct RDMA, permettant à NIXL de transférer les blocs KV directement entre la mémoire des GPU ou des dispositifs Trainium sans passer par la mémoire hôte. Le mode par défaut du connecteur NIXL est pull-based(tiré) : après que l'instance de préfill a terminé le calcul du KV cache du prompt, le routeur relaie les métadonnées source, y compris les identifiants des blocs de préfill, à l'instance de décode. L'instance de décode alloue ensuite les blocs de destination, prépare le transfert NIXL et lance un NIXL READ pour tirer les blocs KV depuis l'instance de préfill. Comme ces étapes de coordination et de préparation se produisent de manière séquentielle après le préfill et avant que le décodage puisse commencer, elles allongent le chemin critique du TTFT, comme le montre la chronologie suivante.
Cet article présente un connecteur NIXL push-based (poussé) qui déplace la coordination et la préparation du transfert post-préfill hors du chemin critique. Pour les clients exécutant une inférence disaggregated prefill/decode avec vLLM, cela peut améliorer la réactivité de l'application en réduisant le TTFT et le TPOT, en particulier à des taux de requêtes élevés.
Dans notre benchmark sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées avec EFA, le mode push a offert jusqu'à 3x meilleur TTFT et jusqu'à 30% meilleur temps par token de sortie (TPOT) par rapport au mode pull (voir la section Performance data ) pour le modèle Qwen3-32B ; les résultats dépendent de la charge de travail et de la configuration.
Nous avons construit et validé cette fonctionnalité sur des clusters d'instances AWS Trainium connectées avec EFA, puis nous l'avons contribuée à vLLM en tant que fonctionnalité indépendante de l'accélérateur. Les résultats présentés ici proviennent d'un cluster AWS p5en (GPU) avec EFA, montrant que les gains se transfèrent aux GPU. Cet article explique l'architecture push-based, le flux de transfert, le modèle de threading, les résultats de performance et comment reproduire le benchmark.
Transfert KV push-based
Vue d'ensemble de l'architecture
Le transfert push-based améliore le TTFT et le débit de décode pour deux raisons :
- Il supprime la sérialisation du modèle pull en chevauchant le travail du producteur et du consommateur. L'instance de décode enregistre ses blocs cibles à l'avance pendant que le producteur calcule encore le KV. Le transfert commence alors dès que les blocs du producteur sont prêts, plutôt qu'après un aller-retour de découverte d'identifiants côté consommateur, supprimant ainsi cet aller-retour du chemin vers le premier token.
- Il déplace le temps de préparation du transfert hors de l'instance de décode. Cette préparation — la préparation des descripteurs NIXL et la soumission du transfert — s'exécute côté préfill et sur un thread d'arrière-plan, de sorte que l'instance de décode ne consomme pas ces cycles pendant sa phase de génération de tokens, critique pour la latence.
L'effet net est un TTFT plus faible et un débit de tokens de sortie plus élevé sur l'instance de décode.
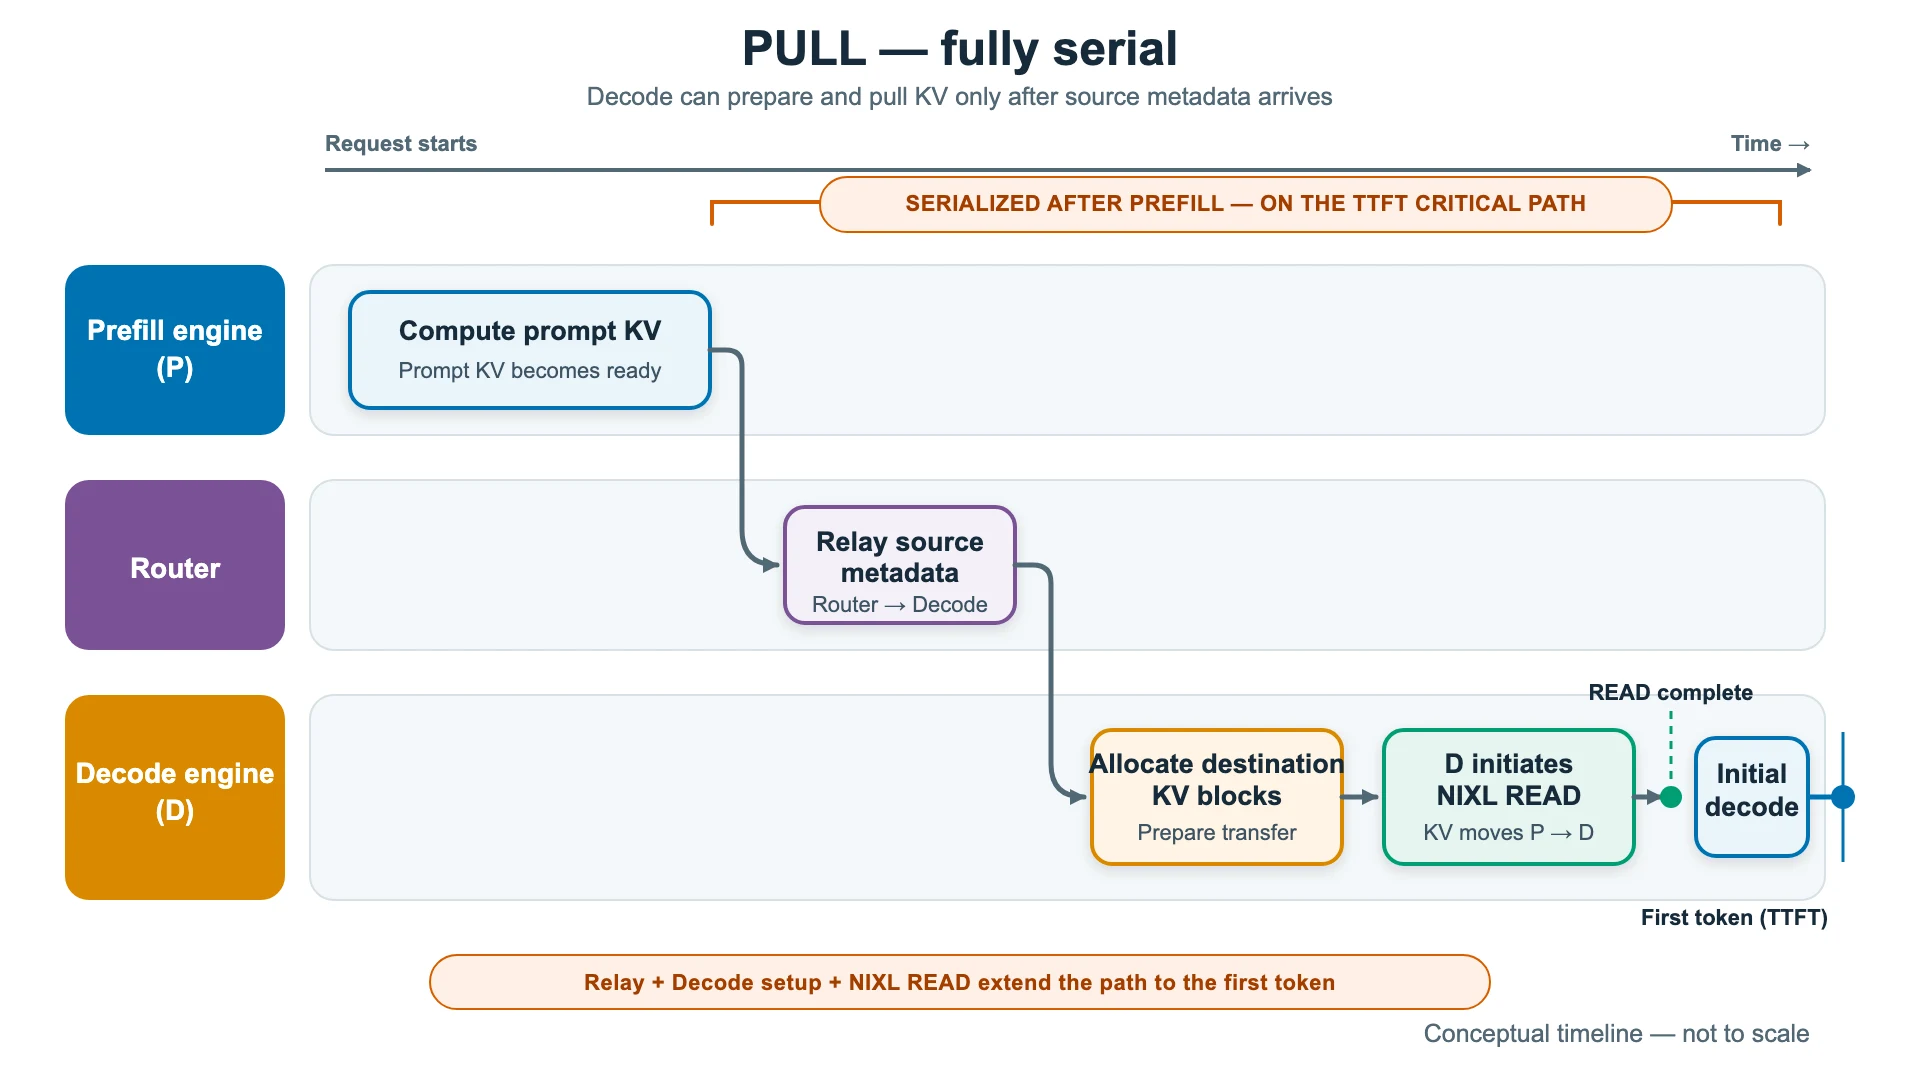
Le connecteur push coordonne trois acteurs : l'instance de décode, qui enregistre ses blocs cibles à l'avance ; l'instance de préremplissage, qui associe chaque requête et lance le transfert ; et un thread d'arrière-plan dédié qui retire l'écriture KV de la boucle de passe avant du moteur. Le diagramme suivant montre comment ces éléments s'articulent.
Détails de l'implémentation
Le protocole comporte trois étapes logiques.
1. Enregistrement (côté décodage). Lorsque l'instance de décode alloue des blocs locaux pour une requête nécessitant un pré-remplissage à distance, elle prépare une décrémentation décrivant où l'instance de pré-remplissage doit écrire le KV : sa propre identité et les emplacements de blocs qu'elle vient de réserver. Au sein d'une même étape du moteur, le worker transmet cette décrémentation à l'instance de pré-remplissage sous forme de notification NIXL. Comme l'enregistrement a lieu au moment de l'allocation, le connecteur connaît les blocs de destination avant que l'instance de pré-remplissage ne termine le pré-remplissage.
2. Rendez-vous (côté préfill). L'enregistrement du décodeur et l'achèvement du prefill sur le producteur peuvent arriver dans n'importe quel ordre, et le connecteur gère les deux. Si l'enregistrement arrive en premier, le producteur le conserve jusqu'à ce que son propre prefill soit terminé. Si le prefill se termine en premier, le producteur conserve les blocs de la requête jusqu'à l'arrivée de l'enregistrement. Quel que soit l'événement qui se produit en second, il déclenche le transfert. Le connecteur associe les requêtes par identifiant, et la correspondance tient compte des requêtes réémises, en associant correctement les requêtes préemptées ou relancées.
3. Transfert (côté préremplissage). Une fois qu'une requête est appariée, le producteur établit une connexion vers l'instance de décodage (si elle n'existe pas déjà) et émet un NIXL WRITE qui copie les blocs KV directement dans la mémoire enregistrée du décodeur, en s'adressant à chaque rang tensor-parallel de destination. Le producteur et le consommateur peuvent utiliser des dispositions de blocs internes différentes. Chaque partie mappe les emplacements des blocs vers sa propre disposition physique au moment du transfert, ce qui permet des tailles de blocs différentes de chaque côté. Chaque WRITE transporte une notification d'achèvement que NIXL transmet à l'instance de décodage dès que les données arrivent. Le décodeur compte ces notifications, une par rang du producteur qui écrit en lui, et considère le KV comme reçu seulement après l'arrivée de toutes les notifications attendues, moment où la requête passe au décodage.
Modèle de threading
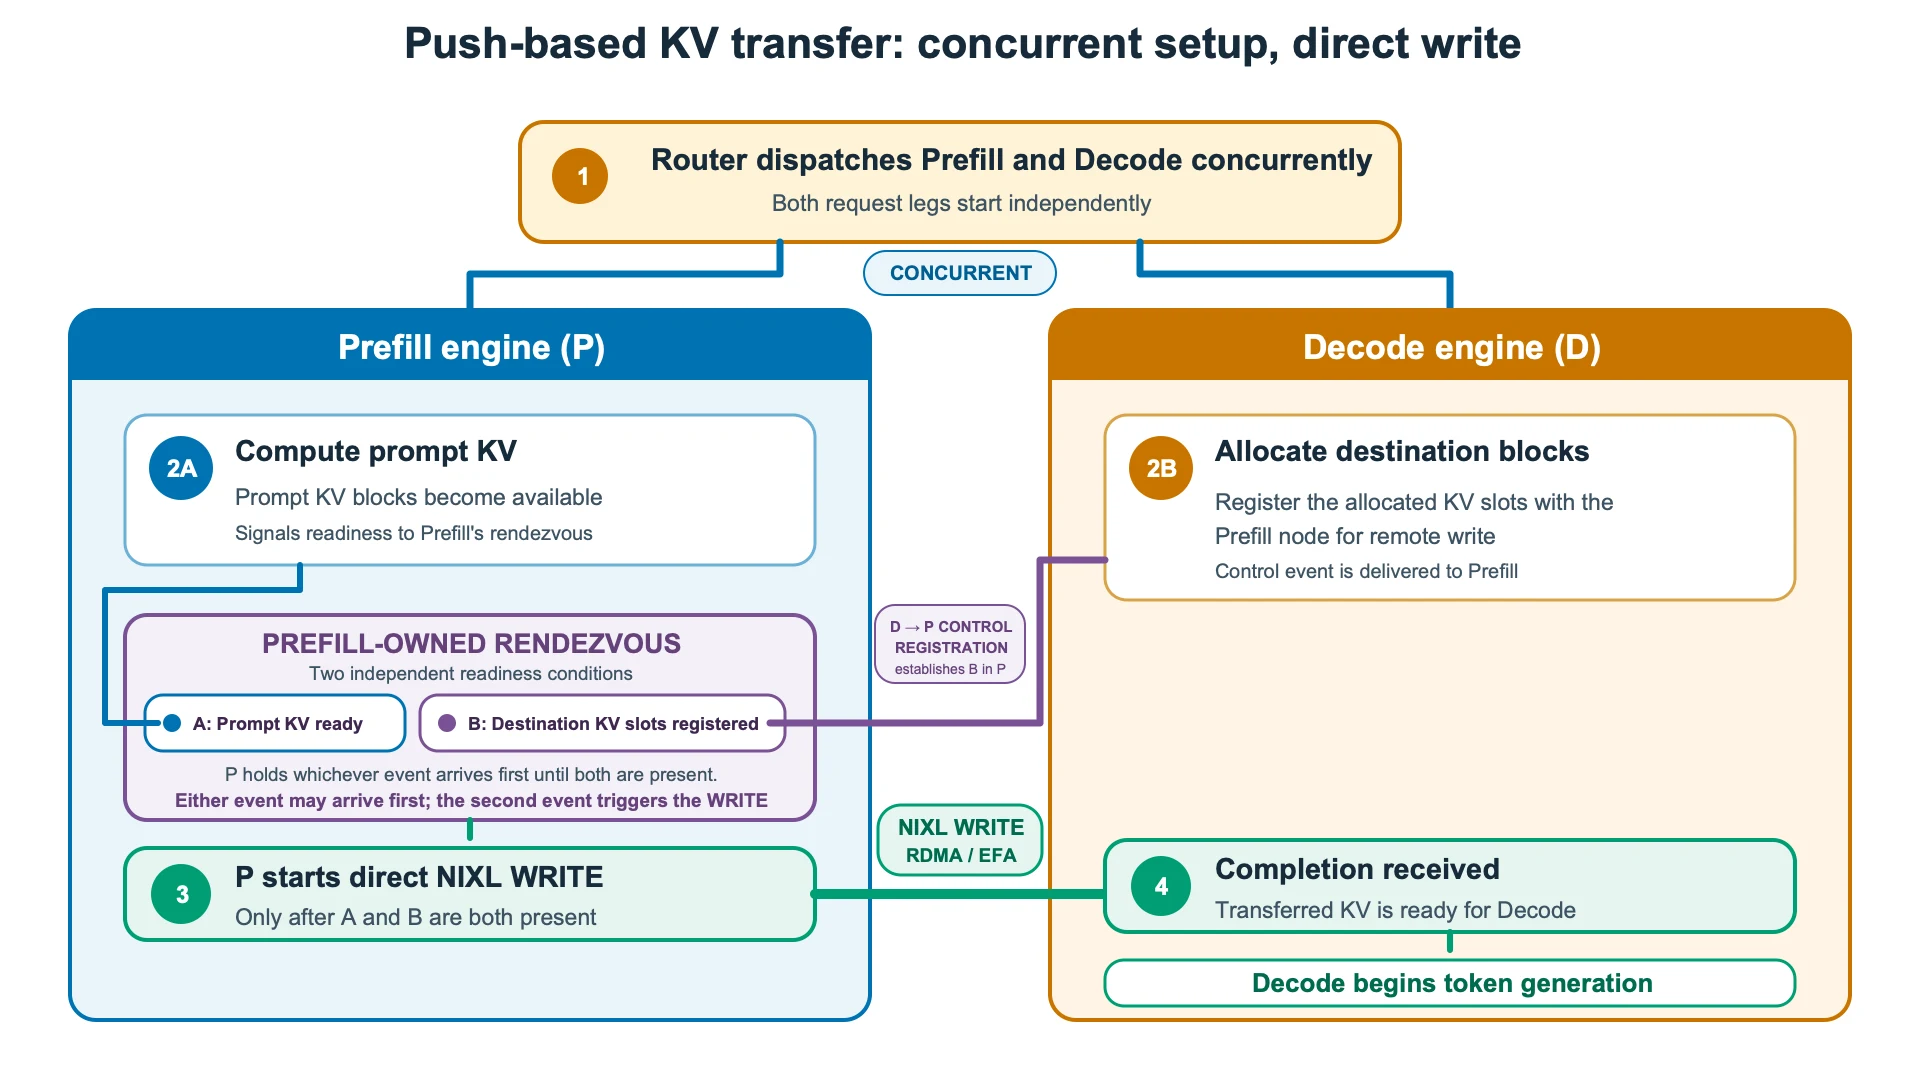
Le connecteur push dissocie l'exécution du modèle de la préparation du transfert KV en utilisant un thread de transfert dédié en arrière-plan sur chaque worker de préremplissage. Au début d'une requête, la boucle principale de décodage alloue ses blocs KV de destination et les enregistre auprès de l'instance de préremplissage pendant que la boucle principale de préremplissage calcule le cache KV du prompt. Une fois l'enregistrement de destination et le KV du prompt prêts, la boucle principale de préremplissage confie les blocs KV au thread d'arrière-plan et retourne rapidement à l'exécution du modèle.
Le thread d'arrière-plan établit ou réutilise la connexion NIXL, mappe les identifiants de blocs KV de la requête vers des descripteurs mémoire, fusionne les blocs contigus en régions de transfert plus grandes et soumet le WRITE NIXL à l'instance de décodage. Lorsque NIXL termine le transfert, il envoie une notification d'achèvement à l'instance de décodage, qui commence alors la génération de tokens. Le fait de garder la préparation des descripteurs et la soumission des transferts hors des boucles principales sensibles à la latence empêche ce travail par requête de retarder l'exécution du modèle. Le diagramme suivant montre ces passations entre la boucle principale et le thread d'arrière-plan pour une seule requête.
Comparaison du minutage : pull vs push
Le diagramme suivant résume les flux de transfert en mode pull et push décrits dans les sections précédentes et met en évidence leur effet sur le TTFT. Bien que les deux modes utilisent le même chemin de données NIXL et EFA/RDMA, le mode pull effectue le relais des métadonnées et la configuration côté décode après le prefill, tandis que le mode push chevauche la configuration côté décode avec le prefill. Par conséquent, le mode push retire ces opérations du chemin critique post-prefill, permettant ainsi au décodage de commencer plus tôt.
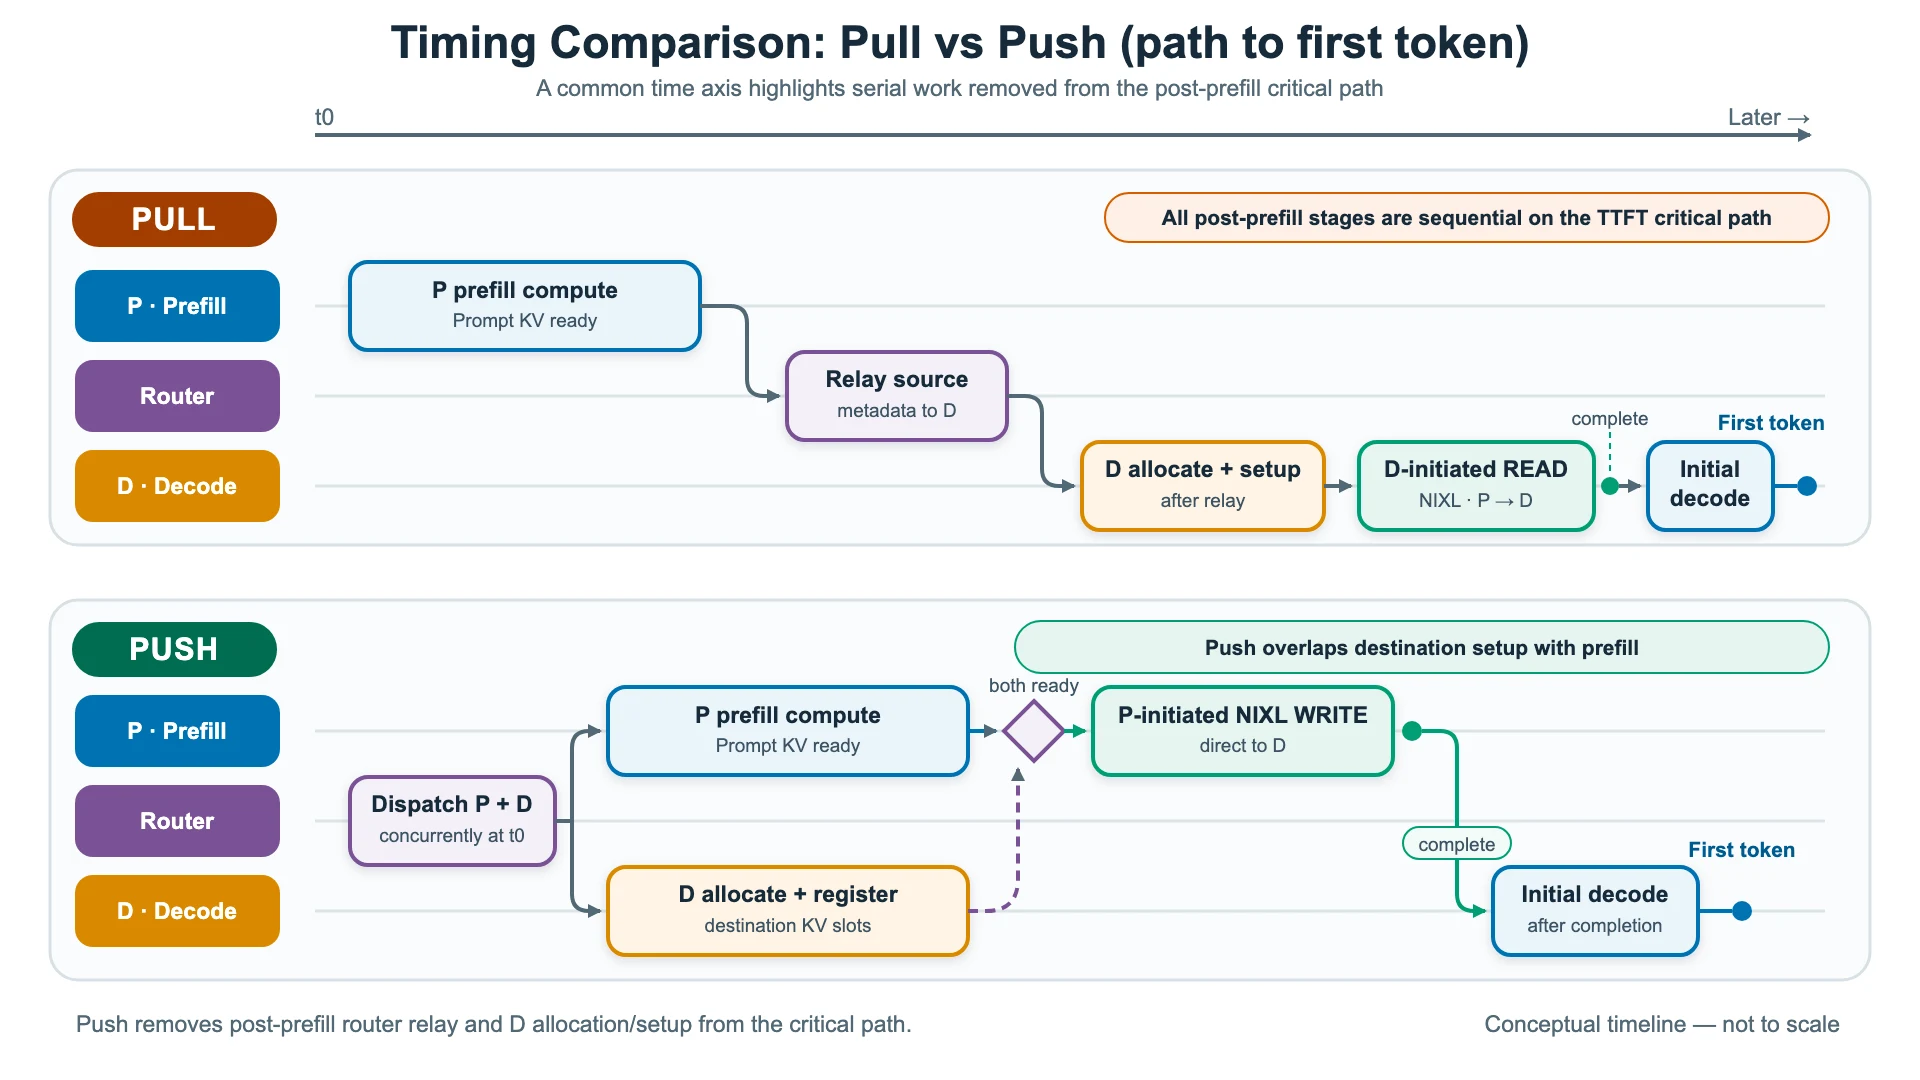
Les deux modes impliquent également un compromis de routage. Le mode pull permet au routeur de sélectionner une instance de décodage une fois le préremplissage terminé, ce qui offre une plus grande flexibilité pour le routage sensible à la charge et la gestion de la qualité de service. Le mode push sélectionne l'instance de décodage plus tôt afin que la configuration de la destination puisse se chevaucher avec le préremplissage. En contrepartie, sous une charge comparable, l'instance de préremplissage peut libérer ses blocs KV plus tôt car le transfert commence dès que le KV du prompt et l'enregistrement de la destination sont prêts.
Données de performance
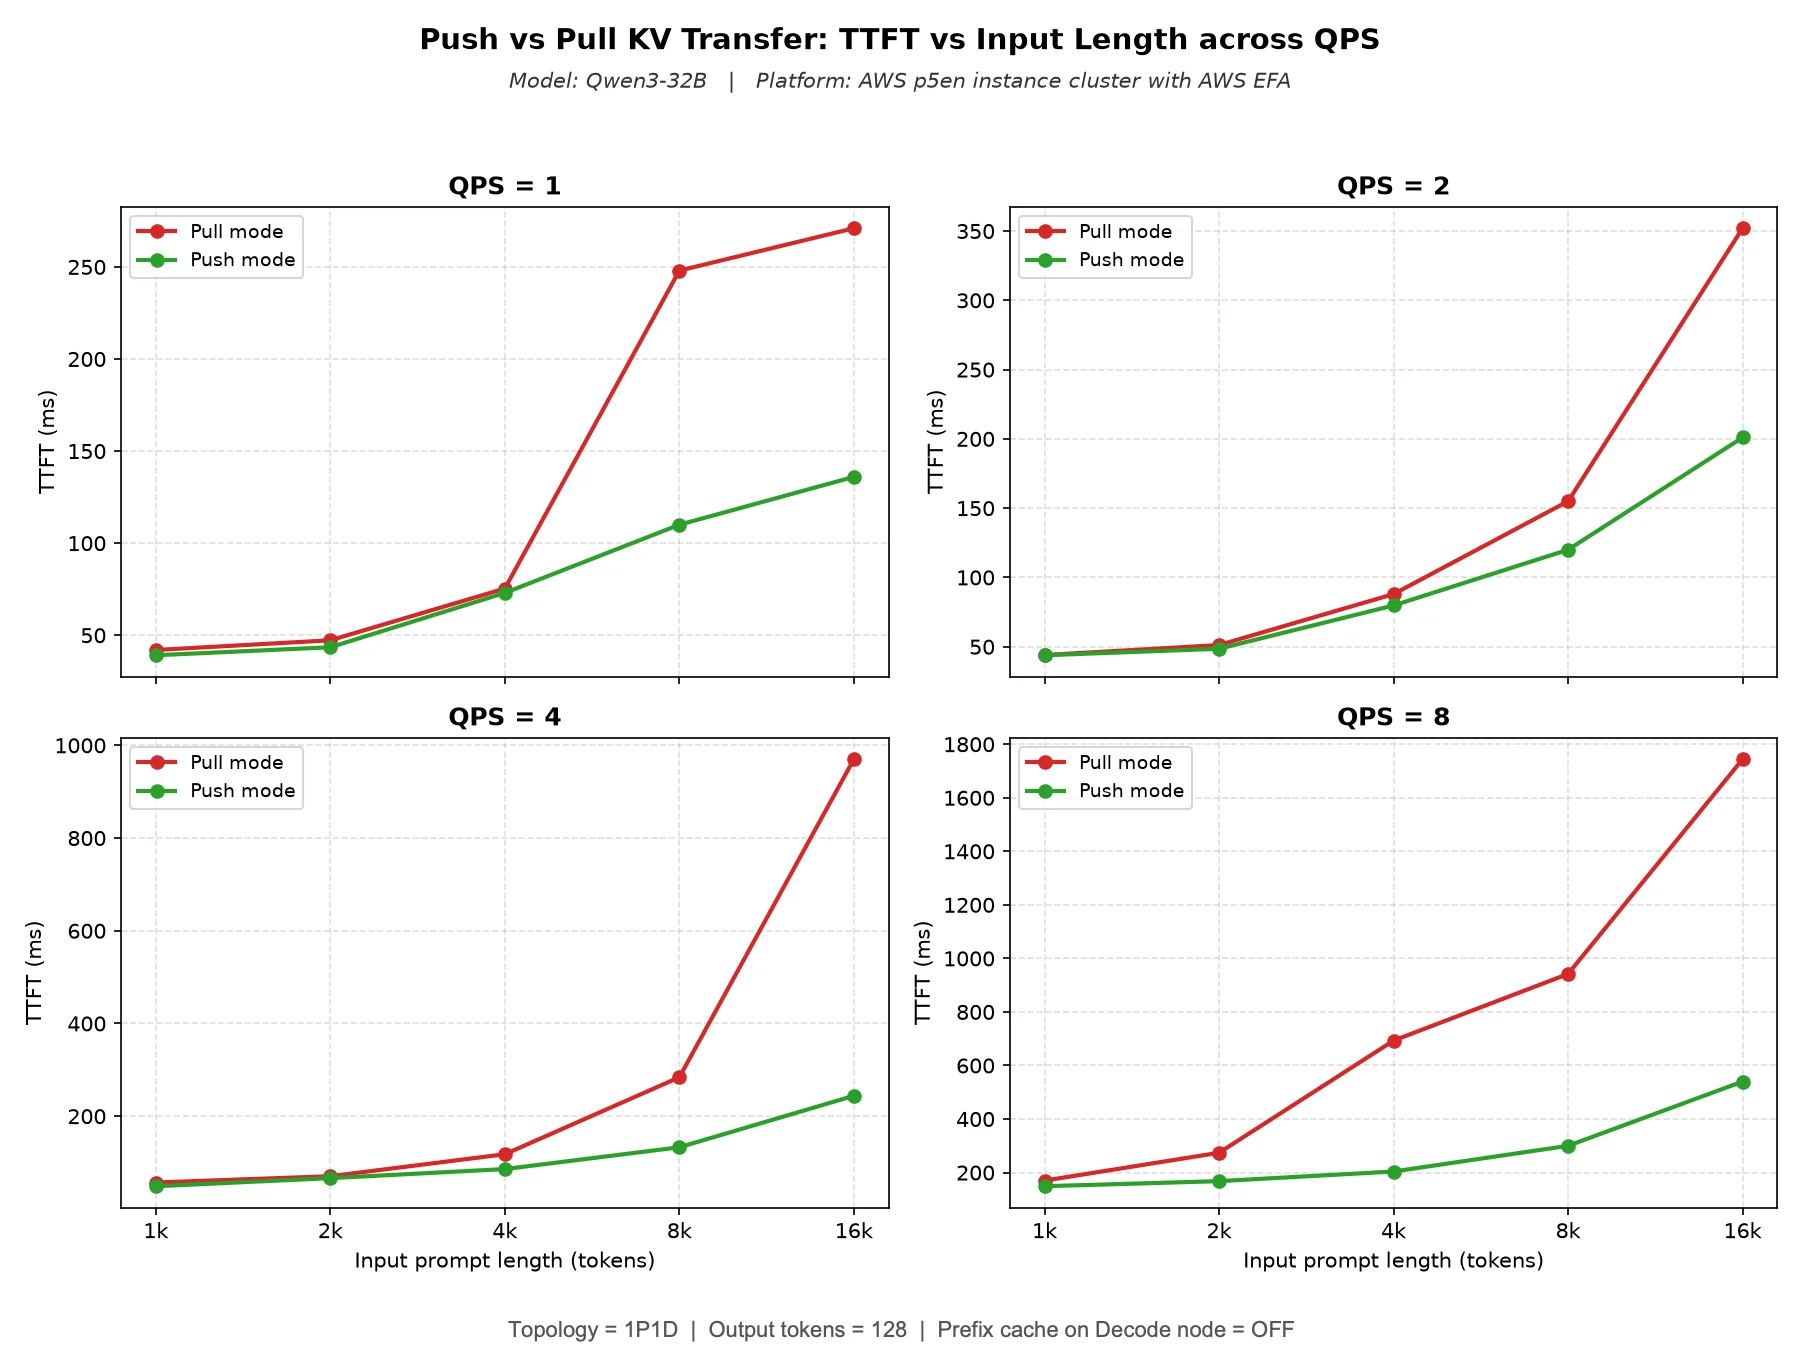
Pour l'évaluation, nous avons utilisé le modèle Qwen3-32B sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées via EFA. Pour isoler les performances de transfert P→D, nous avons configuré le benchmark pour désactiver le cache de préfixe avec --no-enable-prefix-caching. Cette configuration fait que le nœud de décodage récupère l'intégralité du cache KV depuis le nœud de préremplissage pour chaque requête. Sinon, des prompts qui se chevauchent pourraient réutiliser le cache local du nœud de décodage et contourner le transfert, ce qui produirait des résultats de comparaison trompeurs.
Le graphique suivant compare le TTFT pour le transfert KV en mode push et pull. Nous balayons des longueurs d'entrée de 1k à 16k et des taux de requêtes de 1 à 8 QPS. À faible charge et pour des prompts courts, les deux modes fonctionnent presque de manière identique. À mesure que le QPS et la longueur d'entrée augmentent, le mode pull se dégrade fortement, atteignant environ 1,744 ms à 8 QPS et 16k. Le mode push reste bien plus bas, à environ 540 ms, soit une réduction d'environ 3x. L'écart s'explique parce que le mode pull publie les descripteurs NIXL en ligne sur le worker de décodage, de manière synchrone dans sa boucle moteur, ce qui bloque la génération de tokens. Le mode push déplace cela vers un thread d'arrière-plan, hors du chemin critique.
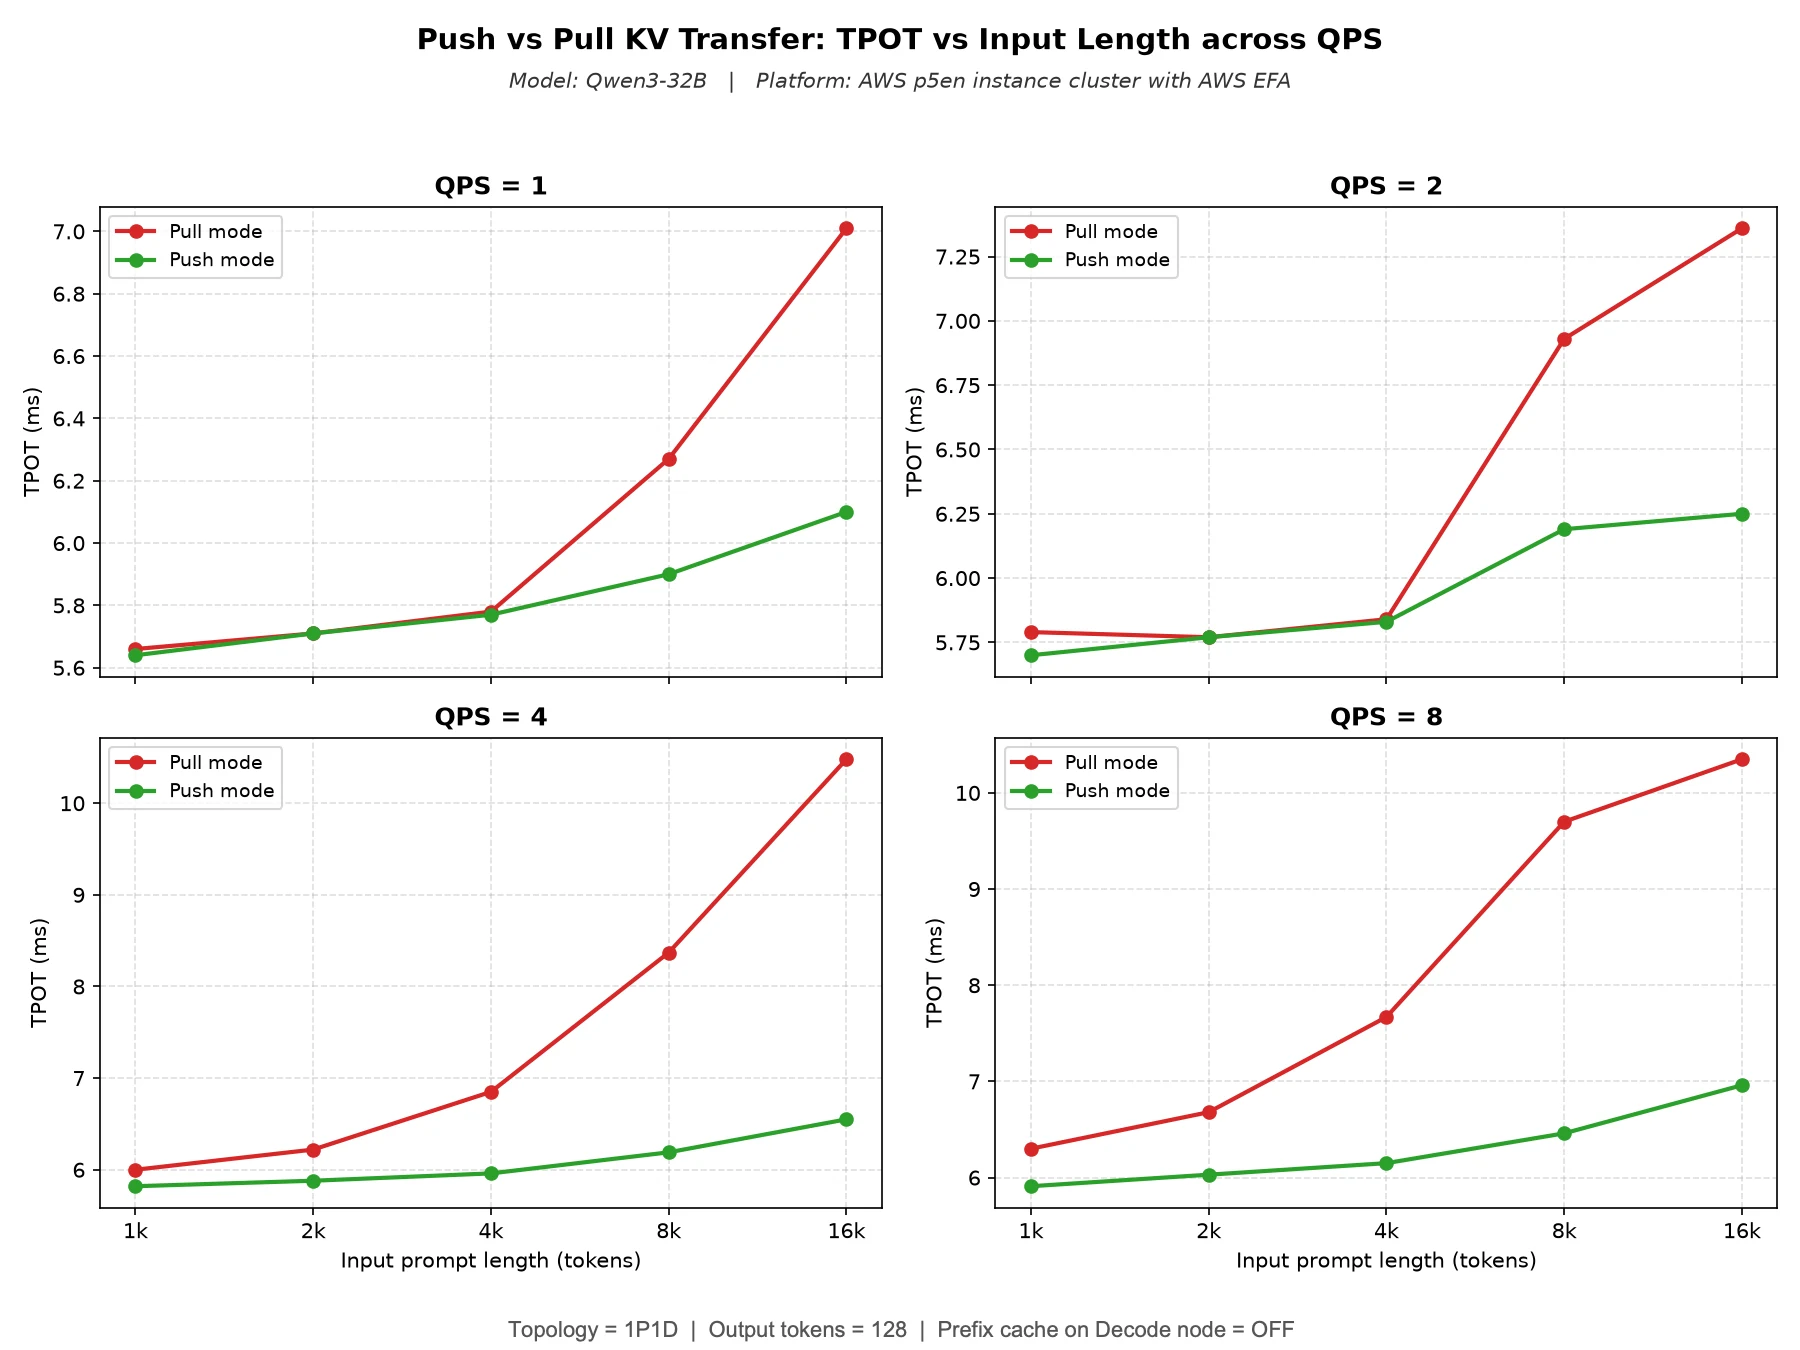
Ce graphique montre le TPOT dans les mêmes conditions. Le schéma est le reflet du TTFT. À charge légère, push et pull sont proches, autour de 5,6–5,8 ms. À mesure que la charge et la longueur d'entrée augmentent, pull grimpe à environ 10,4 ms à 4–8 QPS et 16k, tandis que push reste proche de 7 ms. La raison est que push décharge la préparation des descripteurs et la soumission des transferts du worker de décodage. La génération de tokens n'est jamais privée de ressources, donc la latence par token reste stable même à haute concurrence et avec de longs contextes.
Comment exécuter le benchmark
Pour reproduire notre configuration de benchmark 1P1D, un nœud de prefill et un nœud de decode, en utilisant des instances Amazon EC2 P5en connectées avec EFA, reportez-vous aux instructions détaillées du Reproducing our results guide. Le guide couvre la configuration de l'environnement, le lancement des serveurs vLLM de prefill et de decode, l'exécution du benchmark et la collecte des résultats. La fonctionnalité peut s'exécuter sur d'autres configurations prises en charge, mais les résultats de performance varieront selon le matériel, le modèle, la charge de travail et la configuration réseau.
Conclusion
Dans cet article, nous avons montré comment le connecteur KV basé sur push chevauche le calcul de prefill avec l'allocation et l'enregistrement des blocs côté décodage, supprimant de la voie critique l'aller-retour du routeur après le prefill et la configuration des transferts côté décodage. Cela réduit le TTFT et le TPOT, en particulier à taux de requêtes élevés. Dans notre benchmark Qwen3-32B sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées avec EFA, le mode push a offert jusqu'à une amélioration de 3x du TTFT et de 30% du TPOT par rapport au mode pull. Les résultats varient selon la charge de travail et la configuration. Pour utiliser le mode push, configurez les serveurs de prefill et de decode pour utiliser NixlPushConnector au lieu de NixlConnector.
Choisissez le connecteur basé sur push lorsque la sélection précoce du nœud de décodage est acceptable et qu'un TTFT plus bas est la priorité. Le connecteur basé sur pull reste le mieux adapté aux charges de travail qui nécessitent un transfert KV bidirectionnel ou qui diffèrent la sélection de l'instance de décodage jusqu'après le prefill pour un routage tenant compte de la charge. vLLM prend en charge les connecteurs KV basés sur push et sur pull, permettant aux utilisateurs de choisir l'approche qui correspond le mieux à leur déploiement.
Comme amélioration future, nous explorons l'apport du modèle de threading NIXL en arrière-plan au connecteur en mode pull, déplaçant la configuration NIXL hors de la voie critique afin que les charges de travail en mode pull puissent bénéficier des mêmes optimisations ; nous avons ouvert une pull request (#45211) pour explorer cela.
Ressources associées
Remerciements
Nous remercions la communauté vLLM pour son soutien dans la maintenance de cette fonctionnalité.
Annexe : Reproduire nos résultats
La topologie est constituée de deux nœuds GPU p5en (prefill sur :8100, decode sur :8200) avec EFA activée, plus un troisième nœud plus petit qui exécute le proxy et le client de benchmark. Trois scripts sont fournis avec cet article : serve_pd.sh lance chaque composant dans l'un ou l'autre mode, run_sweep.sh pilote le balayage, et cleanup.sh démontle tout. plot_push_vs_pull.py redessine les deux figures ci-dessus à partir des fichiers JSON de résultats.
Environnement de test
Les deux nœuds GPU ont été configurés de manière identique :
| Type d'instance | p5en.48xlarge (8x NVIDIA H200), un pour le prefill et un pour le decode |
| Région / AZ | ap-south-1 (Mumbai), ap-south-1b (AZ ID aps1-az3), les deux nœuds dans la même AZ |
| Placement | Aucun groupe de placement de cluster ; les deux instances lancées dans une On-Demand Capacity Reservation ciblée, tenancy par défaut |
| AMI | Image publique AWS ParallelCluster 3.14.2 pour Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae dans ap-south-1; les IDs d'AMI diffèrent selon la région). Elle embarque le noyau 6.14.0-1018-aws, pilote NVIDIA 570 et CUDA 12.8 ; mettez donc à niveau le pilote, la CUDA toolkit et l'installateur EFA vers les versions ci-dessous. |
| OS / noyau | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| Pilote NVIDIA / CUDA | Pilote 580.126.16 (API pilote CUDA 13.0) ; CUDA toolkit 13.0 |
| Interfaces EFA | 16 par instance, une par carte réseau (cartes 0-15, toutes de type d'interface efa), 200 Gb/s chacune soit 3.2 Tb/s au total. 8 interfaces se trouvent sur chaque nœud NUMA, et chaque GPU partage un commutateur PCIe avec 2 d'entre elles. |
| Logiciel EFA | Programme d'installation EFA 1.50.0, module noyau EFA 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
Sélection des périphériques EFA par NIXL. Le backend LIBFABRIC ouvre les 16 périphériques EFA comme rails avec le efa fournisseur. Il enregistre ensuite le cache KV de chaque GPU uniquement sur les 2 rails qui partagent le commutateur PCIe de ce GPU, de sorte que chaque transfert reste local au PCIe. Aucun override de périphérique NIXL ou libfabric n'a été défini ; il s'agit de la sélection par défaut. Pour le confirmer sur vos propres nœuds, lancez les serveurs avec NIXL_LOG_LEVEL=DEBUG et vérifiez les lignes d'enregistrement :
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Provisionner les nœuds
Installez la pile EFA en espace utilisateur sur les deux nœuds GPU et confirmez que le fournisseur est présent. Nous avons utilisé le programme d'installation 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
Les deux nœuds GPU doivent pouvoir se joindre sur 8100/8200 et sur le canal secondaire NIXL (5600).
2. Installer vLLM et NIXL
Sur les deux nœuds GPU :
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
Sur le nœud proxy (aucun runtime GPU nécessaire) :
pip install vllm aiohttp fastapi uvicorn pandas datasets3. Télécharger le modèle
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. Lancer la paire P/D
Exécutez serve_pd.sh une fois par nœud GPU. La seule différence entre les deux modes est kv_connector: NixlConnector pour le pull, NixlPushConnector pour le push. Les ports, les IDs de moteur, les rôles et les rangs restent identiques.
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
Ce qui se développe, côté prefill, en :
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
Le serveur de décode ajoute --no-enable-prefix-caching, ce qui force chaque requête à récupérer le KV complet depuis le prefill — exactement ce que nous mesurons. Avec le caching activé, des prompts qui se chevauchent pourraient atteindre le cache local du nœud de décode et sauter le transfert P->D, donnant des chiffres trompeurs. Attendez que les deux endpoints /health renvoient 200 avant de lancer le benchmark.
5. Exécuter le balayage
Le script de benchmark se trouve dans #57567; il choisit le proxy correspondant au mode (disagg_proxy_demo.py pour le pull, disagg_proxy_pushconnector_demo.py pour le push) et le pilote avec vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
Arrêtez ensuite les deux serveurs, relancez l'étape 4 avec MODE=push sur chaque nœud, et relancer le balayage avec MODE=push« . Le mode push nécessite en outre les coordonnées NIXL de l'instance de préremplissage («PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE] afin que le proxy puisse indiquer au nœud de décodage où s'enregistrer ; run_sweep.sh remplit ces champs avec les valeurs par défaut utilisées ci-dessus. Conservez QPS_LIST, INPUT_LENS, et OUTPUT_LENS identiques pour les deux exécutions, et assurez-vous PREFILL_TP_SIZE correspond à la taille tensor-parallel réelle du serveur de préfill.
results/ tient <mode>_qps<q>_in<in>_out<out>_iter<i>.json (plus .log) avec le TTFT, l'ITL, le débit et la latence de bout en bout par exécution. Pour redessiner les figures :
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
Dépannage
- Le serveur plante juste après la première requête — le mode ne correspond pas au connecteur. La traction nécessite
NixlConnector; push a besoinNixlPushConnector, à la fois sur P et D. Backend 404: model ... does not exist—SERVED_MODEL_NAMEne correspond pas à celle des serveurs--served-model-name(Qwen).- Le délai de préparation du proxy expire — confirmez que le proxy pour le mode choisi existe sous
$VLLM_SRC/examples/disaggregated/disaggregated_serving/, et que P et D renvoient tous deux/health200. - Erreurs de handshake ou de transfert NIXL — vérifiez EFA (
fi_info -p efa), que le port de side-channel (5600) est ouvert entre P et D, et quePREFILL_TP_SIZEcorrespond à la taille tensor-parallel du serveur de prefill.
Nettoyage
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Ensuite, suivez le guide utilisateur AWS EC2 pour résilier les instances.