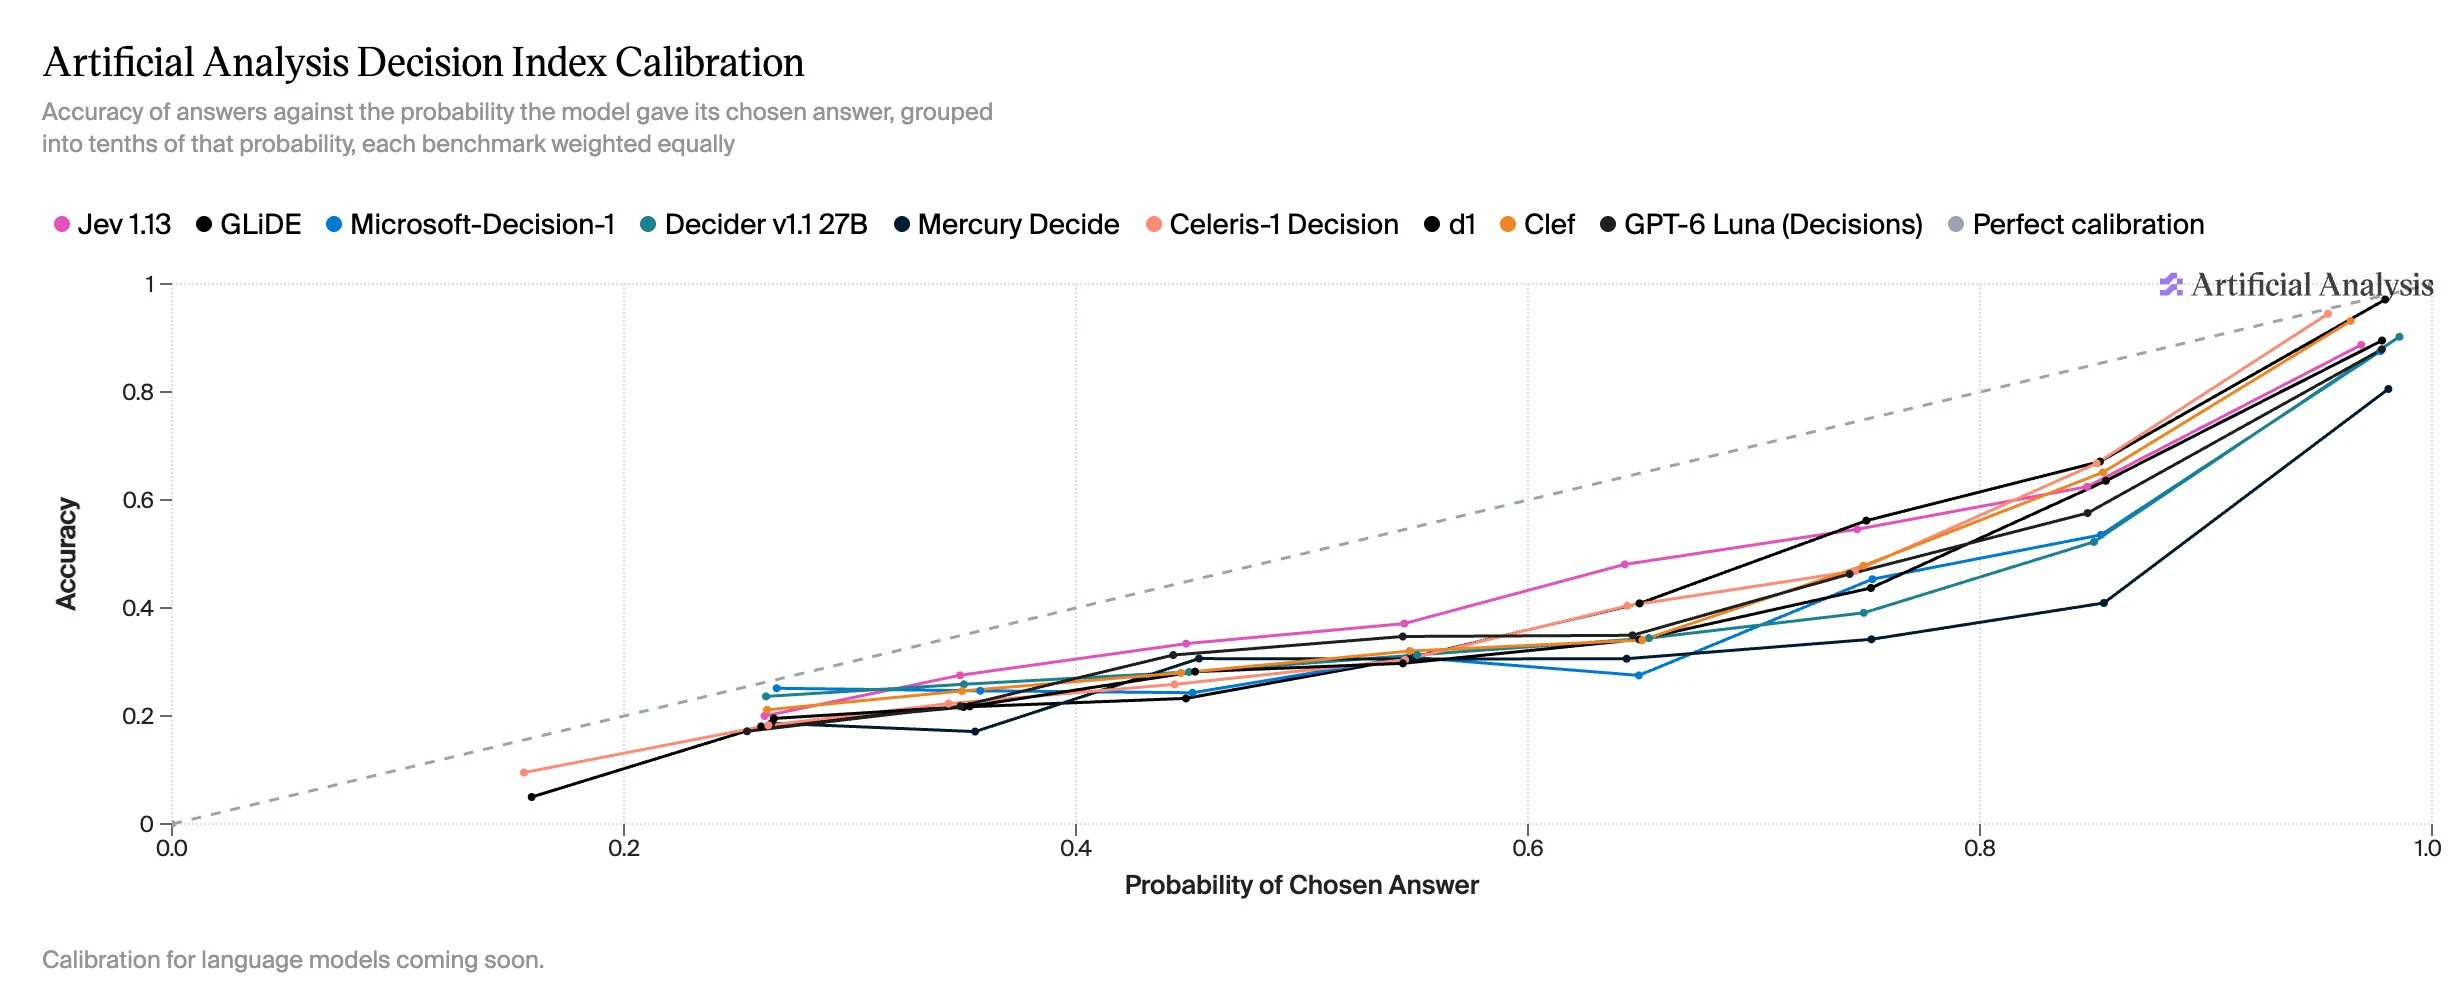
Les modèles de décision sont mal calibrés sur les tâches de connaissances et de raisonnement. Sur presque tous les niveaux de probabilité pour les réponses choisies, la précision est inférieure à cette probabilité pour tous les modèles de décision. Cet écart est le plus important sur AA-Omniscience-Decision et HLE-MultiChoice, tandis que la plupart des modèles sont relativement bien calibrés sur WildGuardTest (classification) et When2Call (appel d'outils)