
Points clés
- La « context rot » (pourriture du contexte) se produit lorsque des agents de longue durée accumulent plus de contexte que le modèle ne peut en contenir, ce qui entraîne des baisses de précision.
- Deep Agents, le harnais d'agent open source de LangChain, utilise cinq techniques pour déplacer le contexte hors de la fenêtre active (sans le supprimer) afin de prévenir la context rot.
- La mémoire d'un agent dans Deep Agents est stockée sous forme de fichiers simples dans un stockage que vous contrôlez, ce qui vous permet de changer de modèle ou de fournisseur tout en conservant tout ce qu'il a appris.
Si vous avez déjà révisé un examen à la veille au soir, vous connaissez cette sensation : plus vous étudiez, plus les premiers chapitres commencent à s'estomper.
Les agents ont le même problème. À mesure qu'ils entreprennent des tâches plus longues, ils accumulent de plus en plus d'informations (instructions, résultats d'outils, fichiers, etc.) ; finalement, cela devient un contexte bien trop volumineux pour tenir confortablement dans la fenêtre de contexted'un modèle. Plus un modèle porte d'historique, de bruit et de sorties d'outils, plus sa précision et son raisonnement ont tendance à se dégrader.
Dans le monde de l'ingénierie des agents, nous appelons cela la context rot. Ce blog couvre les techniques pour gérer la fenêtre de contexte de votre agent et la manière dont le harnais Deep Agents utilise un concept appelé middleware pour les injecter dans l'exécution de votre agent.
Comprendre les techniques d'ingénierie du contexte
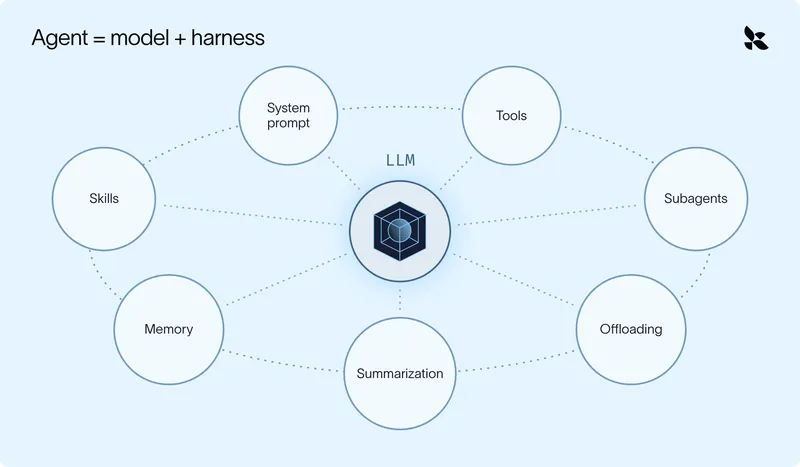
Pour simplifier, un agent n'est qu'un modèle entouré d'un harnais.
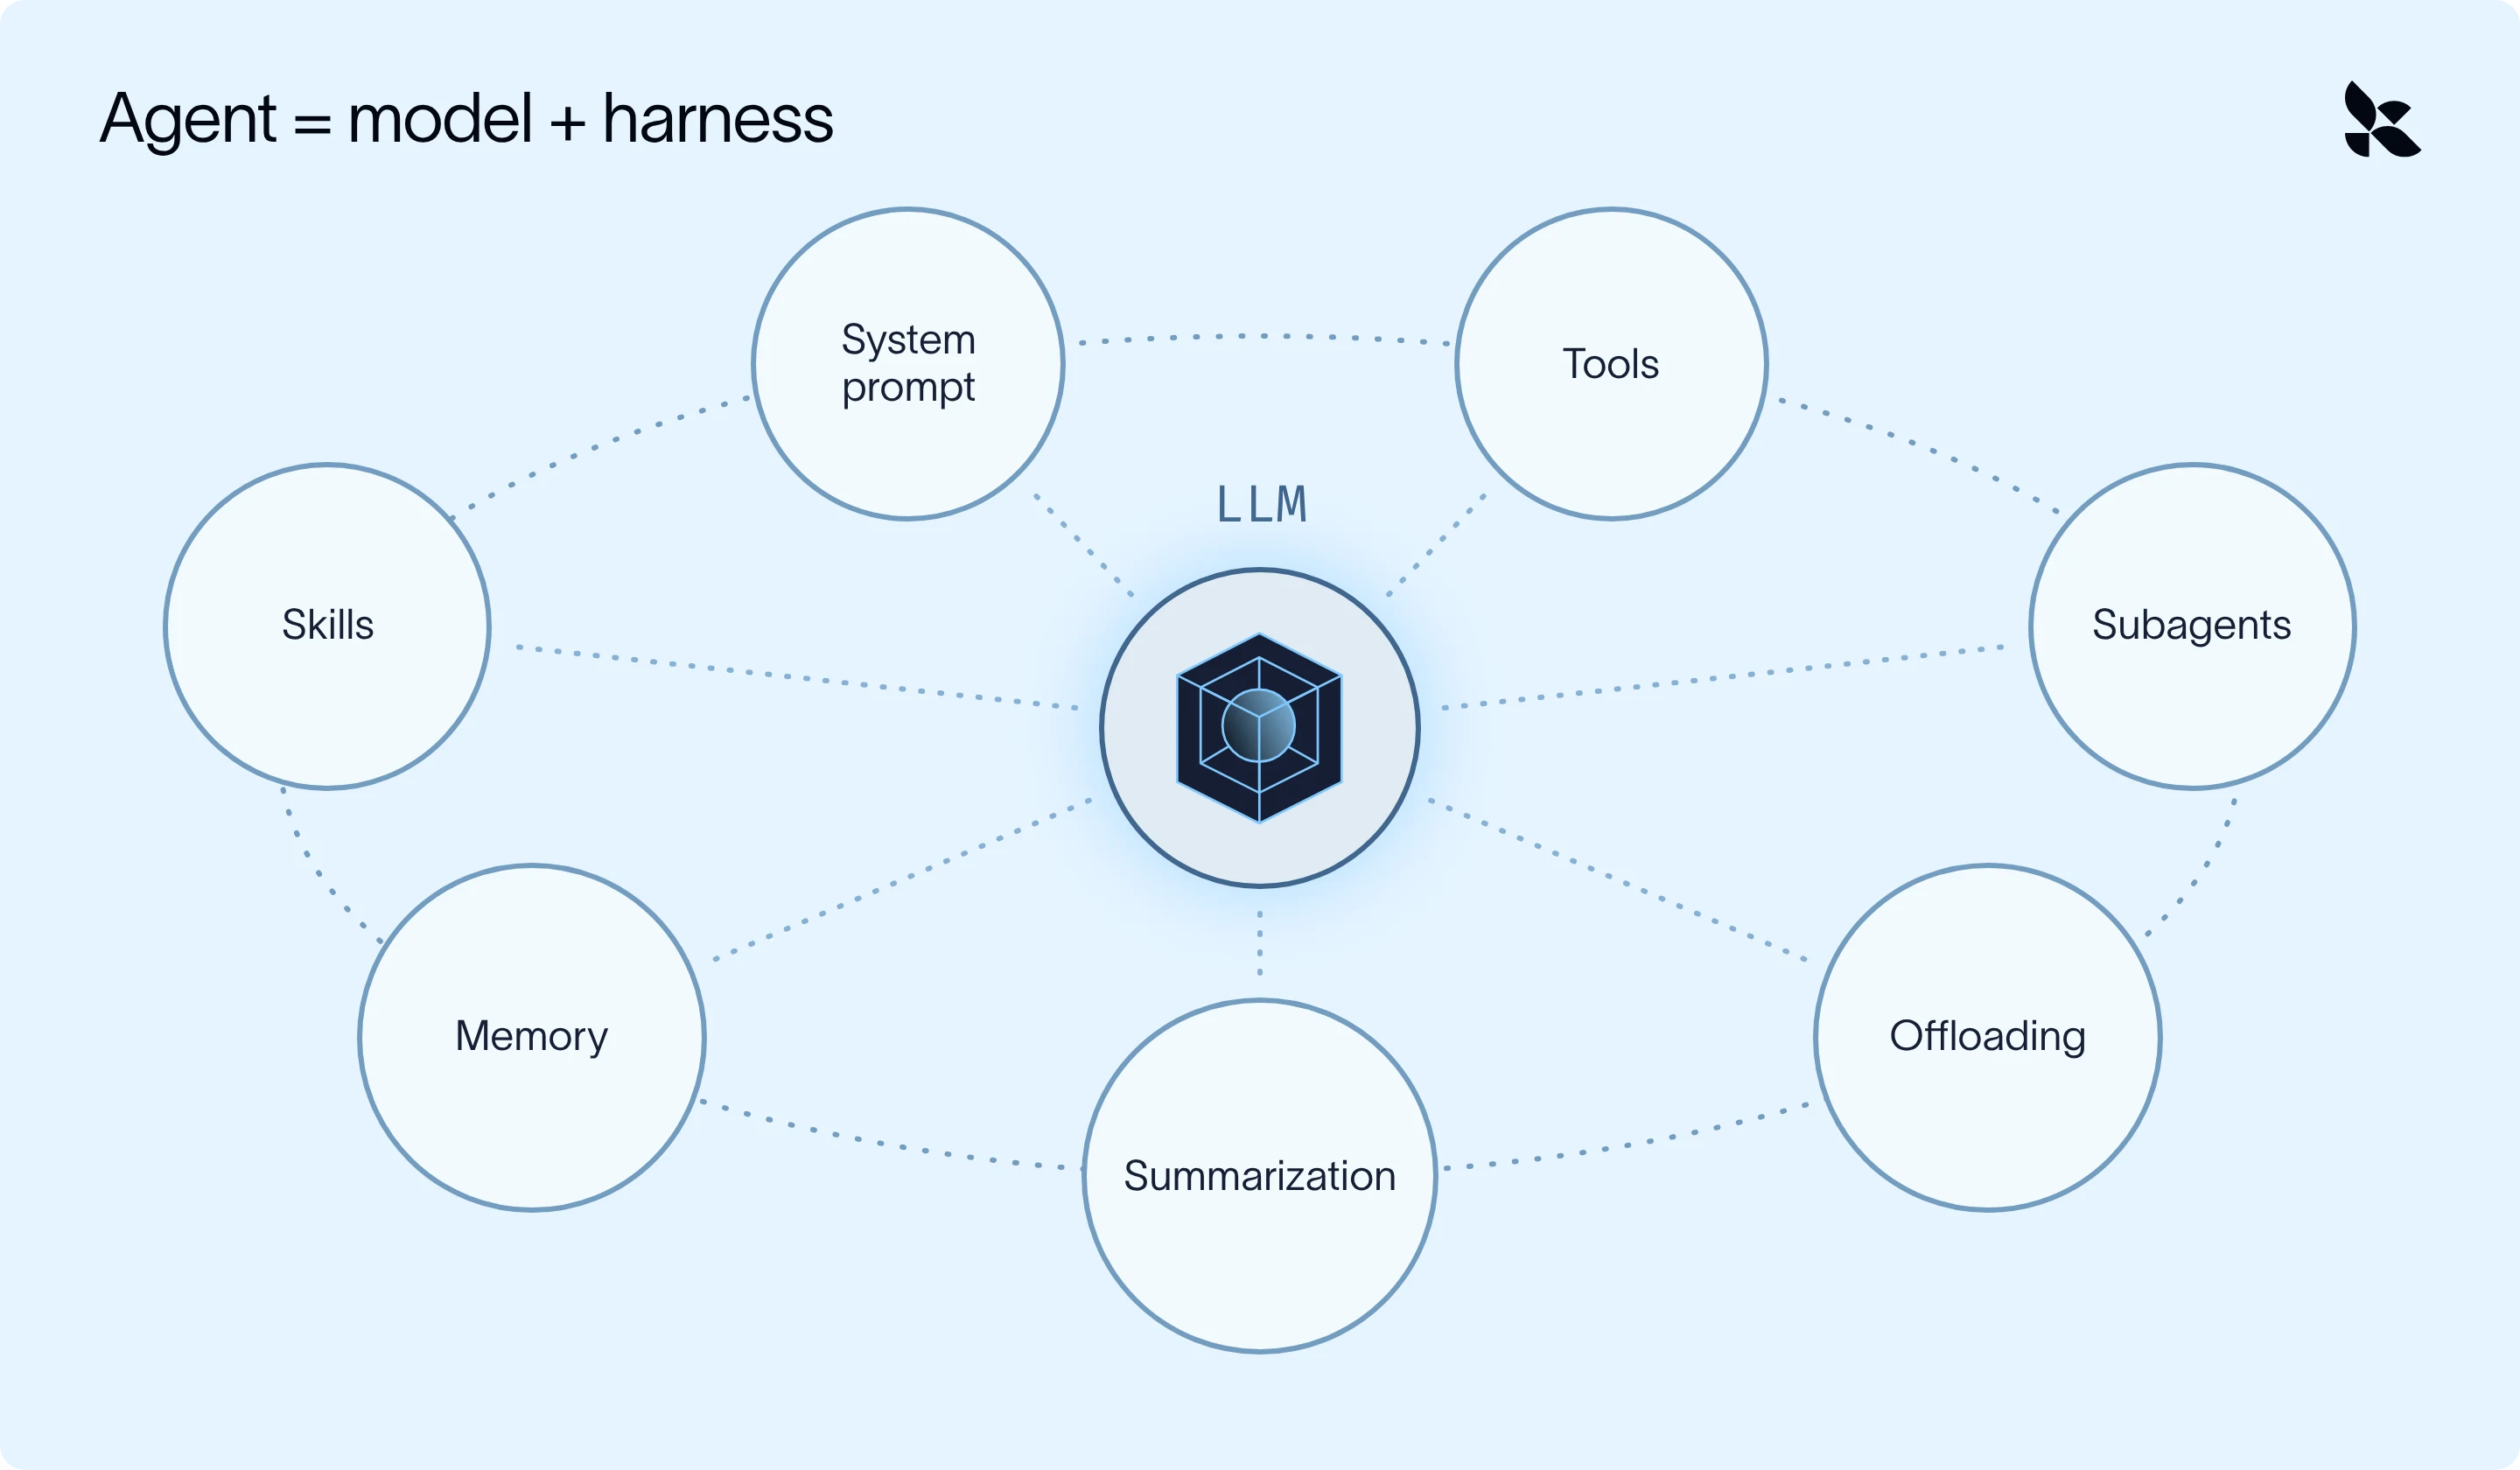
Les techniques d'ingénierie du contexte à la disposition de l'agent pour traiter la context rot relèvent principalement de deux catégories :
- Empêcher les informations inutiles d' entrer dans la fenêtre de contexte
- Gérer et filtrer ce qui se trouve déjà dans la fenêtre de contexte
Le harnais applique ces méthodes stratégiquement pour fournir au modèle le bon contexte au bon moment pour la tâche donnée.
Maintenant, câbler un harnais qui fait cela bien est plus facile à dire qu'à faire, et exige beaucoup de travail (peut-être trop de travail si vous êtes du genre à bachoter la veille des examens).
Deep Agents est le harnais open source de LangChain. Il enveloppe le modèle de votre choix avec des techniques qui déplacent le contexte hors de la fenêtre active (vers des fichiers, des résumés ou un agent distinct), de sorte que l'agent principal ne transporte que ce dont il a besoin (et peut récupérer les données brutes plus tard si nécessaire) :
- Déchargement (Offloading) : les grands résultats d'outils et les messages utilisateur sont enregistrés sur le système de fichiers, et le modèle n'en voit qu'un aperçu.
- Résumé (Summarization) : lorsque la conversation approche de la limite de contexte, les messages les plus anciens sont condensés en un résumé.
- Compétences (Skills) : le savoir-faire n'est chargé que lorsque le modèle juge qu'il est pertinent.
- Sous-agents (Subagents) : le travail bruyant s'exécute dans une fenêtre de contexte distincte, et seul le résultat revient.
- Mémoire à long terme (Long-term memory) : ce que l'agent apprend est sauvegardé dans un fichier qui est conservé pour la conversation suivante.
Appliquer l'ingénierie du contexte à des cas d'usage courants
Voyons comment les techniques ci-dessus peuvent être appliquées à un cas d'usage réel : un agent d'analyse concurrentielle. Chaque lundi, cet agent étudie cinq concurrents et rédige un rapport selon le modèle de l'équipe. Une seule exécution ressemble à ceci :
- Extraire un export de données de marché pour la société A (des dizaines de milliers de lignes)
- Rechercher dans l'actualité, lire quelques articles et prendre des notes
- Répéter pour les sociétés B à E
- Rédiger le rapport, le réviser selon vos retours et le mettre en forme
À l'étape 4, l'agent a transporté cinq exports bruts, des dizaines de résultats de recherche et deux brouillons obsolètes à chaque appel du modèle. La plupart de ces éléments sont inutiles pour la mise en forme du rapport final.
Les méthodes de récupération (RAG, ou recherche sur le système de fichiers) aident l'agent à récupérer seulement ce dont il a besoin, mais cela ne résout encore que la moitié du problème. Même un agent précis accumule des messages, des résultats d'outils et des travaux intermédiaires inutiles, de sorte que le harnais doit aussi gérer ce qui se trouve déjà dans et autour de la fenêtre de contexte.
Comment mettre en œuvre ces techniques : les middlewares
Un agent s'exécute en boucle : le modèle décide quoi faire, appelle un outil, lit le résultat et répète jusqu'à ce que la tâche soit terminée. Middleware est un code qui s'intègre à des points précis de cette boucle : par exemple avant le démarrage de l'agent, autour de chaque appel au modèle, ou autour de chaque appel d'outil.
- À chaque point, il peut lire le contexte et le modifier avant que l'étape suivante ne s'exécute.
- Chaque technique d'ingénierie du contexte présentée dans cet article est un morceau de middleware accroché à l'un de ces points.
- La plupart de cela est intégré, donc vous n'avez pas besoin d'écrire de middleware pour utiliser ces techniques (sauf si vous voulez personnaliser quelque chose de spécifique).
Externalisation : garder hors de la fenêtre de contexte
Notre agent n'a pas toujours besoin de voir toutes les données renvoyées par chaque appel d'outil ou message humain, surtout s'il s'agit d'un grand volume.
Par exemple, chaque appel de l'outil pull_market_report renvoie une exportation complète de données (des milliers de lignes) ; cependant, l'agent n'a besoin que de quelques chiffres, donc le modèle peut être restreint pour ne voir que ces lignes.
FilesystemMiddleware s'exécute à chaque fois qu'un outil est appelé :
- Lorsqu'un résultat d'outil dépasse environ 20,000 tokens, le résultat complet est écrit dans /large_tool_results/{tool_call_id} avant d'entrer dans la conversation.
- Le modèle ne voit qu'un court aperçu (les premières et dernières lignes) plus le chemin du fichier.
- Lorsque l'agent a plus tard besoin du chiffre d'affaires trimestriel de la société B, il parcourt le fichier avec read_file.
Les messages utilisateur/humains surdimensionnés, comme une transcription d'appel collée, reçoivent le même traitement avec un seuil plus élevé (50,000 tokens) et sont enregistrés dans /conversation_history/.
Résumé : compacter ce qui existe déjà
Malgré tous nos efforts pour externaliser les appels d'outils verbeux, le contexte commencera progressivement à s'accumuler sur une longue exécution (par exemple les recherches, notes et brouillons de cinq sociétés). La résumé peut être utilisé pour condenser toute la fenêtre de contexte de notre agent en un résumé de ce qui s'est passé jusqu'ici, afin de lui permettre de poursuivre ses tâches de recherche.
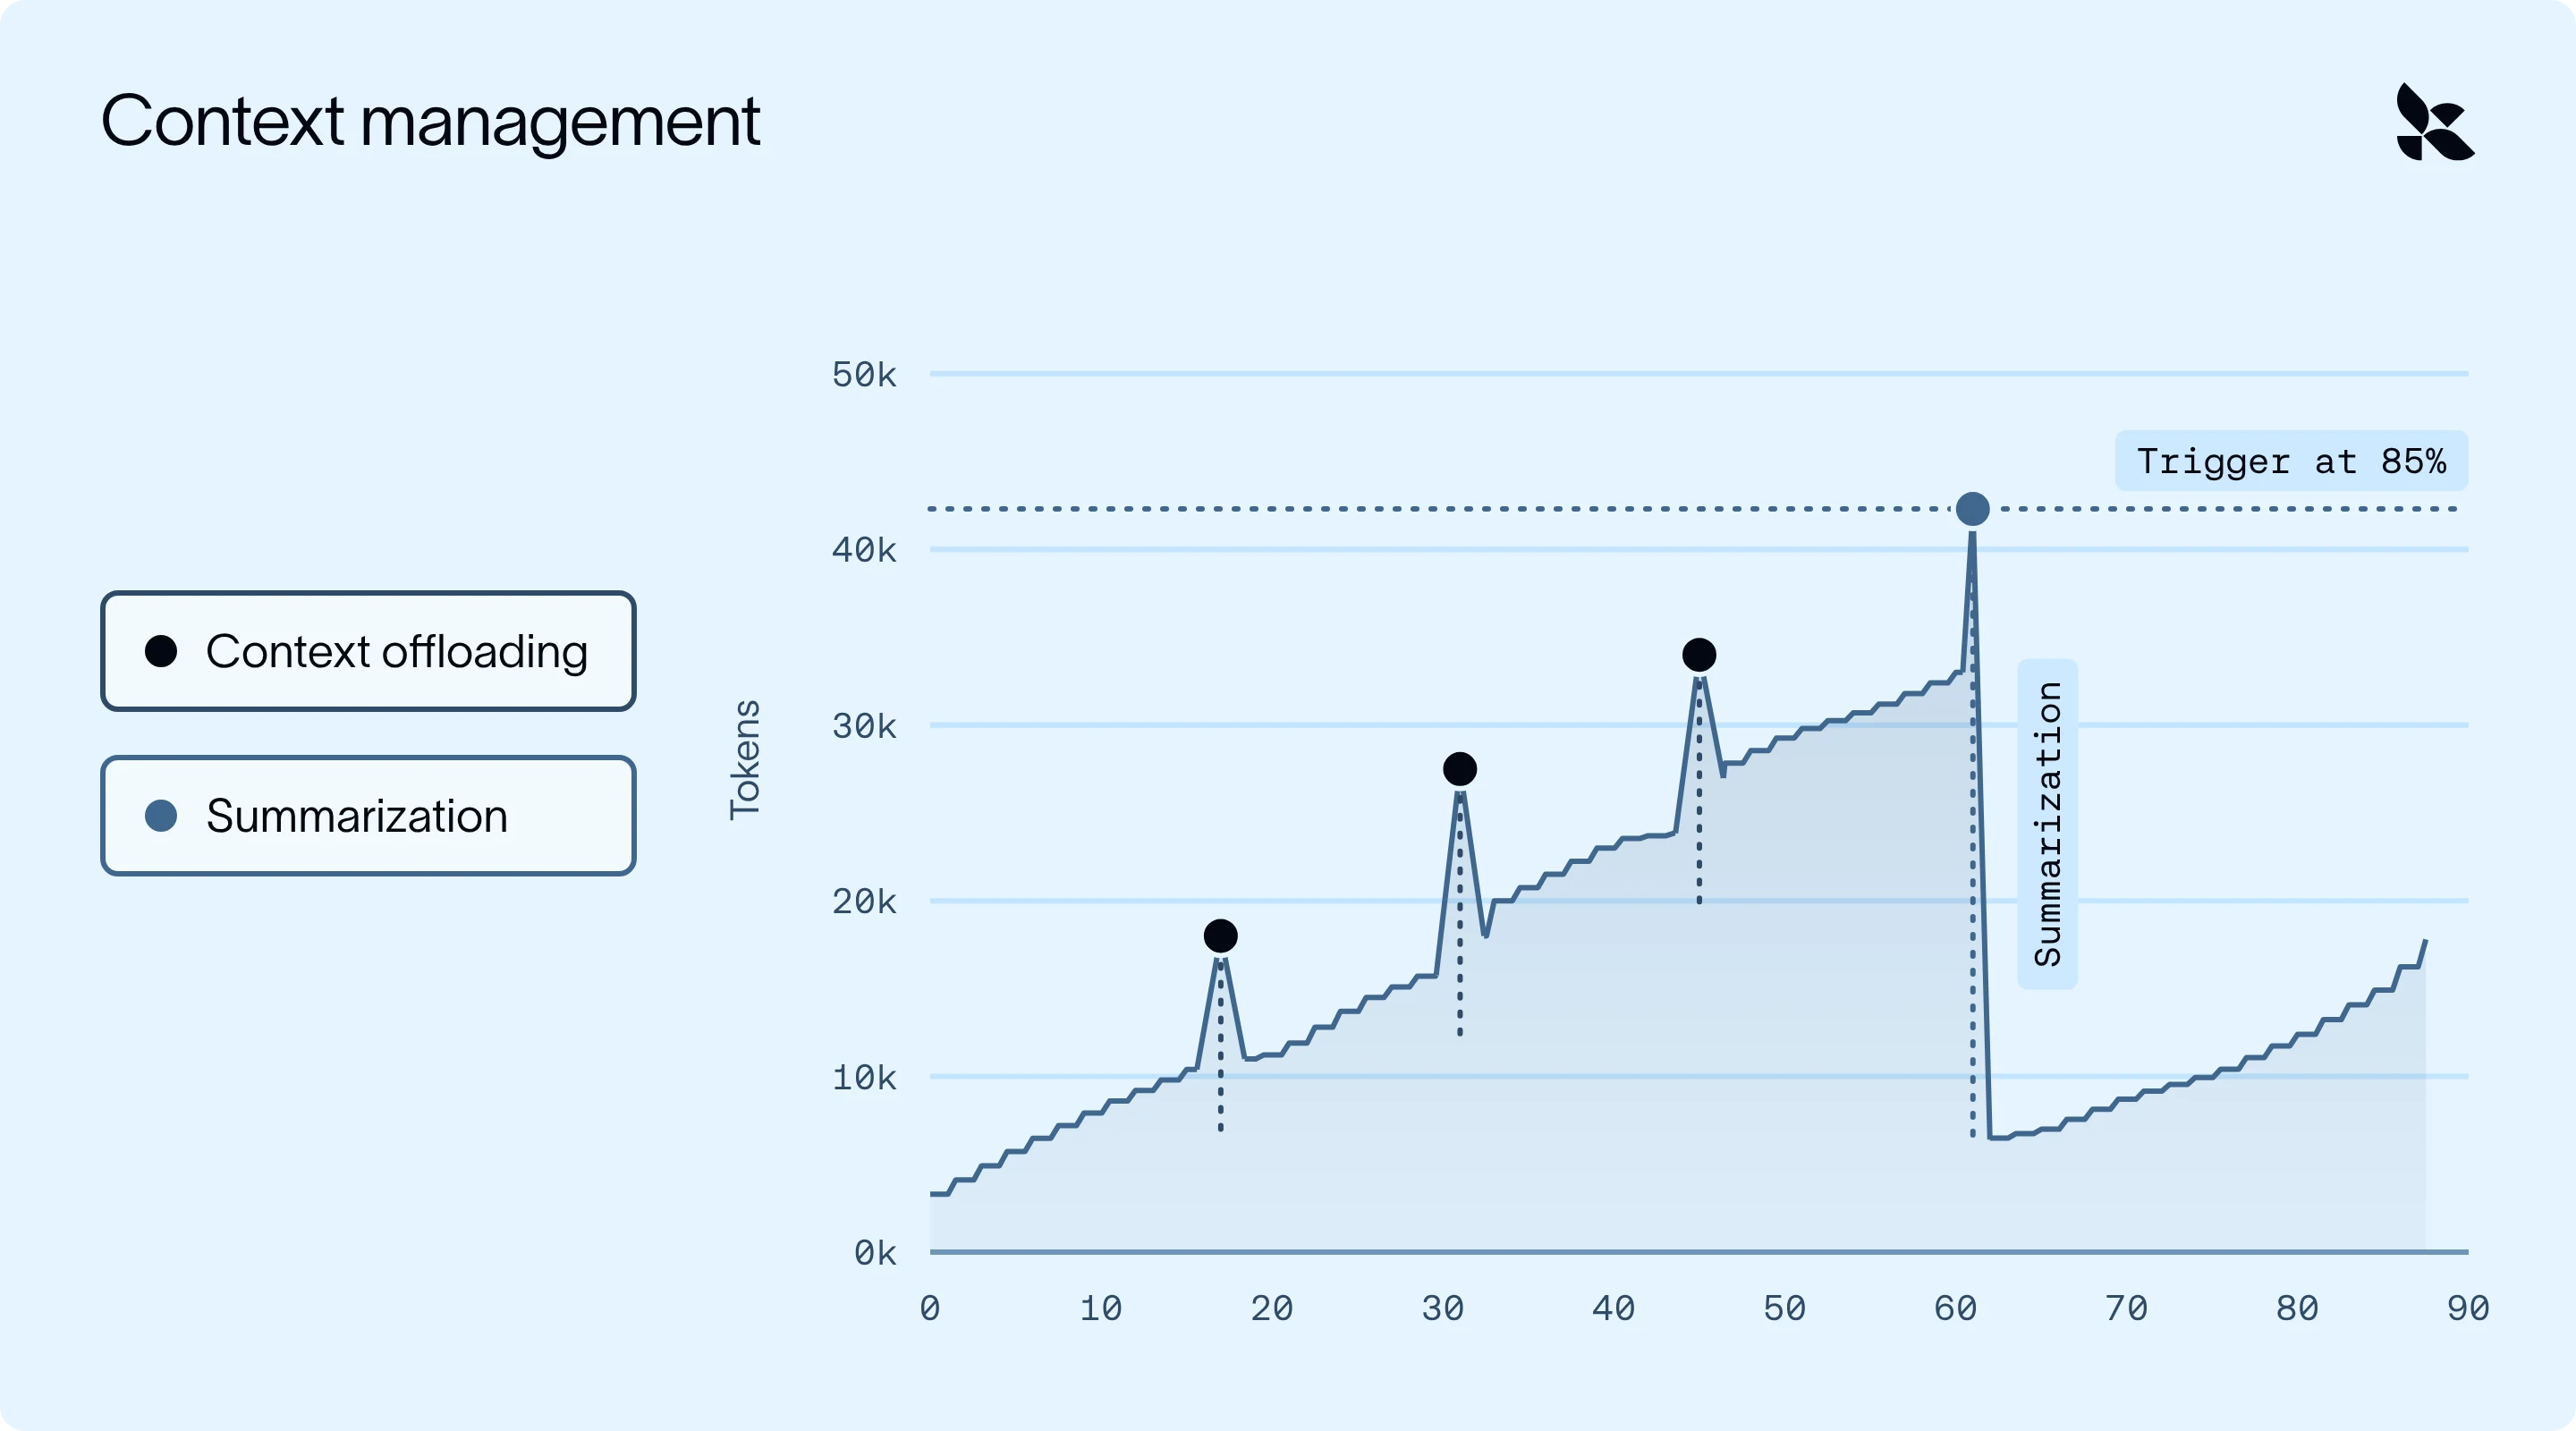
- Les pics sont de grands résultats d'outils/messages humains qui arrivent ; l'externalisation échange chacun contre un court aperçu avant que le modèle ne le voie, donc le contexte ne croît que d'un peu.
- La résumé gère la montée lente : une fois que l'utilisation atteint 85%, les messages plus anciens sont condensés en un résumé et le contexte redescend.
SummarizationMiddleware vérifie l'utilisation des tokens juste avant chaque appel au modèle :
- Une fois que l'utilisation dépasse un seuil (85% de la fenêtre de contexte du modèle par défaut), un appel LLM séparé condense les messages plus anciens en un seul résumé
- Les messages plus anciens sont retirés de la fenêtre de contexte tandis que les messages les plus récents sont conservés mot pour mot.
- Le modèle voit maintenant d'abord le résumé, puis les messages récents (ainsi rien de récent n'est paraphrasé).
Deux détails importants :
- C'est récupérable. Les messages résumés sont écrits dans /conversation_history/{session_id}.md. Si l'agent a besoin d'un détail des recherches sur la société A pendant la rédaction, il peut le relire.
- Cela fonctionne par cycles. Au fur et à mesure que l'exécution continue, l'utilisation remonte, et le résumé suivant inclut le précédent.
Vous pouvez aussi résumer lorsque le sujet change, et pas seulement à un certain seuil de tokens. Il peut être utile de personnaliser le prompt de résumé.
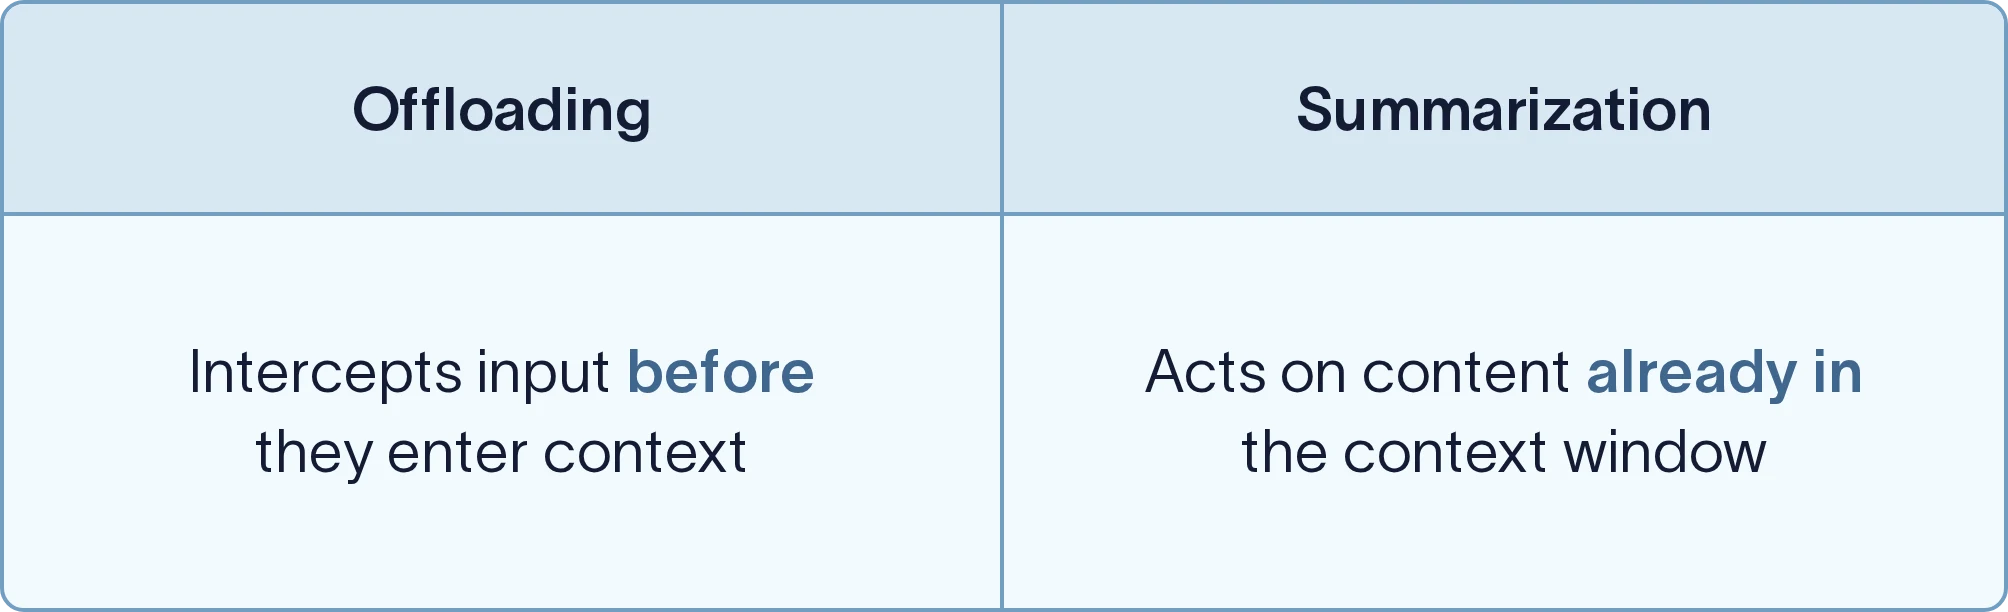
Notre article sur la gestion du contexte pour les Deep Agents traite les deux points plus en détail.
Skills : charger les informations uniquement lorsqu'elles sont nécessaires
Supposons que votre équipe commerciale dispose d'un format spécifique pour les revues commerciales trimestrielles. L'agent n'a besoin de ces instructions qu'une fois par trimestre ; les conserver dans le system prompt revient donc à les payer (en tokens et en temps de réponse) à chaque appel. À la place, vous pouvez regrouper ces informations sous forme de skill.
Un skill est un dossier d'instructions (avec éventuellement des scripts et des documents de référence) qui fournit à un agent ce dont il a besoin pour une tâche spécialisée.
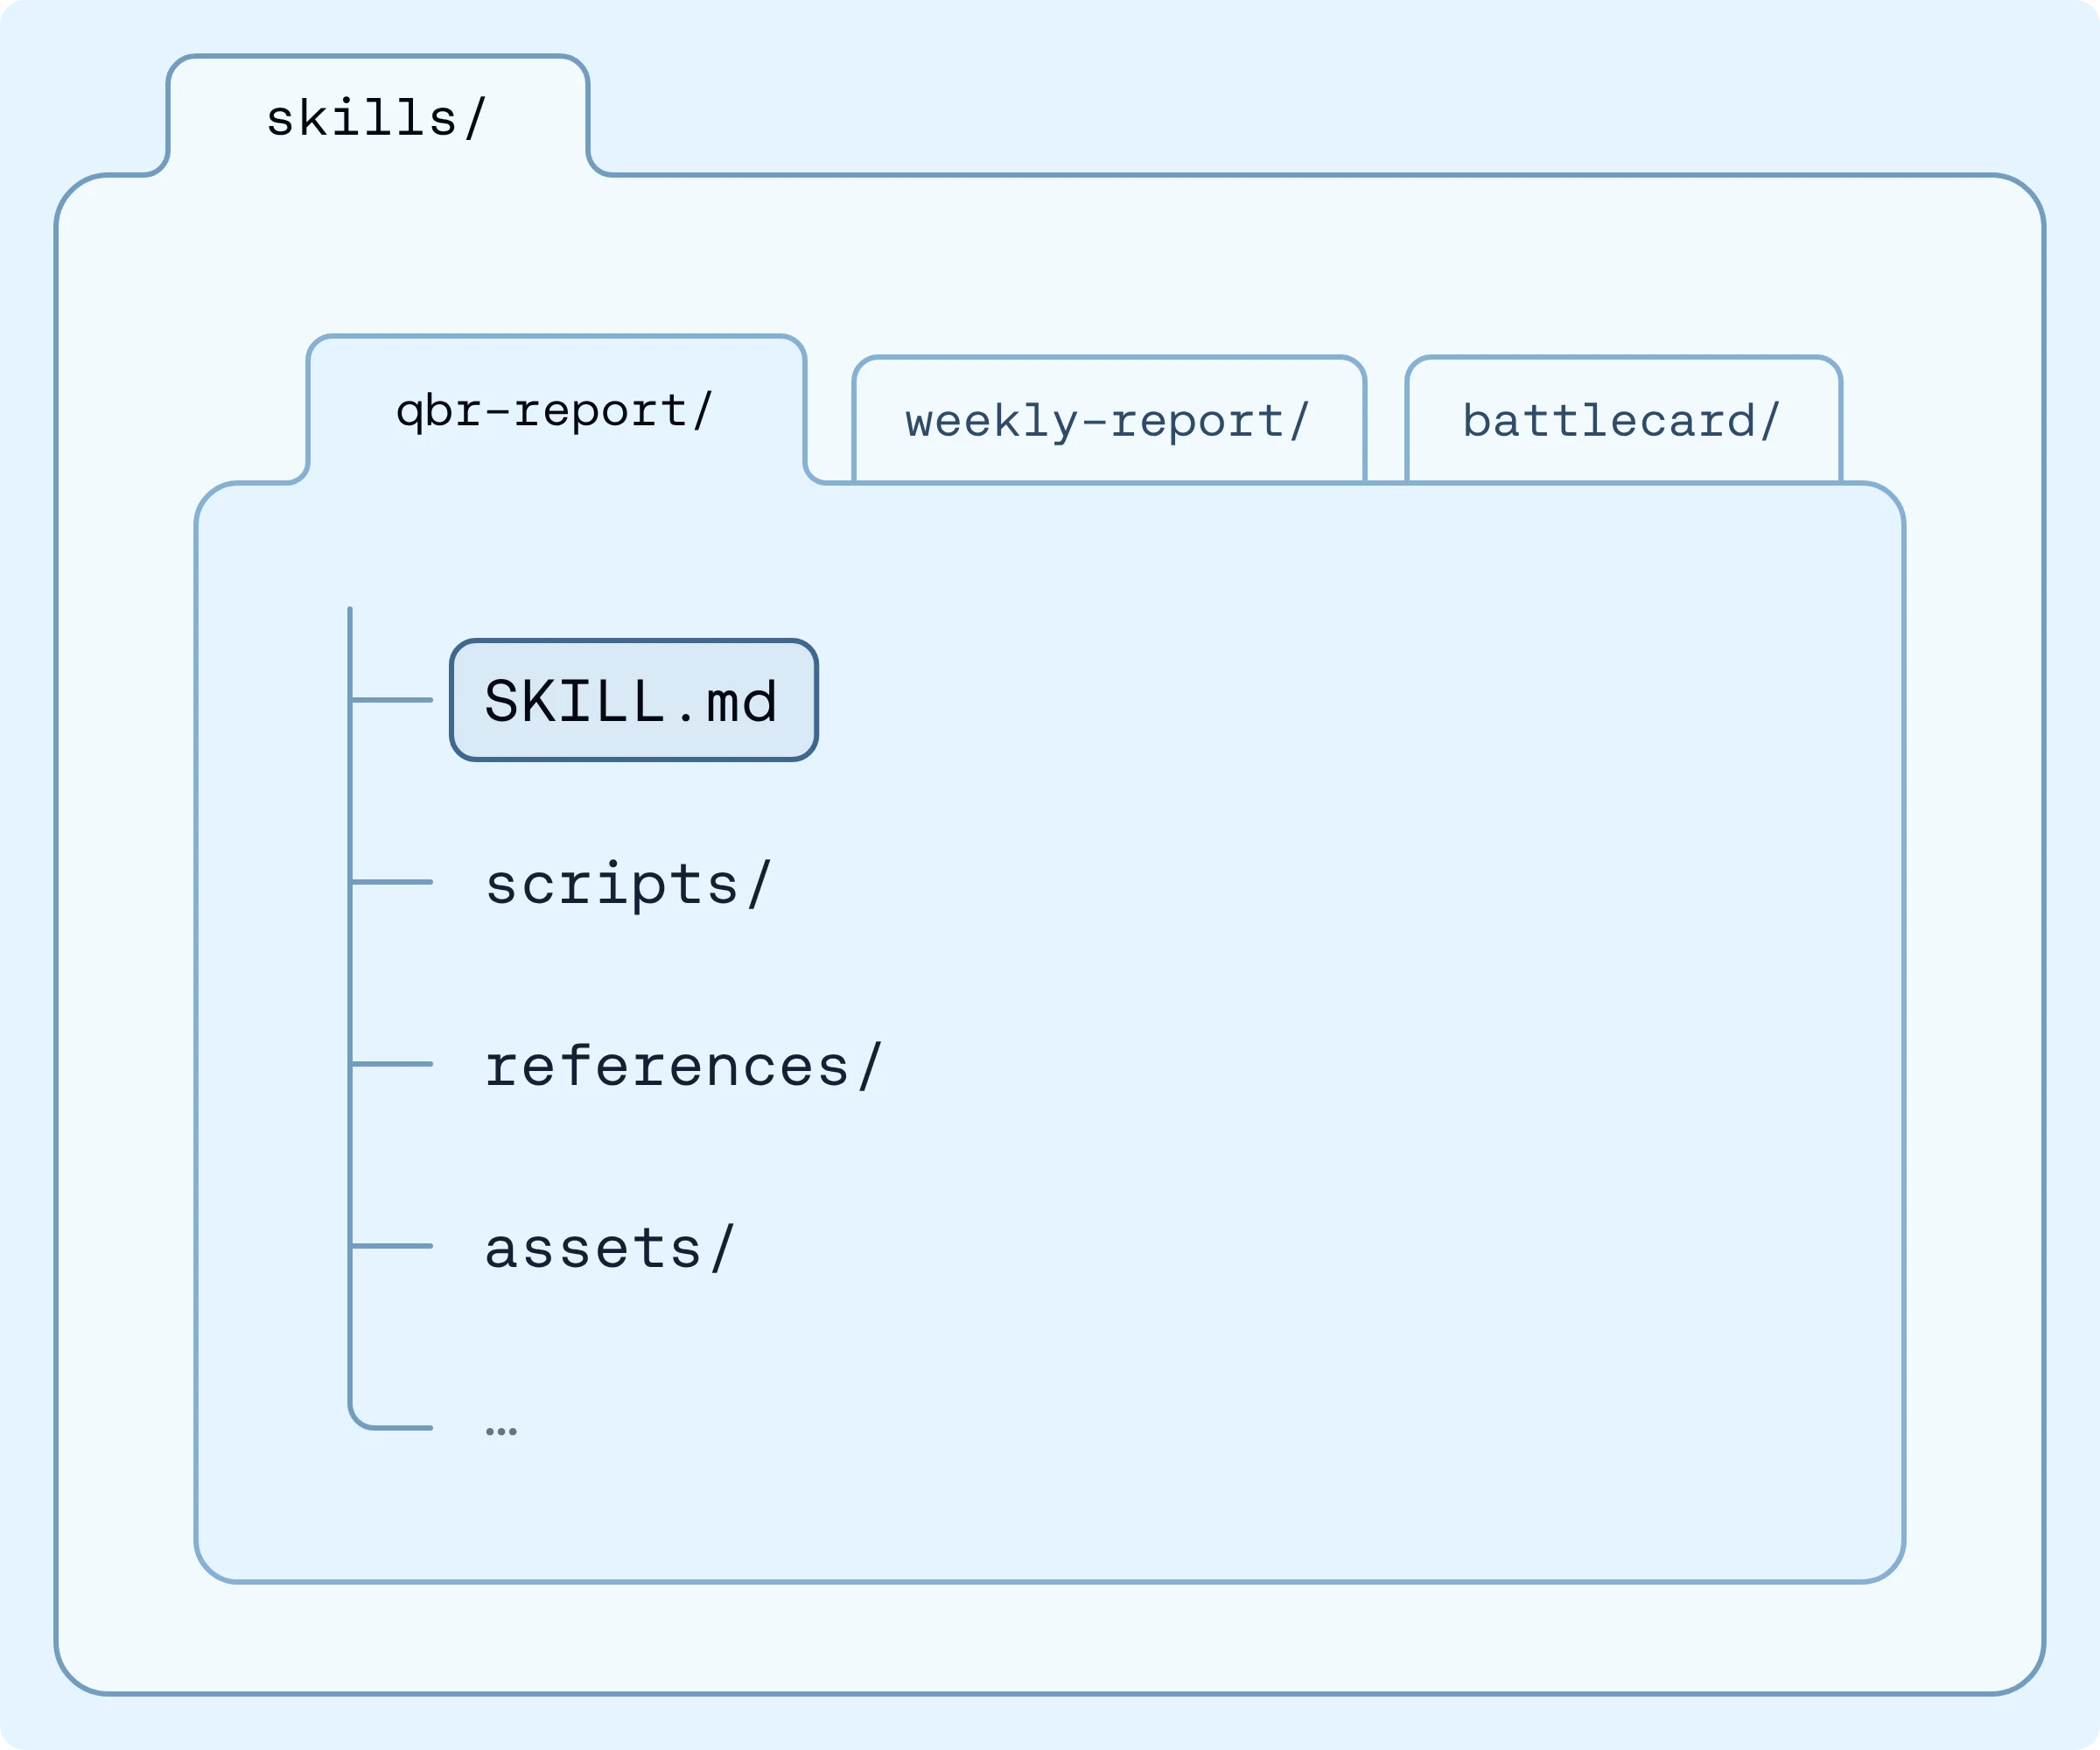
L'agent voit d'abord une courte description et charge les instructions complètes de qbr-report uniquement lorsqu'une QBR arrive (les autres tâches ne les transportent jamais).
Les skills chargent le contexte en couches, de sorte que la fenêtre reste petite jusqu'à ce que quelque chose devienne réellement pertinent. C'est ce qu'on appelle la divulgation progressive : le modèle voit d'abord un « menu » et ne récupère la recette complète que lorsqu'il en a besoin, de sorte que dix skills coûtent à peu près autant de contexte que dix lignes.
Vous pointez l'agent vers vos skills, et SkillsMiddleware utilise deux hooks :
- Avant le démarrage de l'agent, il analyse le dossier des skills et ne lit que l'en-tête de chaque SKILL.md.
- À chaque appel du modèle, il ajoute ces noms et descriptions au prompt système.
Les instructions complètes n'entrent dans le contexte que lorsque le modèle décide qu'un skill est pertinent (et le lit avec un outil read_file), si bien que notre agent effectue ses recherches sans le template et ne le charge qu'au moment de formater un QBR.
Subagents : isoler le travail bruyant
Le déchargement combat efficacement les résultats surdimensionnés, mais les subagents sont un bon choix de conception pour un travail que vous savez déjà bruyant (comme la recherche d'une entreprise à travers des dizaines de recherches et de pages). Le subagent accomplit ce travail dans sa propre fenêtre de contexte et ne renvoie que le résultat final, si bien que l'agent principal ne voit jamais le « bruit ».
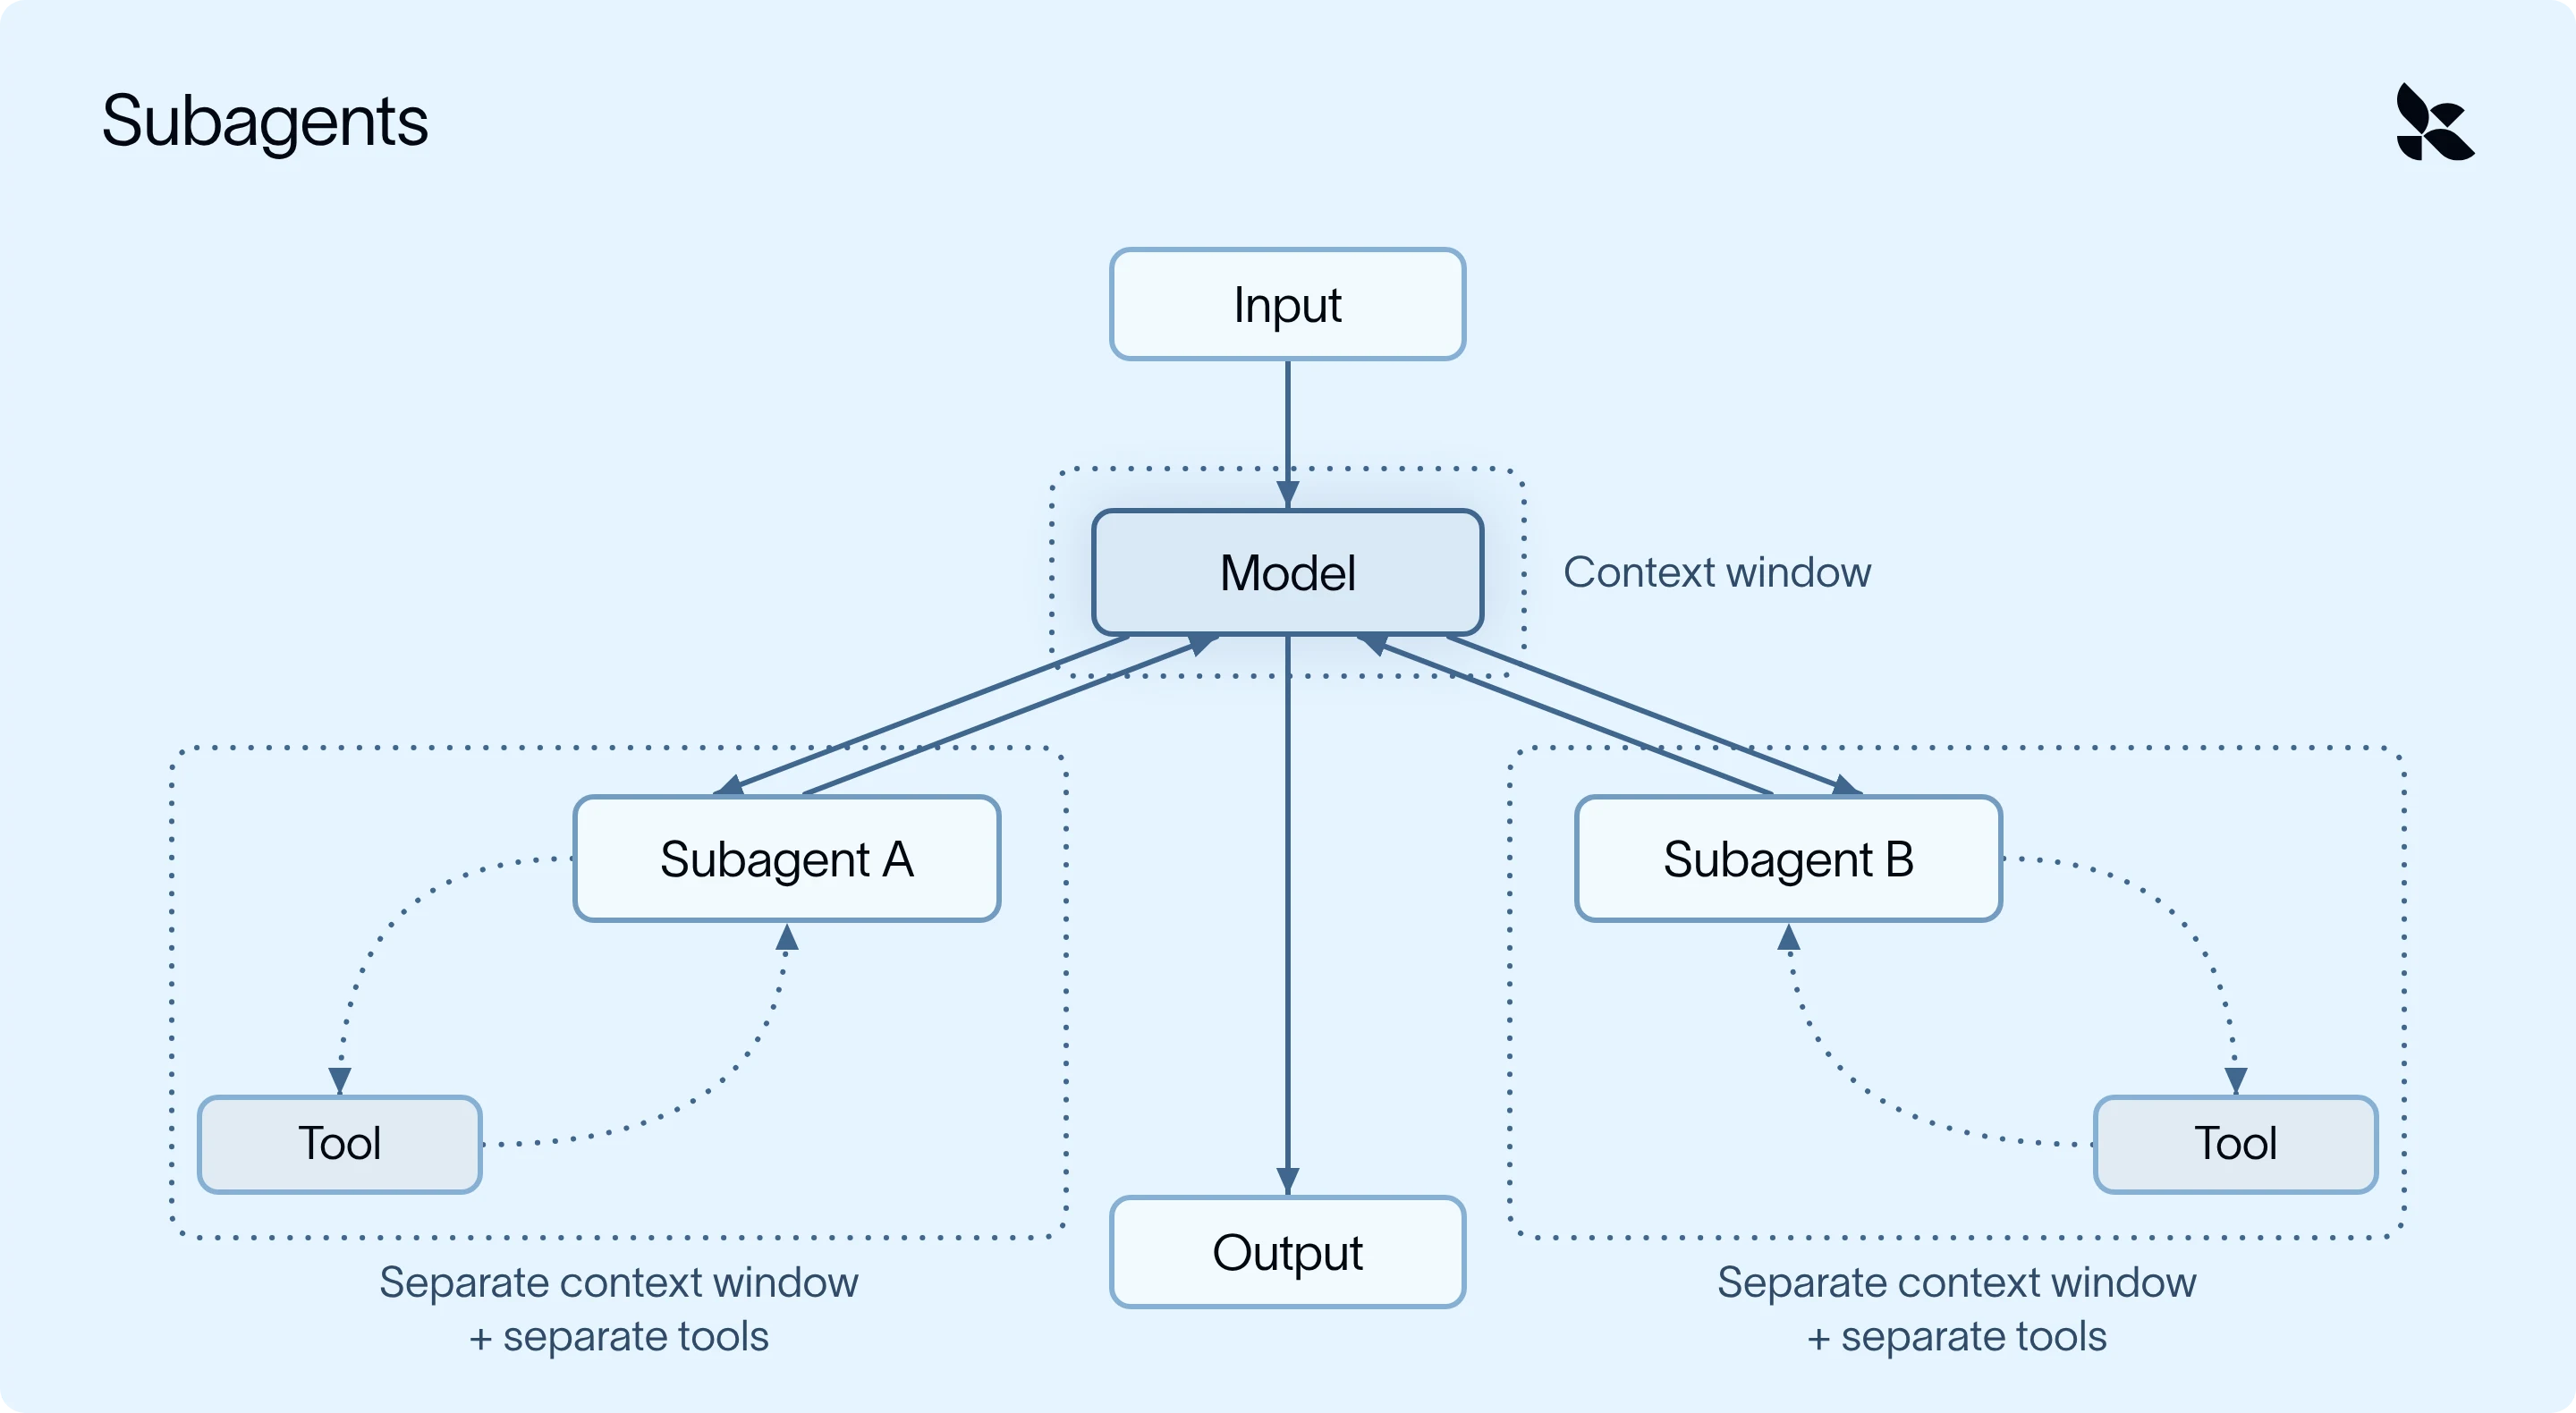
SubAgentMiddleware nous permet de personnaliser le prompt système et les outils disponibles pour nos subagents.
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
Dans notre cas, l'agent principal confie chaque entreprise au subagent market-researcher.
Le subagent chercheur lit le rapport complet dans son propre contexte et ne renvoie que trois puces, de sorte que l'agent principal ne voit que ces trois puces (pas même un aperçu du rapport brut). De plus, comme les tâches des subagents sont généralement petites et bien délimitées, elles peuvent souvent s'exécuter sur un modèle moins cher et en parallèle.
Mémoire à long terme : persister entre les conversations
À la fin, votre agent aura appris beaucoup de choses. Certaines utiles, d'autres non.
Supposons que vous disiez à votre agent : « Utilise des puces dans le résumé, pas des paragraphes. » Sans mémoire, vous pourriez devoir le répéter chaque semaine. Dans Deep Agents, la mémoire à long terme est un fichier markdown. Vous pointez l'agent vers celui-ci avec un seul argument, et MemoryMiddleware s'occupe du reste :
- Chargement : le fichier est lu au début d'une exécution.
- Injection : son contenu est ajouté au prompt système à chaque appel du modèle.
- Mise à jour : lorsque l'agent apprend quelque chose qui vaut la peine d'être conservé, comme votre préférence de formatage, il met le fichier à jour.
Changer de modèle, conserver la mémoire
Deep Agents est indépendant du fournisseur, et cela s'applique aussi à la mémoire. Comme la mémoire est un simple fichier dans votre propre stockage (et non quelque chose qu'un fournisseur conserve), vous pouvez pointer le même backend vers un modèle différent :
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
La semaine prochaine, un modèle différent pourrait lire le même fichier et toujours rédiger le résumé en puces.
Stratégies d'ingénierie du contexte à garder à l'esprit
Que vous construisiez sur Deep Agents, utilisiez un autre harness ou en créiez un vous-même, voici quelques points à surveiller :
- Les entrées volumineuses doivent être déchargées, pas tronquées. La troncature est destructive ; le déchargement permet de les récupérer.
- La compaction doit être réversible. Après la synthèse, l'agent peut toujours récupérer les détails dont il a besoin.
- Le savoir-faire doit se charger à la demande. Les instructions de chaque tâche dans le prompt système consomment du contexte à chaque appel.
- Le travail bruyant doit être isolé. Les sous-agents avec leur propre contexte permettent à l'agent principal de rester concentré.
- Vous devez posséder la mémoire. La mémoire dans un stockage que vous contrôlez survit à un changement de modèle ou de fournisseur.
- Les valeurs par défaut doivent être personnalisables. Les seuils adaptés à une tâche conviennent rarement à toutes les tâches.
Essayez-le
uv add deepagentsVous voulez en apprendre davantage auprès d'un formateur en direct ? J'aborderai ce sujet le 3 novembre : Inscrivez-vous ICI!
Pour approfondir l'ingénierie du contexte, consultez notre cours Deep Agents gratuit et à votre rythme sur LangChain Academy.