
TL;DR
La notation de confiance est désormais prise en charge pour tous les types de spéculateurs basés sur un modèle de brouillon. En l'absence d'une tête de confiance, un estimateur ajusté en ligne dérive une caractéristique des logits du rédacteur pour prédire la probabilité que le modèle cible l'accepte, laquelle est utilisée directement comme score de confiance pour la Vérification adaptative. Les coefficients de l'estimateur sont ajustés en continu, s'adaptant au trafic de données entrant. Cette fonctionnalité a été intégrée dans la PR #52228, et est activée avec enable_adaptive_verification pour les modèles de brouillon dépourvus de tête de confiance.
Contexte
vLLM's Vérification adaptative (AV) permet la vérification d'un sous-ensemble des jetons rédigés lors du décodage spéculatif. Les jetons de brouillon ayant une faible probabilité d'acceptation sont retirés du lot avant d'exécuter la passe avant du modèle cible, ce qui économise du calcul. Cette optimisation est particulièrement bénéfique lors du service de grandes tailles de lot, car dans ce régime le GPU devient limité par le calcul. Voir ce billet de blog de vLLM pour plus de détails.
L'AV a besoin d'une estimation par jeton de la probabilité d'acceptation, c'est pourquoi, jusqu'à présent, il ne prenait en charge que les rédacteurs DSpark. Les modèles DSpark sont souvent livrés avec une tête de confiance : une petite couche linéaire appliquée à l'état caché du rédacteur pour chaque position, entraînée comme un classifieur binaire pour « le modèle cible acceptera-t-il ce jeton ? »
Problème
Les modèles de brouillon dépourvus de tête de confiance, tels que EAGLE, MTP, DFlash et certains checkpoints DSpark, ne bénéficient pas du tout de l'AV. Pour l'utiliser, ces rédacteurs ont besoin d'une estimation d'acceptation par jeton, et l'ajout d'une tête de confiance implique de réentraîner le rédacteur, ce qui n'est pas une option pour les nombreux checkpoints existants que les gens servent déjà.
Travaux antérieurs
Utiliser la confiance propre du rédacteur comme proxy de l'acceptation est une approche bien établie. EAGLE-2 a montré que les probabilités de brouillon d'EAGLE suivent de près les taux d'acceptation, et les a utilisées pour développer et reclasser un arbre de brouillon dynamique. Draft & Verify et plusieurs travaux ultérieurs cessent la rédaction dès que la probabilité du rédacteur tombe en dessous d'un seuil fixe. SpecDec++ entraîne plutôt une tête dédiée de prédiction d'acceptation, d'esprit similaire à la tête de confiance de DSpark. Dans chaque cas, le passage de la confiance de brouillon à l'acceptation est soit utilisé tel quel, soit appris hors ligne.
L'AV a besoin de plus qu'un bon classement. Sa décision de budget additionne les probabilités d'acceptation prédites et les pèse par rapport aux coûts mesurés, de sorte que les prédictions doivent être calibrées pour la paire de modèles et la charge de travail spécifiques servis, ce que fournit l'estimateur ajusté en ligne de la section suivante.
Solution : estimateur d'acceptation ajusté en ligne
Nous avons ajouté une régression logistique légère qui estime la probabilité d'acceptation de chaque jeton de brouillon à partir d'un seul scalaire dérivé de la distribution de brouillon, le log-odds du jeton le plus probable du rédacteur. Il possède une pente partagée et une interception par position de brouillon, de sorte qu'un rédacteur à Kjetons a besoin au total de K + 1 paramètres. Ces paramètres sont ajustés en ligne à partir des décisions d'acceptation/rejet que le modèle cible produit déjà lors de la vérification normale. Tout checkpoint de draft existant obtient AV gratuitement.
Le reste de cette section couvre les deux moitiés de la conception : quelle quantité l'estimateur évalue, et comment ses coefficients sont ajustés pendant le service.
Évaluation de la distribution
Le score de confiance pour un token de draft donné est estimé à l'aide d'une régression logistique par position :
où ω est la pente ajustée, partagée entre toutes les positions de draft, βi est l'ordonnée à l'origine ajustée pour chaque position, et q est la distribution de draft. La forme logarithmique alternative rend la relation claire :
logit(qmax) est la caractéristique de l'estimateur, et représente le log-odds du token le plus probable du draft. Intuitivement, cela représente le degré de confiance du modèle de draft dans ses prédictions. Elle est transformée linéairement par les coefficients ω et βi pour prédire les log-odds de l'acceptation du draft par le modèle cible. La sigmoïde de cela est p, le taux d'acceptation estimé, qui est utilisé comme score de confiance pour AV.
Autres caractéristiques envisagées
Plusieurs caractéristiques alternatives ont été envisagées puis rejetées pour une raison ou une autre. Les quatre principaux axes auxquels nous tenions le plus lors de l'évaluation d'une caractéristique étaient :
- Perte de fidélité — Si la caractéristique biaise la distribution de sortie pendant le décodage spéculatif.
- Aire sous la courbe (AUC) — La probabilité qu'un draft accepté choisi au hasard obtienne un score supérieur à celui d'un draft rejeté choisi au hasard. Cela mesure la discrimination entre les drafts qui devraient être acceptés ou rejetés. Une valeur plus élevée indique une meilleure capacité de discrimination, et 0.5 correspond au hasard.
- Log-loss — La log-vraisemblance négative moyenne de la probabilité d'acceptation prédite, qui pénalise les réponses erronées formulées avec confiance et récompense la calibration. Une valeur plus faible indique une meilleure capacité à prédire la probabilité d'acceptation réelle d'un draft donné.
- Expected Calibration Error (ECE) — Répartir chaque brouillon dans une case en fonction de sa probabilité d'acceptation prédite, puis mesurer l'erreur entre la prédiction moyenne et la fréquence observée moyenne au sein de chaque case, pondérée par le taux d'occupation de la case. Cela mesure la calibration, et une valeur plus faible indique une meilleure capacité à assigner à un brouillon une probabilité correspondant à la fréquence réelle parmi les brouillons notés de manière similaire.
La losslessness est une propriété non négociable que les caractéristiques doivent posséder. Sinon, nous brisons la garantie fondamentale du décodage spéculatif de produire la distribution exacte du modèle cible. L'AUC et l'ECE comptent toutes deux pour la décision de trimming de l'AV, mais de différentes manières. L'AUC est importante pour l'ordonnancement local des probabilités de survie :
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
L'AUC garantit qu'un jeton de brouillon plus susceptible d'être accepté est admis de préférence à un jeton moins susceptible. En revanche, l'ECE est importante pour la décision de budget global :
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
Les probabilités sont sommées puis divisées par la table de coûts mesurée. L'ECE garantit que le nombre estimé de jetons acceptés correspond à la réalité.
Ci-dessous se trouve un tableau des différentes caractéristiques expérimentées, avec leurs scores pour les quatre catégories. Elles ont été mesurées sur ~4.5M brouillons étiquetés collectés au cours du service de DeepSeek-V4-Flash + DSpark (temp=1, top-p=0.95, conc=64), sans AV, sur cinq jeux de données : SPEED-Bench 2k low/high-entropy, GSM8K, HumanEval et MT-Bench. Les deux dernières lignes sont des références plutôt que des caractéristiques ajustées : le qmax du drafteur utilisé directement comme probabilité d'acceptation sans ajustement, et les scores de la tête de confiance entraînée.
| caractéristique | lossless | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | oui | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd) (marge top-2) | oui | 0.8156 | 0.4437 | 0.0105 |
| H(q) (entropie) | oui | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qmax)) | oui | 0.8336 | 0.4289 | 0.0103 |
| logit(qmax) (livré) | oui | 0.8336 | 0.4284 | 0.0100 |
| logit(qéchantillonné) | non | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qéchantillonné)) | non | 0.8554 | 0.4075 | 0.0193 |
| qmax (pas d'ajustement, utilisé directement comme probabilité) | oui | 0.8259 | 0.4880 | 0.0736 |
| tête de confiance entraînée | oui | 0.8191 | 0.4449 | 0.0052 |
logit(qéchantillonné) et −log(−log(qéchantillonné)) surpassent clairement la caractéristique retenue dans le tableau en termes d'AUC, mais n'ont pas été utilisées car un rognage basé sur celles-ci produit une distribution de sortie biaisée. Both read qsampled, la probabilité du jeton que le rédacteur a réellement tiré. Rogner une ébauche sur une fonction de cette valeur rend la décision de vérifier à la position i dépendante de xi lui-même, de sorte que les ébauches qui survivent au rognage ne sont plus distribuées selon q. L'échantillonnage par rejet standard accepte un jeton avec la probabilité min(1, p/q), en supposant que q est la distribution à partir de laquelle le jeton d'ébauche a été échantillonné. Mais un rognage basé sur qsampled biaise la distribution émise vers les jetons de plus grande confiance du rédacteur.1
La ligne qmax « no fit » montre pourquoi nous effectuons un ajustement, au lieu d'utiliser directement la probabilité du rédacteur, comme le fait EAGLE-2 lors de la construction de son arbre d'ébauche. Utilisée directement, la probabilité du meilleur jeton du rédacteur classe en fait les ébauches mieux que la tête de confiance entraînée (0.8259 vs 0.8191 AUC). Cependant, elle n'est pas bien calibrée. Sa prédiction moyenne sur les ébauches étiquetées est de 0.784 contre le taux d'acceptation observé de 0.723, et son ECE est 7 fois pire que celle de la caractéristique logit(qmax) livrée (0.0736 vs 0.0100). La probabilité du meilleur jeton du rédacteur ne reflète que le niveau de confiance du rédacteur dans sa propre prédiction, et non si le modèle cible sera d'accord. Cet accord est en outre influencé par la configuration d'échantillonnage et la charge de travail. Un ajustement en ligne apprend cette correspondance directement à partir des décisions d'acceptation/rejet de la cible, offrant une meilleure calibration, ce dont dépend la décision de budget.
Nous avons finalement retenu la caractéristique logit(qmax), qui présente un bon équilibre entre AUC et ECE à un coût raisonnable. C'était aussi un choix naturel, puisqu'elle partage à la fois l'échelle des log-odds et la résolution de la quantité que nous cherchions à estimer.
Face à une tête de confiance entraînée
Comme le montre le tableau ci-dessus, pour DeepSeek-V4-Flash + DSpark, l'estimateur surpasse la tête de confiance à la fois en AUC et en perte de log-vraisemblance, mais fait moins bien en ECE. Le tableau ci-dessous résume la différence :
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimateur logit(qmax) | 0.8336 | 0.4284 | 0.0100 |
| tête de confiance entraînée | 0.8191 | 0.4449 | 0.0052 |
| Δ (estimateur − tête) | +0.0146 | −0.0166 | +0.0048 |
Cependant, une fois que nous excluons le premier jet des moyennes, le tableau change considérablement :
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| estimateur logit(qmax) | 0.8352 | 0.4420 | 0.0103 |
| tête de confiance entraînée | 0.8075 | 0.4743 | 0.0090 |
| Δ (estimateur − tête) | +0.0278 | −0.0323 | +0.0013 |
La tête et l'estimateur sont désormais pratiquement à égalité en calibration. La répartition de l'AUC par position aide à expliquer pourquoi :
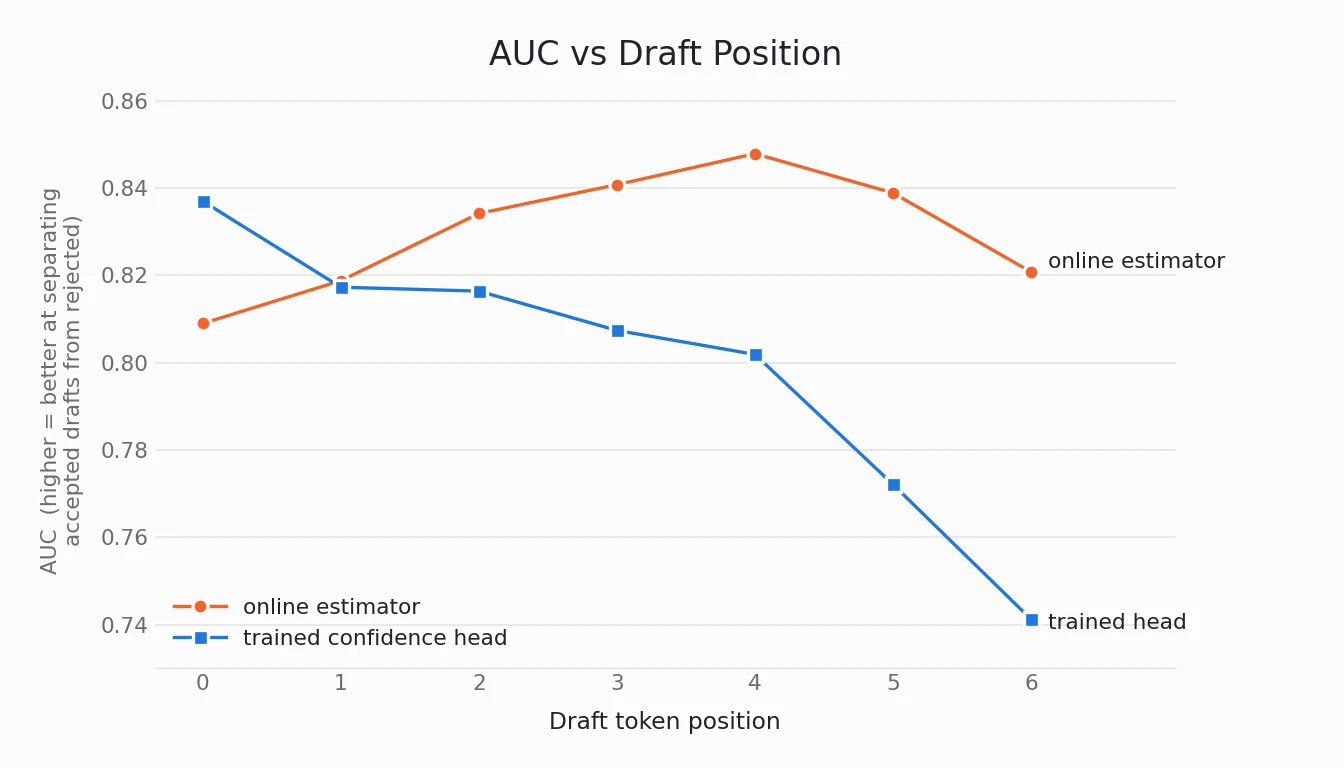
La tête de confiance est le meilleur prédicteur sur la première position de jet, mais l'estimateur prend la tête à partir de la deuxième position. L'écart se creuse avec la profondeur, l'estimateur menant de 0.08 AUC à la dernière position. Les deux prédicteurs chutent également après la cinquième position. C'est probablement parce que le DSpark de DSV4-Flash déclare une taille de bloc de 5 et que le brouilleur n'a jamais été entraîné au-delà, de sorte que les jets eux-mêmes se dégradent là.
Puisque la survie est un produit cumulé, et que la première position de jet porte toujours le score le plus élevé d'une requête, c'est moins souvent le jeton que le budget coupe. L'avantage de l'estimateur se situe exactement là où l'élagage se produit, et cela explique pourquoi l'estimateur peut égaler la tête de confiance en performance de bout en bout.
Ajustement des coefficients
Les coefficients ω et βi sont réajustés en continu pendant le service en direct des requêtes. Les jetons de jet proposés lors de l'étape de décodage précédente sont vérifiés par le modèle cible lors de l'étape de décodage suivante. Seuls les jetons de jet jusqu'à la première rejection (le cas échéant) sont éligibles pour l'entraînement, car le modèle cible les a explicitement étiquetés (accepter ou rejeter).
Nous utilisons les moindres carrés pondérés itérativement (IRLS) pour minimiser la perte de log-vraisemblance des prédictions par rapport aux étiquettes. Cette minimisation est effectuée sur une approximation de Taylor au second ordre de la perte de log-vraisemblance. L'étape d'optimisation pour ω et βi est obtenue en résolvant le système d'équations
où Δθ est le delta pour la pente partagée ω et les intercepts par position βi, H est la hessienne de la fonction de perte, avec une forme de (K + 1) × (K + 1), et g est le gradient de la fonction de perte, avec une taille de K + 1.
Un réajustement a lieu après chaque cycle fixe de N étapes de décodage. Au cours de chaque étape de décodage de cet intervalle, nous accumulons les valeurs de la hessienne et du gradient, qui sont dérivées des coefficients, des caractéristiques et des étiquettes collectées pendant le cycle. Cela limite la mémoire à O(K²) sur un cycle, par contraste avec O(N × B × K) si nous collections plutôt les étiquettes brutes. À la dernière étape du cycle, le système est résolu et les coefficients sont mis à jour.
Comme on pouvait s'y attendre, les brouillons plus profonds sont acceptés moins souvent que les brouillons moins profonds. Par conséquent, les positions de brouillon plus profondes peuvent être privées d'étiquettes au cours d'un cycle. Deux décisions de conception ont été prises pour atténuer l'impact de ce phénomène sur le processus de réajustement :
- Pente partagée: la pente est partagée entre toutes les positions de brouillon afin d'éviter les mises à jour bruitées causées par l'amincissement des données en profondeur. Les prédictions sont bien plus sensibles aux erreurs de pente qu'aux erreurs d'ordonnée à l'origine, de sorte que le partage rend le pas de Newton bien déterminé. En outre, des mesures empiriques montrent que le partage de la pente ne coûte pratiquement rien en termes de précision (seulement 0.0002 AUC et 0.0003 log-loss).
- Amortissement du pas: la mise à jour de chaque coefficient est mise à l'échelle par la quantité de preuves à l'appui selon la formule n / (n + constant), où n est le nombre de brouillons évalués. Cela garantit que les positions plus profondes, disposant de moins d'étiquettes, évoluent de manière plus conservatrice, empêchant ainsi les mises à jour fondées sur le bruit.
Rôles de la pente et de l'ordonnée à l'origine
Les coefficients ajustés ont été suivis à travers plusieurs combinaisons modèle/jeu de données, et les deux types de paramètres se comportent de manière très différente.
Gardez la paire de modèles fixe et faites varier la charge de travail: En ajustant DSV4-Flash + DSpark indépendamment sur chacune des cinq charges de travail, la pente bouge à peine (0.51 à 0.55), sans corrélation avec la difficulté de la charge de travail (r = −0.08 contre l'entropie moyenne du draft). Les intercepts font l'inverse : l'intercept de la première position de draft est corrélé à l'entropie du draft avec r = −0.89, et passe d'environ 0.5–0.6 sur les charges de travail les plus prévisibles à moins de 0 sur la moins prévisible.
| Jeu de données | Taux d'acceptation | Entropie moyenne du draft | Pente ω | Ordonnée à l'origine β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k low-entropy | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k high-entropy | 0.642 | 1.077 | 0.5197 | −0.089 |
Faisons maintenant varier la paire de modèles : La pente varie de 0.45 à 0.59 selon les paires, tout en restant serrée au sein de chacune d'elles. Les ordonnées à l'origine diffèrent également entre les paires, de sorte que, contrairement à la pente, elles ne sont pas une propriété d'un seul axe.
| Modèle | nspec | Pente ω | ω sd | Ordonnée à l'origine β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
Lus ensemble, les deux tableaux suggèrent une division du travail. La pente mesure à quel point le modèle de brouillon sait quand il a raison. Il s'agit d'une propriété de la paire cible/brouillon et de la méthode d'échantillonnage du brouillon, c'est pourquoi elle change à peine quand seule la charge de travail varie. Les ordonnées à l'origine absorbent le reste : le taux d'acceptation de base à chaque position du brouillon, qui diminue avec la profondeur et chute encore davantage sur un contenu moins prévisible. Ce taux d'acceptation de base dépend de la paire de modèles ainsi que de la charge de travail, c'est pourquoi les ordonnées à l'origine varient selon les deux axes tandis que la pente ne varie que selon un seul.
Benchmarks
Nous avons évalué trois checkpoints (MiMo-V2.5-Pro-FP4 + DFlash, Inkling-NVFP4 + MTP et Muse-Glimmer-30B + DFlash2) qui ne pouvaient auparavant pas du tout utiliser AV, ainsi que DSV4-Flash + DSpark + l'estimateur, et DSV4-Flash + DSpark + la tête de confiance, comme référence. Les gains ci-dessous ont été mesurés avec AV désactivé vs activé, temperature 1.0, top-p 0.95 et une concurrence de 64, sur quatre jeux de données.
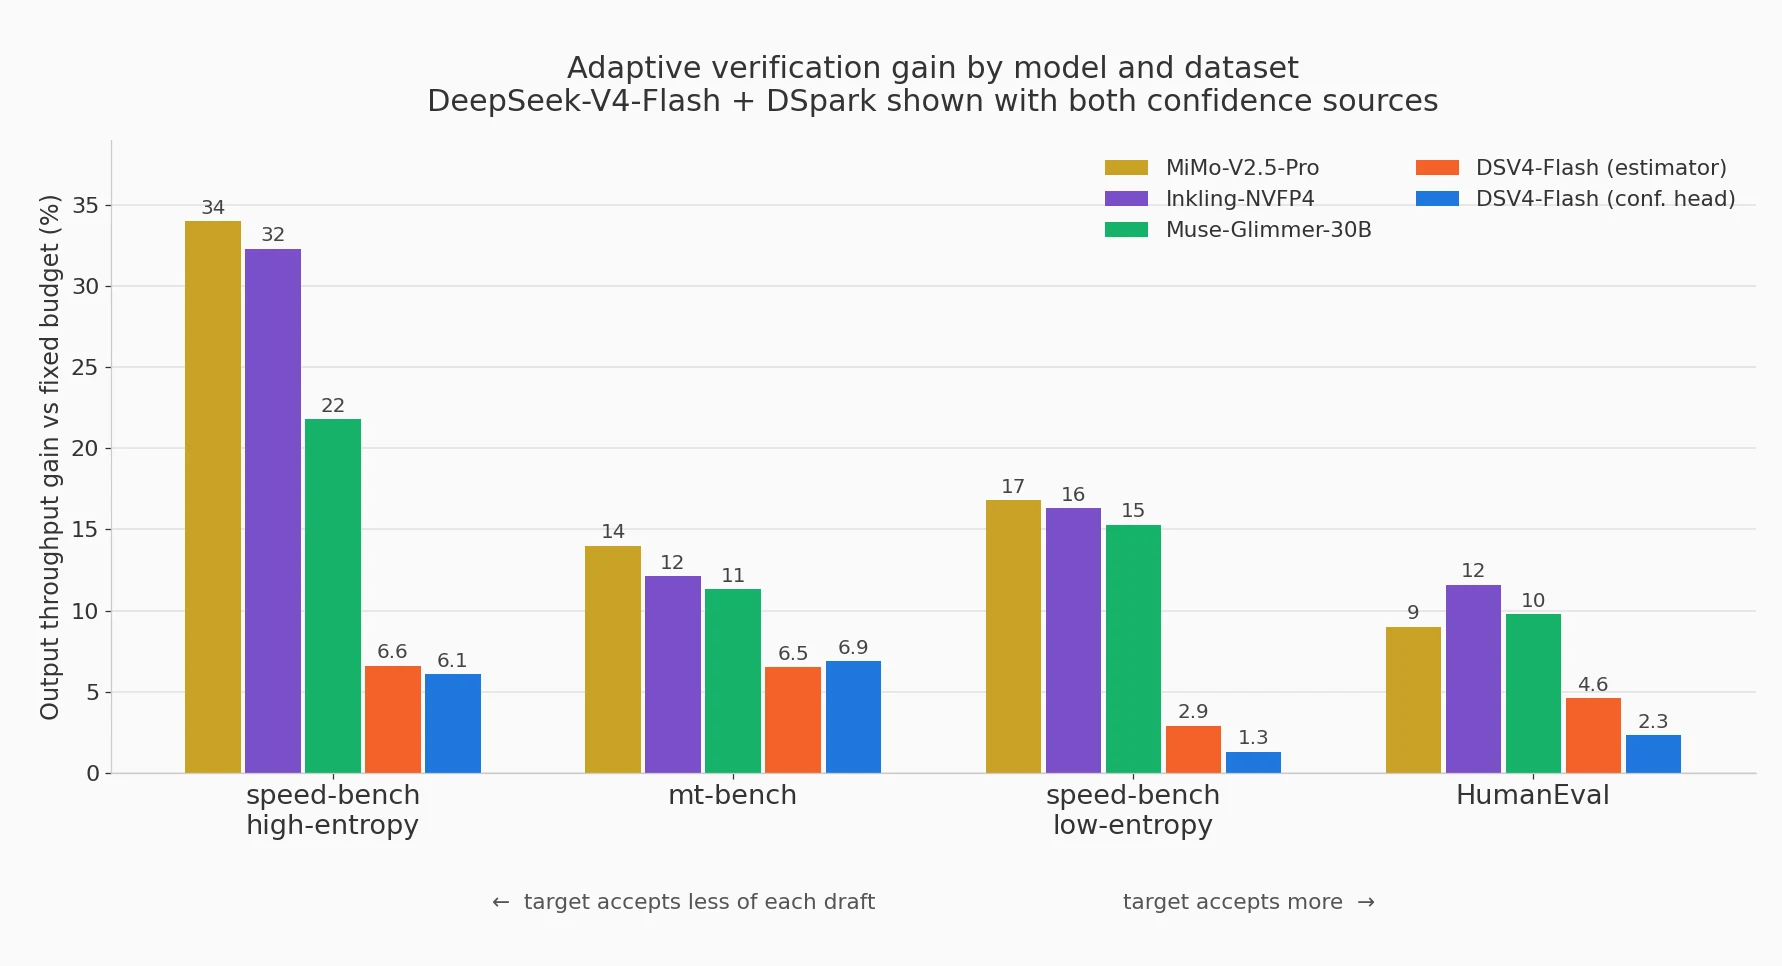
Comparée à la vérification fixe, l'estimation en ligne à la même longueur spéculative est gagnante sur tous les jeux de données évalués. Cependant, ce gain à lui seul ne raconte pas toute l'histoire. Il arrive souvent qu'une longueur fixe plus petite puisse surpasser AV à la longueur spéculative maximale à des concurrences spécifiques. La courbe de Pareto ci-dessous a été capturée avec DSV4 + DSpark sur un balayage de longueurs spéculatives fixes et AV à la longueur spéculative maximale :
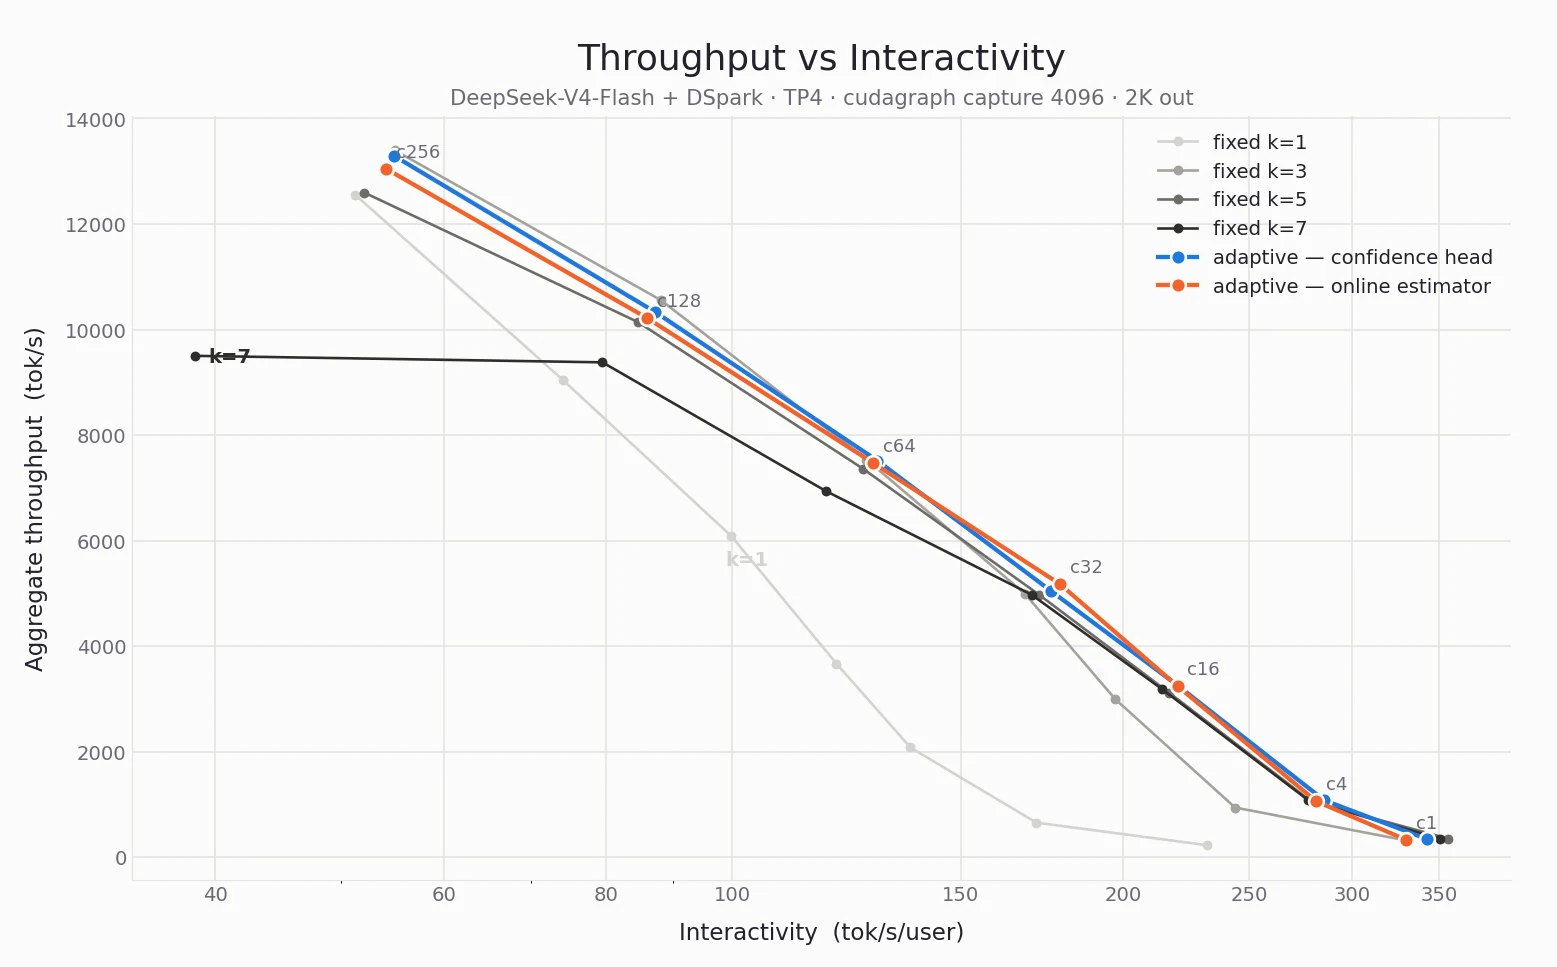
L'estimateur en ligne et la tête de confiance sont à peu près à égalité en termes de performances, sur toutes les concurrences mesurées. Cependant, l'estimateur en ligne n'est pas censé remplacer la tête de confiance, mais plutôt servir d'alternative prête à l'emploi en son absence. Voyons comment il se comporte sur une paire de modèles qui ne dispose actuellement pas de tête de confiance. Voici la courbe de Pareto pour MiMo-V2.5-Pro-FP4 + DFlash sur un balayage de longueurs spéculatives fixes et AV :
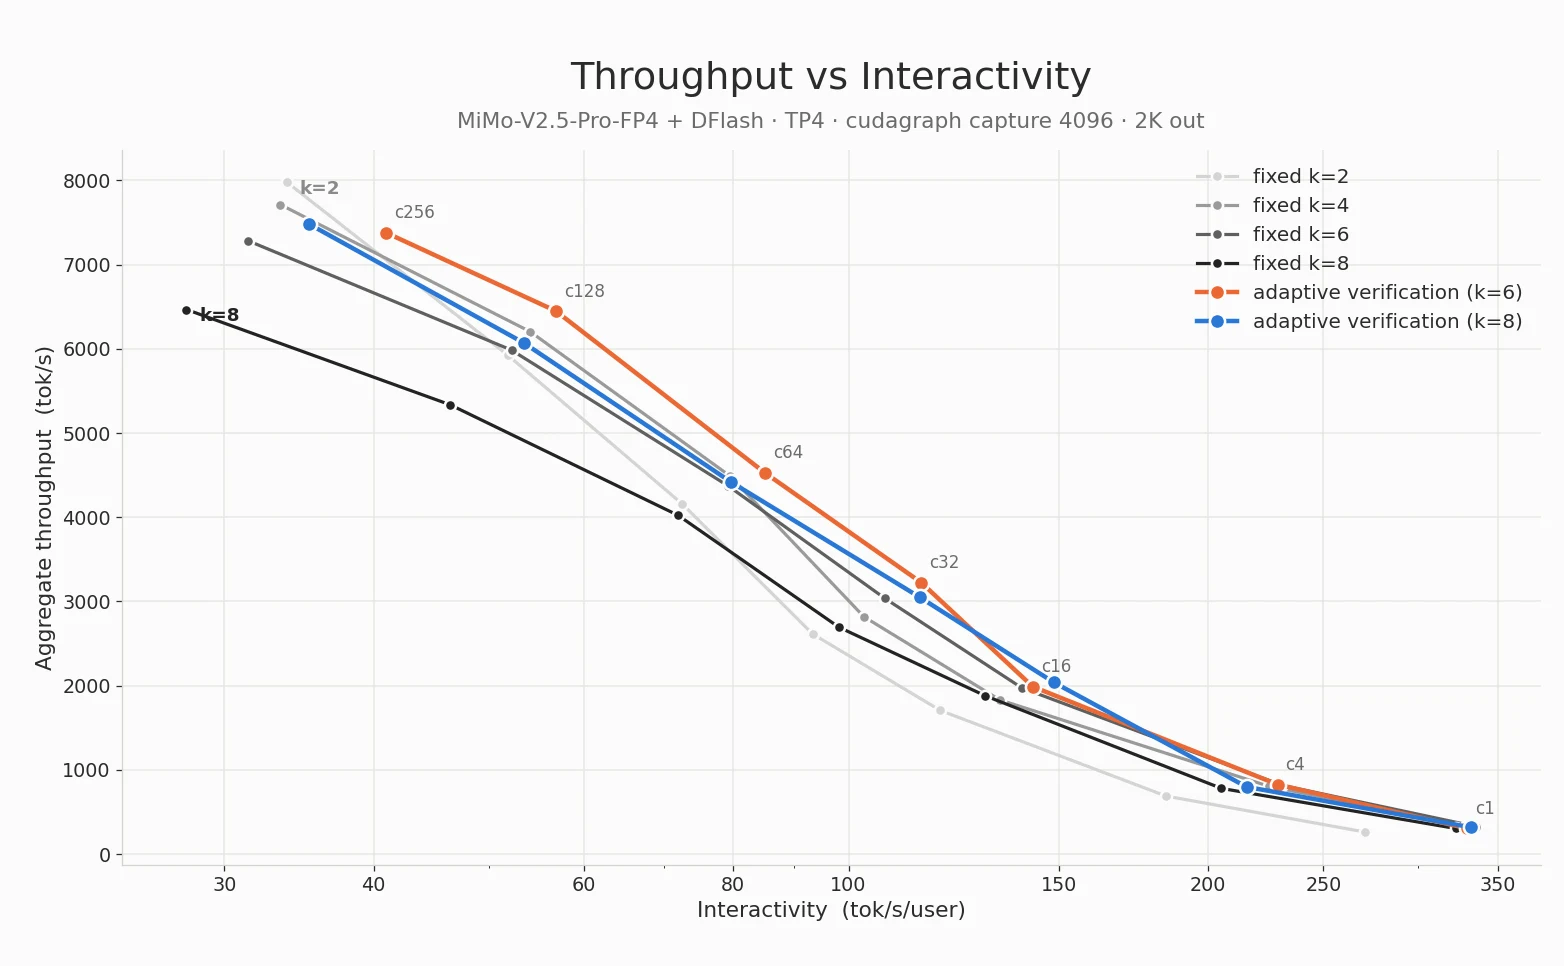
AV se situe sur la frontière débit-interactivité à 5 des 7 concurrences.
Limitations
- Le backend d'attention du modèle cible doit prendre en charge la vérification à longueur variable. C'est le même prérequis que DSpark AV possède déjà.
- MTP et EAGLE bénéficient moins d'AV que DFlash et DSpark. Cela s'explique par le fait que ces spéculateurs auto-régressifs paient un coût proportionnellement plus élevé pour la génération de tokens qui peuvent être supprimés avant la vérification.
Utilisation avec vLLM
AV est activé via la configuration spéculative. Sur un modèle de brouillon qui (1) n'a pas de tête de confiance et (2) prend en charge l'attention à longueur variable pour tous ses backends, l'estimateur en ligne est sélectionné automatiquement :
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
Remerciements
Ce travail a été réalisé par Giancarlo Delfin (Inferact) et s'appuie directement sur Adaptive Verification de Lucas Wilkinson (Red Hat) et Benjamin Chislett (NVIDIA).
Notes de bas de page
-
Un exemple avec un vocabulaire simple de deux jetons [a, b] peut servir à illustrer ce biais. Supposons p = [0.5, 0.5], q = [0.2, 0.8], et qu'un jeton draft est tronqué lors de la vérification si q(x) < 0.5. Tirer a entraîne une troncature, et la cible échantillonne un jeton selon sa propre distribution, p(x). Cependant, tirer b aboutit à une vérification : le jeton est accepté avec la probabilité min(1, p(b)/q(b)) = 0.625, et sinon rejeté et rééchantillonné à partir de la norme résiduelle max(0, p − q)) = [1, 0], ce qui donne a. Pendant l'échantillonnage par rejet, nous obtenons pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4 et pout(b) = q(a)·p(b) + q(b)·0.625 = 0.6. Ceci diffère de la distribution cible de [0.5, 0.5] et viole la garantie sans perte du décodage spéculatif. ↩