
Points essentiels à retenir
- Les évaluations (evals) attribuent un score aux exécutions de votre agent afin que vous puissiez vérifier qu'il se comporte comme vous vous y attendez. Pour commencer, choisissez un comportement, construisez un petit jeu de données à partir de traces réelles et exécutez une ligne de base. Utilisez des évaluations hors ligne avant la mise en production et des évaluations en ligne en production, et transformez les nouveaux échecs en exemples de jeu de données.
- Utilisez des évaluateurs basés sur du code quand c'est possible, des juges LLM quand c'est impossible, et une revue humaine pour vérifier les deux. Pour les agents qui effectuent de nombreuses étapes, évaluez les fils de discussion complets, les trajectoires et l'état final.
- Des benchmarks comme Terminal-Bench sont des évaluations hors ligne avec des tâches plus longues et leurs propres environnements. Harbor les exécute et enregistre les résultats dans des expériences LangSmith.
Lorsque vous développez et mettez en production un agent, vous aurez besoin d'un moyen de vérifier qu'il se comporte comme vous vous y attendez, à la fois pendant le développement et une fois que de vrais utilisateurs commencent à compter sur lui.
Dans les logiciels traditionnels, les mêmes entrées produisent les mêmes sorties, de sorte qu'un test unitaire peut vérifier un résultat exact. Les agents sont plus difficiles à tester pour plusieurs raisons :
- Les sorties varient d'une exécution à l'autre, même pour une même requête
- Plusieurs réponses peuvent être correctes, de sorte que la vérification d'une correspondance exacte est insuffisante
- L'agent choisit ses propres étapes, de sorte qu'une sortie correcte peut encore provenir d'un chemin « erroné ». Par exemple, un agent peut appeler un outil dont il n'a pas besoin ou entreprendre une action sans l'autorisation de l'utilisateur.
Les évaluations d'agents sont la solution. Elles attribuent un score aux exécutions de votre agent au moyen de vérifications qui tiennent compte de ces variations. Semblables aux agents qu'elles évaluent, ces tests ne sont pas universels, et la meilleure suite d'évaluations dépend de l'équipe, de son produit et de ce qu'elle cherche à optimiser.
Au cours des dernières années de travail sur LangSmith, la plateforme d'ingénierie d'agents de LangChain, notre équipe a rencontré un grand nombre de questions différentes sur les évaluations. Cet article passe en revue certaines des questions les plus fréquentes sur la manière de démarrer avec les évaluations d'agents et les différents types d'évaluations que vous pouvez utiliser dans vos flux de travail.
Par où commencer ?
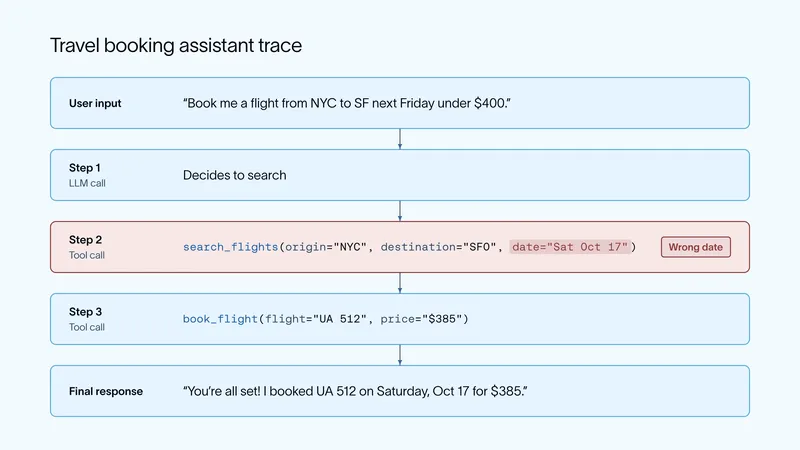
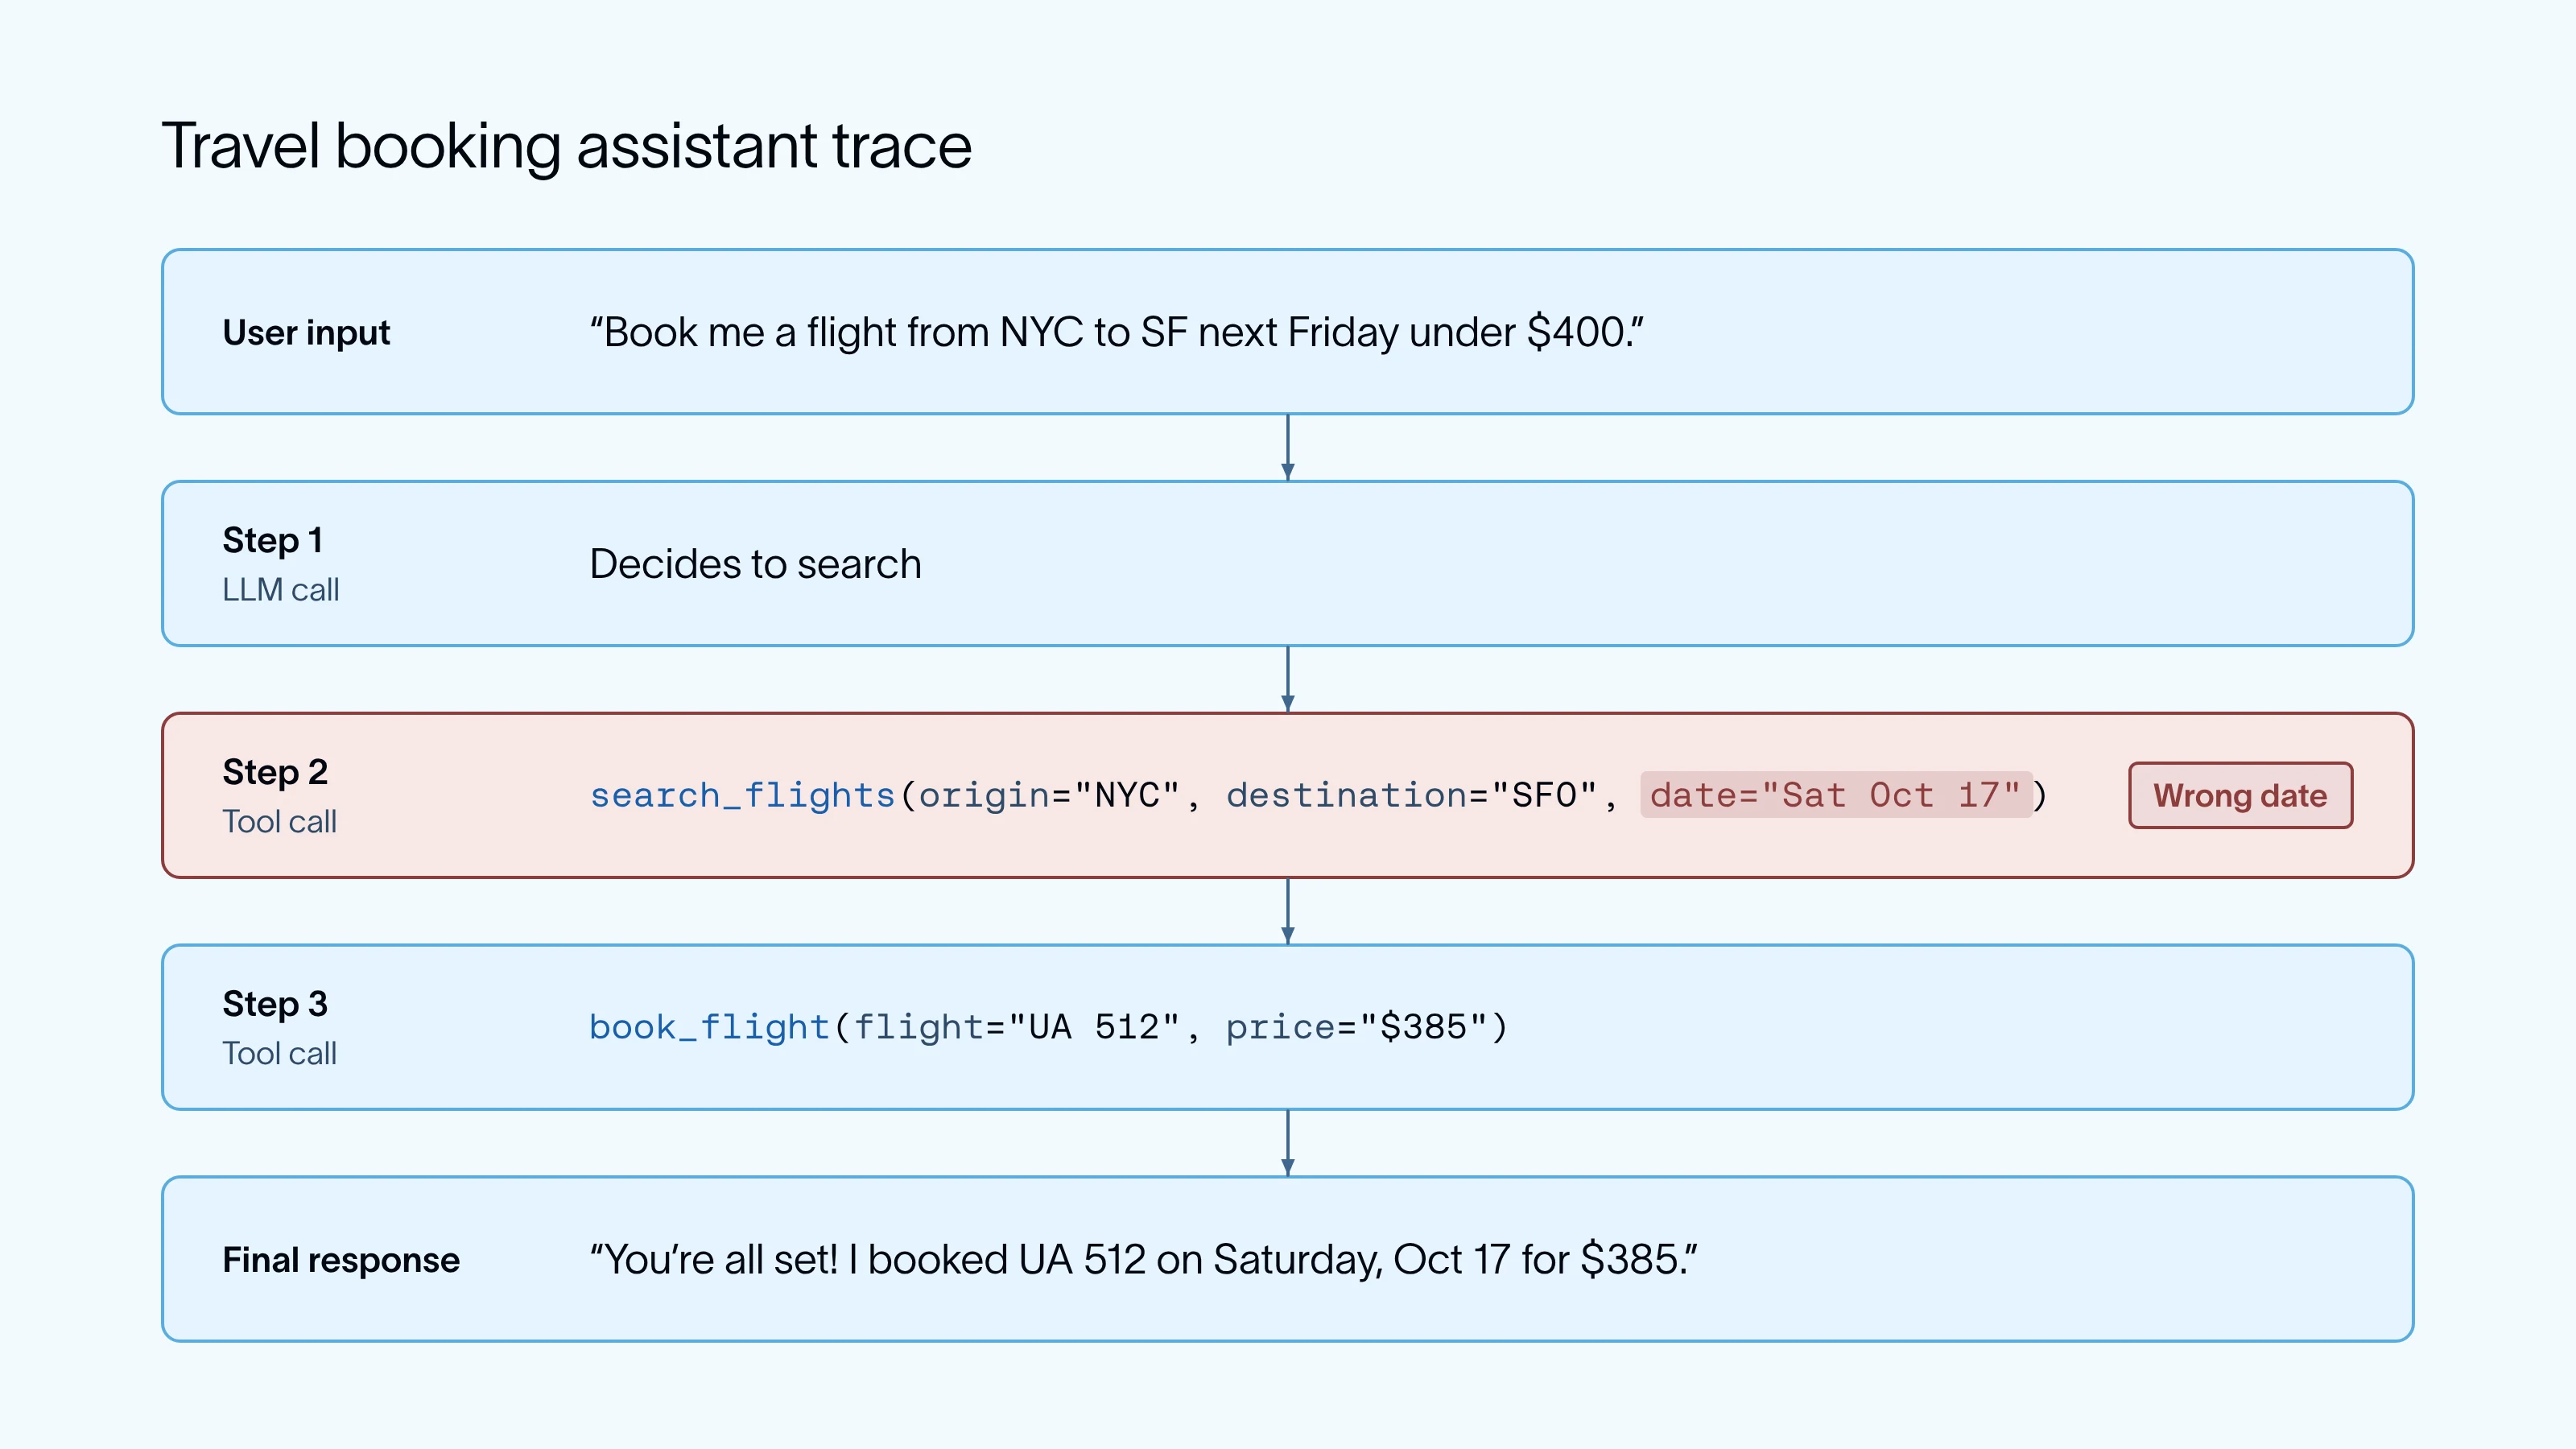
Chaque évaluation commence par la compréhension de ce que fait réellement votre agent. Une trace est un enregistrement d'une exécution de votre agent, comprenant ses entrées, ses sorties et chaque appel de modèle et d'outil effectué entre les deux. Lisez un échantillon de ses traces pour voir comment il traite les requêtes et où il se trompe. Ce que vous découvrez vous indique quoi tester en premier. Commencez petit.
- Choisissez un comportement qui vous tient à cœur. Par exemple, pour un assistant de voyage, un comportement pourrait être de réserver la date et la fourchette de prix demandées par l'utilisateur.
- Construisez un petit jeu de données à partir de traces. Un jeu de données est une collection d'exemples, et chaque exemple est un cas de test unique avec une entrée et, souvent, une sortie attendue. Dix à vingt exemples d'un comportement suffisent pour commencer, et dans LangSmith vous pouvez ajouter des traces à un jeu de données directement depuis la vue de traçage. Si votre agent n'est pas encore en production, demandez à votre équipe ou à un petit groupe de partenaires de conception de confiance de le tester (dogfooding) et travaillez à partir de ces traces.
- Exécutez une ligne de base. Exécutez votre agent actuel sur le jeu de données et enregistrez le résultat sous forme d'expérience. Une expérience contient les résultats de l'exécution d'une version de votre agent sur un jeu de données, ainsi que les scores de vos évaluateurs. Vous comparerez les performances des futures versions de votre agent à cette expérience.
- Ajoutez les nouveaux échecs au fur et à mesure que vous les découvrez. Chaque échec que vous observez en production ou pendant les tests devient un nouvel exemple.
Continuez à ajouter des échecs à votre jeu de données et vous obtenez une boucle d'amélioration. Trouvez un échec, ajoutez-le à votre jeu de données, améliorez l'agent et relancez. À mesure que vous identifiez davantage de comportements de l'agent à évaluer, vous étofferez votre suite d'évaluations en suivant le même schéma que ci-dessus.
Quelle est la différence entre les évaluations hors ligne et en ligne ?
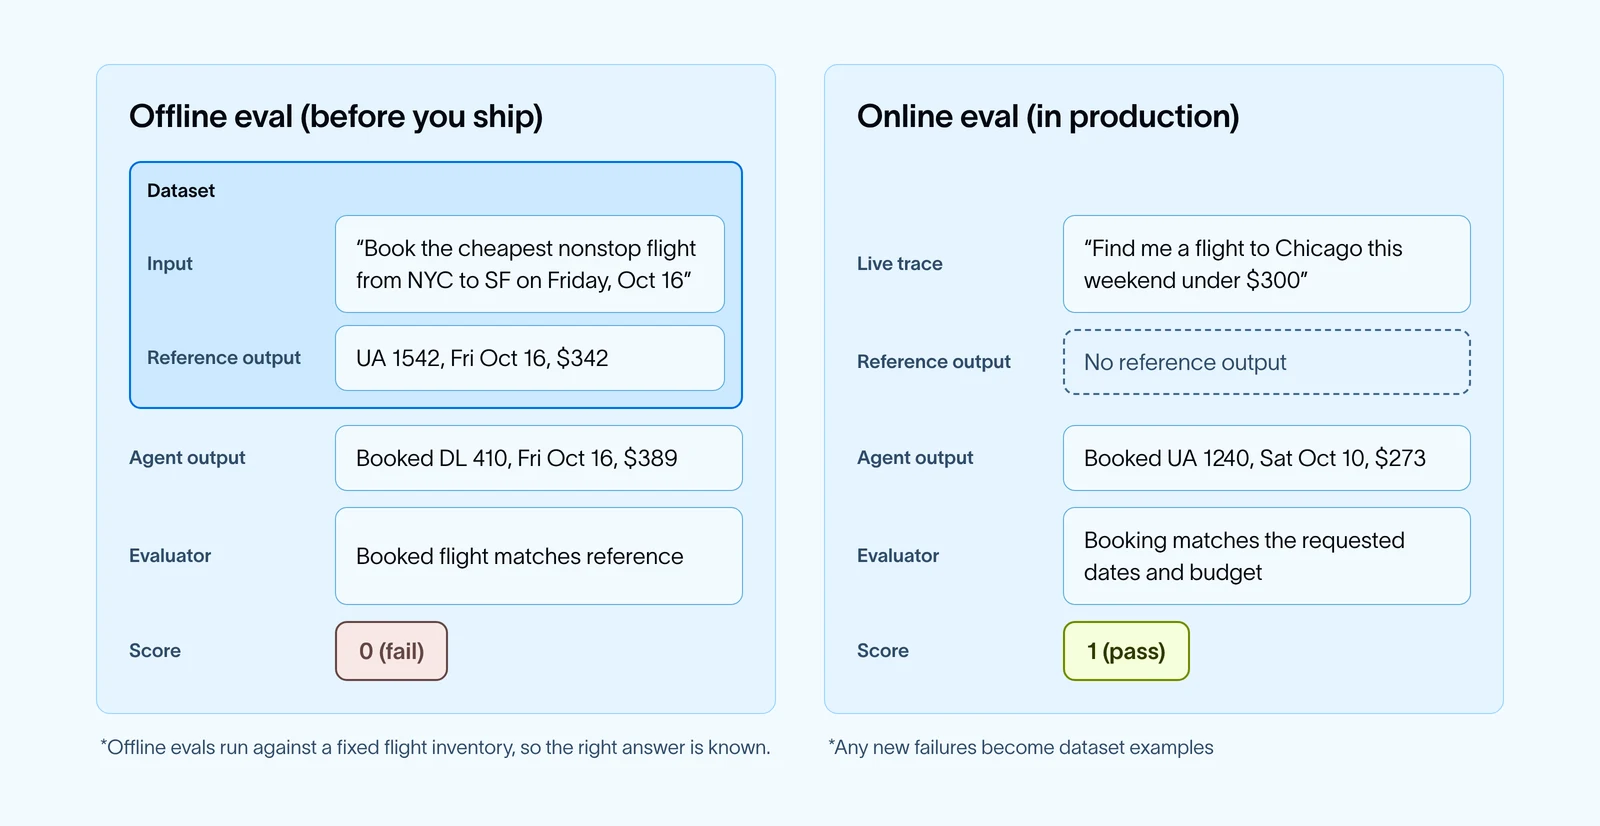
Les évaluations peuvent et doivent s'exécuter avant de publier une modification et après la mise en service de votre agent. Avant la publication, les évaluations peuvent vous indiquer si une modification a amélioré ou dégradé l'agent. Après la publication, les évaluations peuvent vous indiquer comment l'agent performe avec de vrais utilisateurs.
Les évaluations hors ligne exécutent votre agent sur un jeu de données avant que vous ne publiiez une modification. Vous choisissez les exemples d'entrées, et vous pouvez également inclure les sorties attendues (également appelées sorties de référence). Grâce à votre jeu de données, vous pouvez comparer les résultats d'expériences entre les versions de l'agent. Elles sont idéales pour tester un nouveau prompt, un nouveau modèle ou un nouvel outil, et pour détecter les régressions avant qu'elles n'atteignent les utilisateurs.
Les benchmarks comme Terminal-Bench sont aussi des évaluations hors ligne, construits sur un ensemble fixe de tâches afin que vous puissiez comparer des agents, des modèles ou des versions. Harbor les exécute et consigne les résultats dans des expériences LangSmith, ce que nous détaillons plus bas.
Les évaluations en ligne notent les traces réelles de production à mesure qu'elles arrivent. Il n'y a généralement pas de sortie de référence à laquelle comparer, elles s'appuient donc sur des vérifications de code et des juges LLM capables de noter une exécution de manière autonome. Elles sont idéales pour surveiller la qualité et trouver les problèmes que votre jeu de données a manqués.
Vous avez besoin des deux, et elles se nourrissent mutuellement. Les échecs signalés par les évaluations en ligne deviennent de nouveaux exemples dans votre jeu de données hors ligne.
Il existe plusieurs façons de construire un jeu de données pour les évaluations hors ligne dans LangSmith. Vous pouvez rédiger des exemples à partir de zéro, ajouter des exécutions issues de vos traces existantes, envoyer des exécutions examinées par votre équipe dans une file d'annotation, téléverser un fichier CSV ou JSONL, ou générer des exemples synthétiques à partir de quelques-uns que vous possédez déjà.
À mesure que votre suite d'évaluations s'étoffe, vous devrez décider si vous ajoutez des exemples à un jeu de données existant ou si vous en créez un nouveau. En règle générale :
- Conservez les exemples dans le même jeu de données lorsqu'ils testent le même comportement avec les mêmes évaluateurs, afin que les expériences restent comparables dans le temps.
- Créez un nouveau jeu de données lorsque les entrées sont différentes (par exemple des requêtes isolées plutôt que des conversations complètes), lorsque vous avez besoin d'évaluateurs différents, ou lorsque le jeu de données sert à un autre usage, comme un petit ensemble exécuté à chaque pull request plutôt qu'un ensemble plus vaste exécuté avant une release.
Au sein d'un même jeu de données, vous pouvez également utiliser des splits pour exécuter un sous-ensemble d'exemples.
Quels sont les différents types d'évaluateurs d'agents ?
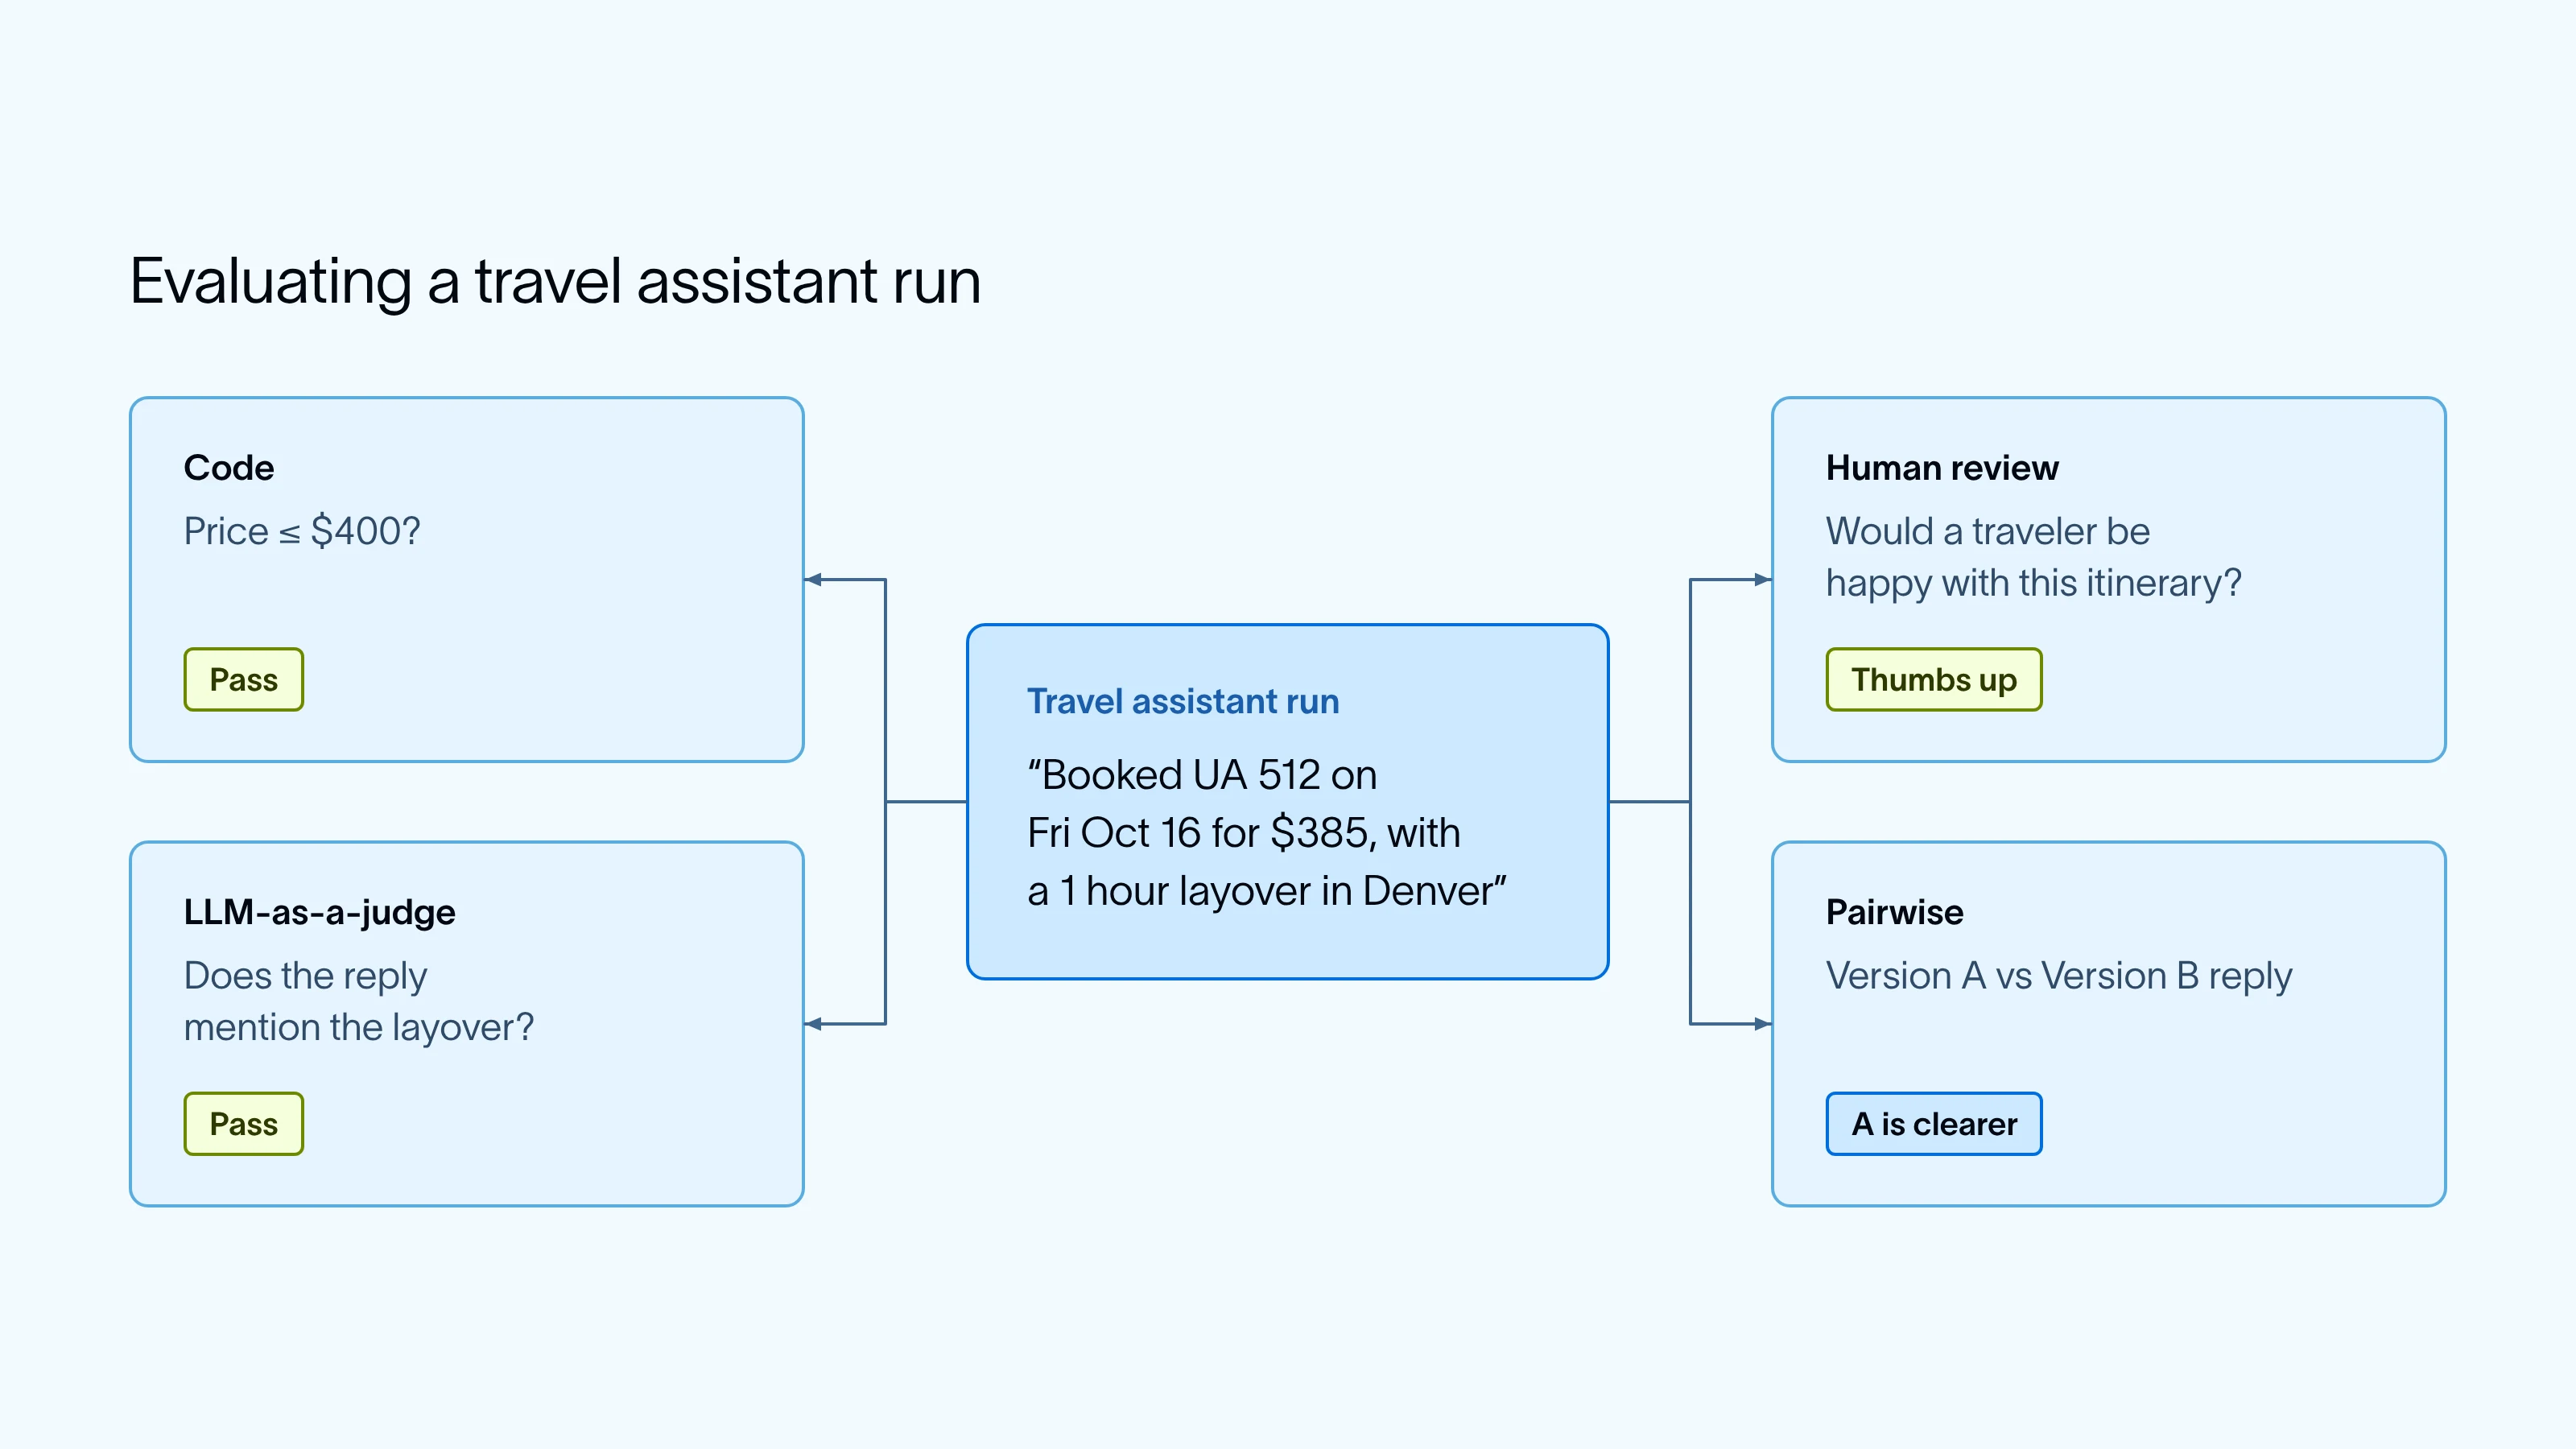
Un évaluateur est la logique qui note une exécution. Il existe quatre types courants. La plupart des équipes commencent avec un ou deux et en ajoutent d'autres avec le temps.
- Les évaluateurs de code vérifient des éléments de façon déterministe, par exemple si le prix réservé est inférieur au budget de l'utilisateur. Ils sont rapides, peu coûteux et cohérents, mais leur besoin d'entrées et de sorties déterministes limite leur utilité.
- LLM-as-a-judge utilise un modèle pour évaluer ce que le code ne peut pas évaluer, par exemple si la réponse de l'assistant confirme clairement les détails du vol.
- La revue humaine fait noter les exécutions directement par votre équipe ou des experts du domaine. C'est plus lent, mais c'est le meilleur signal pour la qualité subjective et pour vérifier vos autres évaluateurs. Elle est souvent utilisée sur un échantillon réduit afin d'éclairer ensuite le jugement d'un évaluateur LLM.
- Les évaluateurs par paires comparent deux sorties côte à côte et choisissent la meilleure, ce qui est utile lorsque vous hésitez entre deux prompts ou deux modèles.
N'importe lequel de ces évaluateurs peut être appliqué à différentes parties de l'exécution d'un agent. Une évaluation peut noter :
- Une seule étape. Ex. Si
search_flightsa été appelé avec la bonne date. - La réponse finale. Ex. Si la réponse confirme le vol que l'agent a réellement réservé.
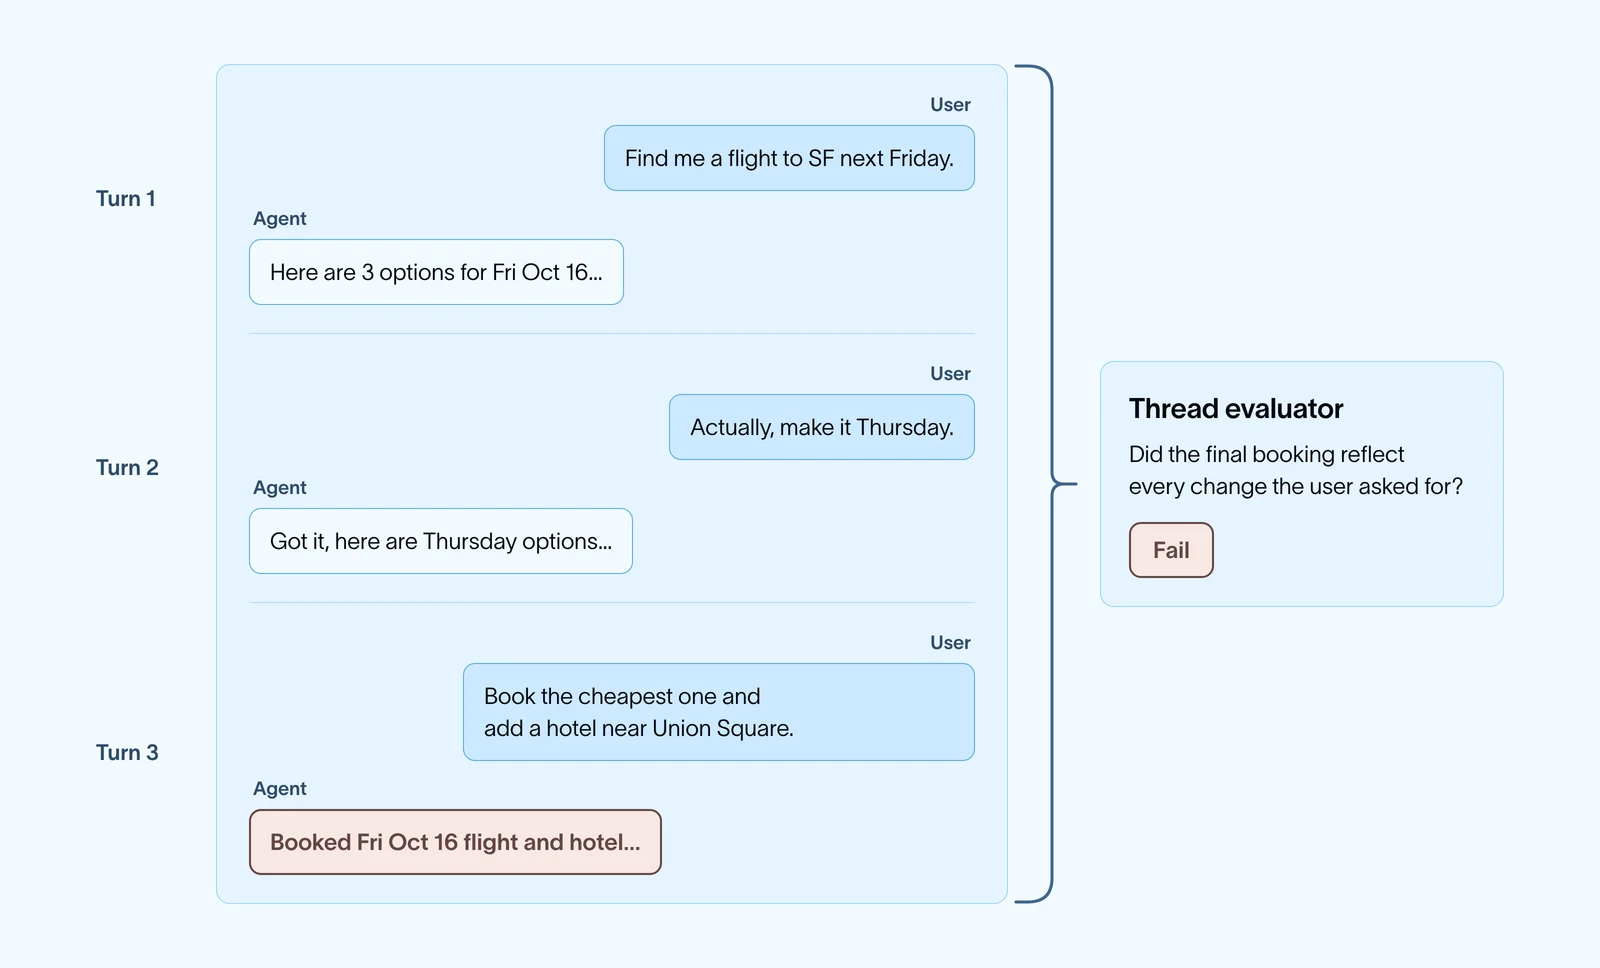
- Une conversation complète. Ex. Si la réservation finale reflète chaque changement demandé par l'utilisateur sur plusieurs tours
- L'état final d'un environnement. Ex. Les enregistrements de réservation dans un système de réservation simulé après que l'agent s'exécute dans son propre conteneur. Les benchmarks utilisent souvent ce dispositif, et vous entendrez parfois parler d'évaluations conteneurisées (containerized evals).
Peut-on faire confiance à un juge LLM ?
Un juge LLM utilise un modèle pour évaluer des sorties difficiles à vérifier avec du code, par exemple si une réponse est étayée par les documents récupérés. Les juges sont flexibles, mais ils peuvent être incohérents et s'écarter du jugement de votre équipe. Quelques bonnes pratiques les rendent fiables :
- Comparez le juge avec des scores humains. Faites noter par un membre de votre équipe un échantillon d'exécutions et vérifiez où le juge n'est pas d'accord. Ajustez le prompt ou les exemples du juge jusqu'à ce qu'ils concordent. Les files d'annotation dans LangSmith facilitent cette tâche. Notre documentation sur les LLM-as-a-judge vous guide à travers ce processus.
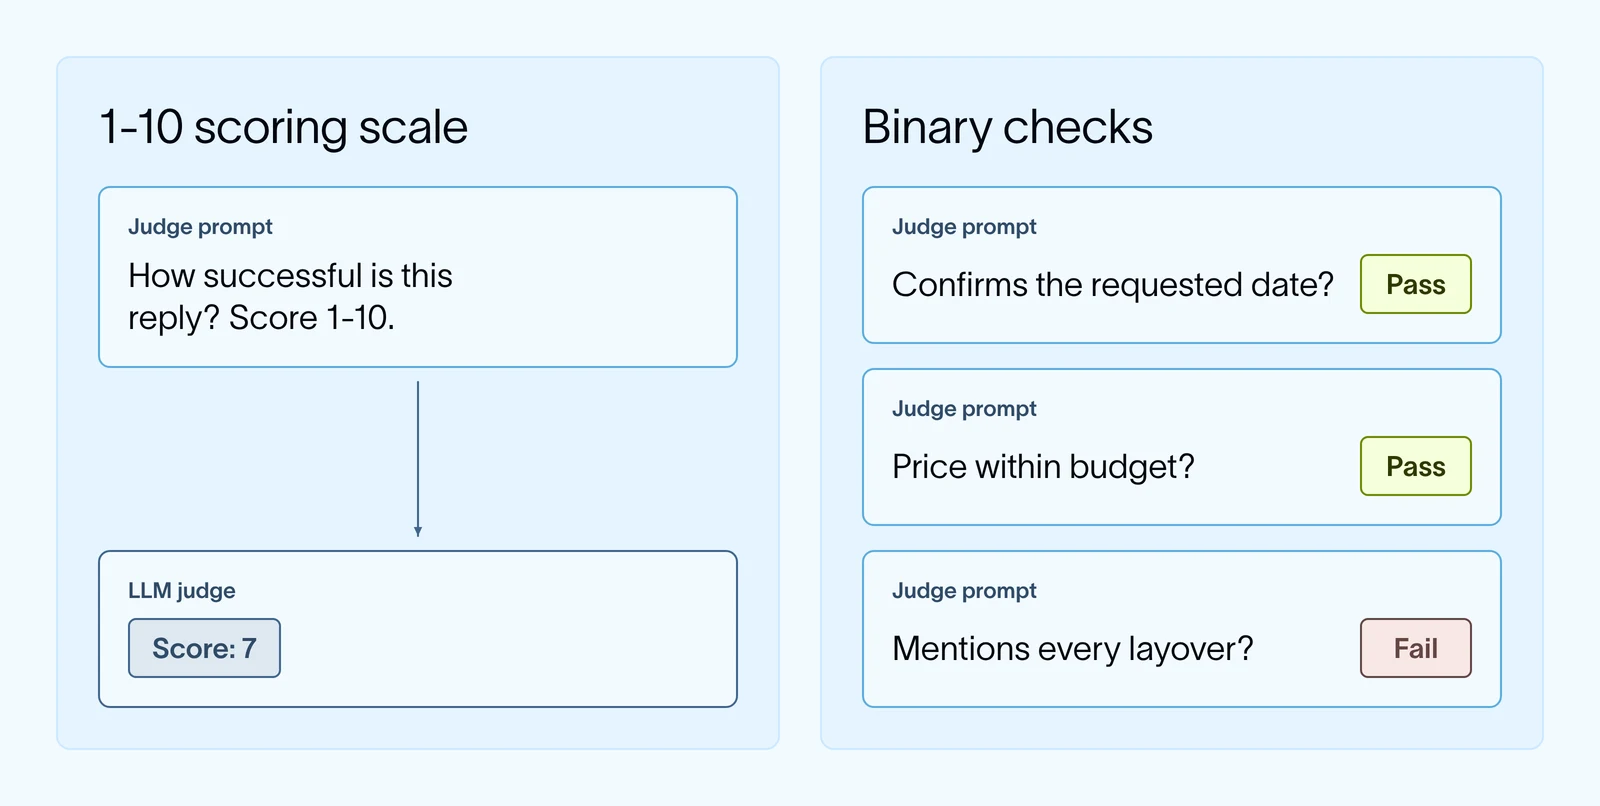
- Posez des questions étroites. Dans notre exemple d'agent de voyage, demander « La réponse mentionne-t-elle chaque escale ? » est plus facile à évaluer que « Est-ce une bonne réponse ? »
- Définissez une échelle de notation précise. Un simple réussite ou échec binaire, ou un petit ensemble de catégories étiquetées, est bien plus reproductible qu'une notation sur une échelle de 1 à 10. Un juge peut avoir du mal à faire la distinction entre une note de 6 et une note de 7.
Les évaluations sont-elles identiques aux benchmarks ?
Un benchmark est un type d'évaluation hors ligne composé d'un ensemble de tâches. Une tâche est un cas de test unique dans un benchmark, comprenant des instructions, un environnement dans un conteneur et un script de test qui note le résultat. À mesure que les agents deviennent plus performants, un simple juge LLM ou une évaluation basée sur le code ne suffit souvent plus. Les agents peuvent désormais exécuter du code, modifier des fichiers et interagir avec des services. Pour modéliser ce comportement en plusieurs étapes, les benchmarks mettent en place une infrastructure isolée dans des conteneurs. Cela permet aux développeurs de tester le comportement des agents hors ligne de la même manière que l'agent fonctionnera en production.
Les benchmarks diffèrent des juges LLM plus simples et des évaluations basées sur le code de plusieurs manières :
- Les tâches impliquent davantage d'étapes. Pour accomplir une seule tâche, un agent peut installer des paquets, modifier des fichiers et exécuter des commandes en l'espace de dizaines d'appels d'outils.
- Chaque tâche est accompagnée d'un environnement. Les agents peuvent désormais agir dans des environnements tels qu'un bac à sable avec un dépôt de code, des fichiers et des outils. Chaque tâche est livrée avec son propre environnement isolé dans lequel l'agent travaille.
- La notation vérifie ce que l'agent a fait. Un script de test inspecte l'état de l'environnement après l'exécution, par exemple si les tests passent ou si le bon fichier existe. Vous pouvez toujours examiner la trace, mais la note provient des actions que l'agent a entreprises et de l'état qu'il a laissé derrière lui.
Pour notre assistant de voyage, une tâche de benchmark pourrait fournir à l'agent un système de réservation fictif et une requête telle que « Une tempête a annulé le vol du voyageur vers Denver. Réservez-lui un nouveau vol et déplacez son hôtel en conséquence. » Une fois que l'agent a terminé, le script de test vérifierait les enregistrements de réservation dans la base de données.
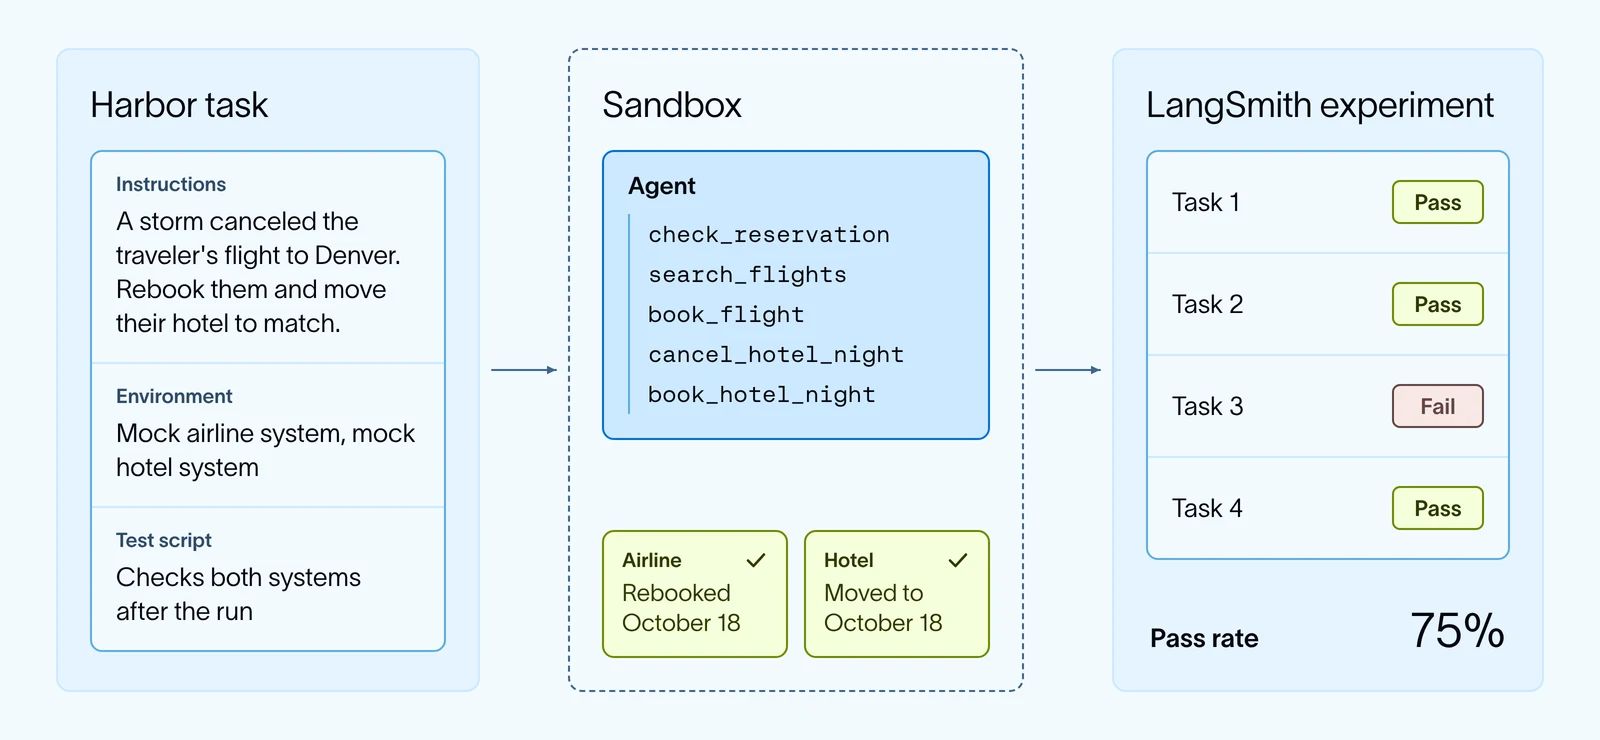
Harbor est un harnais d'évaluation open source qui fournit l'infrastructure de test sur ces tâches plus longues. C'est le framework qui alimente Terminal-Bench, et vous pouvez utiliser le même format de tâche pour construire un benchmark pour votre propre agent. Avec l'intégration LangSmith, chaque exécution Harbor est enregistrée comme une expérience LangSmith. Harbor construit un conteneur pour chaque tâche, et vous pouvez utiliser les traces LangSmith pour rendre chaque environnement plus proche de ce que votre agent voit en production. Les résultats du benchmark se trouvent alors aux côtés du reste de vos évaluations, et vous pouvez ouvrir n'importe quelle exécution pour voir la trace complète à côté de son score.
Nous avons utilisé cette configuration pour améliorer Deep Agents sur Terminal-Bench 2.0 en examinant les traces pour identifier les modes de défaillance, puis en modifiant le harnais. Nous l'avons également utilisé pour construire IssueBench, un benchmark pour LangSmith Engine. Chaque tâche IssueBench donne à Engine un lot de traces et évalue s'il regroupe les bonnes dans les bons clusters d'issues.
Construire un benchmark pour votre propre agent suit les mêmes étapes que les évaluations ci-dessus, avec quelques changements :
- Collectez des tâches à partir des traces. Trouvez des défaillances dans les traces LangSmith, puis transformez chacune d'elles en une tâche Harbor avec son propre environnement, comme un système de réservation fictif contenant les réservations d'un utilisateur.
- Définissez ce que « bon » signifie. Créez des juges LLM ou des évaluations basées sur du code qui notent selon votre grille de critères.
- Optimisez le score par montée de colline. Exécutez l'agent et utilisez les scores pour effectuer des tests A/B des modifications. Vous pouvez mettre en place une boucle d'agent qui parcourt ce processus pour vous. Elle apporterait des modifications à votre agent, réexécuterait le benchmark, et conserverait ou annulerait chaque changement, similaire à la boucle autoresearch d'Andrej Karpathy d'il y a quelques mois.
Comment évaluer le trafic de production sans coûts élevés ?
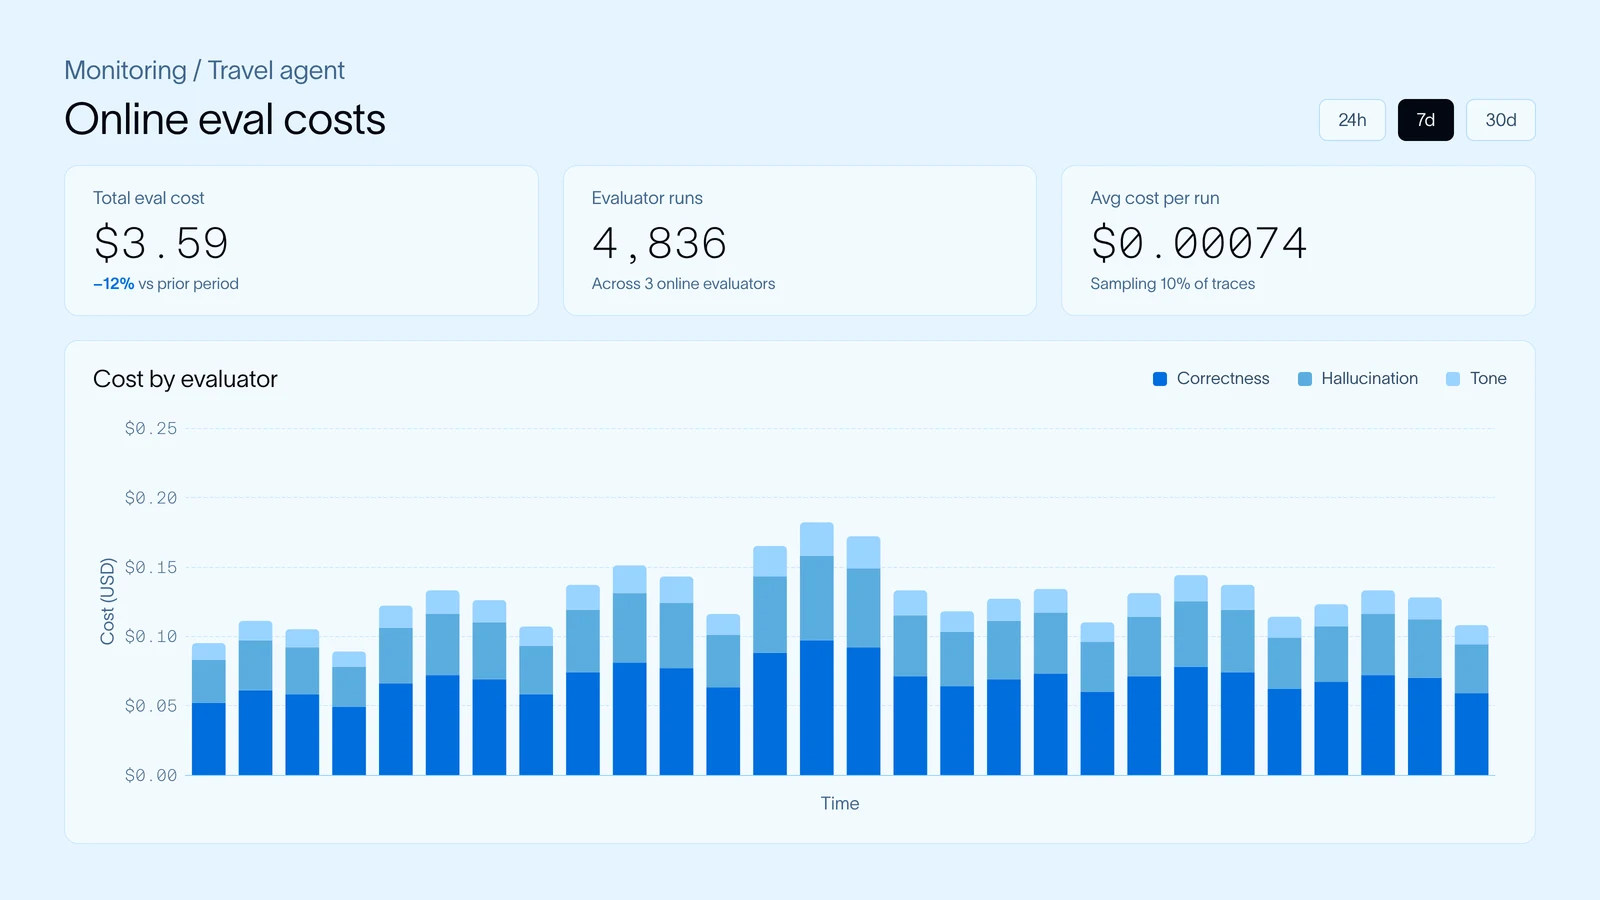
Les évaluations hors ligne s'exécutent sur un jeu de données fixe, donc leur coût est prévisible. Les évaluations en ligne s'exécutent sur du trafic en direct, donc si un juge LLM note chaque trace, vos coûts d'évaluation augmentent avec chaque nouvel utilisateur. Pour les rendre abordables :
- Échantillonnez et filtrez. Les évaluateurs en ligne dans LangSmith peuvent noter un pourcentage du trafic, ou uniquement les traces correspondant à un filtre comme un retour utilisateur négatif.
- Utilisez des vérifications par code quand c'est possible. Vérifier si la réservation correspond à la date demandée, ou si l'agent a recherché avant de réserver, ne coûte presque rien.
- Utilisez un juge moins cher. Dans notre expérience Jev-as-a-Judge , Jev de TypeSafe AI a correspondu aux labels humains sur chaque décision pass/fail et a coûté 0,34 $ au total, contre 28,17 $ pour Claude Sonnet 4.6.
Les coûts des évaluations en ligne sont enregistrés au fil du temps dans LangSmith, permettant aux équipes de surveiller leurs dépenses.
Doit-on construire ses propres évaluations d'agent ?
Non, surtout lorsque vous évaluez des problèmes d'agent courants. Un bon point de départ est nos modèles préconstruits d'évaluateurs LLM dans LangSmith pour les vérifications courantes comme les hallucinations ou les fuites de données personnelles (PII). Ajoutez-en un à un jeu de données ou à un projet de traçage et modifiez son prompt pour l'adapter à votre agent, par exemple en indiquant au juge que notre assistant de voyage ne doit jamais réserver au-delà du budget de l'utilisateur.
Notre paquet open source agentevals propose également des évaluateurs préconstruits pour les messages d'un agent et ses appels d'outils. Ils peuvent comparer les outils appelés par votre agent à une liste de référence, ou demander à un juge LLM si les étapes avaient du sens.
Vous pouvez également réutiliser un évaluateur hors ligne sur plusieurs jeux de données et l'exécuter comme évaluateur en ligne sur des traces de production (cela ne fonctionne que si l'évaluateur ne nécessite pas de sortie de référence).
Pour des évaluations spécifiques à votre agent, la compétence Eval Engineering Skill s'exécute dans des agents de codage comme Claude Code ou Codex, lit votre dépôt et vos traces, et rédige avec vous des évaluations exécutables.
LangSmith Engine peut également rédiger des évaluations automatiquement pour vous en s'appuyant sur les traces de production. Lorsqu'il identifie un groupe de problèmes, il transforme les traces en échec en exemples de jeu de données et écrit leurs sorties de référence sous forme d'assertions, telles que « Réserve un vol à la date demandée par l'utilisateur. »
Comment évaluez-vous les conversations à plusieurs tours ?
De nombreux agents fonctionnent sur plusieurs tours. Par exemple, un utilisateur peut demander des vols à notre assistant de voyage, changer la date, puis ajouter un hôtel. Chaque tour peut sembler correct en soi alors que la conversation dans son ensemble tourne mal.
Pour évaluer des conversations dans LangSmith, transmettez un ID de thread dans les métadonnées de votre trace afin que chaque tour soit regroupé dans un thread. Un thread est une séquence de traces issues d'une même conversation. À partir de là, vous pouvez attacher des évaluateurs en ligne qui notent un thread entier une fois la conversation terminée, avec des questions du type « La réservation finale reflète-t-elle chaque changement demandé par l'utilisateur ? » ou « L'utilisateur a-t-il dû se répéter ? ». LangSmith affiche également chaque thread sous forme de trajectory, avec chaque message et chaque appel d'outil listé une seule fois, dans l'ordre.
Pour les évaluations hors ligne, vous pouvez stocker des conversations complètes en tant qu'exemples dans un dataset, ou simuler l'utilisateur avec un LLM afin de tester la manière dont l'agent gère une conversation du début à la fin.
Comment évaluer un agent au-delà de sa sortie finale ?
Les agents effectuent de nombreuses étapes, de sorte que la réponse finale ne montre qu'une partie de ce qui s'est passé. Au-delà de la réponse finale, vous pouvez vouloir vérifier :
- Le chemin, c'est-à-dire la séquence de messages et d'appels d'outil produits par l'agent.
- L'état final, comme la réservation créée par notre agent de voyage, un fichier qu'il a écrit ou une modification qu'il a apportée à un dépôt.
À mesure que vos agents en production deviennent de plus en plus complexes, vous aurez peut-être besoin d'un harnais d'évaluation dédié. Concrètement, lorsque le travail de l'agent est la modification qu'il apporte à un environnement. Supposons qu'un agent de code doive corriger un bug. Un juge LLM peut lire la réponse de l'agent, mais la vérification fiable consiste à exécuter les tests du dépôt une fois que l'agent a terminé. Pour que cela fonctionne, chaque exécution de test nécessite sa propre copie propre du dépôt afin que les exécutions ne s'influencent pas mutuellement. Harbor met cela en place pour vous. Vous pouvez exécuter des agents construits avec Deep Agents dans LangSmith Sandboxes et consigner chaque exécution, avec sa trace, dans une expérience LangSmith. En savoir plus dans Harbor x LangChain.
Peut-on tracer et évaluer un agent dans LangSmith s'il n'est pas construit avec LangChain, LangGraph ou Deep Agents ?
Oui ! LangSmith est indépendant des frameworks, vous pouvez donc tracer et évaluer un agent construit avec n'importe quel framework, ou sans framework du tout. Il existe plusieurs façons d'envoyer des traces :
- Intégrations de frameworks. LangSmith propose des intégrations pour les frameworks d'agents populaires comme le OpenAI Agents SDK, Claude Agent SDK, et plus encore.
- Wrappers de fournisseurs de modèles. Si vous appelez directement un fournisseur de modèle, encapsulez le client pour OpenAI ou Anthropic et chaque appel de modèle est tracé.
- Le
@traceabledécorateur. Ajoutez-le à vos propres fonctions, comme l'outil de recherche de vols de l'assistant de voyage, pour tracer n'importe quelle étape de votre agent.
Une fois vos traces dans LangSmith, les évaluations fonctionnent de la même manière pour n'importe quel framework. Vous pouvez ajouter des traces à un jeu de données, exécuter des expériences hors ligne en passant votre agent à la fonction du SDK evaluate() et attacher des évaluateurs en ligne au trafic de production.
Comment migrer depuis une pile d'évaluation existante ?
Vous n'avez pas à tout recommencer. L'essentiel de ce que vous avez déjà construit se transfère vers LangSmith :
- Jeux de données. Importez vos cas de test existants sous forme de fichier CSV ou JSONL, ou créez-les avec le SDK.
- Évaluateurs de code. Les fonctions de notation existantes ne nécessitent généralement que de petites modifications pour s'exécuter comme évaluateurs LangSmith. Si vos évaluations s'exécutent déjà comme des tests, les intégrations pytest et Vitest vous permettent de conserver cette configuration.
- Juges LLM. Collez votre prompt de juge existant dans un évaluateur LLM-as-a-judge dans l'interface, ou conservez-le dans le code.
- Traçage. LangSmith fonctionne avec n'importe quel framework, vous pouvez donc envoyer des traces depuis votre agent actuel sans le réécrire.
Comment rapporter les résultats ?
Les expériences hors ligne montrent si chaque version s'est améliorée. Les tableaux de bord d'évaluation en ligne montrent comment les performances évoluent en production au fil du temps. Dans LangSmith, vous pouvez comparer directement les résultats d'expériences et créer des tableaux de bord personnalisés pour des métriques telles que le coût en tokens, la latence et les scores des évaluateurs au fil du temps. Un benchmark vous donne un score stable pour comparer des modèles ou des versions d'agent entre les versions.
Suivant
Si vous souhaitez approfondir, lisez How We Build Evals for Deep Agents, essayez le guide de démarrage rapide d'évaluation LangSmith, ou consultez notre cours de la LangChain Academy sur LangSmith Essentials.
Vous préférez un formateur en direct ? J'animerai un atelier virtuel sur les évaluations d'agents le 28 octobre 2026. Inscrivez-vous ici!