
Par Jay, depuis QbitAI | Compte public QbitAI
Attends, tu es revenu du futur ?
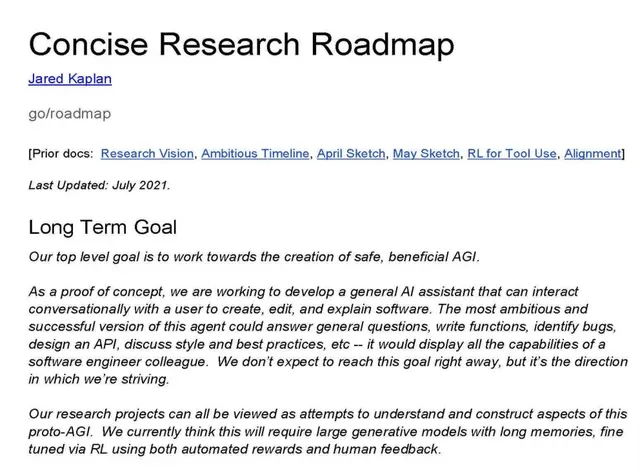
Récemment, à cause d'un procès en matière de droits d'auteur, un document interne d'Anthropic, unefeuille de route de recherche interne du mois 7 de 2021, a été accidentellement dévoilé.
Très court : le corps du PDF ne fait que deux ou trois pages.
Mais après avoir lu ce document, alors classé « Top Secret », du début à la fin, je suis resté effondré.
Le Claude Code d'aujourd'hui, le Tool Use, l'auto-évaluation par l'IA (Self-Judging), le calcul au moment du test (Test-time compute), et même les milliers de milliards de paramètres et les contextes ultra-longs…
Il y a cinq ans, alors que l'entreprise n'était sortie d'OpenAI que depuis quelques mois et ne comptait qu'une douzaine de personnes, tout cela était déjà noir sur blanc, écrit noir sur blanc.
La feuille de route d'il y a 5 ans
Beaucoup pensent que le passage des grands modèles, du chatbot à l'agent capable d'écrire du code et d'opérer des systèmes, s'est fait ces deux dernières années, une fois la technologie arrivée à maturité, chacun profitant du courant.
Erreur.
Au tout début de cette feuille de route de 2021, Anthropic s'était fixé une définition de prototype très claire pour son objectif ultime (Safe, beneficial AGI) :
Créer un assistant IA généraliste capable d'interagir avec les humains en langage naturel pour créer, éditer et expliquer des logiciels.
Qu'est-ce qu'un assistant IA généraliste ?
Un système capable de répondre à des questions générales, d'écrire des fonctions, de trouver des bugs, de concevoir des API, de discuter du style de code et des meilleures pratiques.
Le plus terrifiant, c'est la phrase qui suit :
Il devait démontrer l'intégralité des capacités d'uncollègue ingénieur logiciel.
Non, je me dis que ce n'est pas exactement Claude Code, ça ??
À une époque où GPT-3 venait tout juste de faire sensation et où tout le monde s'émerveillait encore que l'IA puisse écrire des acrostiches, Anthropic a directement ignoré la simple logique d'autocomplétion de code et visé un agent complet d'ingénierie logicielle.
Et ce n'est pas tout : sur le chemin concret de la mise en œuvre, une débat interne extrêmement passionnant a eu lieu.
Le chercheur Andy Jones a soulevé, dans une annotation, une divergence fondamentale : fallait-il d'abord créer un véritable assistant de programmation vraiment utile, ou d'abord prouver la faisabilité du tool use ?
À l'époque, l'équipe était confrontée à deux voies :
La voie pratique : développer la recherche dans les dépôts de code (Repo Search), permettant à l'IA de fouiller les définitions de types des projets.
Tom Brown, premier auteur de l'article sur GPT-3, a également participé à cette discussion, suggérant de commencer par l'exploration de dépôts de code (Repo Browsing).
La voie de la recherche : développer le débogage printf et les opérations sur les éditeurs, prouver d'abord que le modèle pouvait appeler des outils.
Finalement, c'est le PDG Dario qui a tranché :
À court terme, il s'agit d'abord de valider la faisabilité de l'appel d'outils, puis à long terme d'évoluer vers un assistant de programmation ultra pratique.
En y regardant aujourd'hui, le processus d'évolution de Claude Code suit exactement, pas à pas, cette phrase de Dario de l'époque.
Self-judging, milliards de paramètres et mémoire ultra longue
Outre les Coding Agents, cette feuille de route contient aussi des anticipations sur les technologies sous-jacentes.
Par exemple, dans la partie pré-entraînement, dès 2021, ils avaient écrit noir sur blanc qu'ils voulaient entraîner1T (1 billion de paramètres) et plus, des modèles ultra-larges, et explorer les contextes ultra-longs (Very large contexts), ou d'autres mécanismes capables d'accueillir des masses énormes de mémoire et d'expérience.
À une époque où 175B était encore un monstre, ils considéraient déjà les paramètres à l'échelle du billion et la mémoire ultra-longue comme des infrastructures standard.
Encore plus remarquable : la partie sur le retour humain et l'alignement (Alignment).
Le document indique noir sur blanc :
le modèle s'auto-évalue.
Dès 2021, ils étudiaient déjà comment faire en sorte que le modèle évalue son propre comportement et la qualité de ses sorties, et comment utiliser le jugement du modèle lui-même comme signal de retour. C'est exactement l'idée centrale de l'AI Feedback d'aujourd'hui ainsi que de l'auto-correction des modèles de raisonnement.
Plus intéressant encore, le document fait même apparaître un concept devenu par la suite extrêmement important dans la recherche sur les grands modèles :
Test-time compute (calcul au moment du test).
Bien sûr, à l'époque, cette recherche était située dans le contexte de l'alignement et des études sur les discriminateurs, encore loin de l'expansion du calcul de raisonnement à la o1.
Mais cela montre au moins que dès 2021, l'horizon de recherche d'Anthropic couvrait déjà l'investissement en calcul au-delà de l'entraînement des modèles.
Il faut bien dire que le Neo Lab a vraiment des choses, pas étonnant qu'Ilya se soit effondré.
On ne sait pas ce que vivent aujourd'hui, chaque jour, les laboratoires de pointe.
Moments de sueur froide en interne
Bien entendu, puisqu'il s'agit d'Anthropic, impossible d'éviter de parler de sécurité.
Mais en regardant, j'ai constaté que ces gens aiment vraiment discuter de sécurité : ils y ont consacré de très longs passages.
En tant qu'entreprise fondée sur la sécurité, Anthropic avait dès 2021 pressenti le cauchemar auquel on est confronté aujourd'hui, à l'heure où les Agents se multiplient partout.
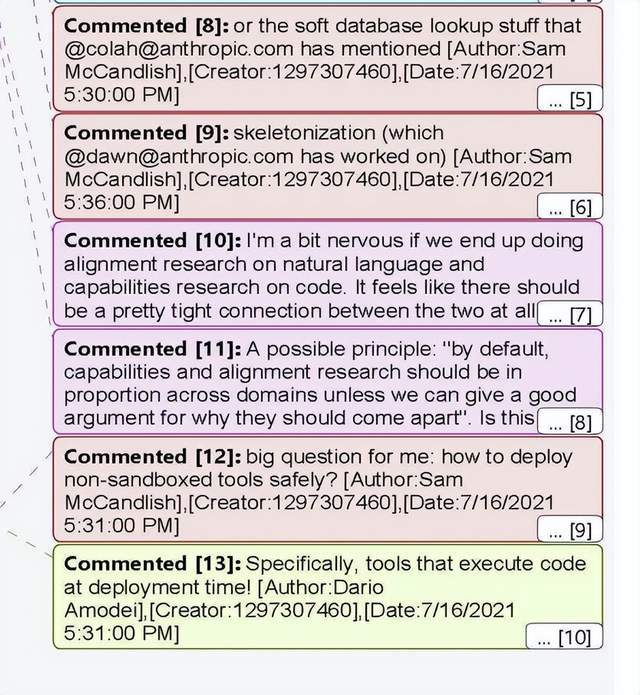
Le cofondateur Sam McCandlish a posé dans ses annotations une question existentielle :
comment déployer en toute sécurité des outils sans isolation par sandbox ?
Dario a aussitôt répondu dans le fil pour enfoncer le clou :
concrètement, des Tools qui exécutent du code au moment du déploiement !
(ps : il y a vraiment un point d'exclamation dans l'original, voilà à quel point ton Dario est passionné)
Incroyable.
Lorsque l'IA peut réellement exécuter du code directement dans l'environnement hôte, appeler le Shell, modifier des fichiers, une fois qu'elle échappe au contrôle ou subit une injection de Prompt, les conséquences sont tout simplement inimaginables.
L'élévation de privilèges des Agents, l'évasion d'environnement, la pollution des données dont tout le monde parle aujourd'hui : eux en discutaient déjà des frontières de la sandbox en 2021.
C'est probablement justement parce qu'ils voulaient suivre cette voie dès le départ.
Au fait, Amanda apparaît aussi dans ce rapport : c'est cette philosophe interne de la société A dont on a beaucoup parlé récemment.
Elle souligne très sérieusement :
si nous menons nos recherches en alignement sur le langage naturel, mais que nous faisons progresser les capacités des modèles principalement sur le code, je suis un peu inquiet. Ces deux types de recherche doivent rester étroitement liés en permanence.
Si nous ne menons pas de recherches en alignement dans les domaines où les capacités s'améliorent, cela limitera la validité des tests d'alignement. Cela pourrait créer un effet en chaîne, par exemple : faute d'intégration précoce, la recherche en alignement se transforme directement en une île isolée.
Elle va même jusqu'à proposer d'établir un principe d'entreprise :
Les recherches sur les capacités et les recherches sur l'alignement dans tous les domaines devraient progresser de manière proportionnée et synchronisée, sauf si nous pouvons fournir des raisons suffisantes justifiant de les séparer.
One More Thing
Ah, je me disais bien pourquoi A\ écrasait toujours OpenAI : c'était l'avantage du premier entrant.
Ces cinq dernières années, Anthropic est resté inébranlable, s'acharnant sur les signaux de code de haute qualité, l'apprentissage par renforcement et les flux de travail en entreprise ;
tandis qu'OpenAI a mené des combats sur plusieurs fronts : génération d'images, vidéos Sora, assistants vocaux, recherche... ce qui a pas mal dispersé ses forces.
Cependant, alors que tout le monde analysait encore les différences de trajectoires techniques entre les deux, OpenAI a soudain révélé un scandale encore plus invraisemblable qu'un film hollywoodien —
les amis, il y a une taupe chez OpenAI !!!
Selon l'acte d'accusation publié par les procureurs fédéraux américains, Abdulrahman Alfozan, 35 ans, ancien ingénieur de l'équipe produit d'OpenAI, a été officiellement licencié et fait l'objet de poursuites pénales fédérales.
Qu'a-t-il fait, ce gars ?
Dans la salle de réunion centrale réservée aux dirigeants au siège d'OpenAI à San Francisco, il a pris un dispositif d'écoute doté de fonctions de chiffrement avancé et de transmission de données,enveloppé dans du papier toilette,et l'a discrètement branché sur le port USB situé derrière le téléviseur.
Il faut savoir que cette salle de réunion est l'endroit où Sam Altman et d'autres dirigeants tiennent leurs réunions centrales à huis clos, où l'on discute habituellement de secrets sur le développement de la superintelligence, de plans de produits non révélés et de briefings sur les partenariats gouvernementaux.
Résultat : cela a été piraté aussi facilement.
Le monde n'est vraiment qu'un cirque...