
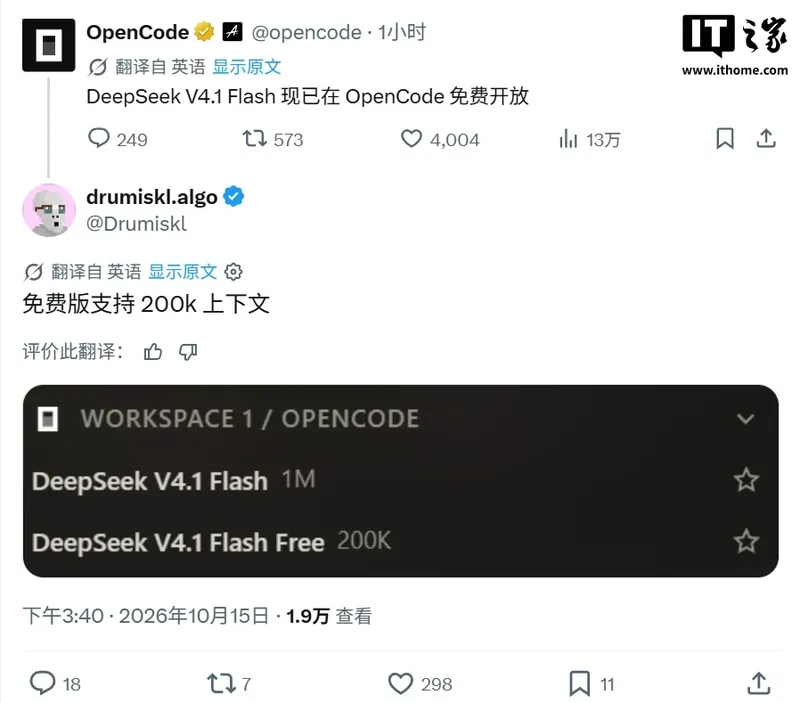
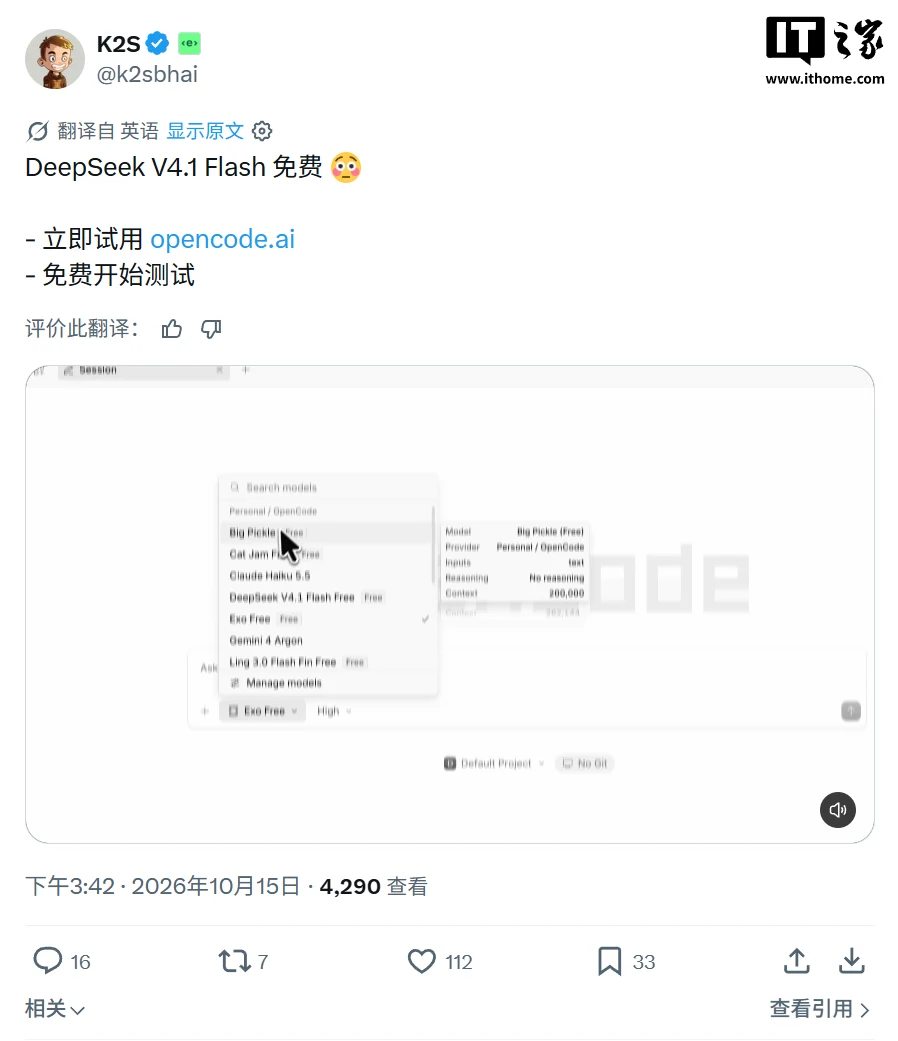
IT之家 Le 15 octobre, OpenCode vient d'annoncer que DeepSeek V4.1 Flash est désormais disponible gratuitement ; la version gratuite prend en charge en pratique une fenêtre de contexte de 200K, une réduction par rapport à la version avec contexte de 1M.
Cette ouverture gratuite constitue une nouvelle étape par rapport au plan « Operation Cheepseek » lancé précédemment. En septembre de cette année, OpenCode avait temporairement porté le quota d'utilisation de DeepSeek V4.1 Flash dans la formule OpenCode Go de 15 dollars à 60 dollars, avant de l'ajuster à 80 dollars le 12 octobre. Après cette ouverture gratuite, les appels au modèle sur la plateforme OpenCode ne consomment plus de quota.
DeepSeek V4.1 Flash, officiellement lancé le 10 septembre 2026, est un modèle MoE nativement multimodal, dont le tronc compte 552B de paramètres, auxquels s'ajoutent 196B de paramètres de mémoire conditionnelle Engram. IT之家 a noté que son architecture repose sur une conception encodeur-décodeur causal : parmi les 40 couches du tronc de langage, les 20 premières forment l'encodeur causal et les 20 dernières le décodeur, ce qui réduit de près de moitié le calcul de Prefill. Le modèle ne dispose d'aucun niveau d'API gratuit sur la plateforme officielle de DeepSeek ; la facturation s'effectue par prépaiement à l'usage.
Côté retours utilisateurs, la vitesse de génération (TPS) est au centre des discussions de la communauté. Plusieurs utilisateurs ont signalé d'importantes fluctuations de vitesse. Un utilisateur indique avoir observé sur la plateforme cloud ollama une vitesse de sortie d'environ 490 tokens/s au maximum, mais l'ensemble reste instable, avec des creux pouvant descendre à cinquante ou soixante tokens/s entre midi et l'après-midi.
Dans la formule OpenCode Go, des utilisateurs font également état d'une TPS inférieure à 100. De plus, les tests communautaires montrent que la vitesse diminue à mesure que le contexte grandit : un utilisateur rapporte qu'au-delà de 100K de contexte la TPS tombe en dessous de 100, et qu'à 200K elle avoisine 50 tokens/s.
À lire également :