
TL;DR
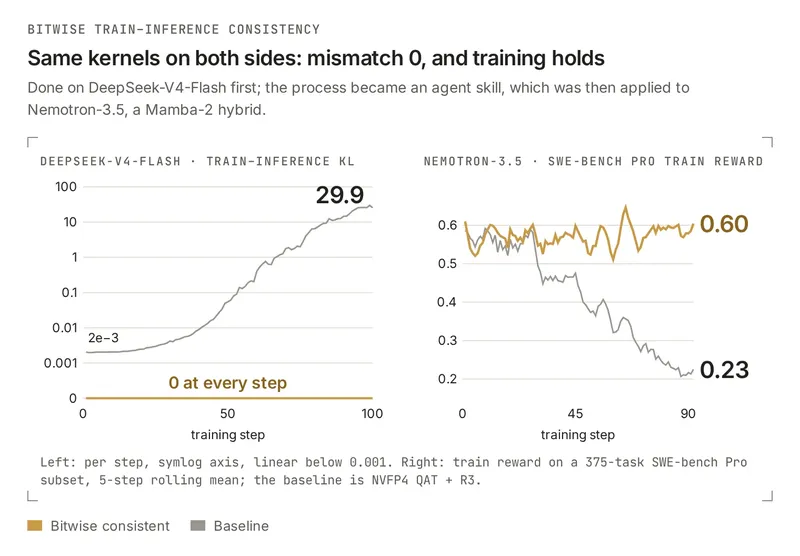
- Problème: les optimisations côté inférence dans le RL haute performance modifient la numérisation, si bien que l'entraînement optimise une politique différente de celle qui a échantillonné. Sur DeepSeek-V4-Flash, la KL train-inference du baseline haute performance est passée de 2e-3 à 29.9 tandis que la récompense replongeait.
- Approche: le forward d'entraînement appelle directement les noyaux d'inférence de vLLM, et ces noyaux haute performance sont modifiés afin que le rollout et l'entraînement produisent des logprobs bitwise identiques pour chaque token échantillonné (diff = 0).
- Résultats: sur plus de 100 étapes d'entraînement de DeepSeek-V4-Flash, diff est 0 à chaque étape à 91.3% du débit de rollout du baseline. Transposé à Nemotron (hybride Mamba + NVFP4), le score SWE-bench Pro du run consistant se maintient tandis que celui du baseline chute de 0.56 à 0.22.
- Open source: le processus est empaqueté sous forme d'agent skill et publié avec les recettes et le code, ce qui réduit le coût de la démarche sur un nouveau modèle.
- En cours: DeepSeek-V4.1 a atteint 0 de diff ; le travail de performance est en cours de finalisation et fera l'objet de son propre billet.
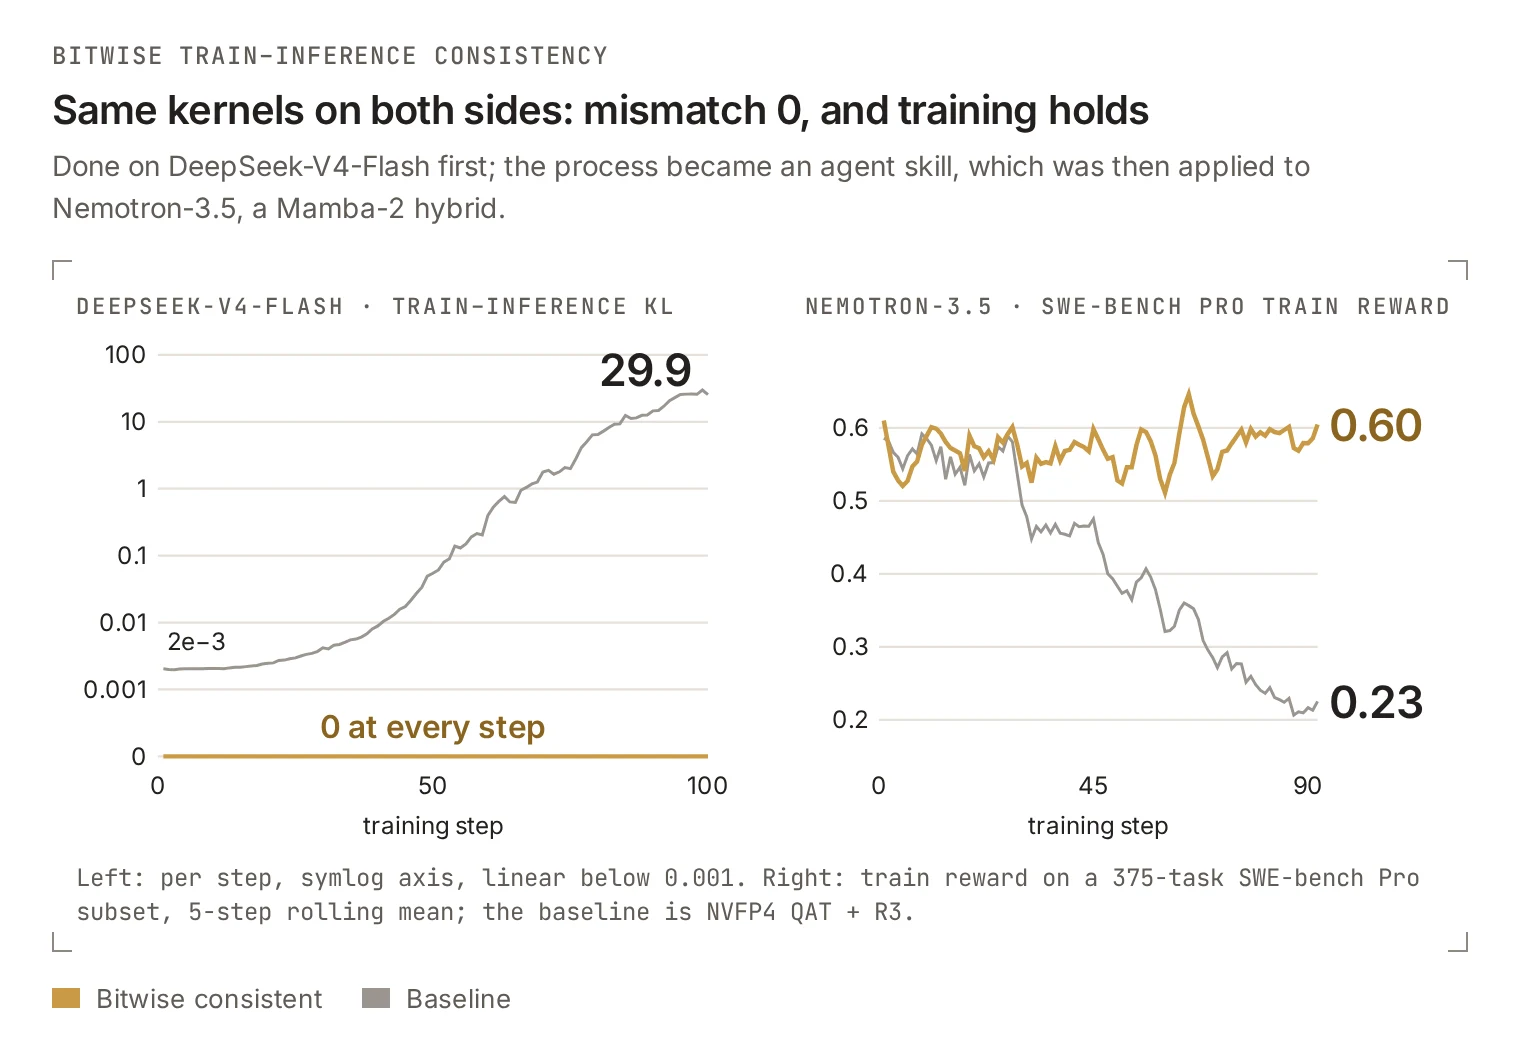
DeepSeek-V4-Flash a atteint 0 de diff en premier ; le processus est devenu un agent skill, qui a ensuite été appliqué à Nemotron-3.5 (un hybride Mamba-2). À gauche : KL train-inference de DeepSeek-V4-Flash ; le baseline grimpe de 2e-3 à 29.9 et le run consistant est à 0 à chaque étape. À droite : score d'entraînement de Nemotron-3.5 sur SWE-bench Pro (moyenne glissante sur 5 étapes) ; le run consistant reste autour de 0.6 tandis que le baseline tombe à 0.23.
Le rollout domine le temps d'entraînement RL, aussi les systèmes d'entraînement adoptent-ils le calcul basse précision, le KV cache basse précision, ainsi que des optimisations de communication et de noyaux. Cela modifie la numérisation côté inférence. Le moteur d'inférence génère une réponse ; le moteur d'entraînement recalcule ses probabilités et met à jour le modèle. Avec des poids identiques, les deux côtés attribuent désormais des probabilités différentes au même token, de sorte que l'entraînement optimise une politique autre que celle qui a échantillonné. L'écart peut croître avec les mises à jour et déstabiliser l'entraînement. Dans notre expérience DeepSeek-V4-Flash-Base (sans correction algorithmique telle que TIS), la KL train-inference du baseline haute performance est passée de 2e-3 à 29.9 tandis que la récompense replongeait.
Un entraînement instable signifie plus de plantages, de rollbacks et de relances, une part plus faible d'entraînement effectif, et plus de temps total pour atteindre le même résultat. Notre objectif est de finir plus vite l'entraînement RL effectif: en réduisant les plantages et les relances, atteindre un résultat en moins de temps de bout en bout.
Notre approche : sur le chemin numérique haute performance, l'entraînement et l'inférence produisent un logprob bitwise identique pour chaque token échantillonné (diff = 0 ; la Section 2 le définit exactement), ce qui constitue un vrai RL on-policy. Nous y parvenons en faisant appel par le forward d'entraînement directement aux noyaux d'inférence de vLLM et en modifiant ces noyaux haute performance pour que les résultats ne changent pas selon la composition du batch, la phase prefill ou decode, ou la disposition parallèle (Sections 3 et 4). Un agent skill réduit ensuite le coût de la démarche sur un nouveau modèle et rend le processus transférable : il indique à un agent comment trouver le premier opérateur où les deux côtés divergent, le réduire à un repro minimal, le corriger et relancer les régressions. Sur DeepSeek-V4-Flash, nous atteignons 0 de diff à 91.3% du débit de rollout du baseline haute performance, et nous avons transposé la méthode à Nemotron, un hybride Mamba avec NVFP4.
Ce billet mesure la cohérence numérique, les courbes d'entraînement et le débit de rollout. Le gain de bout en bout provient de la réduction des plantages et des relances, qui ne se manifeste que sur de longues exécutions ; cette comparaison en temps murale est laissée pour plus tard. Par ailleurs, aucun des baselines n'a été finement réglé ni exploré : chacun n'a exécuté qu'une seule configuration, avec R3 mais sans corrections algorithmiques telles que TIS ou MIS. Les effondrements des baselines présentés ici ne reflètent que cette recette ; avec un réglage, le baseline pourrait ne pas s'effondrer aussi facilement.
1. Approches existantes : comment elles arbitrent les trois
Finir plus vite l'entraînement RL effectif exige trois propriétés à la fois :
- A, haute performance: rollout et entraînement rapides, avec calcul basse précision, KV cache basse précision et optimisations de communication tous utilisables ;
- B, haute cohérence: entraînement et inférence calculent la même politique pour les mêmes poids ;
- C, faible coût et généralité: obtenir A et B sur un nouveau modèle, une nouvelle précision ou un nouveau matériel prend un temps de développement acceptable.
Elles tiennent rarement ensemble. Abandonner B et vous optimisez librement mais risquez un entraînement instable. Abandonner A et vous pouvez utiliser des kernels cohérents, mais l'inférence devient beaucoup plus lente (chiffres dans le tableau ci-dessous). Conserver A et B signifie aligner modèle par modèle et opérateur par opérateur, donc C échoue.
Le décalage entraînement-inférence n'est pas nouveau ; les approches existantes font des compromis différents entre A, B et C :
| Approche | Ce qu'elle conserve | Ce qu'elle sacrifie ou paie |
|---|---|---|
| Correction algorithmique: TIS, MIS, FlashREINFORCE, Score Centering | A et C : laisse le moteur d'inférence intact, indépendant du modèle, simple à adopter | B : la différence numérique subsiste ; seul son effet sur la mise à jour est limité. Coûts : biais, échantillons abandonnés, et la correction devient plus difficile à mesure que la basse précision élargit l'écart |
| R3 (routage expert par rejeu des rollouts) | A, plus B pour le routage MoE | Ne supprime que les bascules de routage ; les autres différences numériques subsistent |
| QAT (le forward d'entraînement simule la quantification du déploiement) | A : le rollout peut utiliser en toute sécurité une faible précision ; réduit la part de la différence induite par la quantification (améliore B) | L'entraînement doit simuler la quantification, et la rétropropagation utilise le straight-through estimator (STE : la rétropropagation traite la quantification comme l'identité) ; simuler uniquement les poids laisse des différences provenant des activations, du KV, des kernels et des réductions |
| Alignement numérique strict (Thinking Machines, slime, IsoExec, ce billet) | B | A ou C : des kernels génériques à invariance par lot coûtent A (charge de travail Thinking Machines : 26 s à 55 s, 42 s avec un kernel d'attention amélioré) ; s'aligner sur le chemin hautes performances conserve A et coûte C (slime, IsoExec, ce billet : alignement et vérification par modèle et par opérateur) |
La correction algorithmique couvre plusieurs mécanismes :
- TIS (Truncated Importance Sampling, Yao et al.) : pondère le gradient par le ratio des probabilités entraînement/rollout, tronqué à une borne supérieure, échangeant un peu de biais contre une variance bornée ;
- MIS (Masked Importance Sampling, When Speed Kills Stability) : pas de troncature ; écarte entièrement les séquences dont le ratio de probabilité au niveau de la séquence dépasse un seuil ;
- FlashREINFORCE (Hu, Zhang et al.) : pour le RL agentique asynchrone ; le filtrage de dérive au niveau des trajectoires (région de confiance de séquence) supprime les trajectoires qui s'écartent trop ;
- Score Centering (Marek & Ryabinin) : annule la dérive entraînement-inférence accumulée à chaque mise à jour via un terme de correction additif ; se combine avec l'échantillonnage par importance.
Ces méthodes réduisent l'effet du désalignement mais ne l'éliminent pas : le désalignement transforme l'entraînement on-policy en entraînement off-policy (Yao et al.) ; lorsqu'il est important et comporte plusieurs sources, l'échantillonnage par importance au niveau des tokens est biaisé et l'entraînement est plus sujet à l'effondrement (Li & Liu) ; dans P1-VL, l'échantillonnage par importance tronqué n'a fait que retarder l'effondrement. R3 (Rollout Routing Replay, Ma et al.) enregistre le routage des experts du rollout et le rejoue dans l'entraînement, ne supprimant que la partie liée aux inversions de routage.
Sur la dernière ligne, Thinking Machines Lab parvient à un véritable RL on-policy avec des kernels à invariance par lot (Defeating Nondeterminism in LLM Inference) au coût d'inférence indiqué dans le tableau, dont une grande partie provient d'une intégration FlexAttention pas encore bien optimisée ; vLLM et TorchTitan réutilisent les noyaux forward de vLLM dans l'entraînement, et leur exécution bit-à-bit cohérente a atteint une récompense plus élevée en moins d'étapes ; slime aligne les logprobs sur l'architecture GLM-5 (MLA + DSA, même structure que DeepSeek-V3.2) ; et IsoExec par Alexander Jiang et l'équipe SkyRL couvre l'attention linéaire (Section 6).
La plupart de ces approches se combinent : certaines ciblent la différence numérique entre moteurs sur une même version des poids, d'autres la différence de politique entre versions des poids. Dans l'entraînement asynchrone, le hors-politique dû aux poids périmés passe toujours par TIS, MIS ou le Score Centering, mais les moteurs peuvent toujours être alignés numériquement sur ces poids, et l'exécution bit-à-bit cohérente devient la référence pour mesurer de telles corrections. Le QAT appartient aussi à l'alignement strict : le rollout et l'entraînement en basse précision ne concordent bit-à-bit que si le forward d'entraînement applique la même quantification ; notre backward utilise STE.
Nous prenons le chemin de la dernière ligne qui conserve A, avec ce critère pour A : un débit de rollout d'au moins 70% d'une référence haute performance également optimisée (le rollout est la partie la plus longue de l'entraînement RL ; le surcoût côté entraînement n'a pas été mesuré séparément, voir 3.2). C est le point faible de ce chemin ; la Section 5 explique comment Agent + skill le compense.
2. Ce qu'exige la cohérence entraînement-inférence
Dans cet article, le diff est la différence, avant chaque mise à jour avec la même version des poids et le même préfixe de tokens, entre le logprob du rollout pour chaque token valide (tokens échantillonnés à l'intérieur du masque de réponse) et l'old-logprob recalculé côté entraînement. L'acceptation exige que le max, la moyenne et l'écart-type de la différence par token |p_rollout − p_train|, ainsi que la KL k3, soient exactement 0. Il s'agit d'une égalité exacte, pas d'un seuil, vérifiée avant chaque mise à jour ; une mise à jour par mini-lot modifie de toute façon la politique, ce que la définition exclut. Elle tient sur nos tâches acceptées (raisonnement mathématique, appels d'outils multi-tours) et sur nos dispositions parallèles, y compris des dispositions différentes selon le côté.
« L'entraînement et l'inférence calculent la même chose » se décompose en quatre dimensions plus un contrat numérique partagé :
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
Le déterminisme des noyaux (un seul GPU). Le même noyau sur la même entrée donne toujours la même sortie. Les GPU ne le garantissent pas par défaut. Un exemple est la multiplication matricielle split-K : un ordre d'accumulation différent donne un résultat différent parce que l'addition en virgule flottante n'est pas associative.
Indépendance des batchs. Le résultat d'une requête ne doit pas dépendre de ses compagnons de batch. Lors de l'inférence, le moteur fusionne et divise les batchs dynamiquement pour le débit. À l'entraînement, la taille des micro-batchs, le packing et les nombres de tokens par expert en MoE changent également le chemin. Diverses optimisations (choix du noyau selon la taille du batch, nombre dynamique de divisions) rendent une requête donnée dépendante des autres dans son batch.
Cohérence de phase. Un token doit obtenir le même résultat en prefill (plusieurs tokens à la fois) et en decode (un à la fois). Les moteurs d'inférence donnent à chaque phase son noyau le plus rapide ; forcer un chemin partagé est une source principale du ralentissement de la version cohérente et un axe d'optimisation.
Cohérence inter-GPU. Les réductions inter-GPU (AllReduce, reduce-scatter, et fusion des sorties d'experts après le all-to-all du MoE) doivent également être fixes, à deux niveaux.
- Avec la même disposition parallèle des deux côtés, les résultats de communication ne doivent pas varier selon le timing et l'ordonnancement (fixer l'algorithme de la bibliothèque de communication, le découpage et la précision de la réduction, et l'ordre de fusion des experts).
- Avec des dispositions parallèles différentes (par exemple des degrés TP/EP différents), les résultats doivent rester identiques quand le degré de parallélisme change, ce qui nécessite un arbre de réduction fixe et coûte plus cher. La recette DeepSeek-V4 déplace à la place la réduction inter-GPU hors du chemin comparé (4.5).
Chaque dimension protège contre l'une des deux causes racines : un ordre différent des opérations (l'accumulation ou l'ordre de réduction parallèle suit l'ordonnancement) ou un chemin de calcul différent (les deux côtés, ou des formes de batch différentes, exécutent des noyaux ou des branches différents). Atteindre 0 diff signifie d'abord supprimer les différences statiques, puis fixer la sélection dynamique de chemin pour qu'elle ignore la charge.
Outre ces quatre dimensions, atteindre diff = 0 exige quelques éléments supplémentaires :
- Le même contrat numérique des deux côtés: même quantification et arrondi, même précision d'accumulation, même arithmétique des noyaux. Deux moteurs peuvent satisfaire les quatre dimensions et néanmoins diverger s'ils calculent différemment.
- Les mêmes choix discrets: le Top-K et le routage MoE transforment une différence amont d'un ulp (une unité de dernière place d'un nombre à virgule flottante) en un ensemble de tokens ou une combinaison d'experts différente. Une fois l'amont aligné, les départages, l'ordre de sortie et les règles de fusion doivent aussi coïncider.
- 1 mise à jour par étape (batch d'étape égal au mini-batch): avec plusieurs mises à jour de mini-batch par étape, dès la deuxième, les poids d'entraînement diffèrent des poids d'échantillonnage, ce que diff = 0 ne couvre pas, si bien que l'entraînement cesse d'être strictement on-policy (sur une tâche de mathématiques avec 4 mises à jour par étape, environ 7 % des tokens ont changé de combinaison d'experts après chaque mise à jour).
- Une rétropropagation et une restauration correctes: les quatre dimensions ne donnent qu'un forward cohérent. Le backward doit toujours être correct, et la première étape après la restauration d'un checkpoint doit rester cohérente.
Les principaux opérateurs de la Section 4 répondent chacun à l'une de ces exigences : le GEMM dense fixe la sélection de noyau pour l'indépendance des batchs (4.1) ; le cache KV FP8 unifie les lectures prefill et decode pour la cohérence de phase (4.2) ; le Top-K fixe les départages et l'ordre pour que les choix discrets coïncident (4.3) ; le GEMM expert conserve un seul contrat numérique entre deux dispositions (4.4) ; et la réduction inter-GPU est sortie du chemin comparé pour la cohérence inter-GPU (4.5).
diff = 0 signifie que les deux côtés calculent la même chose, non que cela convient à l'entraînement: avec plusieurs mises à jour par étape, diff = 0 reste valable pendant que le routage dérive entre les mises à jour. diff = 0 est notre cible d'ingénierie, pas une condition suffisante pour la qualité de l'entraînement, qui requiert une validation séparée.
3. Recette de référence : DeepSeek-V4-Flash
DeepSeek-V4-Flash combine calcul basse précision, attention creuse et parallélisme d'experts multi-nœuds, ce qui en fait une configuration difficile. À partir de la base FP8, nous avons entraîné deux runs de 100 étapes sur GB200 : une baseline optimisée haute performance et une version cohérente avec diff = 0.
Tâche : raisonnement mathématique avec des données au format DAPO, GRPO, et une récompense avec une pénalité de longueur excessive (elle peut donc être négative). Chaque run utilise 8 machines (32 GPU), 128 prompts × 8 réponses par étape, et 1 mise à jour par étape (batch d'étape = mini-batch). Aucun des deux runs n'utilise TIS, MIS ou des corrections similaires, ce qui expose directement la différence entre moteurs.
Parallélisme : DP données, EP experts, CP contexte (découpage de séquence), TP tenseur. Le rollout de la version cohérente exécute 4 moteurs vLLM, chacun DP8/EP8, TP=1 ; l'entraînement utilise EP32, CP4, TP=1. Les deux côtés utilisent des dispositions parallèles différentes (4.5).
Structures pertinentes : MLA (attention latente multi-têtes, qui compresse les KV avant la mise en cache) ; DSA (attention éparse DeepSeek : un indexeur léger attribue des scores aux positions de l'historique, le Top-K en conserve au plus 2048, et MLA n'effectue l'attention que sur celles-ci) ; le compresseur CSA (compresse les KV de l'historique en un nombre réduit de lignes) ; mHC (mélange entre flux résiduels, la matrice de mélange étant normalisée par itérations de Sinkhorn) ; et 43 couches MoE. SM100 est Blackwell (le GB200 utilisé ici) ; SM90 est Hopper.
3.1 Décision centrale : les noyaux d'inférence définissent les valeurs, l'entraînement ajoute la rétropropagation
Deux moteurs s'accordent le plus facilement en exécutant le même code ; la question est de savoir quel côté s'adapte. Le rollout domine le temps de RL, chaque opérateur étant optimisé pour le débit ; faire de l'entraînement la référence reviendrait à renoncer à ces optimisations. Ainsi, les noyaux d'inférence constituent la référence numérique : la passe avant de l'entraînement appelle les mêmes noyaux vLLM pour ses valeurs, et l'entraînement n'ajoute que la rétropropagation. L'inférence ne bascule pas non plus vers des noyaux génériques invariants au batch : elle conserve les noyaux de déploiement haute performance et les modifie pour satisfaire aux exigences de la Section 2. Chaque opérateur de la Section 4 suit ce compromis.
Le défi de cette décision est que les kernels d'inférence n'ont pas de backward, et que la quantization FP8 n'est pas dérivable. Ainsi, forward et backward sont traités séparément, et les valeurs du forward proviennent toujours du kernel vLLM. Chaque module encapsule le kernel dans un autograd.Function dont le backward dérive par rapport aux poids maîtres BF16, la quantization FP8 étant traitée comme une identité (le straight-through estimator, STE). Le backward réutilise principalement les kernels existants : les GEMM BF16 de Transformer Engine pour les couches linéaires et les GEMM d'experts, le backward DSA du frontend cuDNN pour l'attention parcimonieuse, et le backward de DeepEP pour le all-to-all ; seuls de petits opérateurs comme mHC, RMSNorm et SwiGLU ont des dérivées FP32 écrites à la main. Quelques kernels fusionnés ont des sorties qui ne peuvent pas être dérivées de cette manière (attention q/k, KV compressé, poids de routage, logprob final) ; pour ceux-ci, nous réexécutons le même calcul dans PyTorch uniquement pour son gradient et conservons les valeurs du kernel : visible + (graph - graph.detach()). Chaque backward vérifie d'abord que les poids maîtres n'ont pas changé depuis le forward, afin que la recomputation ou les mises à jour asynchrones ne puissent pas mélanger des versions de poids.
Tous les coûts se retrouvent dans l'entraînement, sous deux formes. Ingénierie et vérification : le gradient est un substitut, pas la dérivée exacte de l'opérateur quantisé ; ainsi, un forward identique au bit près ne prouve rien sur les gradients, et le skill vérifie le backward par rapport à une référence indépendante (Section 5) ; le backward doit seulement être correct, pas déterministe. Chaque point d'entrée de layout (par ex. masked / contiguous en 4.4) nécessite aussi sa propre vérification. Performance et mémoire : le forward d'entraînement doit sauvegarder les entrées et sorties des kernels d'inférence pour le backward ; c'est cette pression mémoire qui conduit la recette à activer la recomputation complète, qui exécute le forward deux fois.
3.2 Résultats et qui paie
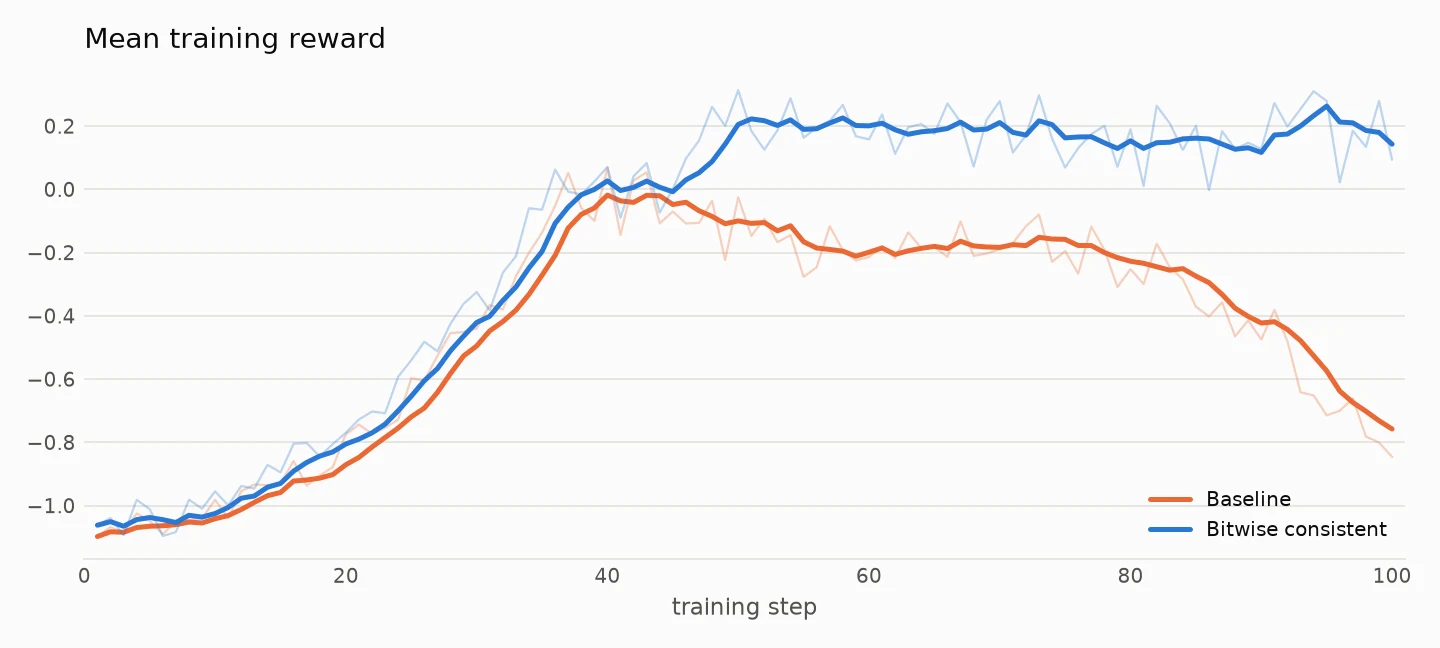
Récompense d'entraînement par étape. Orange : baseline ; bleu : version consistante. Ligne épaisse : moyenne mobile de l'étape courante et des 4 précédentes ; ligne fine : valeur brute.
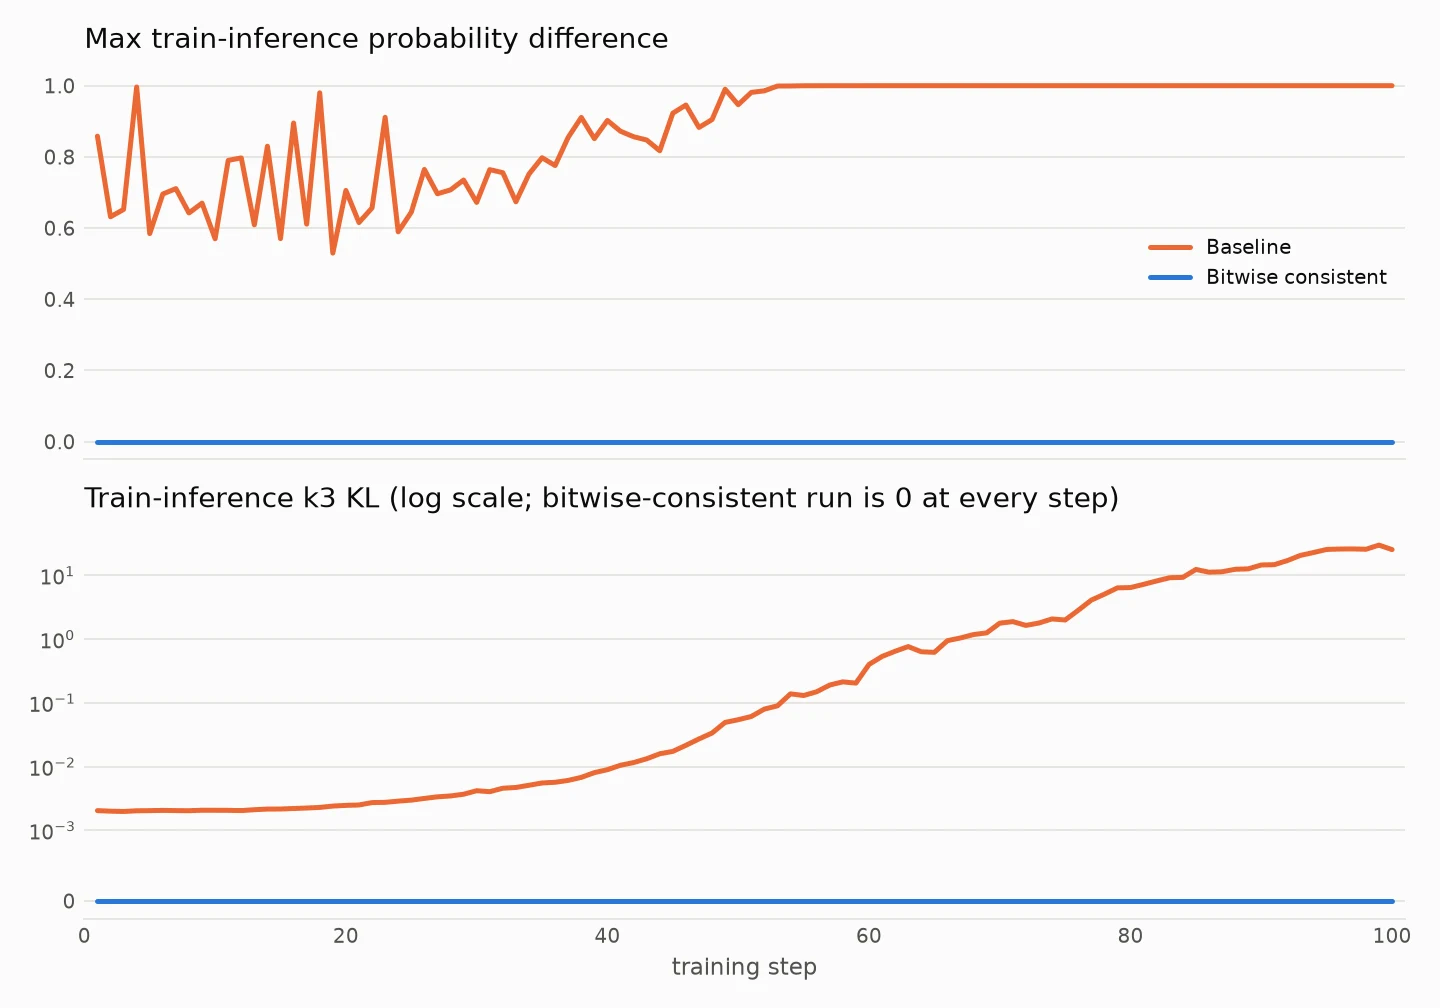
Haut : différence maximale de probabilité train-inférence par étape ; bas : KL train-inférence (estimateur k3 r − 1 − log r, utilisé partout ; échelle logarithmique symétrique, linéaire près de zéro). La différence maximale réagit à un seul basculement de routage ou échange Top-K, elle est donc conséquente dès l'étape 1 de la baseline ; la KL montre le niveau global. Orange : baseline ; bleu : version consistante. Les deux métriques de la version consistante valent 0 à chaque étape.
Sur 100 étapes, le rollout de la version consistante atteint en moyenne 24.22 token/ms, soit 91.3% de la baseline (26.53) :
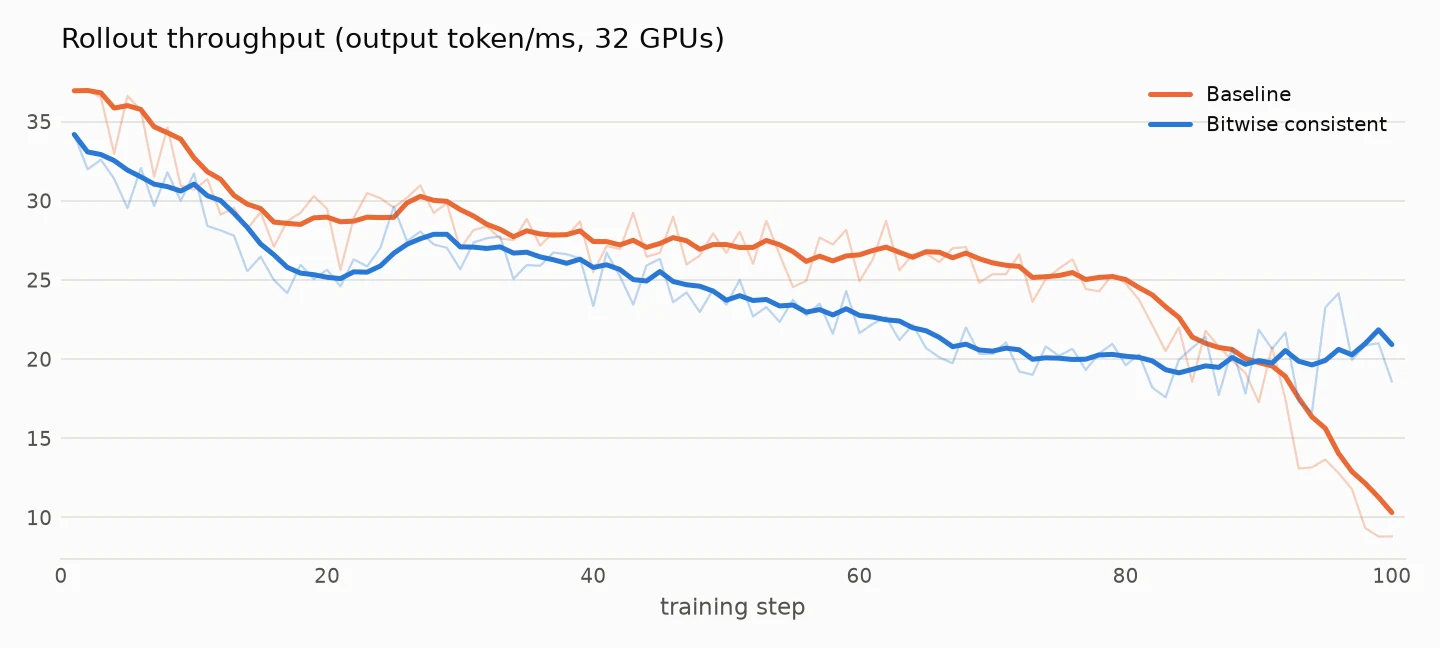
Débit de rollout par étape (token/ms en sortie, sommé sur 32 GPU). Orange : baseline ; bleu : version consistante. Ligne épaisse : moyenne mobile de l'étape courante et des 4 précédentes ; ligne fine : valeur brute.
La KL train-inférence de la baseline croît (2e-3 à 29.9) pendant que sa récompense retombe ; la version consistante reste à diff 0 et sa récompense se maintient. Un autre gain potentiel est un forward en moins : nous recalculons old-logprob à chaque étape uniquement pour mesurer diff ; après acceptation, l'entraînement peut utiliser le logprob du rollout à la place.
Côté rollout, mesuré dans cette exécution : le débit moyen est de 91.3% de la baseline (environ 9% plus bas), au-dessus du plancher de 70% de la Section 1. Après l'étape 90, le débit de la baseline chute, ce qui gonfle le ratio ; sur les mêmes étapes, sa longueur moyenne de réponse passe d'environ 3,000 à environ 1,600 tokens. Les 89 premières étapes donnent 88.6%. Les longueurs de réponse des deux exécutions diffèrent tout au long de l'entraînement, donc le ratio reflète aussi des charges de travail différentes, et pas seulement les moteurs.
Cet écart n'est pas encore attribué à des opérateurs ; la Section 4 pointe vers la communication LL MoE et le backend, le gather d'attention et la déquantization, et les lancements par requête.
Côté entraînement, non mesuré séparément : selon la Section 4, la surcharge vient de la requantization des poids FP8 à chaque forward, de l'attention et du Top-K sériels par requête, d'un dispatch supplémentaire de métadonnées de routage, et de la recomputation complète (3.1), qui exécute le forward deux fois.
Un aperçu séparé d'une PR de recette verl sur 32 GPU GB200 rapporte environ 10% de surcharge de bout en bout : rollout proche de la parité, l'écart se situant surtout dans l'entraînement. L'optimisation côté entraînement est la prochaine étape.
4. Opérateur par opérateur : choix techniques dans la recette DeepSeek-V4
Chaque sous-section couvre ce qui est conservé, ce qui est abandonné, comment la vitesse est récupérée, et quel coût demeure. Quel kernel chaque côté utilise par opérateur, et comment le backward est écrit, figurent dans le skill.
Tableau maître par opérateur
Le coût se situe surtout dans la communication MoE et le backend (4.4, 4.5), puis dans le gather d'attention et la déquantization (4.2, 4.3) ; le dense est bon marché.
| Module | Conservé | Abandonné | Coût |
|---|---|---|---|
| GEMM dense (4.1) | Déploiement W8A8 et DeepGEMM ; un ordre d'accumulation par sortie | Branche FlashInfer pour M<32, kernel de gate pour petits lots, kernel mHC fusionné | rollout : pas de kernel plus rapide pour les petits lots ; entraînement : poids requantisés à chaque passe avant |
| Cache KV FP8 (4.2) | Stockage FP8 | Kernel de décodage qui lit le FP8 directement | rollout : gather et déquantification supplémentaires dans le décodage ; entraînement : un cache privé |
| Top-K (4.3) | DSA attention sparse | Rupture des égalités et ordre de sortie du Top-K par défaut | Un tri supplémentaire par côté, récupéré par fusion ; plusieurs lancements de préremplissage par requête ; entraînement : attention et Top-K en série par requête |
| GEMM d'experts (4.4) | GEMM groupé FP8 ; le routage correspond par construction, pas de R3 | FlashInfer TRT-LLM MoE | rollout : un écart de débit principal ; entraînement : remplissage d'alignement |
| Réduction inter-GPU (4.5) | Dispositions parallèles différentes pour l'entraînement et le rollout | TP>1 | rollout : la communication LL ne peut pas se chevaucher avec le calcul ; entraînement : un dispatch supplémentaire de métadonnées de routage |
| CUDA Graph (4.6) | Graphes | Branches de raccourci uniquement pour la performance | Espaces de travail réservés à leur borne supérieure |
| Autres (embedding, RMSNorm, o_proj, lm_head + logprob) | Noyaux existants, ordre de réduction fixe | — | Faible |
4.1 GEMM dense : conserver FP8, un seul ordre d'accumulation pour chaque M
Conservé. DeepSeek-V4-Flash-Base est livré en block-FP8, et le chemin de déploiement est W8A8 avec DeepGEMM. La version cohérente l'utilise des deux côtés : chaque passe avant d'entraînement quantize les poids maîtres BF16 en block FP8 selon la règle de déploiement et appelle le GEMM d'inférence. Un rollout BF16 coûterait du calcul et de la bande passante ; un schéma distinct côté entraînement tel que MXFP8 ne fait que s'approcher des numériques déployés, la limite de la ligne QAT de la Section 1.
Abandonné. Le moteur d'inférence choisit les noyaux selon la forme : la couche linéaire FP8 utilise FlashInfer lorsque M<32 et DeepGEMM sinon ; la porte du routeur bascule vers un noyau à petit lot à 16 tokens ou moins ; le nombre de splits du mHC croît avec le nombre de tokens. L'addition en virgule flottante n'est pas associative, donc chacune fait dépendre le résultat d'une requête de ses voisines. La version cohérente supprime ces branches : la couche linéaire FP8 utilise toujours DeepGEMM en mode invariant au lot, la porte du routeur utilise un GEMM à sortie FP32 à chaque taille de lot, les petits matmuls BF16 utilisent un noyau Triton avec un ordre de sommation fixe, et le split du mHC est fixé à 1. Nous unifions sur DeepGEMM plutôt que FlashInfer car DeepGEMM dispose d'un mode invariant au lot, est déjà le noyau de déploiement, et le M d'entraînement est grand.
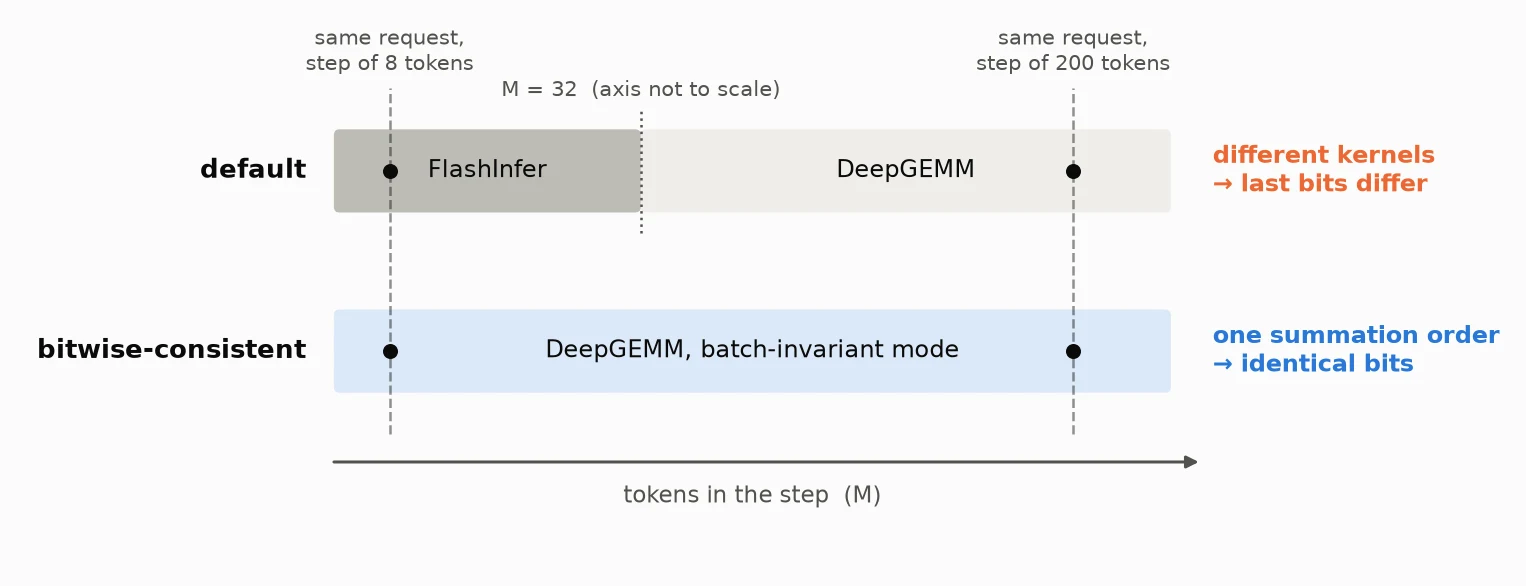
Axe horizontal : tokens par étape (schématique). Le chemin par défaut change de noyau à 32, ainsi la même requête dans une étape de 8 tokens et une étape de 200 tokens passe par FlashInfer et DeepGEMM et diffère au dernier bit. Le mode invariant au lot a un seul ordre de sommation.
Coût. Le rollout perd des noyaux à petit lot plus rapides et une fusion mHC, mais les Tensor Cores restent utilisés. L'entraînement requantize les poids à chaque passe avant, y compris la recomputation ; mettre en cache les poids FP8 économise ce temps au prix d'une copie résidente de plus.
4.2 Cache KV FP8 : conserver le stockage FP8, unifier le chemin de lecture
Conservé. Le cache KV est stocké en FP8, environ 57% du BF16, ce qui fixe directement la concurrence. Les deux exécutions partagent le chemin d'écriture.
Abandonné. Le décodage par défaut utilise un noyau FlashMLA qui lit le FP8 directement et partitionne le travail par lot ; le préremplissage déquantize en BF16 et exécute l'attention sparse. Les deux phases exécutent des algorithmes différents, et la partition du décodage dépend de son lot. La version cohérente fait passer le décodage par le chemin de préremplissage : déquantizer et rassembler le KV sélectionné dans un espace de travail BF16, puis appeler le même flash_mla_sparse_fwd. L'espace de travail est propre à chaque requête et dimensionné uniquement par les limites du modèle. Ce noyau de décodage doit être sélectionné explicitement ; le seul commutateur de cohérence ne le change pas.
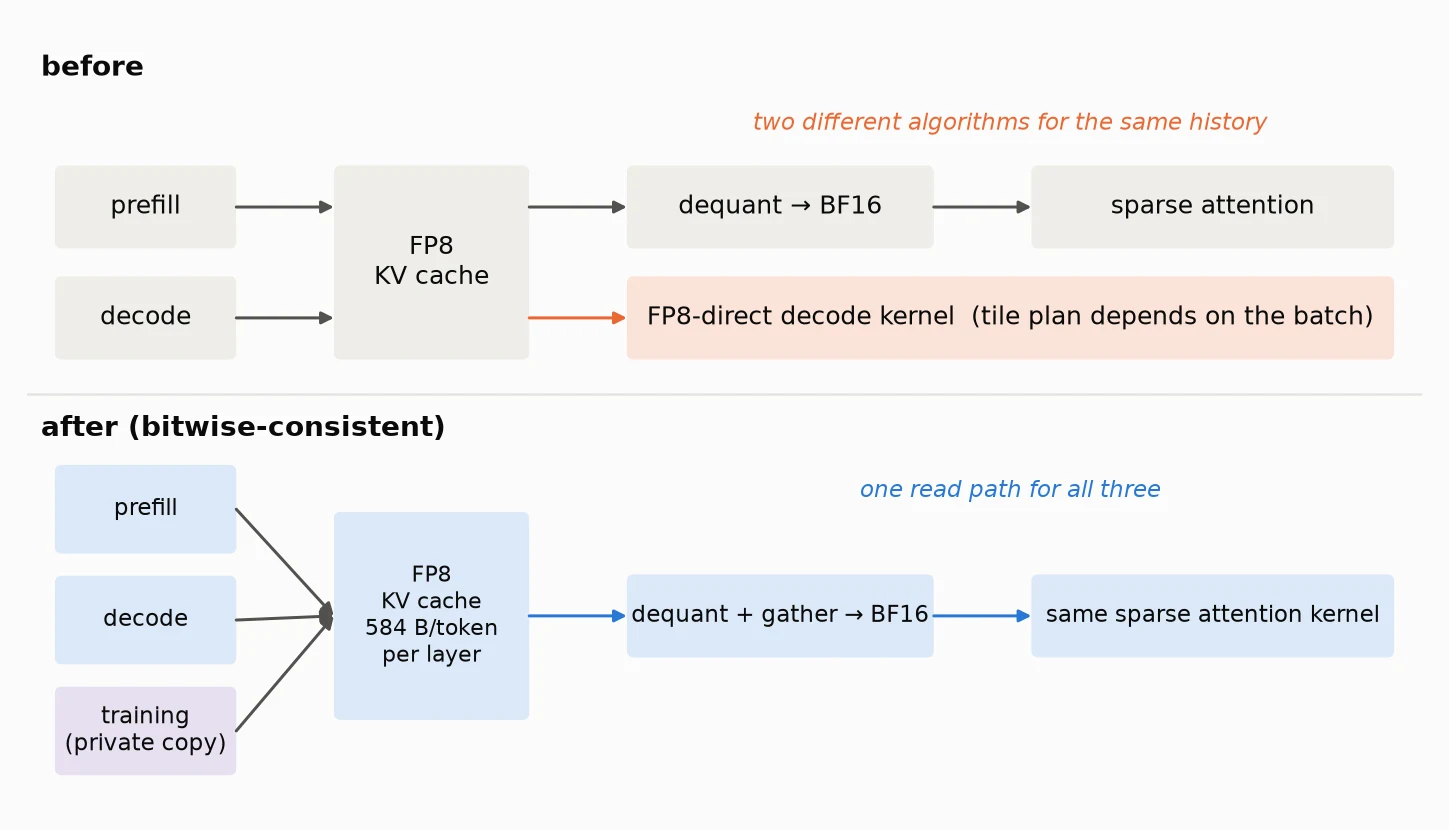
En haut : avant, le préremplissage et le décodage lisent le même historique FP8 avec deux algorithmes, et la partition du décodage dépend du batch. En bas : le préremplissage, le décodage et l'entraînement (avec une copie privée du cache) partagent un chemin de lecture unique.
L'entraînement n'a pas de vrai cache, mais K doit effectuer le même aller-retour FP8 : le même noyau fusionné l'écrit dans un cache FP8 privé, et la même déquantification le relit.
Coût. Le décodage ajoute un gather et une déquantification, et l'entraînement ajoute un cache. C'est le prix de la cohérence des phases ; la précision de stockage reste inchangée. Chaque requête génère actuellement un token par étape ; la prédiction multi-token (MTP) et le décodage spéculatif ne sont pas couverts.
4.3 Top-K dans l'attention creuse : corriger les égalités et l'ordre
Problème. L'indexeur DSA attribue un score à chaque position de l'historique, et le Top-K sélectionne au plus 2048 positions pour l'attention. Ce choix discret transforme une différence d'un ulp en amont en un contexte différent. Le scoring est d'abord aligné : l'indexeur utilise le même noyau DeepGEMM, le prefill lit un KV contigu et le decode lit un KV paginé, et les deux lectures sont identiques au bit près.
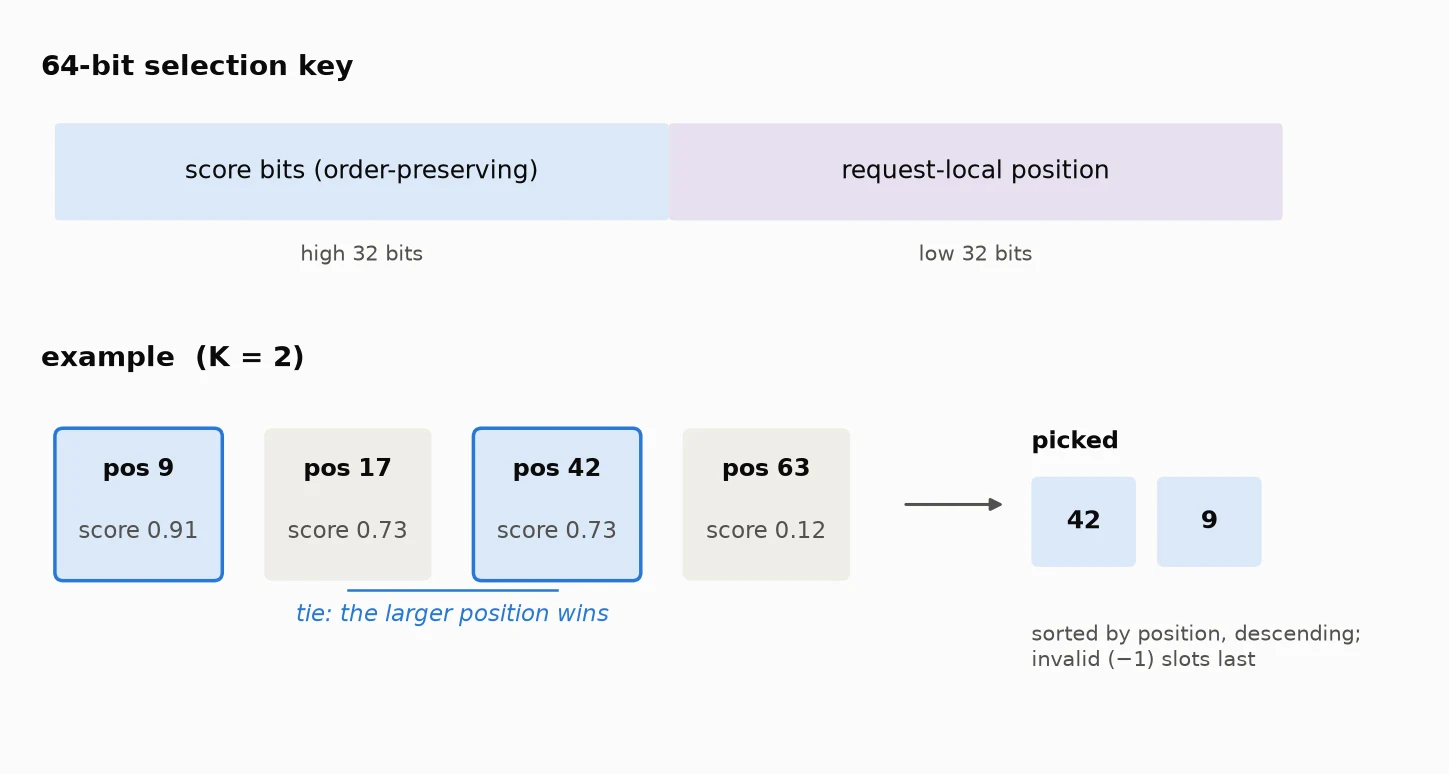
Haut : disposition de la clé de sélection 64 bits. Bas : un exemple avec K = 2 où les positions 17 et 42 sont à égalité et où les bits de position de la clé sélectionnent 42 ; les positions sélectionnées sont ensuite triées par position décroissante, les entrées invalides en dernier.
Fixer la sélection et l'ordre. Le Top-K par défaut départage les égalités selon l'ordonnancement des threads. La version consistante combine le score et la position dans la requête en une clé unique, si bien que les égalités vont à la plus grande position. Elle utilise la position dans la requête, et non la position globale dans le batch ; sinon, déplacer une requête dans le batch changerait les résultats des égalités. Le même ensemble ne suffit pas : l'ordre des indices détermine l'ordre d'accumulation de l'attention, donc les indices sélectionnés sont triés par position décroissante, les entrées invalides en dernier.
L'alternative de style R3 enregistre les indices du rollout et les rejoue en entraînement, mais cela représente jusqu'à 2048 indices par token et par couche : de l'ordre du Go par séquence pour de longues réponses.
Côté entraînement. La passe avant de l'entraînement sélectionne les mêmes positions avec le même scoring et le même Top-K, mais l'indexeur n'est pas entraîné, principalement pour des raisons de simplicité. Cela correspond à la pratique existante : DeepSeek-V3.2 détache l'entrée de l'indexeur lors de l'entraînement de DSA, de sorte que la perte RL ne l'atteint jamais, et GLM-5 gèle l'indexeur par défaut en RL.
Coût et récupération. Chaque côté effectue un tri supplémentaire. Le Top-K déterministe prend environ 5.9 µs par appel ; sa fusion avec le tri des indices augmente le débit en benchmark d'inférence de la version consistante de 6.7% (configuration en 4.4). Le coût restant est celui de multiples lancements par requête dans le prefill.
4.4 Expert GEMM : deux dispositions, même résultat par ligne
Conservé. Le GEMM groupé FP8 des experts routés domine la couche MoE, et les deux côtés lui fournissent des dispositions différentes. Le rollout utilise DeepEP en mode basse latence (LL) (pourquoi : 4.5), ce qui donne une disposition masquée découpée par expert avec une capacité fixe par chunk. L'entraînement traite de nombreux tokens avec DeepEP en mode normal, ce qui donne une disposition contiguë empaquetée par expert.
Choix du backend. Les deux côtés consistants utilisent DeepGEMM en mode batch-invariant : il est open source, dispose d'un mode batch-invariant, et c'est le noyau de déploiement haute performance. Le FlashInfer TRT-LLM MoE du baseline est livré sous forme de cubins précompilés, si bien que nous ne pouvons ni le modifier ni vérifier s'il est batch-invariant ; cutlass manque du block-FP8, et triton tombe sur une implémentation par lots qui ne déclare pas l'invariance de batch. Un seul expert GEMM prend environ le même temps des deux côtés ; le baseline est plus rapide car TRT-LLM MoE chevauche la communication et le calcul dans un pipeline multi-flux.
Même résultat par ligne à partir de deux dispositions. Trois conditions doivent être remplies :
- Les experts reçoivent la même entrée FP8. Le mode LL quantifie au dispatch et le mode normal après celui-ci, à l'origine avec des arrondis différents ; nous avons unifié les deux sur l'arrondi au plus près élément par élément.
- Le résultat de chaque ligne est indépendant de la disposition. La quantification est par token et le DeepGEMM batch-invariant accumule chaque ligne de manière fixe, donc le résultat d'une ligne ne dépend pas de ses voisines. Des tests bitwise du routeur + MoE le confirment.
- L'activation est arrondie une seule fois. SiLU(gate) × up entre les deux GEMM est calculé en FP32 et seul le produit est arrondi en BF16, puis quantifié en FP8. Arrondir SiLU en BF16 avant la multiplication peut différer d'un ulp, ce que la quantification FP8 amplifie en un basculement de code.
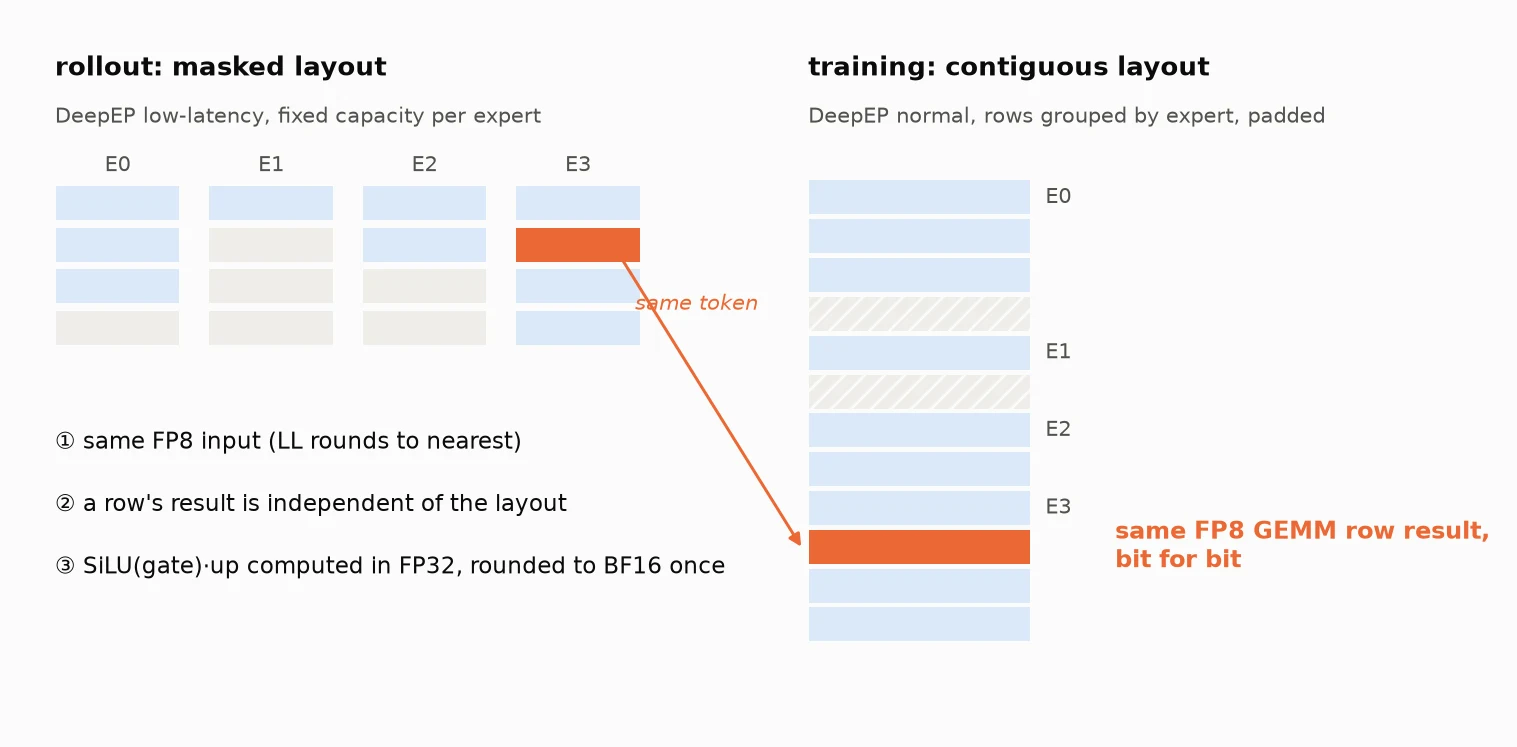
Le même token (orange) se trouve à des positions différentes dans la disposition masquée du rollout et la disposition contiguë de l'entraînement, pourtant les trois conditions rendent son résultat d'expert GEMM identique au bit près. Gris : emplacements vides ; hachures : padding d'alignement.
Pas besoin de R3. Le GEMM de scoring du routeur utilise un seul noyau à sortie FP32 à toutes les tailles de batch sur des entrées identiques au bit près, donc le routage recalculé correspond au rollout. Cela suppose 1 mise à jour par étape (Section 2).
Coût. Le rollout abandonne le MoE de TRT-LLM, mais le GEMM ne constitue pas la majeure partie de l'écart. Sur le benchmark d'inférence (GB200, DP8/EP8, 256 de concurrence, 150 en entrée / 3000 en sortie par requête), la version consistante démarrait 33 % plus lentement que la baseline, environ 83 % de cet écart provenant de la communication LL non recouvrable (4.5). L'entraînement sauvegarde les valeurs intermédiaires pour la rétropropagation et complète les lignes de chaque expert. Les chiffres du benchmark d'inférence ci-dessous proviennent de différentes étapes d'optimisation ; ne les comparez qu'au sein d'une même phrase.
Avant de comparer les performances, confirmez également quel kernel la baseline exécute : vLLM active le kernel batch-invariant SiLU·mul·quantisation dès que sa bibliothèque partagée est présente, en ignorant le commutateur de consistance, de sorte que toute image livrant la bibliothèque l'exécute aussi dans la baseline.
4.5 Réduction inter-GPU : hors du chemin comparé
Problème. Le rollout veut une faible latence et utilise DP8/EP8 ; l'entraînement doit faire tenir les activations de longues séquences et utilise EP32 plus CP4. Comme l'a noté la Section 2, différentes dispositions exigent des résultats invariants au degré de parallélisme, généralement au moyen d'un arbre de réduction fixe et coûteux.
Choix. Cette recette tient la réduction inter-GPU hors du chemin numérique comparé, et la communication restante déplace des données sans changer les valeurs :
- TP=1. Les couches linéaires n'ont pas d'all-reduce. L'all-reduce de vLLM choisit les algorithmes selon la taille des messages, donc TP ramènerait cette dépendance ; la recette refuse TP>1 au démarrage.
- La fusion EP est locale. Le all-to-all ne fait que déplacer des données. Les sorties des experts reviennent au rang propriétaire du token et sont accumulées en FP32 dans l'ordre des slots top-k, indépendamment de EP=8 vs 32 ou du rang qui répond en premier.
- CP ne fait aucune réduction. Les rangs voisins n'échangent que les états cachés aux frontières, et le KV compressé est all-gathered dans le groupe CP : concaténation, pas sommation.
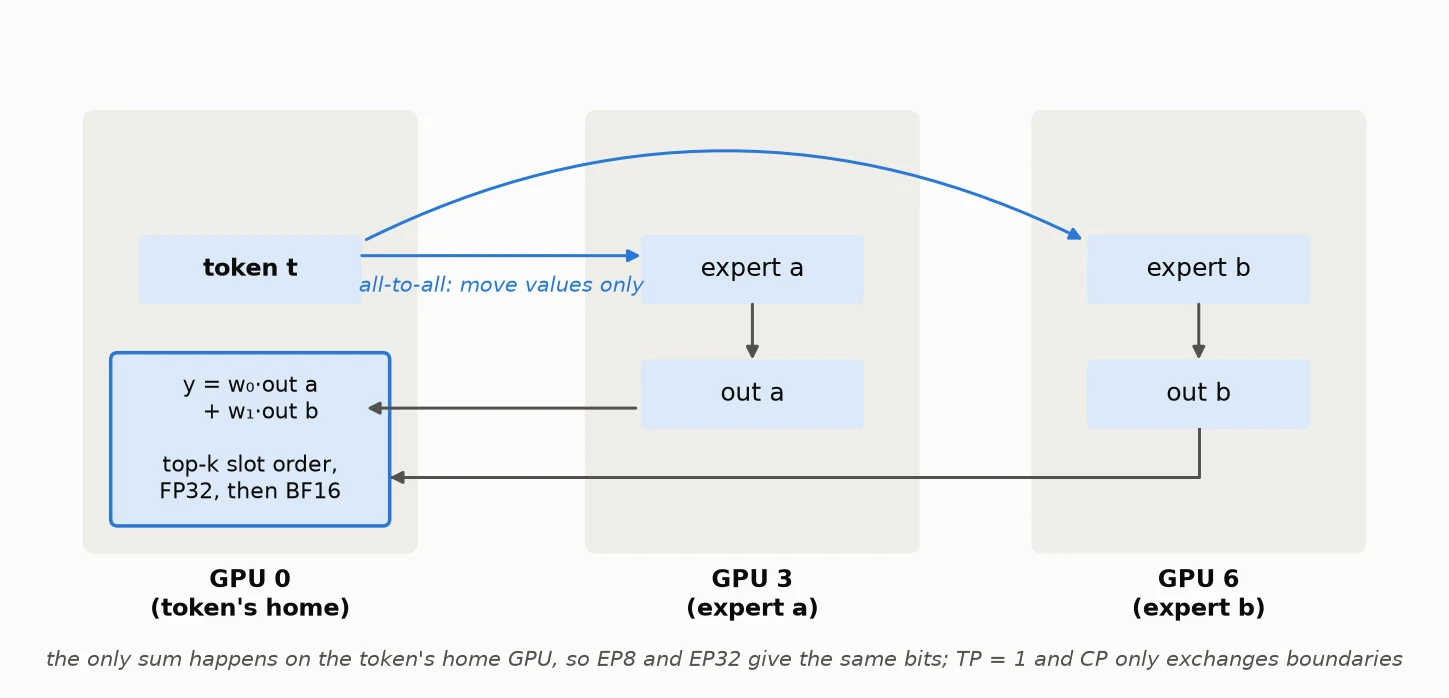
Le chemin d'un token : le all-to-all ne fait que déplacer des données, et la seule sommation a lieu sur le GPU propriétaire du token, en FP32 dans l'ordre des slots top-k, donc EP8 et EP32 donnent le même résultat.
Rendre le déplacement de données déterministe. En rollout, chaque rang envoie au plus un nombre fixe de tokens par appel et tous les rangs segmentent en lockstep, donc la forme de la communication est fixe. Seul LL implémente cela, et le mode normal de DeepEP désactive CUDA Graph quand DP>1, donc le rollout doit utiliser LL. En entraînement, le mode normal n'a pas d'ordre d'arrivée fixe, donc les métadonnées de routage sont envoyées une fois de plus et un hachage bit à bit associe chaque sortie d'expert à son token et à son slot.
Coût et récupération. Le mode LL exécute 43 couches × 2 = 86 all-to-alls sériels par étape qui ne peuvent pas se chevaucher avec le calcul. Les schémas de chevauchement inter-couches que nous avons essayés calculent avant que les entrées soient prêtes et cassent l'indépendance des lots. L'entrelacement de deux micro-lots (DBO) était 39 % plus lent : les poids experts de chaque couche sont lus deux fois, et les lectures de poids utilisent déjà 84 % de la bande passante HBM.
Nous avons fini par combler l'écart de communication sur le benchmark d'inférence. Vérifiez d'abord que les deux exécutions utilisent le même transport : nous avons perdu deux jours parce qu'un script avait épinglé le DeepEP de la version cohérente à Ethernet RDMA (RoCE) tandis que la ligne de base utilisait le MNNVL, bien plus rapide. Avec un transport identique et l'expert partagé sur un flux auxiliaire, la version cohérente était 3.2 % plus rapide que la ligne de base (16834 vs 16313 tok/s).
TP>1 et le context parallel de décode remettraient la réduction inter-GPU sur le chemin comparé et ne sont pas encore pris en charge.
4.6 CUDA Graph : conserver les graphes et les faire coexister avec la cohérence
Pourquoi les conserver. Le décode exécute des dizaines de petits kernels par couche et par étape à un token par requête, donc la surcharge de lancement dominerait ; nous conservons CUDA Graph pour atteindre l'objectif de performance. Les graphes entrent en conflit avec la cohérence bit à bit à trois endroits.
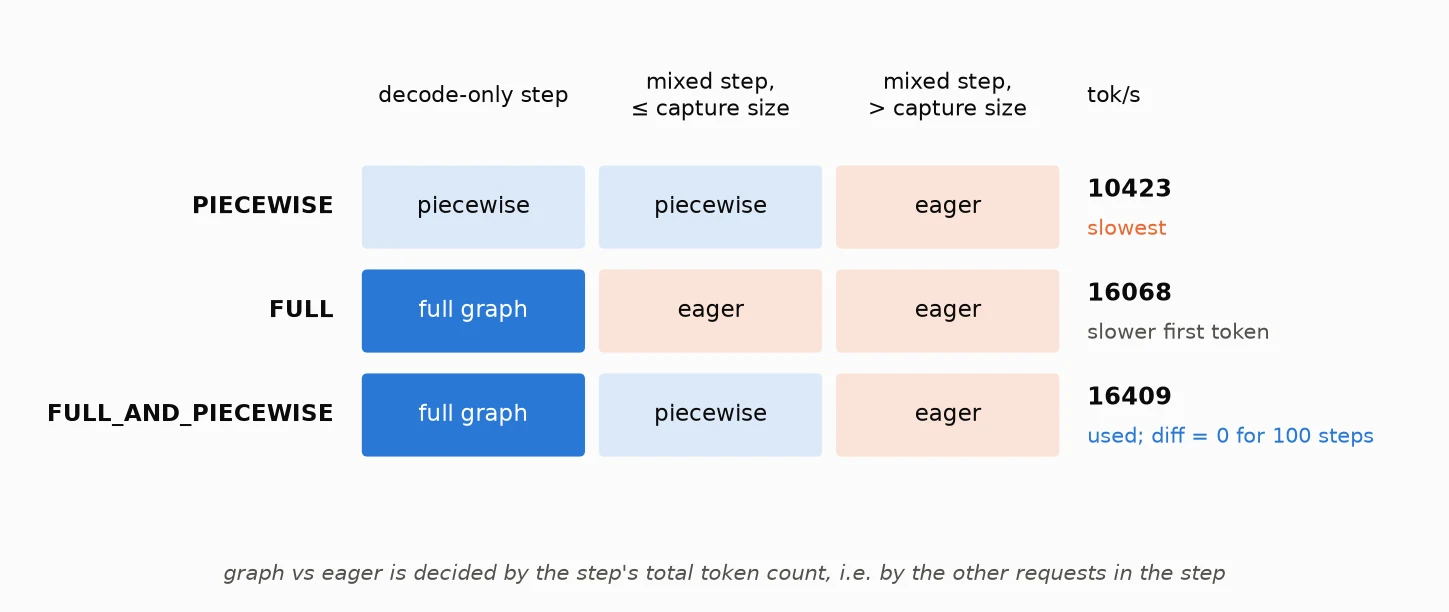
Le chemin emprunté par chaque mode pour trois types d'étape, avec le débit du benchmark d'inférence à droite. Une requête bascule entre graphe et eager selon son lot, donc les deux chemins doivent être identiques bit à bit.
Conflit 1 : graphe ou eager. Une étape s'exécute dans le graphe si son nombre total de tokens tient dans la taille de capture maximale, et en eager sinon, ce qui dépend des autres tokens de l'étape, donc les deux chemins doivent être identiques bit à bit. C'était notre première divergence : un raccourci indexeur à contexte court était figé dans le graphe à la capture en fonction de la longueur de l'entrée factice. Faire dépendre la vérification uniquement d'une borne supérieure statique a corrigé le problème.
Le mode compte aussi. PIECEWISE ne capture pas l'attention, et FULL sur DeepSeek-V4 ne capture que les étapes de pur décode. Sur le benchmark d'inférence, FULL_AND_PIECEWISE donne 16409 tok/s, FULL 16068 et PIECEWISE 10423 ; FULL exécute chaque étape mélangée au prefill en eager, faisant passer le time to first token de 764 ms à 1792 ms. Nous utilisons FULL_AND_PIECEWISE : graphes complets pour les étapes de pur décode, capture par morceaux pour les étapes mixtes ; le diff reste 0 sur l'exécution de 100 étapes.
Conflit 2 : pas de synchronisation hôte ni de formes dépendantes du lot dans le graphe. Ceci est compatible avec la cohérence, et beaucoup de conceptions servent les deux : l'indice d'ordonnancement du MoE utilise une capacité statique au lieu de relire les comptes de tokens par expert vers l'hôte (4.4) ; LL fixe la forme de la communication (4.5) ; les espaces de travail ne sont dimensionnés que par les limites du modèle, alloués avant la capture puis verrouillés ; les branches de raccourci à usage purement performance sont désactivées au moment de la capture.
Conflit 3 : les graphes capturent des adresses, les poids changent à chaque étape. Le rollout doit copier les nouveaux poids dans leur stockage d'origine et recalculer sur place les paramètres dérivés des poids, plutôt que d'allouer une nouvelle mémoire qui laisserait le graphe sur d'anciennes adresses. Correspondre à la première étape ne suffit pas, donc la compétence compare à nouveau après mise à jour, export et rechargement.
Coût. Les espaces de travail réservés à leur borne supérieure coûtent de la mémoire. Les autres récupérations de vitesse (suppression du débogage inutile de padding et du démarrage à froid du rollout, mise à zéro plus rapide du cache KV) s'appliquent aux deux exécutions ; la ligne de base doit aussi les obtenir, sinon le chiffre de perte de performance n'a pas de sens.
5. Réduire le coût d'ingénierie avec Agent + compétence
A et B peuvent coexister, mais la table maître de la Section 4 et les choix clés qu'elle contient exigent un jugement d'expert : quel backend est invariant au lot, que les choix discrets nécessitent des égalités alignées et un ordre, comment aligner la quantisation et l'ordre de fusion selon les différents modes de communication, et qu'un écart de communication requiert d'abord d'exclure une différence de transport. Un nouveau modèle, une nouvelle précision ou un nouveau matériel signifie repartir de zéro, donc C ne tient pas.
Après DeepSeek-V4-Flash, nous avons constaté que la plupart de ce travail se répartit en deux catégories, chacune avec un objectif mesurable :
- Amener le diff à 0. Corriger les poids et l'entrée, trouver le premier opérateur où les deux côtés divergent, le réduire à un repro minimal rejouable, le corriger, puis vérifier en entraînement réel. Les sorties sont comparées directement.
- Optimiser la performance en gardant le diff à 0. Profilez les points chauds, les opérateurs A/B individuels, et revérifiez la cohérence après chaque modification. Les accélérations qui changent les résultats ou qui n'apparaissent que dans des micro-benchmarks, et non lors d'un déploiement réel, ne comptent pas ; ralentir la référence pour réduire l'écart n'est pas autorisé.
Lire du code, tracer des chaînes d'appels, localiser des divergences, écrire des cas de reproduction, modifier des noyaux et relancer des régressions est un travail de longue haleine adapté à un agent, dont le succès est déterminé par une comparaison de cohérence et une mesure des performances.
Nous avons regroupé cela dans la skill train-inference-consistency: elle indique à un agent quoi faire dans quel ordre et ce que chaque étape doit atteindre pour être validée, de sorte que le processus se transpose à d'autres modèles.
La skill comporte 11 portes (C0–C10) avec des conditions de réussite explicites. Pour accélérer le démarrage à froid, nous prélevons d'abord quelques couches du modèle complet pour en faire un petit modèle, y résolvons la plupart des problèmes, puis passons au modèle complet. Cinq étapes :
- Fixer l'objectif et la baseline (C0–C1). Lister les modules du modèle avec leur précision et leur parallélisme. Régler la version ordinaire, non cohérente (la baseline) pour atteindre des performances élevées normales, en vue de la revue humaine. Elle sert de dénominateur pour « de combien la version cohérente est plus lente ».
- Rendre l'inférence auto-cohérente sur un petit modèle (C2–C4). Le petit modèle (généralement 4–6 couches extraites du modèle complet) doit contenir chaque classe d'opérateur, conserver l'interaction entre couches adjacentes, et correspondre en taille par couche et en quantification, afin de reproduire la plupart des problèmes numériques locaux. La profondeur complète, le contexte long, la disposition multi-GPU et la pression mémoire doivent néanmoins être validés sur le modèle complet. D'abord, rendre le moteur d'inférence interne cohérent : une requête donne le même résultat seule et dans un lot, et le traitement de l'entrée entière correspond au traitement token par token. Parallèlement, chercher les problèmes structurels qui ralentiraient la version cohérente.
- Connecter l'entraînement (C5–C7). L'entraînement appelle les mêmes opérateurs que l'inférence, recalcule les données générées par l'inférence et compare token par token ; en cas d'écart, comparer couche par couche pour identifier la première couche divergente. Ajouter ensuite la passe backward et vérifier les gradients par rapport à une implémentation de référence indépendante du code testé : un forward cohérent n'implique pas des gradients corrects.
- Exécuter le RL, puis passer au modèle complet (C8–C9). Sur le petit modèle, exécuter deux mises à jour consécutives dans le véritable cadre d'entraînement, en comparant sous la même version des poids avant et après chacune. Après revue humaine, passer au modèle complet et monter en charge par paliers, y compris la vérification de la première étape après restauration de checkpoint.
- Récupérer les performances (C10). Optimiser les opérateurs les plus coûteux un par un, en revérifiant la cohérence à chaque fois, puis effectuer une comparaison appariée contre la baseline sur l'image de livraison.
Deux conceptions comptent le plus. Premièrement, deux agents font avancer en parallèle la baseline et la cohérence: l'un rend la baseline rapide, l'autre construit la version cohérente. La baseline réglée est gelée pour la revue humaine, de sorte que l'agent ne peut pas la ralentir pour réduire l'écart. Deuxièmement, nos pièges sont inscrits dans le processus: le programme en cours d'exécution doit correspondre au code source lu ; les checkpoints exigent la vérification de la première étape après restauration, pas seulement une sauvegarde ; chaque conclusion de performance exige une baseline équitable et des données brutes traçables ; avant de comparer les goulots d'étranglement de communication, confirmer que les deux exécutions utilisent le même transport (la leçon du 4.5).
La skill réduit le coût de la localisation et de la régression (économies non encore quantifiées ici) ; elle ne remplace pas le jugement humain : les humains examinent toujours la baseline, les compromis de précision et la recette. Un exemple est la dérive de routage avec plusieurs mises à jour par étape : l'agent a construit un reproducteur à petite échelle à partir du symptôme, mené des expériences discriminantes et éliminé des hypothèses, et un humain a décidé de passer à 1 mise à jour par étape.
6. Transfert : Nemotron, une architecture hybride Mamba + NVFP4
Nous avons ensuite testé la recette de référence et la skill sur un modèle structurellement très différent.
Nemotron-3.5-Lightning-30B-A3B (NVFP4) est un hybride Mamba-2 / attention / MoE (experts routés NVFP4 W4A16, projections Mamba FP8, cache KV FP8 pour l'attention) sur GB200. La baseline utilise l'entraînement NVFP4 QAT (règle de quantification et export de NVIDIA ModelOpt) + R3 route replay ; la version cohérente partage le forward de vLLM, sans route replay. Les deux exécutions utilisent des master weights BF16 et 1 mise à jour par étape.
Les structures récurrentes ont des précédents. Dans la communauté vLLM, Alexander Jiang et l'équipe SkyRL ont conçu le chunkwise-parallel recurrent (CPR) dans IsoExec pour le Gated DeltaNet (GDN) de Qwen3.5-35B-A3B : il conserve la forme récurrente mais calcule en parallèle par chunks, de sorte que l'entraînement, le prefill et le decode partagent un même ordre d'arrondi, et son unified model donne à l'entraînement et à l'inférence une seule définition de modèle et un seul ensemble de kernels alignés. Le « zero mismatch » d'IsoExec vaut dans son contrat d'exécution ; de bout en bout, il rapporte néanmoins une infime différence de logprob non nulle (différence absolue moyenne autour de 1e-7), contrairement au « bitwise identical » de cet article. Mamba-2 est le même type de récurrence linéaire. Nous faisons en sorte que le decode rejoue exactement l'arithmétique par chunks du prefill au lieu de sa propre récurrence mono-pas, et l'entraînement importe les mêmes opérateurs que l'inférence, comme dans le unified model. L'agent + la skill ont réalisé cet alignement.
Dans vLLM, chaque opérateur pouvant dépendre de la composition du lot reçoit une implémentation batch-invariant, et l'entraînement (un fork léger de Megatron-LM) les importe :
| Opérateur | Version cohérente |
|---|---|
| Scan SSD Mamba-2 | le décode rejoue exactement l'arithmétique par chunks du préremplissage, configuration autotune fixe, état en fp32 |
| Attention | FlashAttention avec split-KV fixe, nombre de splits indépendant du batch |
| Experts routés (NVFP4 W4A16 : poids en 4 bits, activations en 16 bits) | GEMM groupé CuTe-DSL, tactique unique, pas de split-K, fusion fp32 dans l'ordre des slots |
| MoE all-to-all | communication unilatérale, ordre de fusion fixe |
| GEMM du routeur | Matmul persistant invariant par batch, sortie en fp32 |
| Norme / quantization FP8 | Kernels invariants par batch unifiés ; les fusions modifiant les valeurs sont interdites |
Résultats : entraînement sur SWE-bench Pro
Nous exécutons du RL agentique sur SWE-bench Pro dans des sandboxes distantes : 32 tâches × 8 trajectoires par étape, environ 57K tokens par trajectoire en moyenne, GRPO, 8 nœuds GB200 par exécution. L'ensemble d'entraînement est constitué des 375 tâches SWE-bench Pro sur lesquelles les 4 tentatives échantillonnées du modèle de base n'étaient ni toutes correctes ni toutes erronées et où le gold patch passe dans notre sandbox ; les scores ci-dessous sont donc des récompenses d'entraînement sur ce sous-ensemble. Les deux exécutions utilisent la même image et la même recette, sans corrections telles que TIS ou MIS. Avec 1 mise à jour par étape, la KL entre les logprobs de rollout pré-mise à jour et la recomp calculée côté entraînement est la KL train-inférence de cette étape.
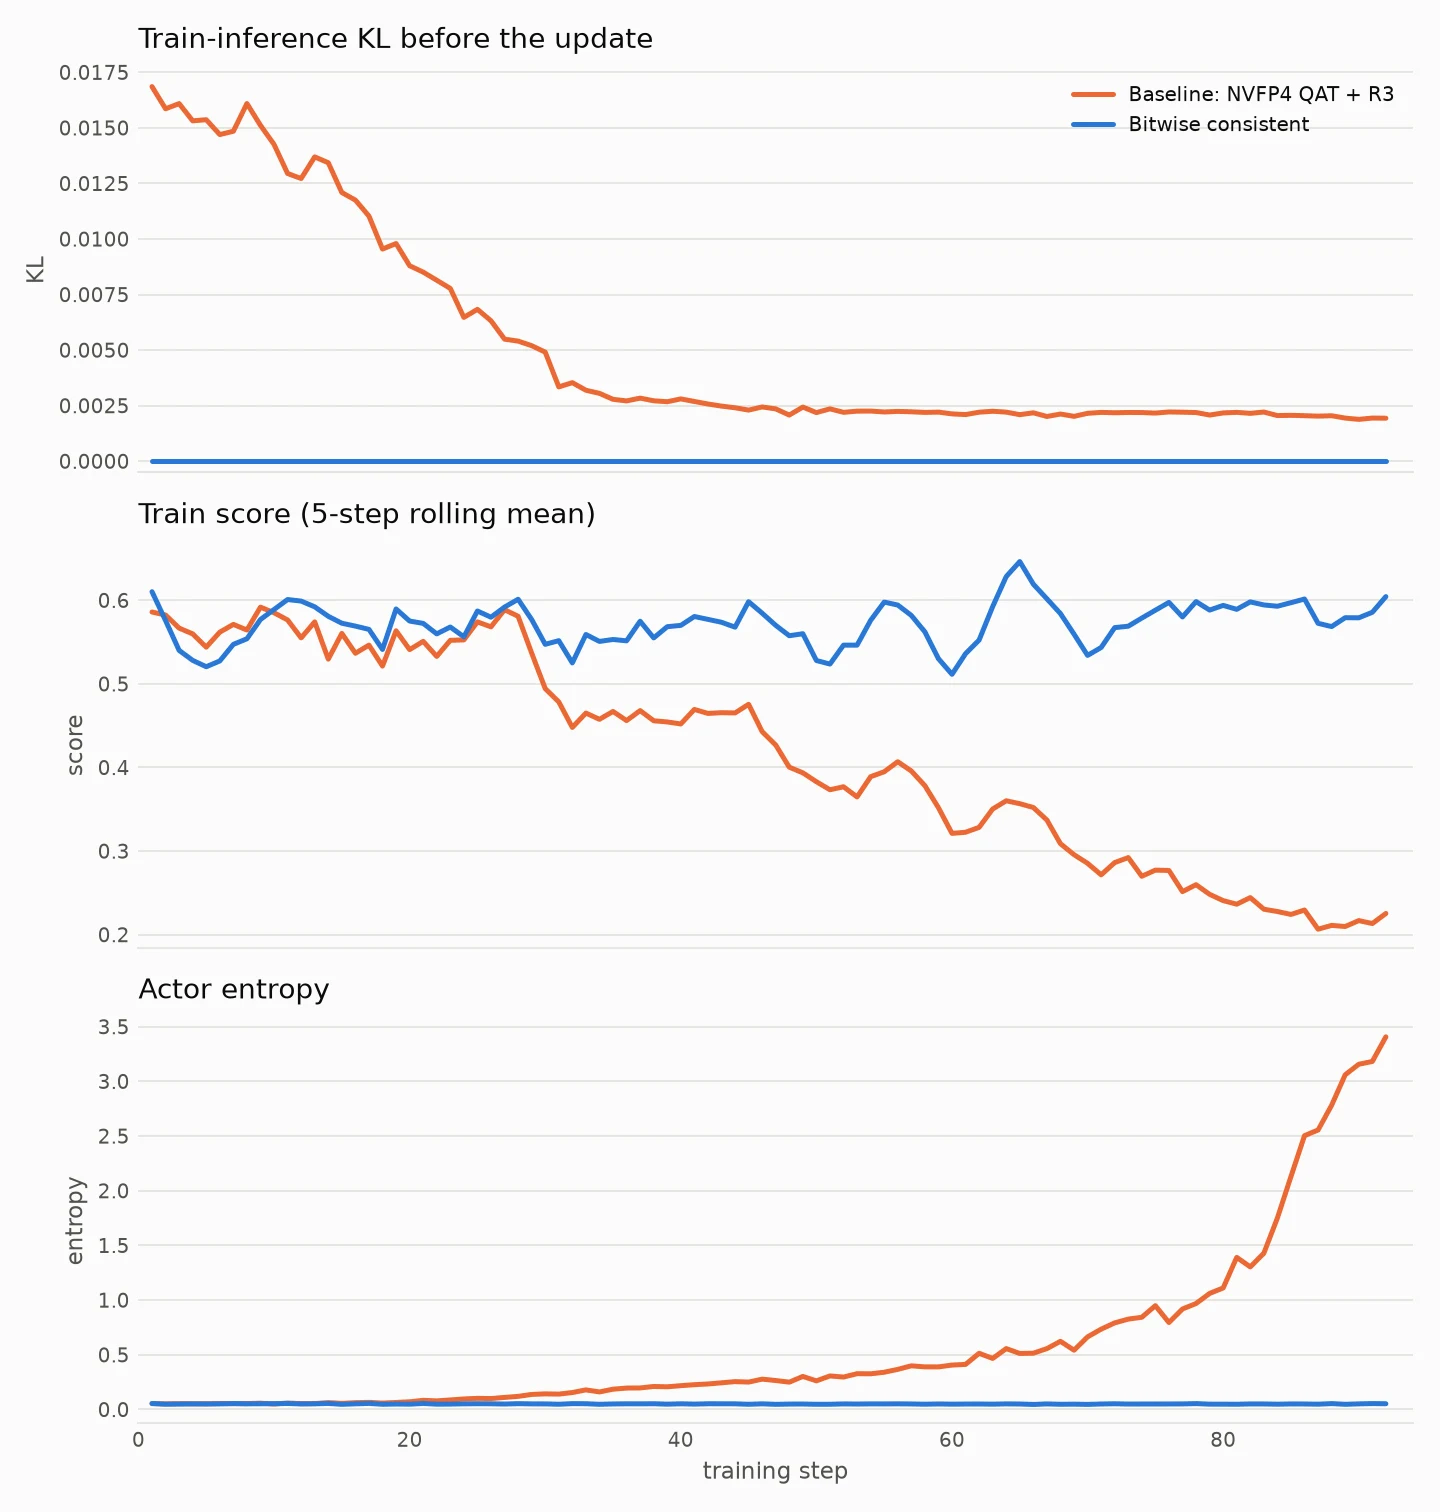
En haut : KL train-inférence par étape ; au milieu : score d'entraînement (moyenne mobile sur l'étape courante et les 4 précédentes) ; en bas : entropie de l'acteur. Orange : baseline ; bleu : version consistante. À l'étape 10 de la version consistante, seules quelques trajectoires sont revenues de la sandbox, son score est donc exclu.
- Version consistante: la KL train-inférence est exactement 0 à chaque étape, l'entropie reste autour de 0,05, et le score passe de 0,56 (10 premières étapes) à 0,59 (10 dernières), sans baisse.
- Baseline: la KL train-inférence chute d'environ 0,015 à ~0,002, mais l'entropie monte de 0,05 à 2,6 et le score passe de 0,56 à 0,22 (10 premières étapes contre 10 dernières).
- vitesse de rollout: sur les 30 premières étapes, tant que les deux exécutions sont saines, le débit de rollout de la version consistante est de 87.5 % de celui de la baseline, soit seulement 12.5 % plus lent.
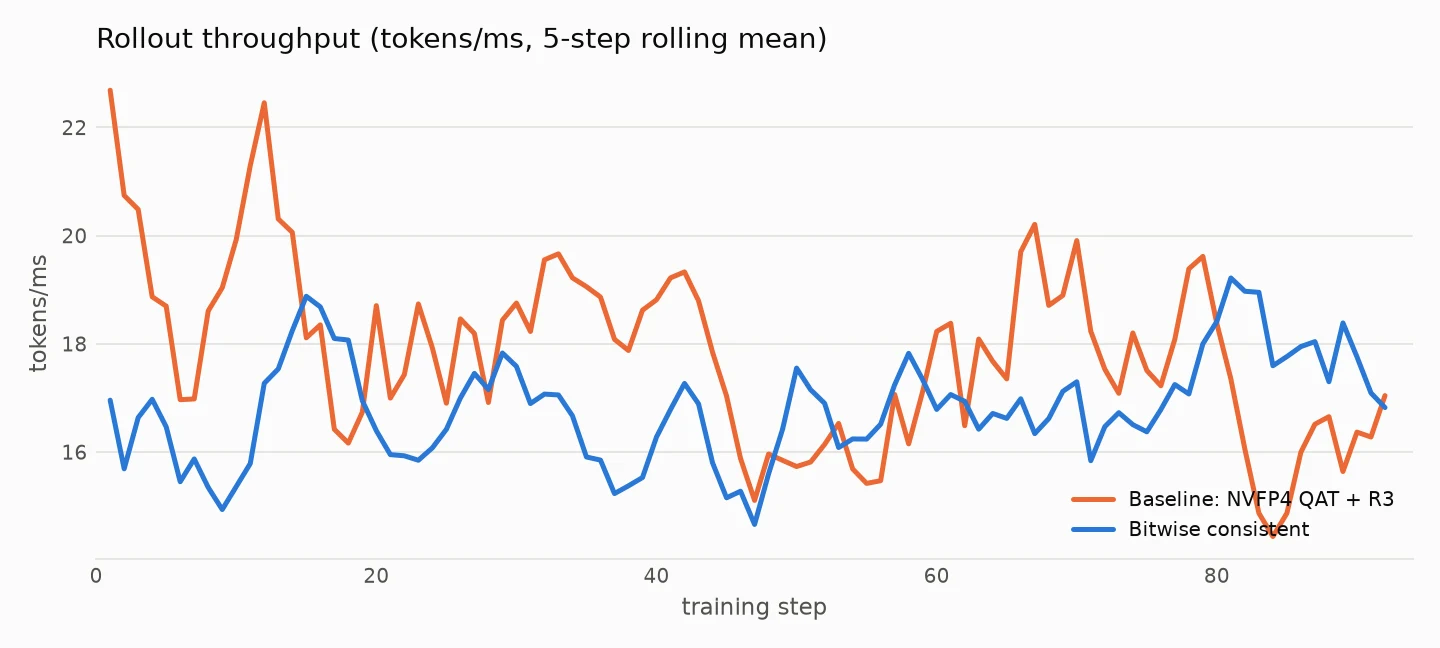
Débit de rollout par étape (token/ms, moyenne mobile sur l'étape courante et les 4 précédentes). Orange : baseline ; bleu : version consistante.
7. Open source
Nous publions ceci en open source afin que d'autres puissent atteindre la cohérence train-inférence en dépendant moins d'ingénieurs seniors vérifiant opérateur par opérateur, en utilisant la compétence, le code prêt à l'emploi et un agent sur leur propre modèle. La publication comprend :
- compétence train-inference-consistency: le workflow complet (C0–C10), dix guides et des pratiques clés telles que la comparaison des logprobs et la vérification croisée des gradients ;
- DeepSeek-V4: une véritable recette de RL on-policy atteignant 0 diff sur Megatron et vLLM, verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (poids maîtres BF16, quantifiés en NVFP4 de déploiement lors du forward d'entraînement et à la synchronisation des poids) :
- inférence vLLM bitwise-consistante alignée sur l'entraînement : aoshen02/vllm#85;
- Un acteur d'entraînement aligné avec vLLM : aoshen02/Megatron-LM#7;
- Deux modifications de verl : aoshen02/verl#11;
- Recette de cohérence train-inférence et Dockerfile d'image unifiée : aoshen02/verl#12.
Les issues, PRs et retours d'utilisation de la compétence sur votre propre modèle sont les bienvenus.
Ensuite : la cohérence train-inférence pour DeepSeek-V4.1 a atteint 0 diff ; l'optimisation des performances est en cours et fera l'objet de son propre billet.
Remerciements
Merci à (organisations par ordre alphabétique) :