
Notre dernière version, Apertus 1.5, étend les modèles Apertus 1.0 de 8B et 70B avec la compréhension d'images/audio, un mode de réflexion optionnel, une fenêtre de contexte quatre fois plus longue, un meilleur suivi des instructions et une utilisation améliorée des outils. La mise à jour les poids des modèles 8B et 70B ont été publiés sur Hugging Face le 24 juillet 2026 sous une licence Apache 2.0. De plus amples détails sont désormais disponibles auprès du projet Rapport technique« et résumé ici. »
Apertus 1.5 est un pré-entraînement continu du modèle de première génération : ajout de 4 trillions de jetons de données d'entraînement textuelles et multimodales au modèle 8B et de 2 trillions de jetons au modèle 70B, pour un total de 19T et 17T respectivement. Comme pour chaque version d'Apertus, les modèles sont entièrement ouverts : ouverts poids, ouvert données, ouvrez valeurs, et la formation complète détails.
Améliorations clés
- Compréhension multimodale native : Apertus 1.5 accepte les images et l'audio en plus du texte, intégrant documents, diagrammes et photos dans la conversation. Les modèles peuvent également traiter le langage parlé, bien que cela reste expérimental.
- Mode de réflexion : Les modèles peuvent être basculés dans un mode de réflexion pour raisonner sur l'entrée avant de répondre, ce qui améliore les performances sur les problèmes de raisonnement.
- Contexte long : La fenêtre de contexte passe à 262,144 tokens, soit une augmentation d'un facteur 4 par rapport à Apertus 1.0.
- Amélioration du suivi des consignes : Une meilleure adhésion aux instructions qu'Apertus 1.0 donne des réponses plus prévisibles et plus précises.
- Utilisation améliorée des outils : Les modèles sont entraînés pour une meilleure intégration des outils, permettant une utilisation plus efficace des outils externes et des API.
- Open Values : Une adhésion renforcée à la Charte Apertus, qui apporte de la transparence aux valeurs et principes du modèle.
Processus d'entraînement
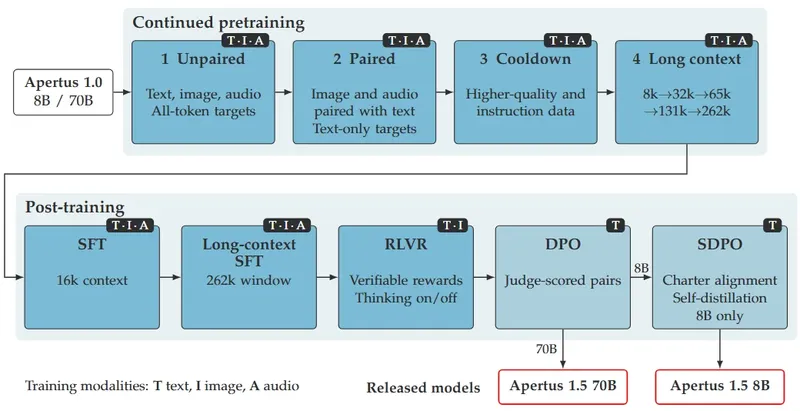
 Le pipeline d'entraînement complet d'Apertus 1.5
La multimodalité à travers le tokenizer
Nous introduisons la multimodalité dans les modèles v1.5 de manière à fusion précoce (early-fusion), où les images et l'audio entrent dans Apertus sous forme de tokens discrets dans la même séquence que les tokens de texte, au lieu d'utiliser un encodeur de vision séparé. Les images sont tokenisées avec le Emu3.5 tokenizer (une image 512×512 devient 1,024 tokens) et l'audio avec WavTokenizer (40 tokens par seconde). Nous ne faisons qu'étendre le vocabulaire, l'architecture reste donc inchangée et l'entraînement s'exécute à la vitesse du texte seul. Les modèles comprennent les images et l'audio mais génèrent uniquement du texte.

Pré-entraînement
À partir d'Apertus 1.0, nous poursuivons le pré-entraînement en quatre étapes :
- Non apparié : du texte plus des images et de l'audio autonomes, afin que le modèle apprenne les nouvelles modalités.
- Apparié : des paires image–légende et audio–transcription, afin de les aligner avec le langage.
- Cooldown : des données de meilleure qualité avec plus de mathématiques et de code.
- Contexte long : la fenêtre s'étend progressivement de 8k à 262k tokens.
Dans l'ensemble, plus de la moitié des tokens d'entraînement sont du texte seul, ce qui préserve les capacités linguistiques d'Apertus 1.0. Les données textuelles sont actualisées avec des sources telles que FineWeb2-HQ+, FinePDFs et Nemotron-CC. Toutes les nouvelles données, multimodales comprises, répondent aux mêmes critères qu'avant : publiquement disponibles, sous licence permissive, et avec le respect rétroactif des opt-outs de robots.txt. Chaque source est répertoriée dans apertus-data-transparency.
Post-entraînement
Le post-entraînement se déroule en cinq étapes : SFT → SFT en contexte long → RL → DPO → alignement sur la charte (SDPO).
- SFT sur 3.7M d'échantillons de texte plus des données d'image et de parole. Les traces de raisonnement ne sont ajoutées qu'aux invites que le modèle ne sait déjà pas résoudre sans elles. Les données d'utilisation d'outils sont restreintes aux trajectoires vérifiées par exécution. Nous publions le mélange SFT textuel que nous avons utilisé sur Hugging Face.
- SFT en contexte long à la fenêtre complète de 262k restaure la capacité en contexte long que le SFT en contexte court érode.
- RL avec récompenses vérifiables (RLVR) sur environ 350k invites de mathématiques, de code, de suivi d'instructions, multilingues et de vision, en mélangeant le mode réflexion activé et désactivé.
- DPO avec des paires de préférences notées par un juge améliore la qualité du chat, l'utilisation d'outils et la sécurité. Nous publions le pool de préférences et les paires d'entraînement.
- SDPO aligne le modèle sur la Charte Apertus grâce aux retours d'un juge et à l'auto-distillation.
Résultats d'évaluation
Parallèlement à l'extension des capacités du modèle, nous avons également considérablement élargi la portée des évaluations. Au-delà des évaluations textuelles existantes utilisées pour Apertus 1.0, nous avons ajouté des évaluations multimodales (image & audio) et des évaluations en mode de réflexion.
Les évaluations multimodales sont réalisées via le pipeline MLLM-eval-suite , qui fusionne deux grands cadres d'évaluation multimodale lmms-eval et VLMEvalKit. Nous avons également ajouté une série de benchmarks textuels, ainsi que des benchmarks étendus pour la traduction et les capacités multilingues, la sécurité et l'utilisation d'outils. Ceux-ci sont disponibles dans notre dépôt d'évaluation post-training évaluation repository, basé sur un lm-evaluation-harness fork.
Bien qu'il accuse encore un retard sur les modèles open-weight de pointe, la nouvelle version a également amélioré de manière significative les performances en codage et en suivi d'instructions, avec Apertus 1.5 8B surpassant les modèles open-weight de taille similaire sur les tâches IF et multilingues. Le mode de réflexion améliore encore les performances sur des benchmarks exigeants en raisonnement comme AIME. La performance multimodale du modèle est plus proche de celle de Gemma 4 12B et d'autres modèles open-weight actuels. La performance multimodale d'Apertus 1.5 est compétitive en compréhension spatiale parmi les modèles open-weight et en compréhension de documents/graphiques parmi les modèles open-source.
Nous remercions également nos collaborateurs et évaluateurs externes pour leur aide dans le benchmarking efficace des capacités d'Apertus. En particulier, Apertus 1.5 montre de solides performances sur les tâches de droit suisse, étant au niveau des principaux modèles open-weight (blog, code). De plus, sur le Last Translation Benchmark, Apertus 1.5 8B présente des capacités de traduction automatique qui égales celles de GPT-OSS-20B et surpassent des modèles comme Claude Haiku 4.5 ou Google Translate (leaderboard, paper).
Evaluation Cards : Apertus ❤️ EvalEval
Apertus collabore avec la EvalEval Coalition pour garantir un benchmarking totalement transparent et reproductible. Nous publions les résultats d'Apertus 1.5 dans le schéma Every Eval Ever (EEE) , un format partagé qui enregistre non seulement les scores, mais aussi qui a exécuté l'évaluation, comment le modèle a été accédé, les paramètres de génération, et comment chaque métrique doit être interprétée : des détails qui manquent habituellement aux classements et qui expliquent souvent pourquoi des scores en apparence similaires diffèrent.
Les résultats sont présentés dans la carte d'évaluation (Eval Card) ci-dessous, qui combine les données d'exécution avec les métadonnées du benchmark et du modèle en un seul enregistrement interprétable, et sont également disponibles via Hugging Face Community Evals. Il s'agit de la même infrastructure que celle utilisée par l' UK AI Security Institute pour publier ses évaluations en accès ouvert. Comme nos évaluations de texte s'exécutent sur notre fork public de lm-evaluation-harness, qu'EEE prend en charge avec un convertisseur dédié, n'importe qui peut les relancer et comparer ses chiffres aux nôtres avec des paramètres identiques.
Le reporting d'évaluation structuré compte également au-delà de la recherche. EvalEval a établi une correspondance entre les Evaluation Cards et les exigences de gouvernance de l'IA, notamment l'article 55 de l'AI Act de l'UE et le GPAI Code of Practice, et a constaté que le schéma EEE peut représenter 56 des 60 éléments de reporting d'évaluation que ces cadres exigent. Cela correspond à la manière dont nous publions déjà Apertus : en plus des modèles, nous publions un Public Summary du Training Content et, à titre volontaire, un document Code of Practice . Les enregistrements d'évaluation lisibles par machine constituent une étape naturelle suivante : faciliter la recherche, l'interprétation et la comparaison des preuves derrière un modèle pour les régulateurs, les déployeurs et les chercheurs.
Nous nous engageons à promouvoir une évaluation reproductible et transparente grâce aux Eval Cards et au schéma EEE, et encourageons les autres développeurs de modèles à rapporter leurs résultats de la même manière, afin que les scores puissent être comparés entre modèles et organisations.
Reproductibilité d'Apertus 1.5
Toutes les recettes, ablations et mélanges de données sont documentés dans le Technical Report. Nous visons à populariser le développement ouvert de modèles en rendant le processus d'entraînement de la v1.5 public et accessible. Les checkpoints intermédiaires sont hébergés dans notre collection Hugging Face Apertus 1.5, incluant les poids de base, SFT, RLVR et DPO, ainsi que nos mélanges de données d'entraînement curatés/jeux de données personnalisés dans la collection de jeux de données Apertus 1.5. Leur partage permet aux chercheurs d'étudier comment chaque étape modifie le comportement du modèle.
Le rapport couvre de nombreuses ablations sur l'effet des données de post-training à différentes étapes, où nous avons observé que les données multimodales mélangées aux données textuelles pendant le SFT contribuent à améliorer toutes les modalités. Nous constatons également que les bénéfices des traces de raisonnement multimodales survivent à l'apprentissage par renforcement textuel ultérieur : en partant d'un checkpoint SFT entraîné avec des traces multimodales, le RL améliore les mathématiques davantage qu'en partant d'un checkpoint purement textuel, et l'avantage sur les tâches de raisonnement persiste tout au long de l'entraînement.
| Modèles | 8B | 70B |
|---|---|---|
| Pré-entraînement (base long-context) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Finetuning supervisé (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Apprentissage par renforcement (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Alignement des préférences (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (final) |
| Alignement avec la charte (SDPO) | Apertus-v1.5-8B (final) | – |
| Étape | Données | Code / recette |
|---|---|---|
| Pré-entraînement : étapes 1–2 (non appariées, appariées) | Toutes les sources avec versions et licences dans apertus-data-transparency; recettes de traitement de la vision et de l'audio dans multimodal-data | Megatron-LM, scripts de lancement dans pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (y compris le générateur de données entrelacées parole–texte) |
| Pré-entraînement : étape 3 (cooldown) | apertus-data-transparency; jeux de données d'images organisés NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, scripts de lancement dans pretrain-code |
| Extension de contexte long | apertus-data-transparency; tâches de contexte long synthétiques dans LongContextQA | Megatron-LM, scripts de lancement dans pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (mélange SFT multimodal listé dans le rapport) | posttraining-data, Megatron-LM (scripts de lancement SFT) |
| SFT à contexte long | Sous-ensembles du mélange SFT (listés dans le rapport), plus LongContextQA tâches | Megatron-LM |
| RL (RLVR) | Mélange listé dans le rapport | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (complétions annotées), Apertus-v1.5-Preference-Data (paires) | posttraining, verl |
| SDPO (alignement selon la charte, 8B uniquement) | gretelai/gretel-safety-alignment-en-v1 | auto-distillation |
Disponibilité du modèle
Proton Lumo et Infomaniak Euria sont deux applications largement utilisées qui ont récemment intégré Apertus 1.5. Ces déploiements sont répertoriés dans la Vitrine communautaire entre autres - voir ce fil de discussion pour un aperçu.
L'accès à Apertus 1.5 sous forme d'API pour les développeurs a été annoncé par un certain nombre de fournisseurs, notamment Swisscom, Infomaniak, Phoeniqs, et d'autres entreprises listées dans notre guide de disponibilité générale. Le rapport fournit également des détails sur la manière dont nous travaillons avec des évaluateurs externes pour tester et préparer les modèles.
Les instructions techniques pour exécuter les modèles se trouvent dans les fiches de modèle des versions Apertus sur Hugging Face et dans notre guide de démarrage rapide.
Comment participer
Merci d'avoir lu cet article de blog et de faire partie de notre communauté ! Nous venons de célébrer cinq millions de téléchargements dans nos statistiques Hugging Face 🤗 et nous ne ralentissons pas. Lors du récent AI+X Summit à Zurich, notre équipe a annoncé la feuille de route pour Apertus 2.0: architecture sparse/MoE, ~600B de paramètres au total, calendrier d'entraînement étendu, avec les agents, les mathématiques et le codage comme priorités.
En résumé : nous vous invitons à lire notre rapport, télécharger les modèles, explorer les checkpoints intermédiaires, affiner les poids et reproduire nos évaluations. Les questions qui ne sont pas déjà couvertes dans nos publications ou dans la FAQ du site web sont toujours les bienvenues, et nous serions également ravis de savoir quels sujets seraient les plus utiles à la communauté pour de futures analyses approfondies.
Si vous développez avec Apertus ou l'utilisez, veuillez remplir le formulaire Showcaseet nous contacter via les options de notre page Contact. Nous nous réjouissons de mettre en avant davantage de travaux, de découvrir ce que vous construisez et d'entendre comment Apertus peut être amélioré !
Citation
Project Apertus, et al. « Apertus 1.5: From Open Text Models to Open Multimodal Reasoners. » arXiv:2610.15542. Preprint, arXiv, 11 octobre 2026. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}