
Réflexion
Résumé
Timestral, première famille de modèles de fondation pour séries temporelles de Mistral, fournit des prévisions probabilistes multivariées de pointe avec seulement 209M de paramètres, surpassant des modèles plus grands sur les benchmarks clés tout en prenant en charge les covariables passées et futures. Disponible en quatre tailles (de 5M à 209M de paramètres), il équilibre précision et efficacité, s'exécutant efficacement sur CPU et excellent en prévision zéro-shot pour des domaines variés. Le modèle combine pré-entraînement synthétique, attention sensible aux covariables et apprentissage en contexte long, avec des options de fine-tuning pour l'adaptation à un domaine via Mistral Forge.
Aujourd'hui, nous publions Timestral, notre première famille de modèles de fondation pour séries temporelles. Notre plus grand modèle, avec seulement 209M de paramètres, se classe premier sur les trois principaux benchmarks publics du domaine, GIFT-Eval, TIME et fev-bench, surpassant le précédent état de l'art avec seulement les deux tiers des paramètres du modèle précédent.
Timestral fournit des prévisions probabilistes multivariées et prend en charge les covariables passées uniquement et connues du futur. Notre famille de modèles se situe sur la frontière de Pareto entre précision de prévision et taille de modèle, offrant des performances de premier plan à chaque taille. Les résultats ont été soumis aux classements GIFT-Eval et TIME.
Modèles de fondation pour séries temporelles (TSFM)
Les séries temporelles sont l'un des types de données les plus courants en entreprise, de la télémétrie des capteurs aux métriques d'observabilité. Les prévisions qui en découlent éclairent les décisions en matière de planification de capacité, d'énergie, de chaînes d'approvisionnement, de risque et de maintenance.
Les usines industrielles prévoient les capteurs de process en fonction du calendrier de production, détectent la dérive des équipements avant leur défaillance et planifient la capacité et les pièces de rechange sur des milliers d'actifs. Les équipes financières prévoient les flux, les volumes et la volatilité pour éclairer les positions, la couverture et la trésorerie sur des milliers de comptes.
Les modèles classiques tels qu'ARIMA et la régression linéaire restent des outils bien établis pour la prévision de séries temporelles. Ces modèles sont généralement ajustés sur une seule série et n'apprennent qu'à partir de l'historique de cette série.
Les modèles d'apprentissage profond tels que PatchTST ajoutent la capacité d'apprendre des motifs non linéaires sur de nombreuses séries liées, mais ils sont généralement encore entraînés from scratch sur chaque jeu de données, de sorte que ce qu'ils apprennent ne se transfère pas à de nouveaux domaines.
Les modèles de fondation pour séries temporelles apportent l'approche du pré-entraînement aux séries temporelles. Entraîné sur un corpus vaste et diversifié, notre modèle apprend des motifs qui se transfèrent d'une série à l'autre, réalisant des prévisions zéro-shot sur des données jamais vues, même dans des domaines où les données sont rares.
Résultats des benchmarks
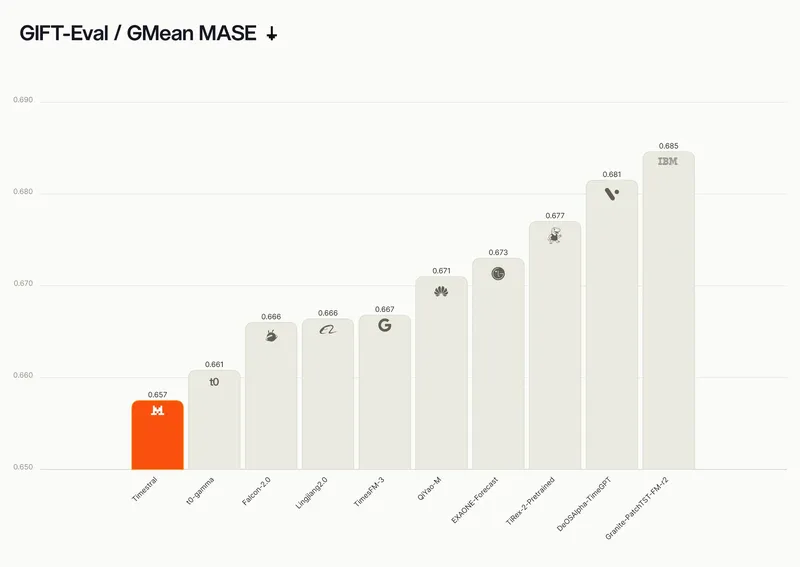
Nous avons évalué Timestral sur les trois principaux benchmarks publics de prévision : GIFT-Eval, TIME et fev-bench. Parmi les modèles pré-entraînés zéro-shot, il se classe premier sur les cinq métriques. Ces résultats proviennent d'un seul checkpoint, sans ensembling.
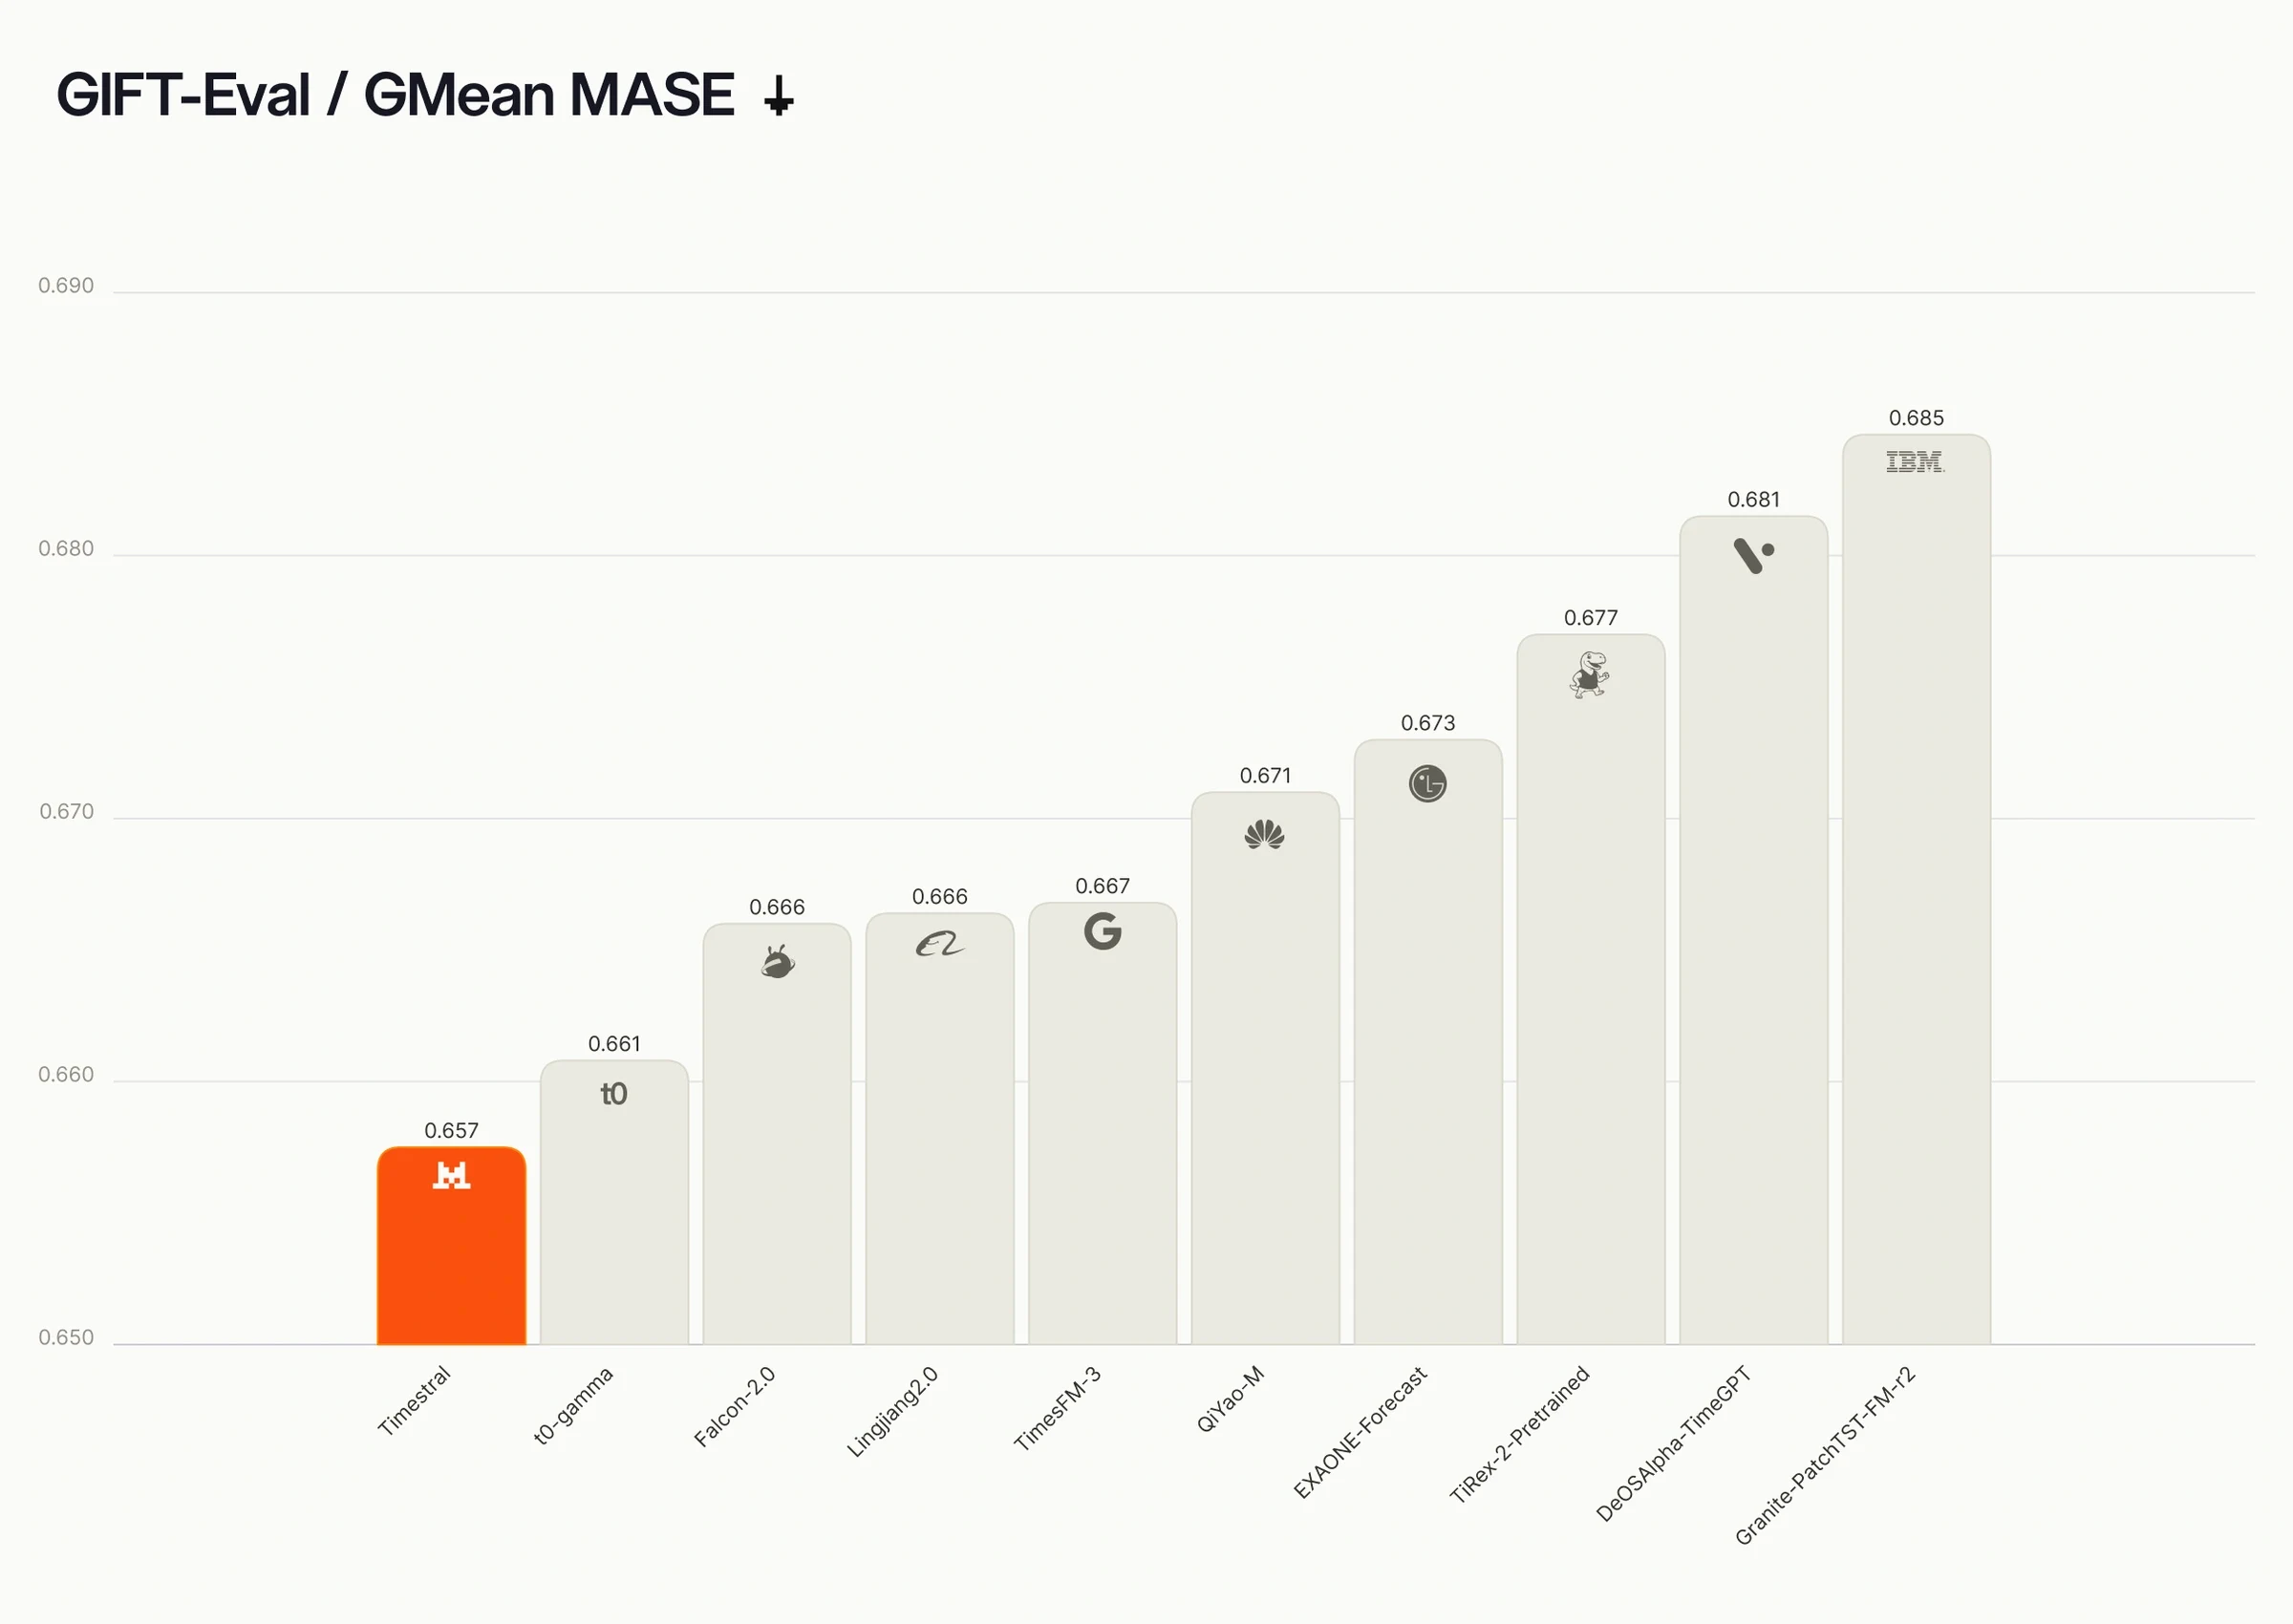
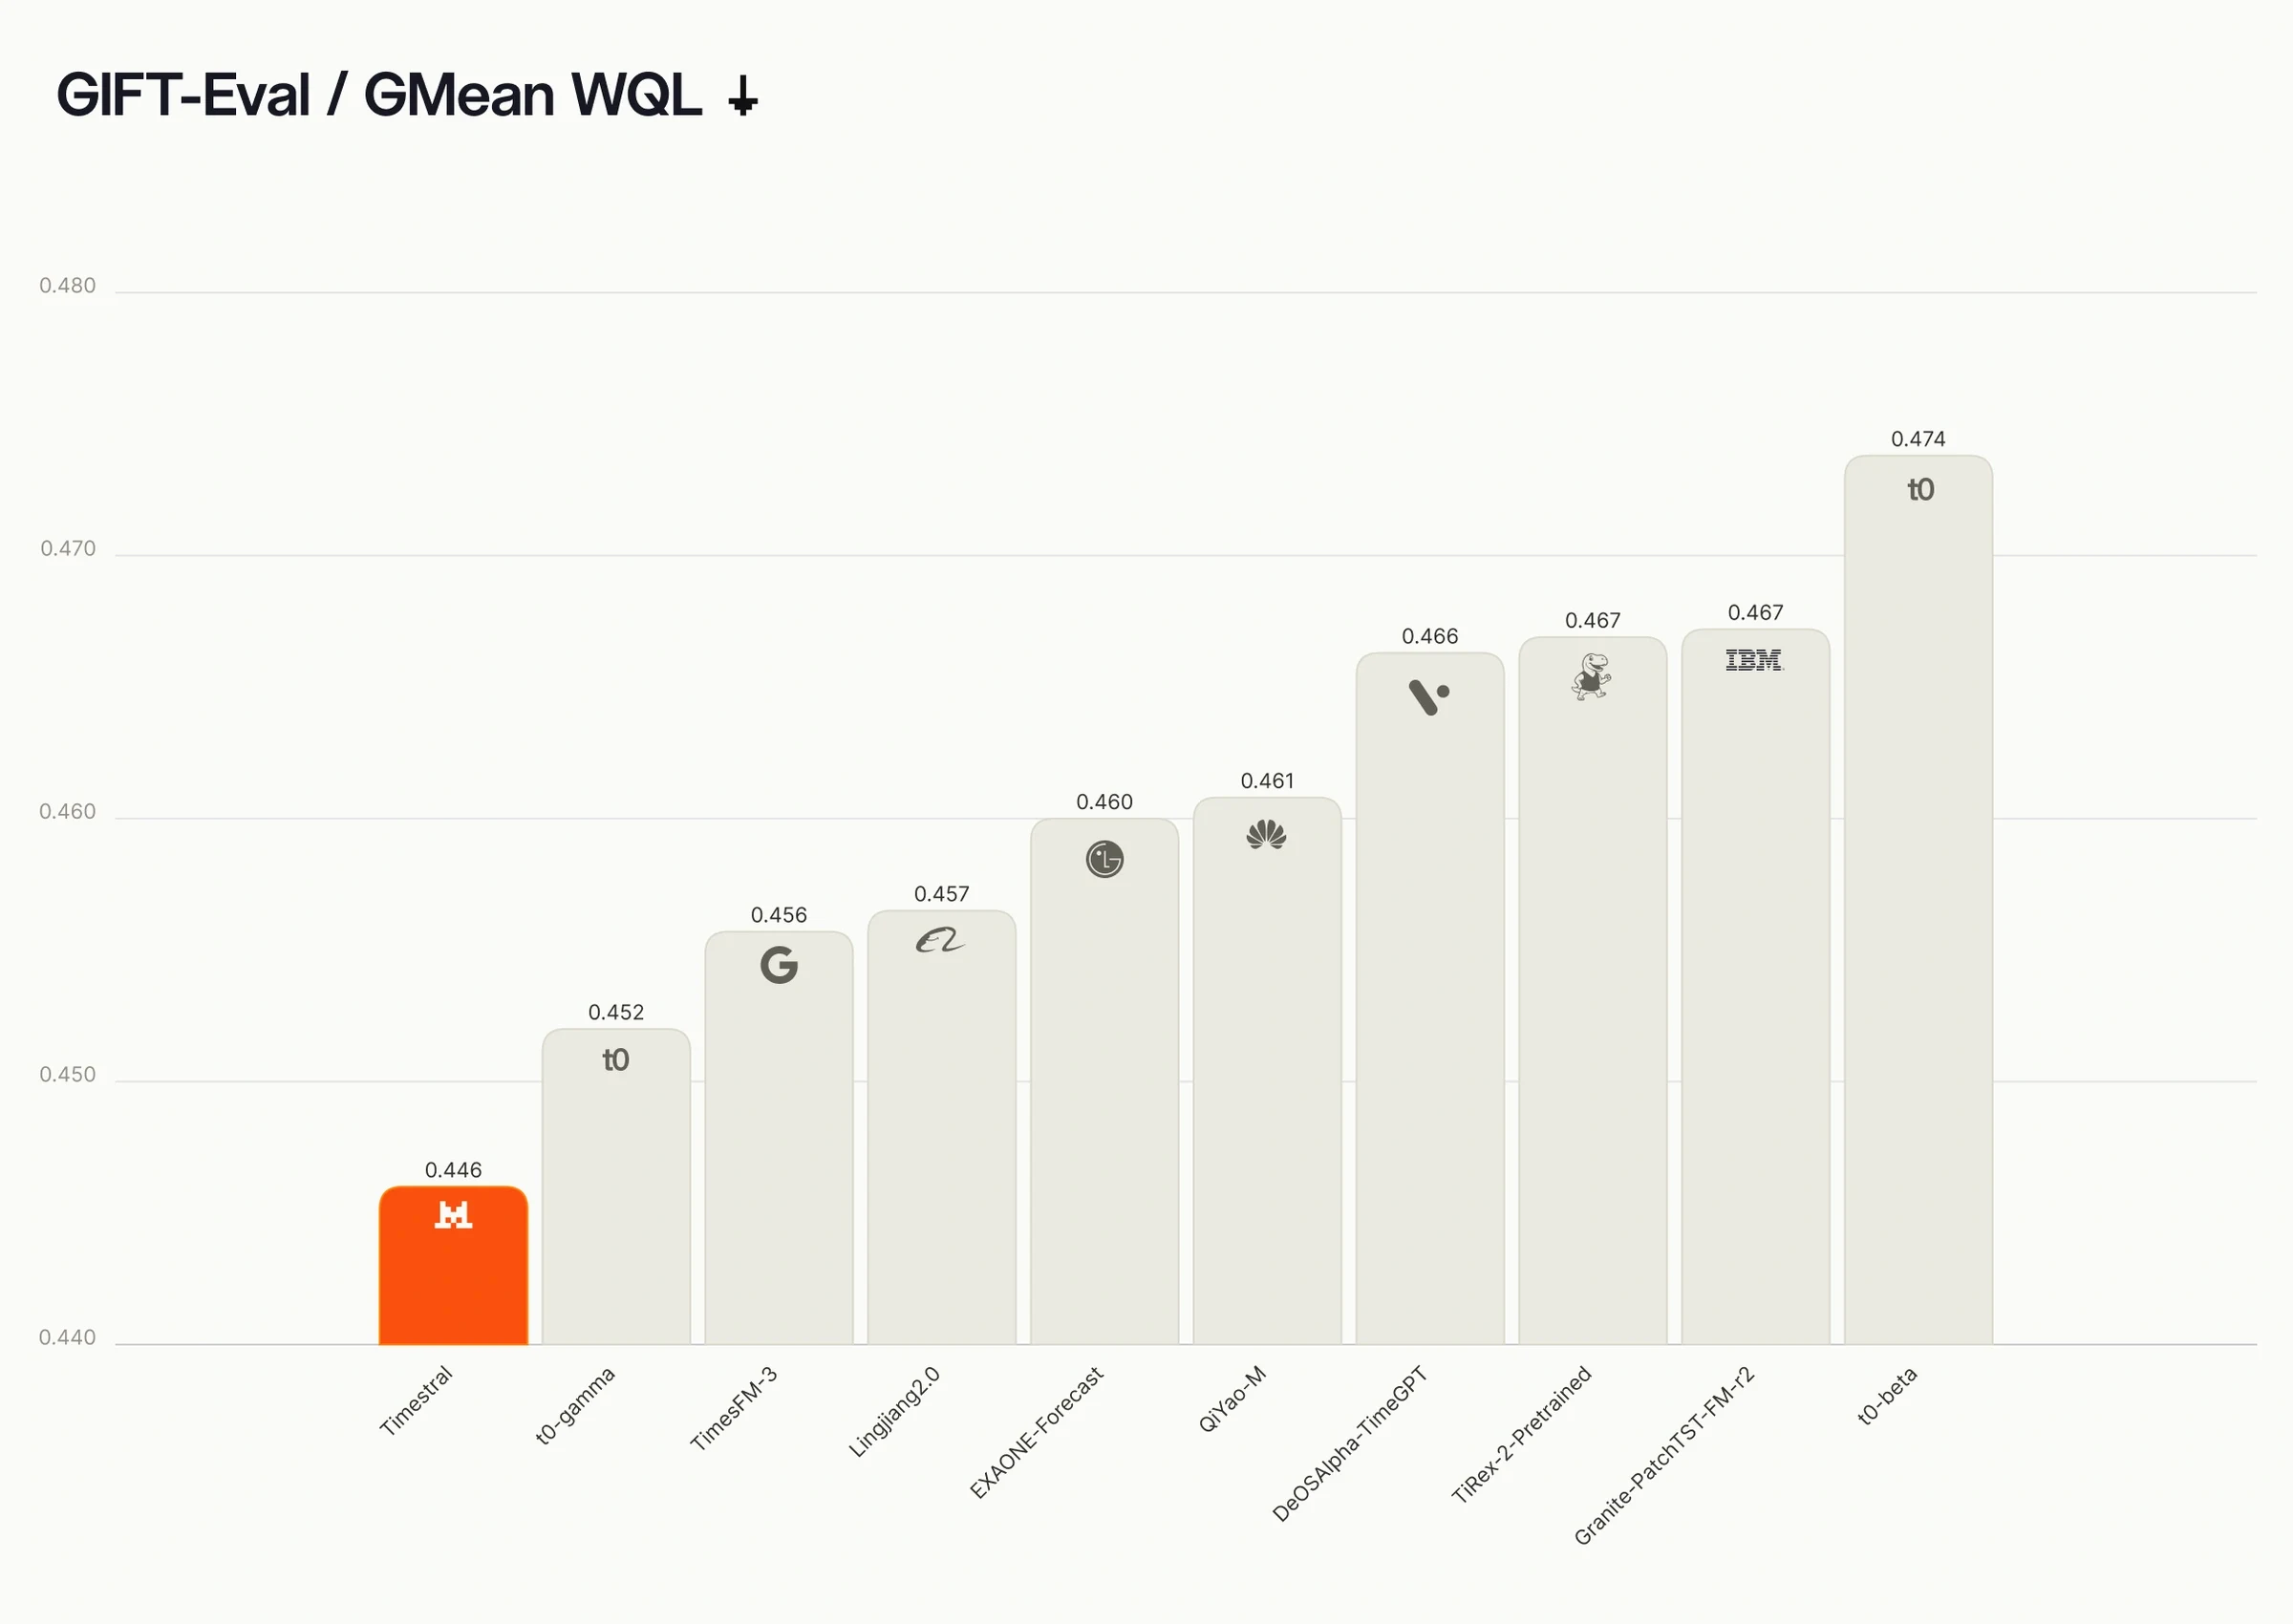
GIFT-Eval, top dix des 83 entrées comparables pré-entraînées et zéro-shot. Plus bas est meilleur.
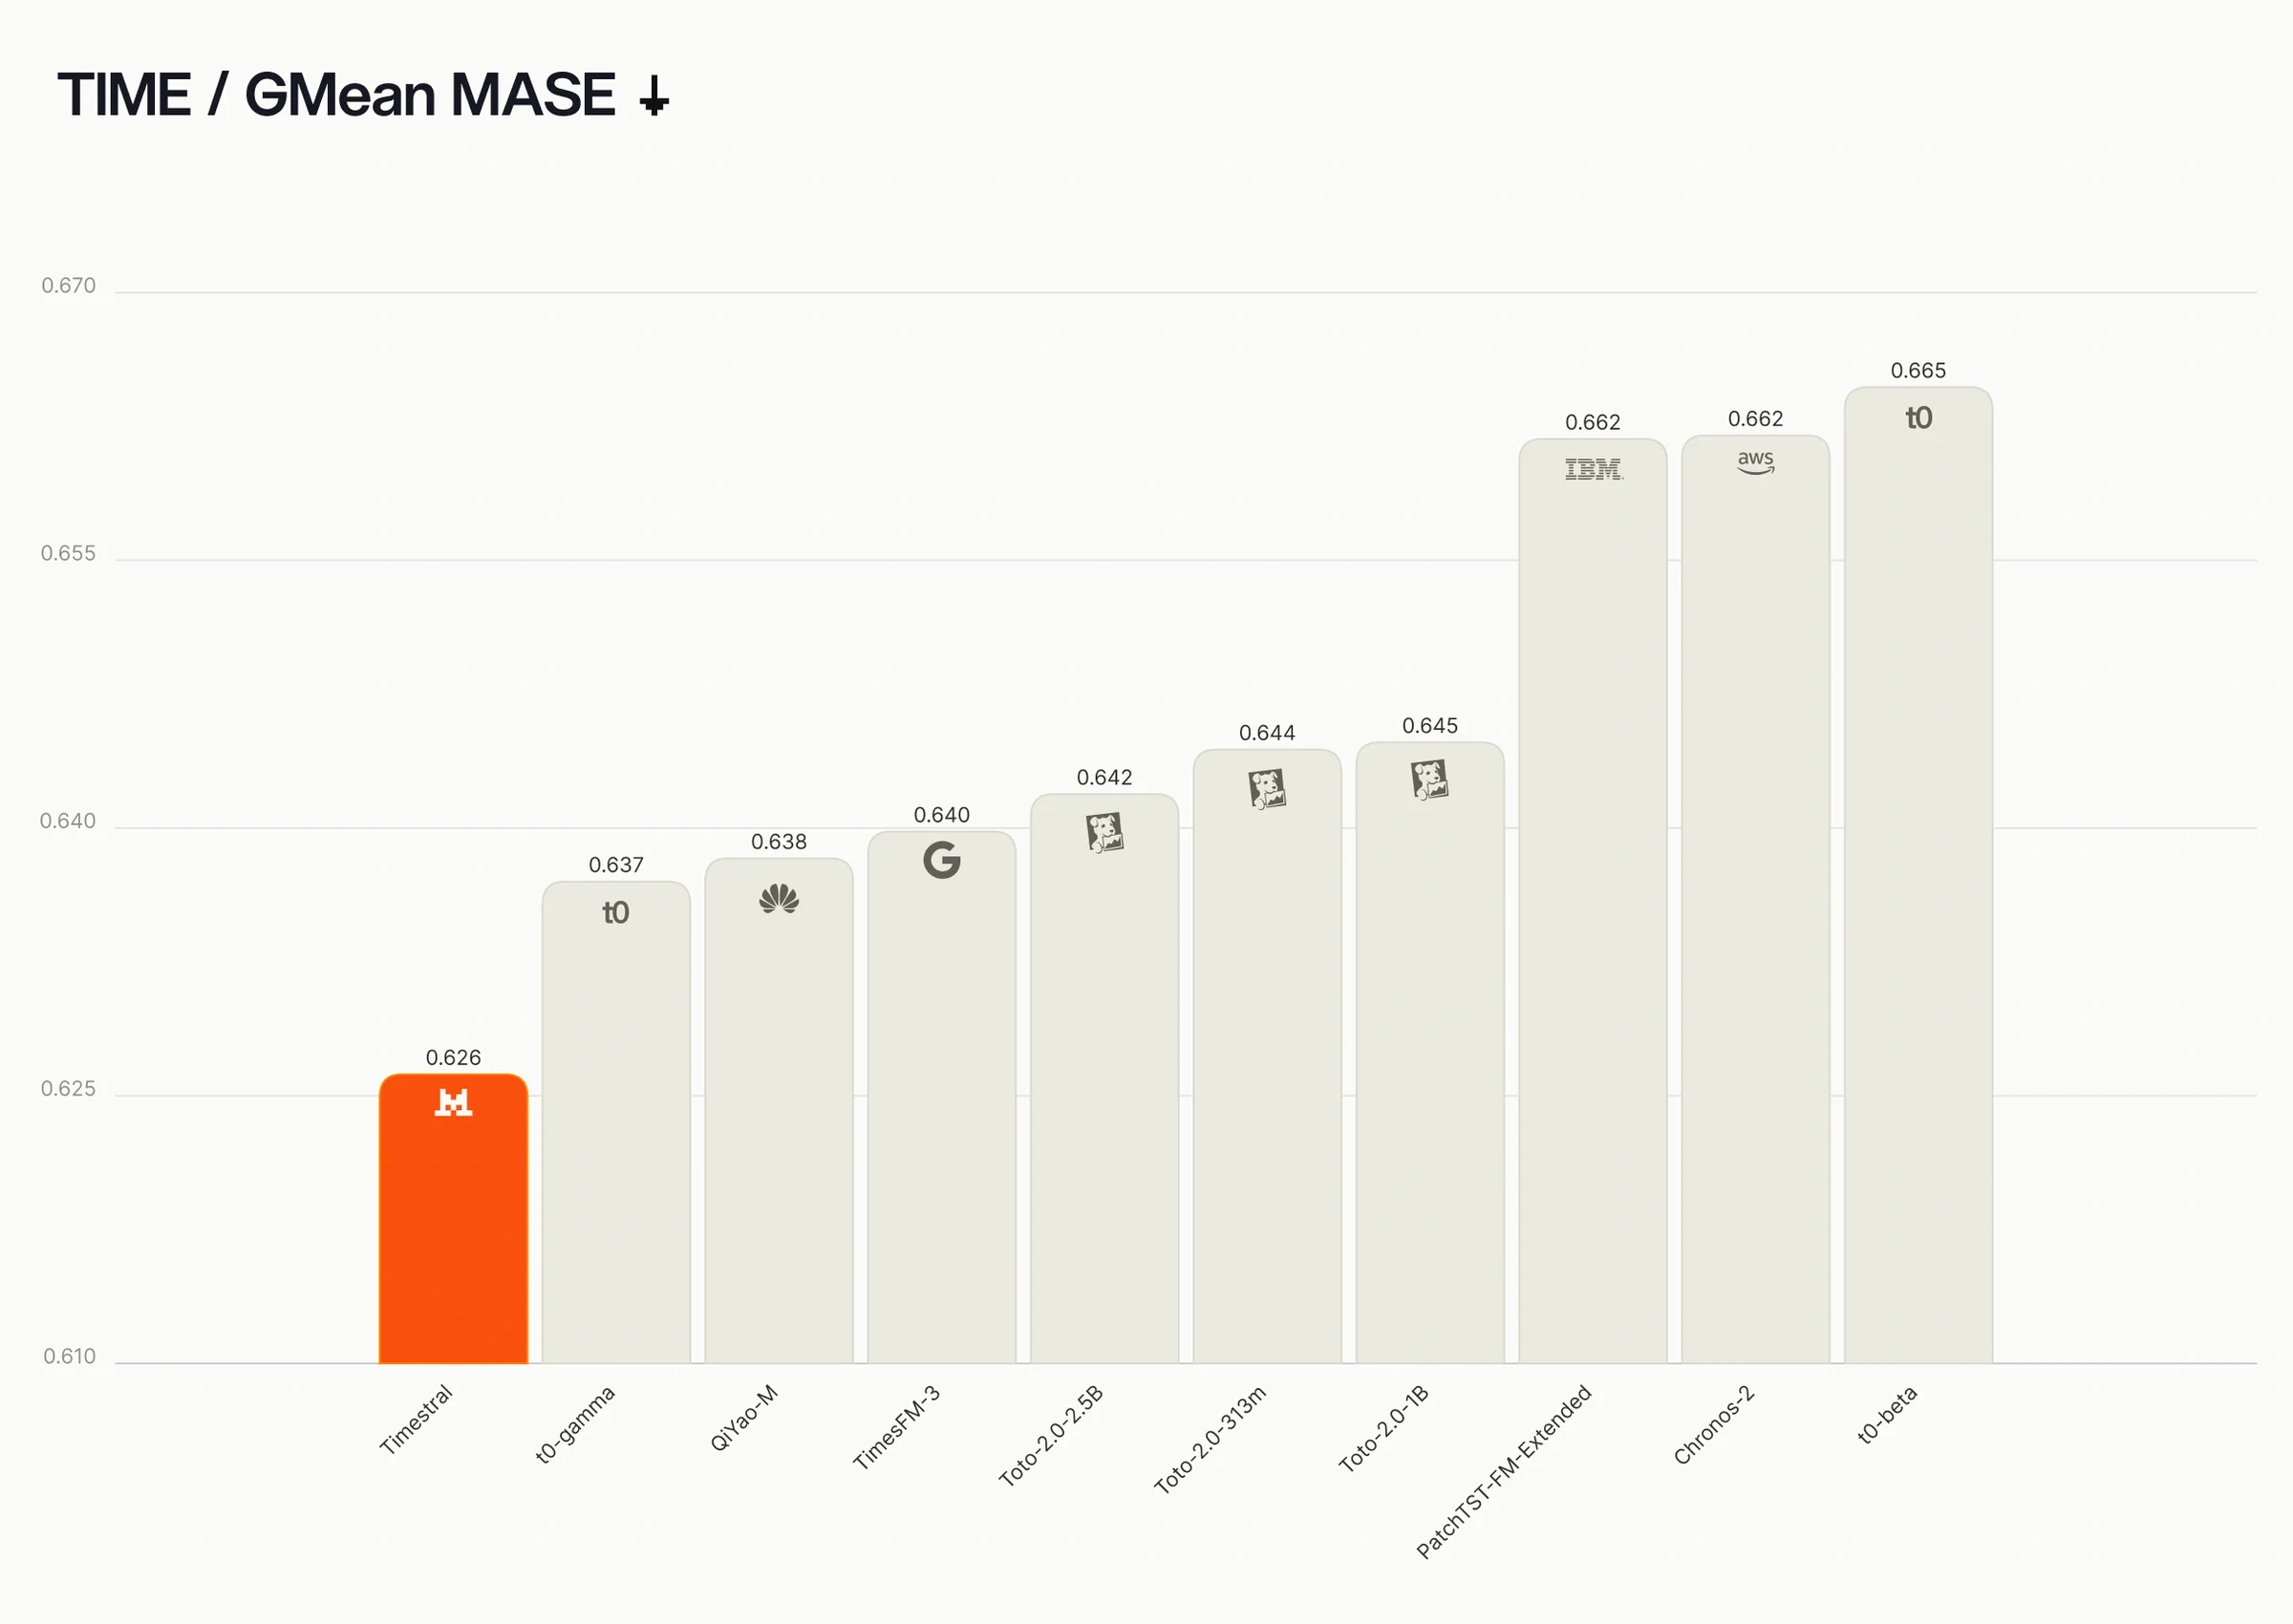
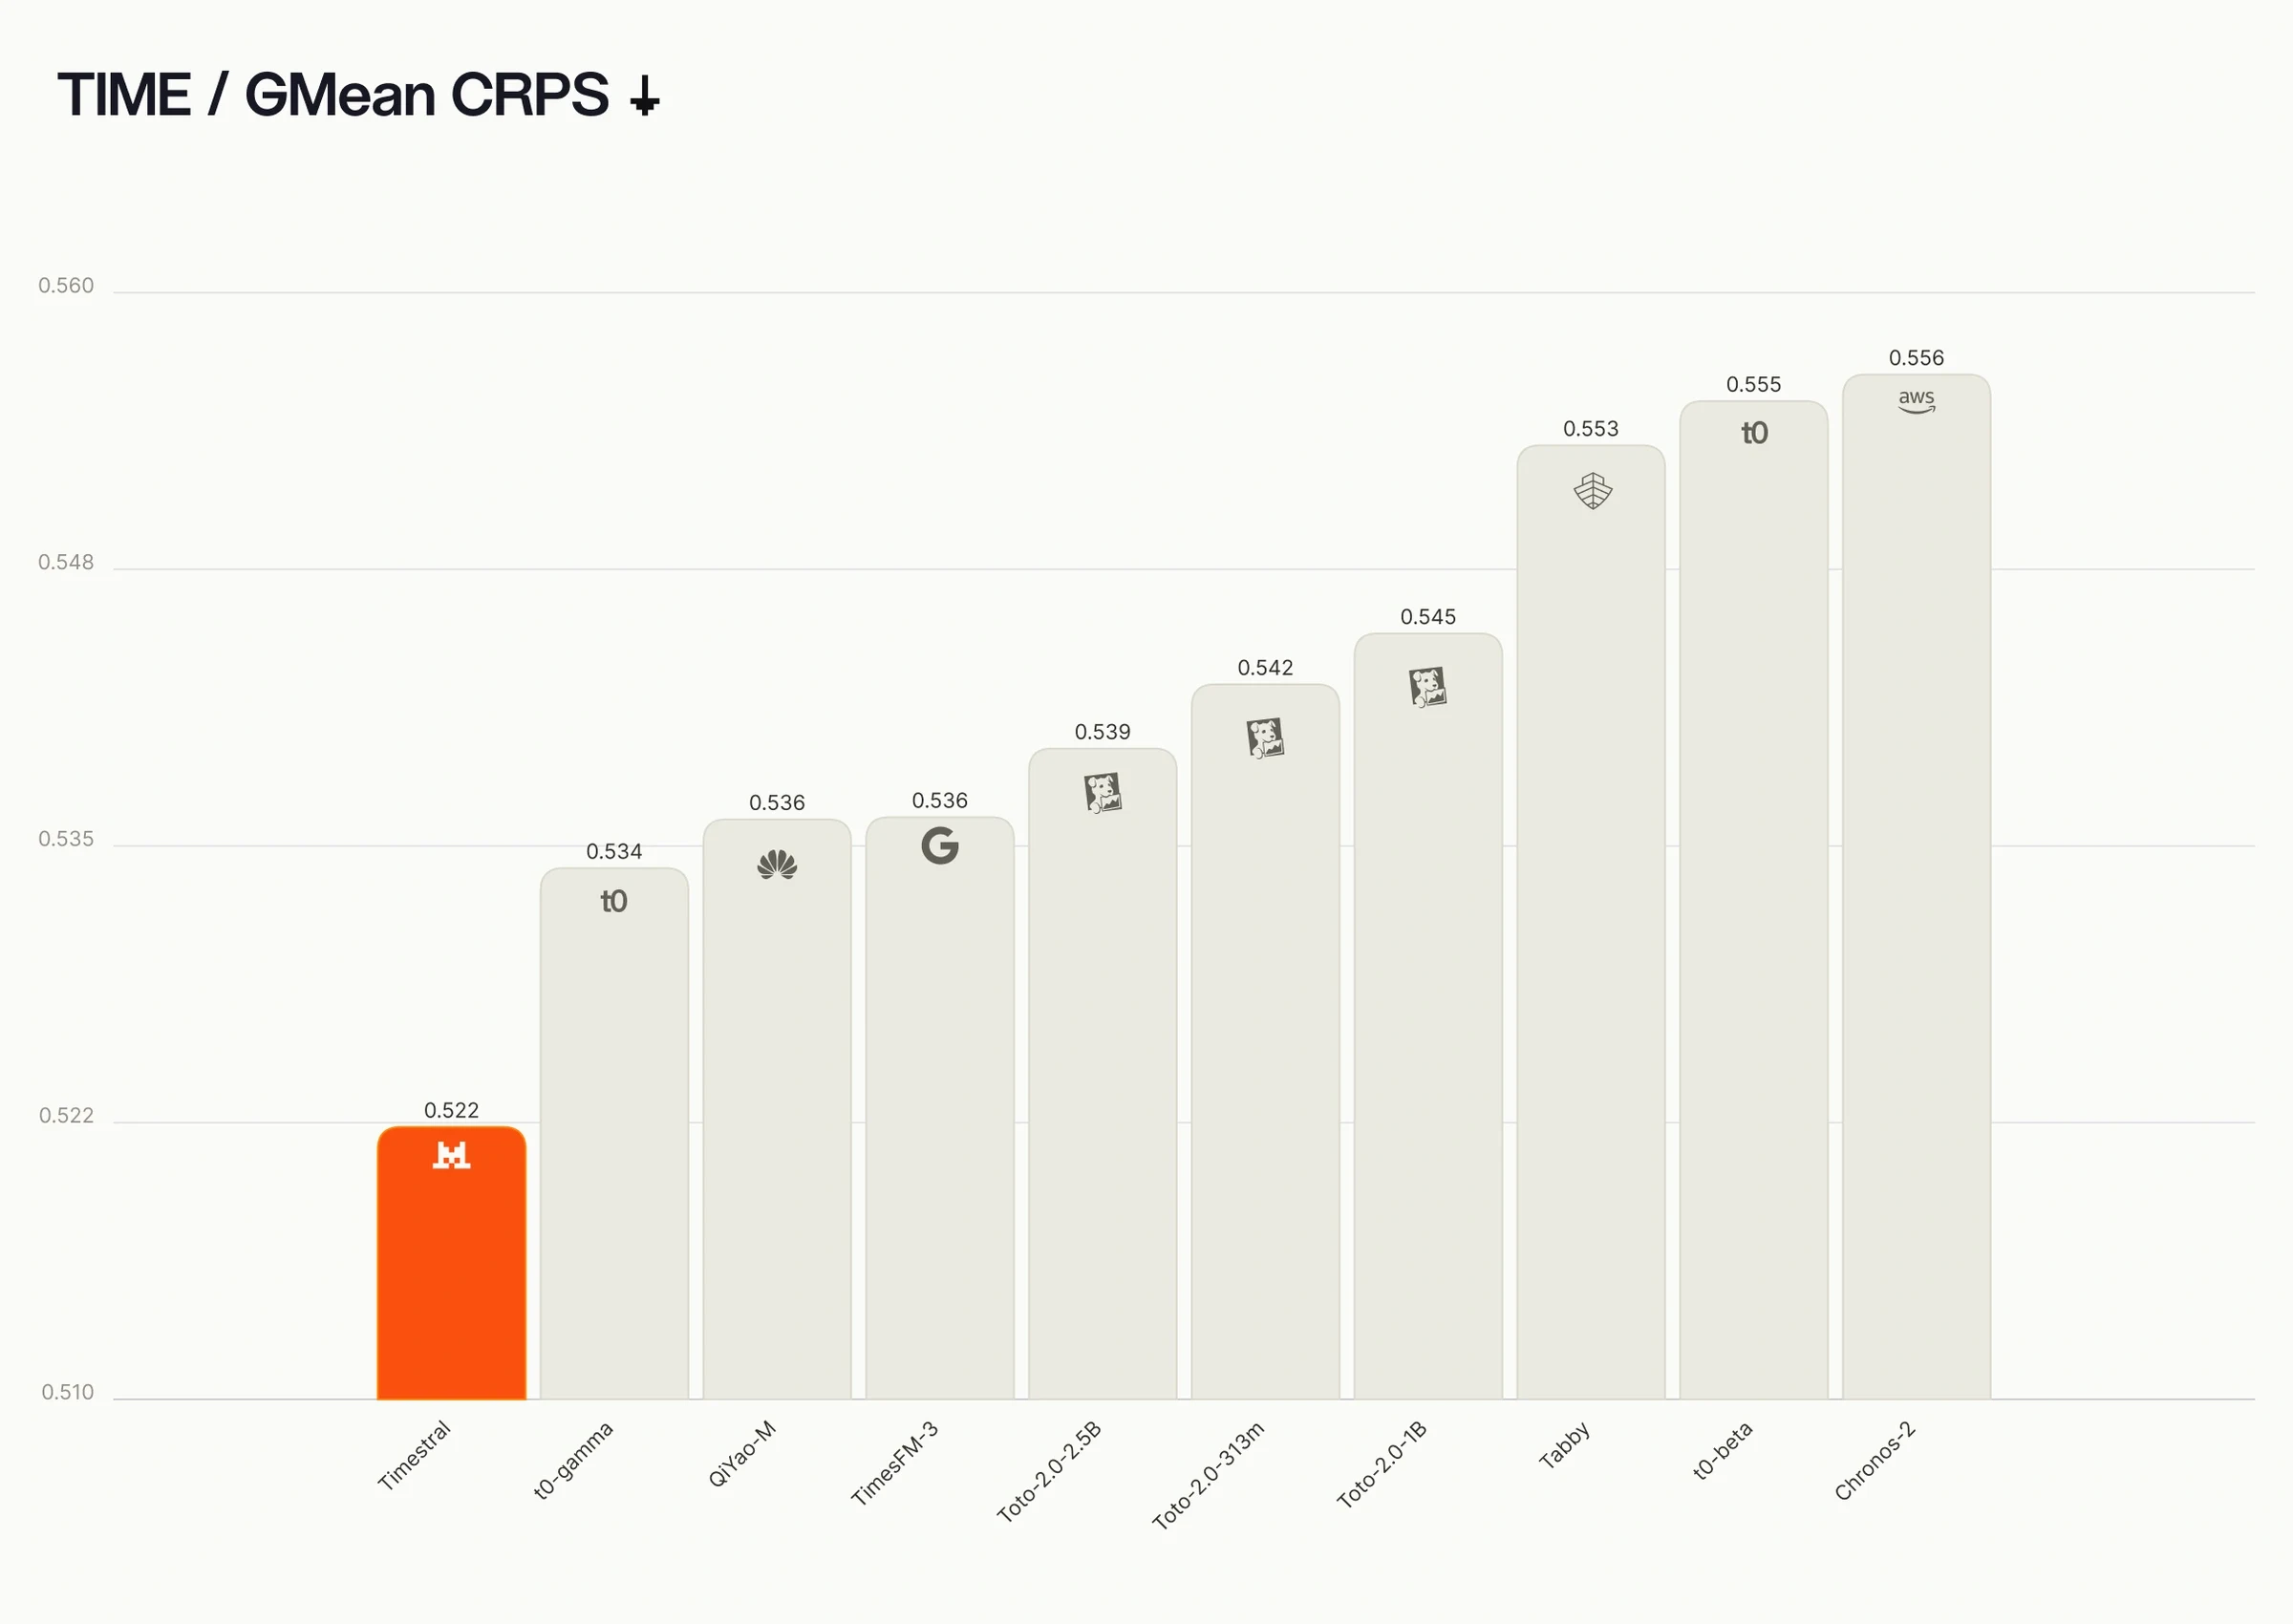
TIME, top dix des 35 entrées du classement. Plus bas est meilleur sur les deux métriques.
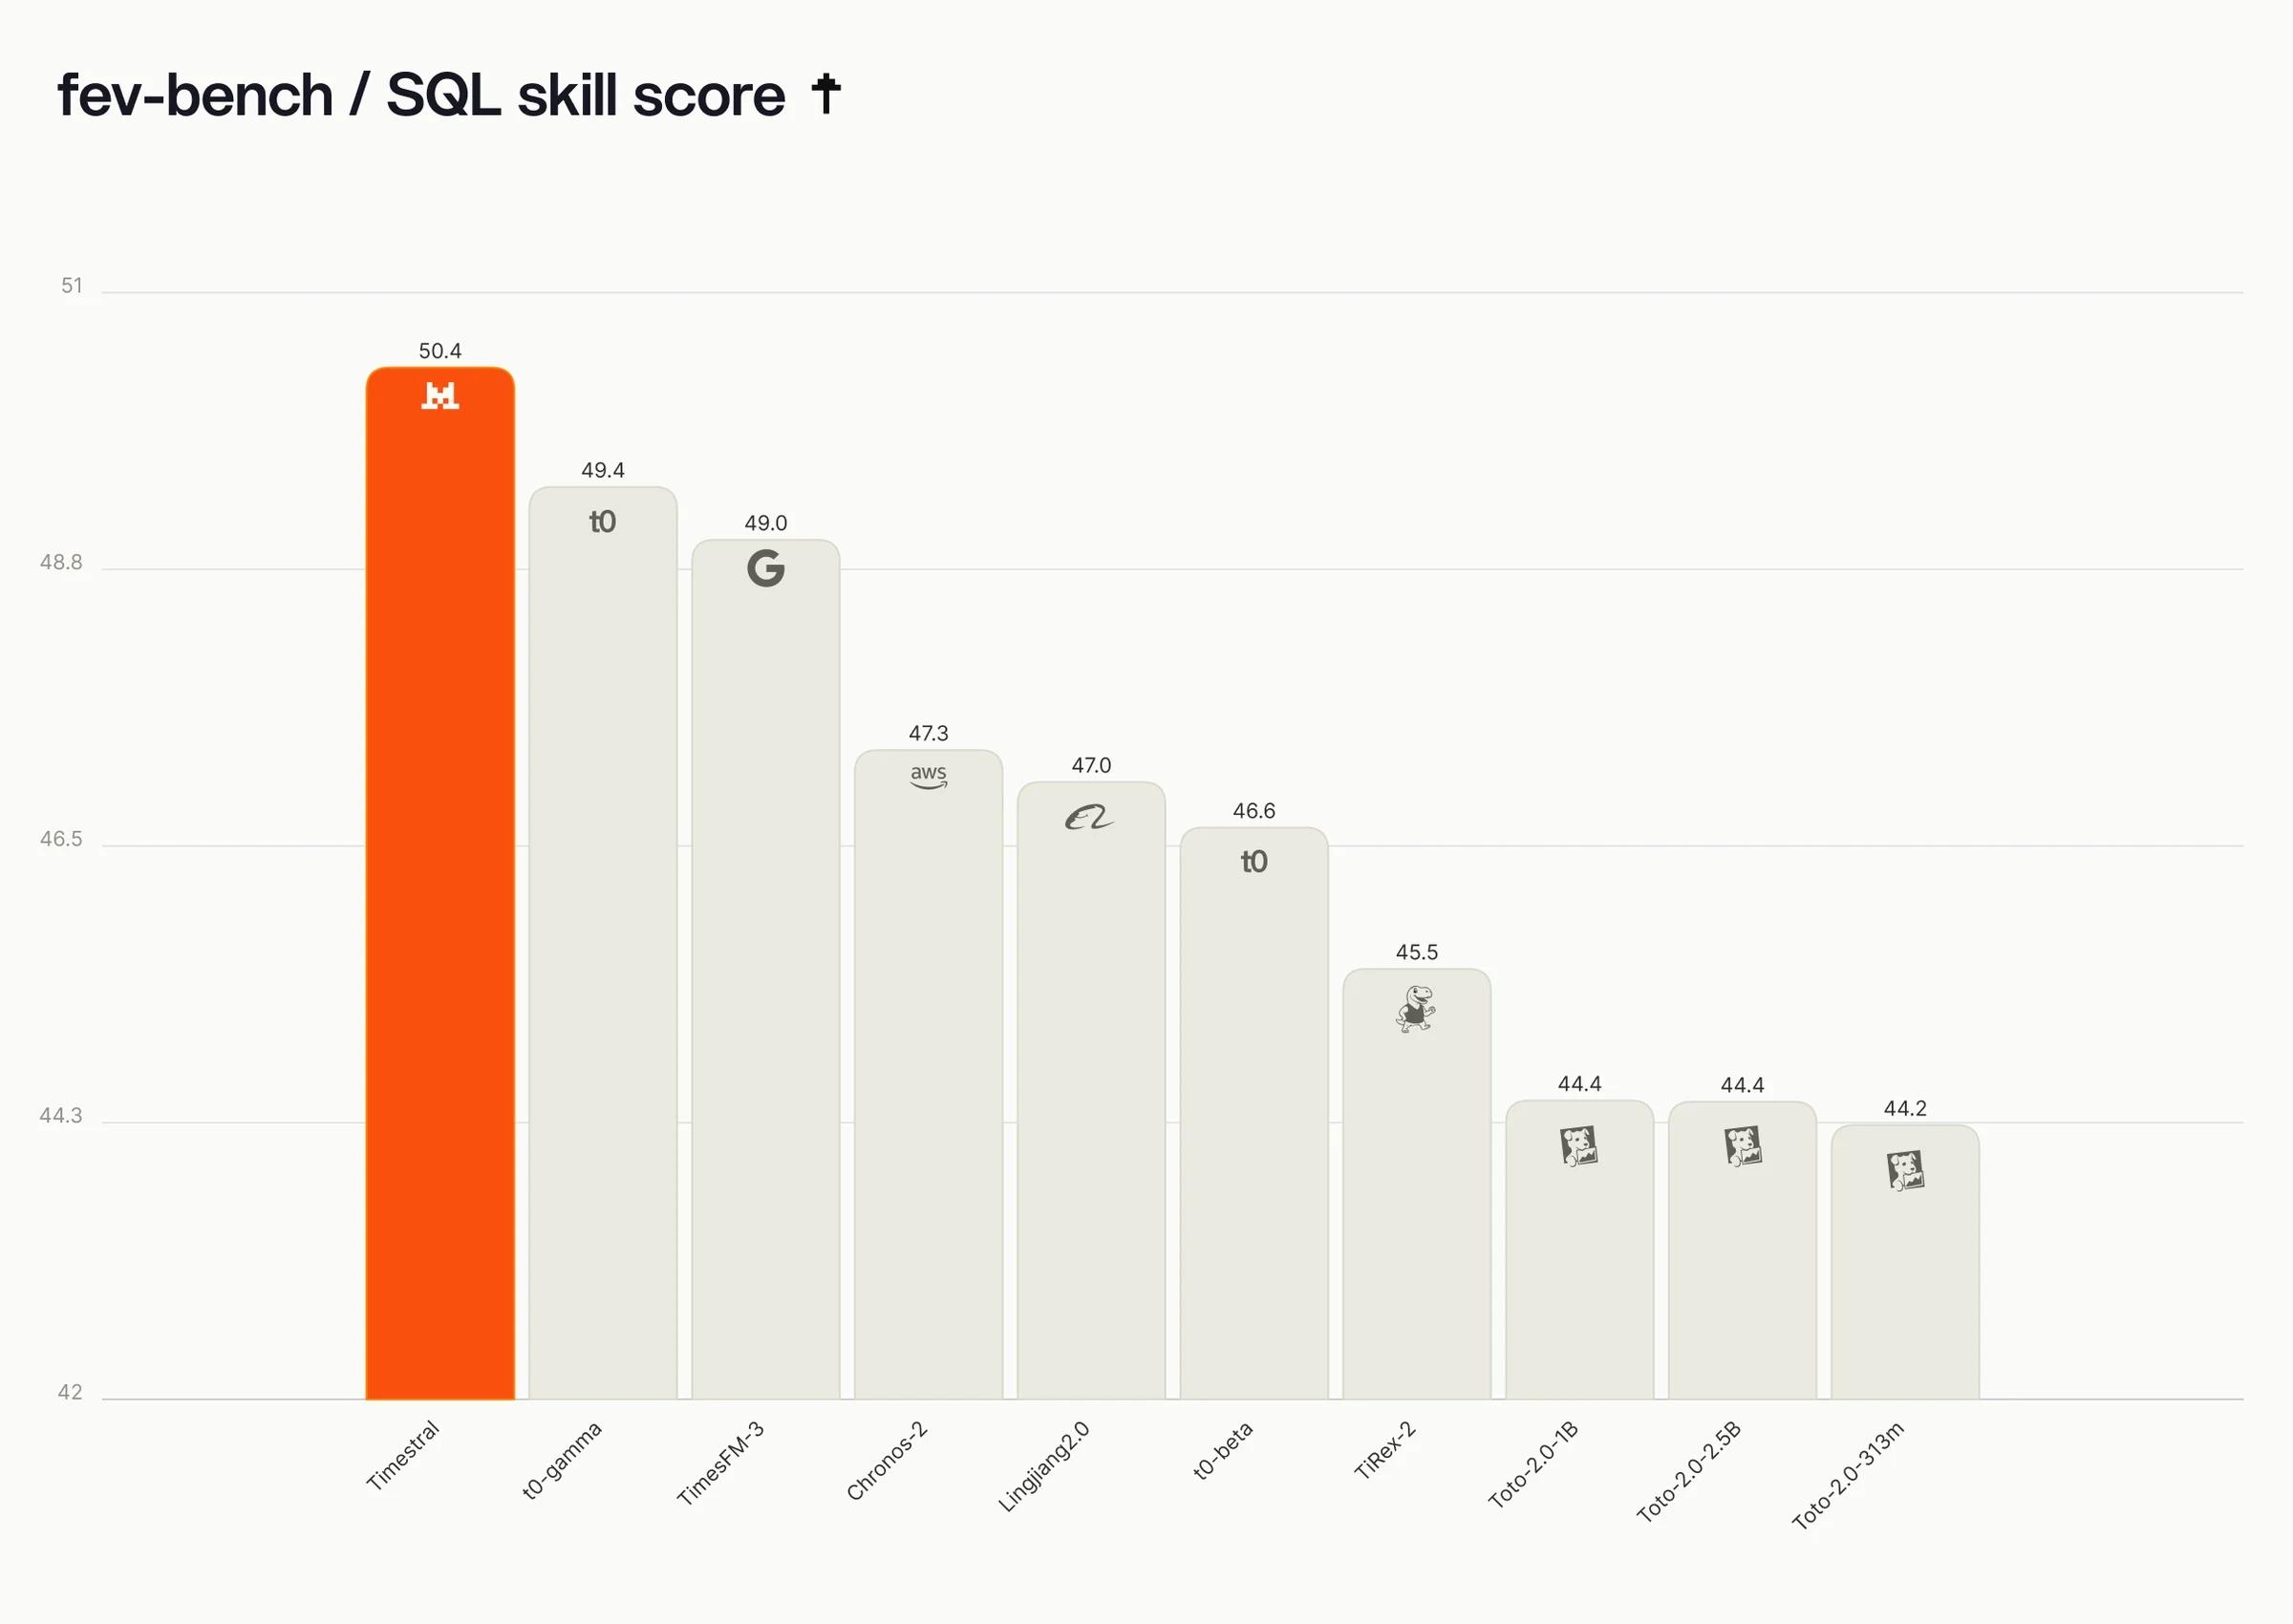
fev-bench, top dix des 37 entrées du classement, par SQL skill score. Plus haut est meilleur.
Une famille de modèles optimisée pour chaque spécification
Timestral a été optimisé comme une famille de quatre modèles : 5M, 28M, 123M et 209M de paramètres. Les modèles plus grands améliorent les performances de prévision, tandis que les plus petits sont plus rapides et moins coûteux. Les quatre partagent la même architecture et la même recette d'entraînement. Chaque taille se situe sur la frontière de Pareto entre précision et taille de modèle : pour chaque taille, aucun modèle public ne prévoit mieux.
Score en fonction de la taille du modèle sur GIFT-Eval, TIME et fev-bench (affiché comme 1 − skill score). Plus bas est meilleur. Notre modèle 28M bat Chronos-2, environ quatre fois plus grand, sur GIFT-Eval et TIME. Notre modèle 209M bat TimesFM-3 et Falcon-2.0 avec moins de paramètres.
Timestral n'a pas besoin de GPU à l'inférence. Sur un CPU de serveur standard avec 8 threads, prévoir un jour à l'avance à partir de trois semaines d'historique à 15 minutes prend 10 ms avec le modèle 5M et 140 ms avec le modèle 209M. Les modèles plus petits échangent un peu de précision contre de la vitesse : le modèle 28M est cinq fois plus rapide que le modèle 209M, et le modèle 123M arrive à moins de 0.2% du score du 209M avec les trois quarts de sa latence.
Un exemple industriel
Considérons une usine industrielle équipée de milliers de capteurs sur ses équipements. Timestral peut améliorer les prévisions sur ces données de plusieurs manières.
Prévision multivariée. Les vibrations, la température et la pression d'une pompe n'évoluent pas de manière indépendante. Une hausse de l'une explique ou cause souvent un changement d'une autre. Timestral modélise les séries liées conjointement, ce qui lui permet d'exploiter ces dépendances au lieu de prévoir chaque capteur isolément.
Prévision probabiliste. Une seule valeur prédite peut ne pas montrer l'ensemble du tableau. Timestral prédit un jeu complet de quantiles, permettant aux équipes de voir l'ampleur de l'incertitude, de définir des seuils d'alerte qui en tiennent compte et de planifier la maintenance en fonction du risque plutôt qu'en fonction d'un chiffre unique.
Covariables catégorielles. Certaines covariables prennent des valeurs issues d'un ensemble de catégories plutôt que des nombres continus, comme le jour de la semaine ou l'état d'une machine (en marche, au repos, en maintenance). Les encoder en nombres imposerait un ordre ou une échelle qu'elles n'ont pas. Timestral les accepte directement comme entrées catégorielles pour améliorer les prévisions.
Covariables connues du futur. Certains facteurs déterminant le comportement des capteurs sont connus à l'avance, comme les calendriers de production, les arrêts planifiés ou les prévisions météorologiques. Timestral peut les prendre en compte pour améliorer la qualité des prévisions, de sorte qu'une augmentation de charge programmée soit attendue plutôt que signalée comme une surprise.
Du modèle au système
Timestral est un modèle numérique capable de fonctionner au sein de pipelines de supervision existants, ou d'être associé à nos modèles de langage dans des workflows agentiques multimodaux.
Dans l'usine, cela pourrait ressembler à ceci :
Timestral fonctionnant en continu sur les flux de capteurs de l'usine, détectant les anomalies au fur et à mesure qu'elles se produisent.
Lorsqu'il signale une anomalie sur une pompe, un agent incorpore les signaux et les compare aux embeddings de données de capteurs passées pour trouver des défaillances historiques similaires.
L'agent lance ensuite des sous-agents pour effectuer une analyse des causes racines, en s'appuyant sur le contexte de cette usine, tel que les dossiers de maintenance, les journaux d'équipe et les notes des opérateurs, les manuels des équipements, les anciens ordres de travail et les relevés des équipements connexes.
L'agent rédige un diagnostic proposé sur la base des constats, avec des preuves à l'appui et les prochaines étapes possibles.
Le responsable de l'usine reçoit un diagnostic et un plan appuyés par les données des capteurs, plutôt qu'une simple alerte.
Contributions techniques clés
Plusieurs idées ont été combinées pour produire ces résultats. Chacune sera décrite en détail dans le rapport technique.
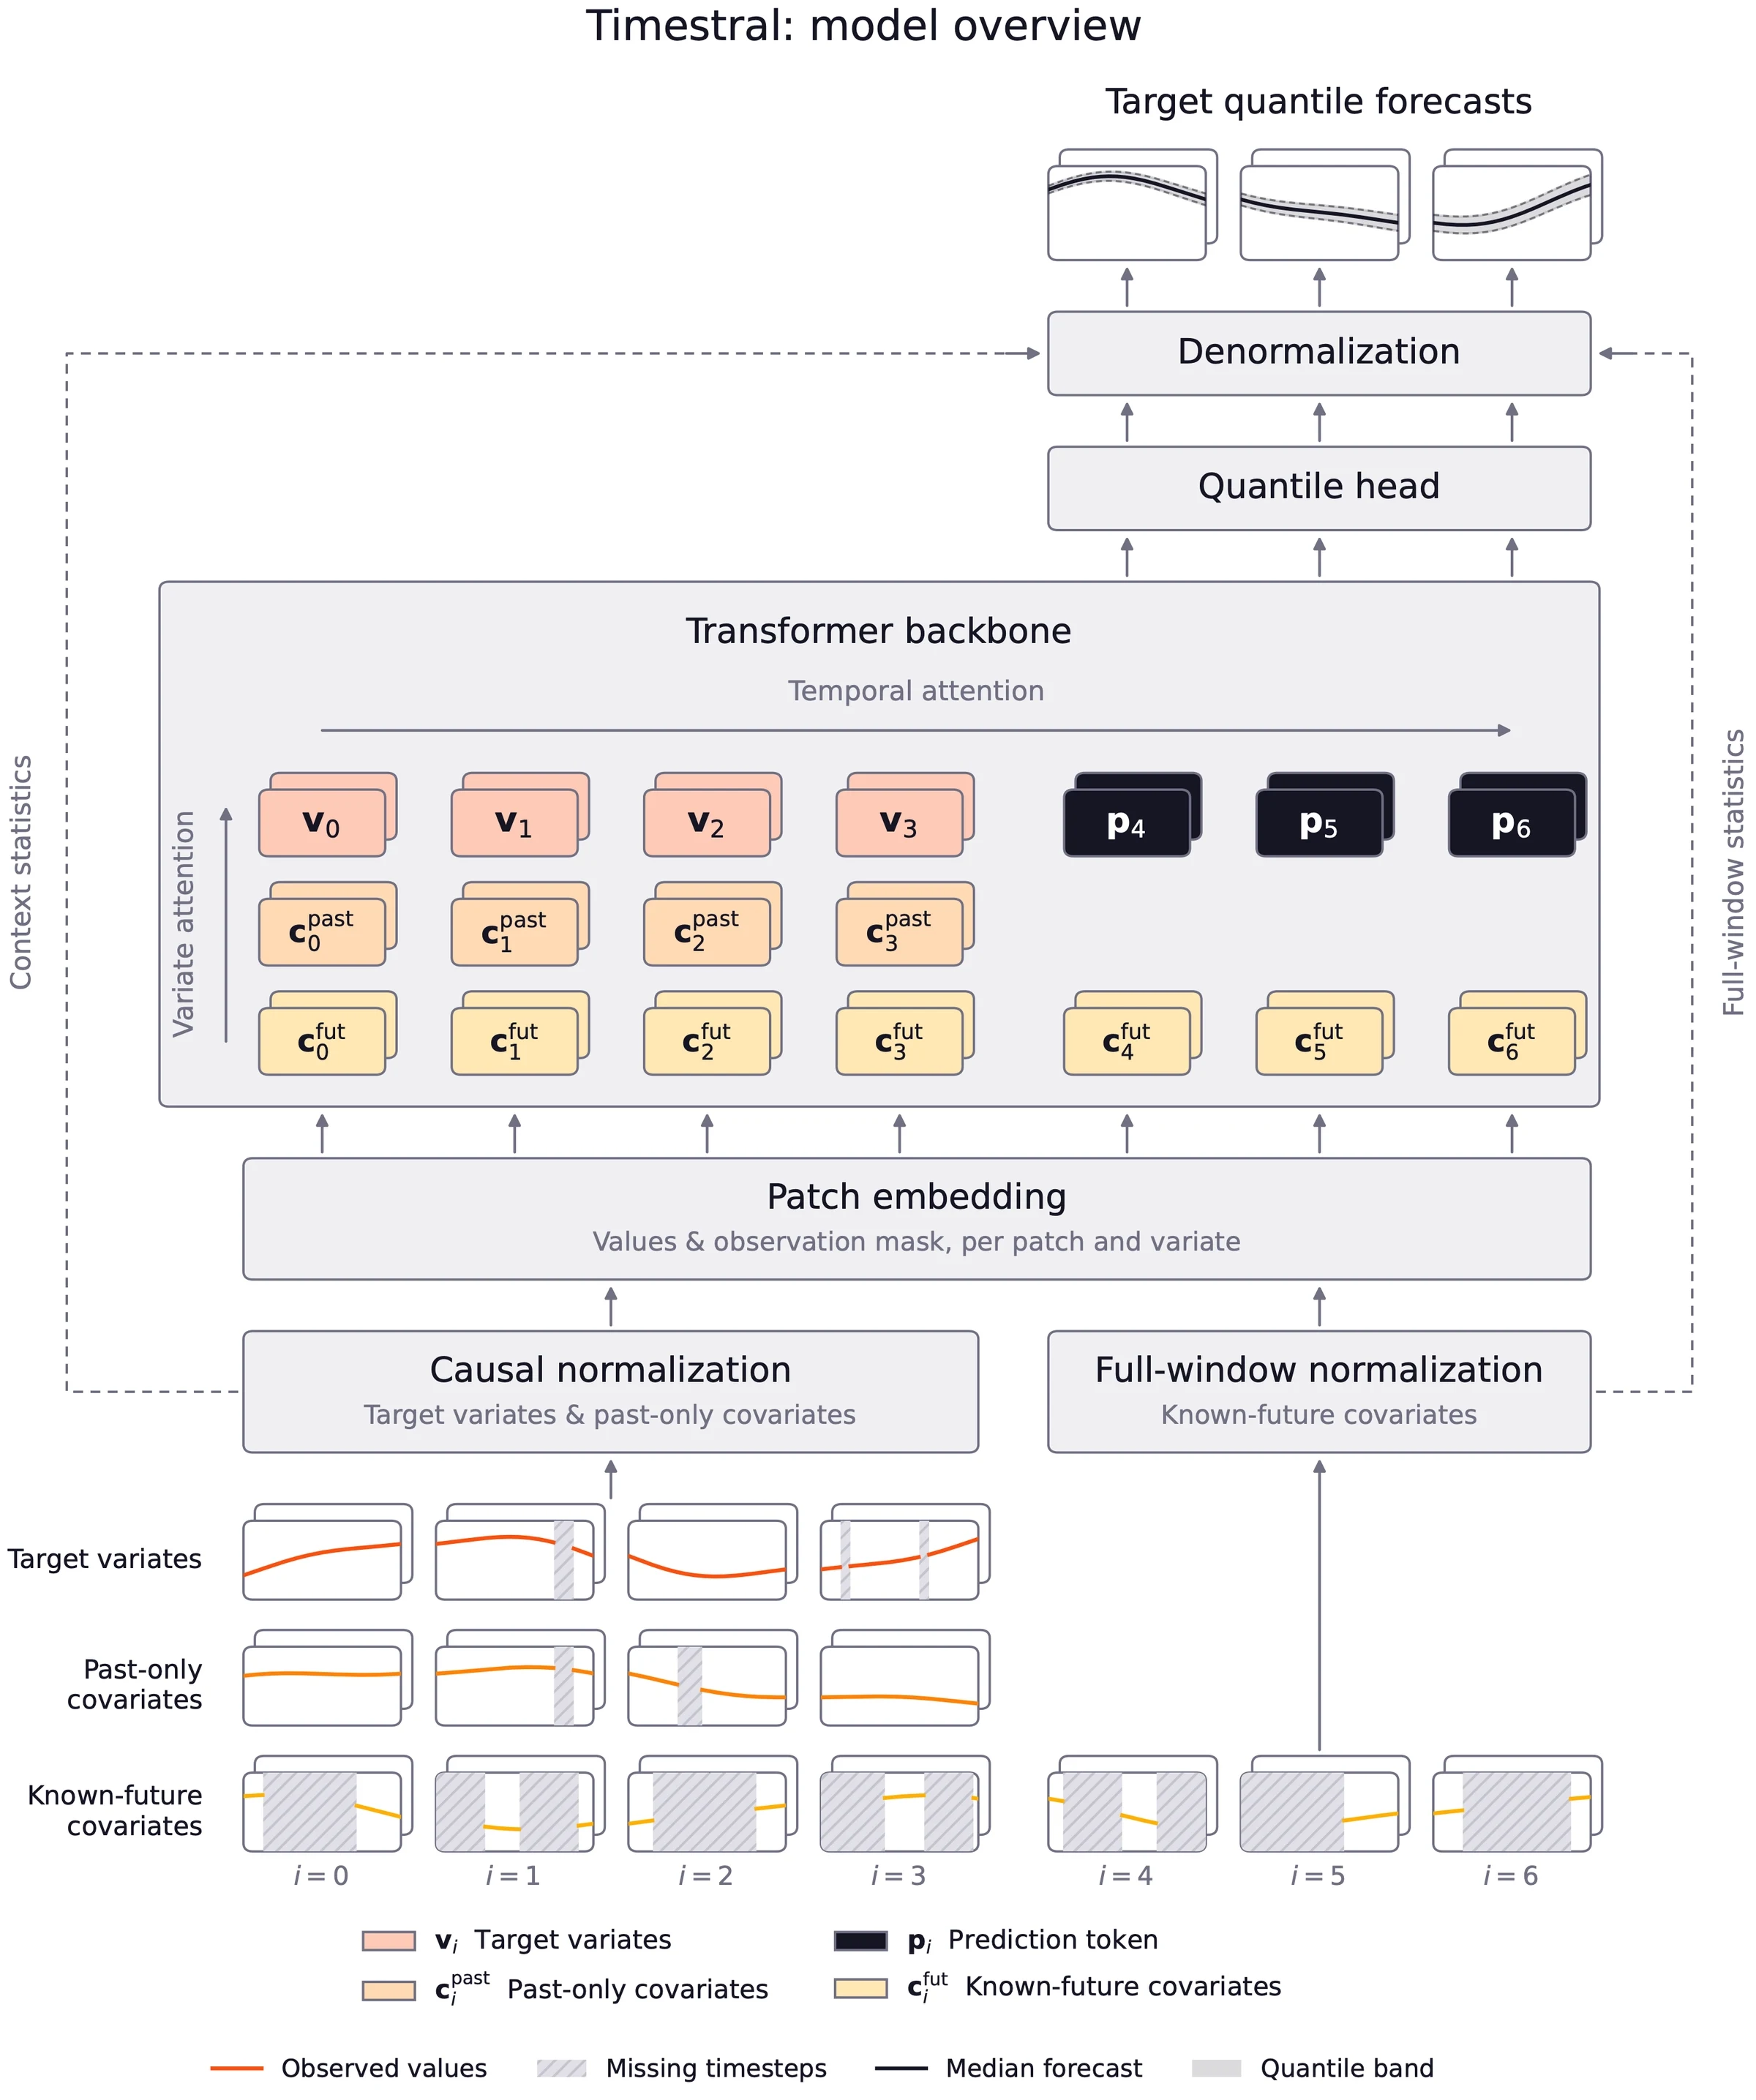
Decoupled Horizon Forecasting (prévision à horizon découplé). Les décodeurs causaux entraînés avec un masquage par patchs contigus, comme dans Toto 2.0 et TimesFM-3, masquent les valeurs à prévoir, de sorte qu'elles apparaissent comme des valeurs manquantes et sont également perdues comme contexte pour les prévisions ultérieures. Notre approche, DHF, sépare les deux : l'historique complet reste dans la séquence, et des tokens de prévision appris lisent l'historique qui les précède. Chaque valeur observée sert ainsi à la fois de cible et de contexte, les véritables trous restent signalés comme manquants, et les longueurs d'horizon d'entraînement et l'augmentation des données manquantes peuvent être ajustées indépendamment l'une de l'autre.
Attention sensible aux covariables. Chaque série d'entrée se voit attribuer un rôle : variable cible, covariable passée uniquement ou covariable future connue. Les covariables futures connues sont visibles sur toute la fenêtre tandis que les cibles restent causales, et l'information ne circule que des covariables vers les cibles. Timestral peut donc utiliser un calendrier des jours fériés ou une prévision météorologique sans laisser le futur d'une cible s'infiltrer dans sa propre prévision.
Données d'abord synthétiques. La majorité des données d'entraînement était synthétique. Nous avons d'abord généré des processus univariés avec une dynamique temporelle cohérente, incluant des tendances, une saisonnalité et des motifs de bruit divers. Nous avons ensuite utilisé un synthétiseur multivarié pour construire des séries multivariées en introduisant des dépendances non linéaires entre ces processus.
Entraînement en deux étapes. Timestral est d'abord pré-entraîné à grande échelle sur des données purement synthétiques avec une taille de contexte de 8192, puis post-entraîné sur un mélange de données réelles et synthétiques avec un contexte 4x plus long. L'objectif est une pinball loss sur 21 quantiles, une approximation discrète de la CRPS.
Un modèle qui peut être adapté
Les benchmarks publics mesurent la performance générale, mais les données de production peuvent différer considérablement en comportement et en structure. Elles peuvent également évoluer dans le temps à mesure que les marchés changent de régime, que les équipements se dégradent et que les schémas de demande évoluent. La valeur durable réside dans la capacité à adapter un modèle à des données internes et à le réentraîner en continu à mesure que la distribution évolue.
Pour les organisations qui souhaitent aller plus loin, Timestral est disponible via Mistral Forge, le même pipeline d'entraînement que nous utilisons pour nos modèles de langage. Il prend en charge :
Inférence zéro-shot disponible immédiatement.
Extensions architecturales, telles que des covariables spécifiques au domaine.
Fine-tuning sur des données propriétaires, pour se spécialiser dans un domaine tout en préservant la performance générale.
Contrôle sur les données d'entraînement, y compris l'ajustement du mélange d'entraînement, la relecture des données de pré-entraînement et la génération d'échantillons de données synthétiques reflétant le domaine cible. Un contrôle total sur les données garantit que rien de ce que nous rétro-testons n'a été vu pendant le pré-entraînement.
Le pipeline complet peut être déployé sur le matériel de nos clients, y compris dans des environnements isolés du réseau (air-gapped).
Et maintenant ?
Nous avons publié un dépôt GitHub vous pouvez ainsi exécuter Timestral sur vos propres données. Un rapport technique présentant l'ensemble des résultats suivra. Pour des problèmes de prévision plus spécialisés, ou pour collaborer sur des recherches, n'hésitez pas à nous contacter.
Timestral | |
|---|---|
Type | Modèle de fondation pour séries temporelles (TSFM) |
Paramètres | 5M, 28M, 123M et 209M |
Longueur de contexte | 32,768 pas de temps |
Sortie | Prévisions probabilistes, 21 quantiles |
Entrées | Cibles multivariées, covariables passées uniquement et covariables futures connues |
Déploiement | Sur site, VPC ou réseau isolé (air-gapped) |
Licence | MIT modifiée |
Timestral
Nouveau
Les modèles de fondation de séries temporelles de Mistral. Prévisions probabilistes de pointe, 5M–209M de paramètres, fonctionne sur CPU.
Prévisions probabilistes
Découvrir