
Dans chaque conversation que j'ai avec des dirigeants d'entreprise, ils disent la même chose. Ils veulent que les agents fassent plus, mais ils ne leur font pas confiance pour le faire correctement en toutes circonstances.
C'est compréhensible. La même créativité et la même autonomie qui rendent les agents utiles les rendent difficiles à approuver. Donnez une tâche à un agent et il trouve son propre chemin pour l'accomplir, en choisissant des outils et en enchaînant des étapes qu'aucun développeur n'a scriptées. Exécutez la même tâche deux fois et il pourrait emprunter un itinéraire différent à chaque fois. Un test qui passe aujourd'hui vous en dit peu sur ce que l'agent fera demain.
La réponse habituelle est une personne dans la boucle, qui approuve tout ce que fait l'agent. Cela fonctionne à petite échelle, mais à mesure que les agents prennent en charge davantage de travail, les approbations humaines s'accumulent et la lassitude de la revue s'installe. Les personnes invitées à tout vérifier finissent par ne plus repérer les choses importantes. La prudence devient un goulot d'étranglement, et des agents capables de bien plus restent inactifs face au travail précieux qui pourrait avoir davantage d'impact.
La solution consiste à laisser l'agent agir seul lorsque ses actions peuvent être vérifiées, et à réserver le jugement humain aux décisions qui le nécessitent. À mesure que les agents entreprennent des travaux à plus haut risque, comme des transactions financières, une action erronée devient de plus en plus préjudiciable. Les organisations ont besoin de la confiance nécessaire pour confier un travail important à un agent d'IA, en sachant qu'il restera dans les limites fixées, même lorsque personne ne regarde. Cette confiance doit être construite.
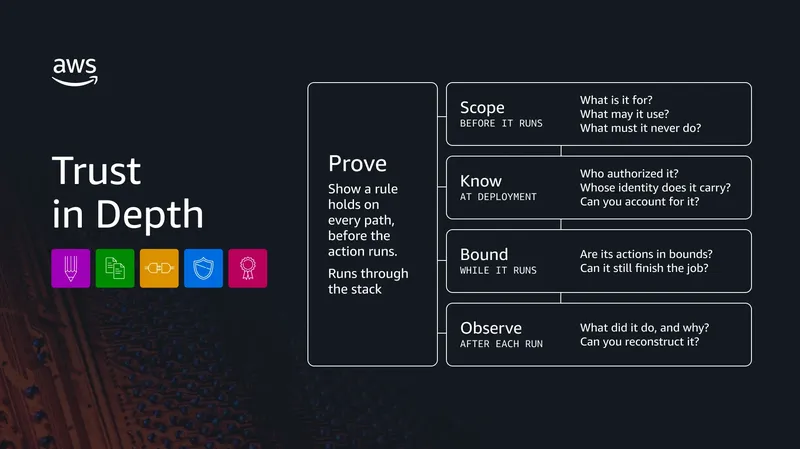
Le filtrage de contenu, les tests et la surveillance remplissent chacun un objectif important, mais aucune de ces capacités seule ne peut garantir qu'un agent se comportera correctement lors de sa prochaine exécution. La confiance provient de couches indépendantes qui se renforcent mutuellement, la même discipline en couches que l'industrie pratique depuis deux décennies sous le nom de Defense in Depth, tournée vers un nouvel objectif. Là où Defense in Depth limite ce qui peut mal tourner, cette approche élargit ce que vous pouvez autoriser en toute sécurité. AWS l'appelle Trust in Depth.
Trust in Depth : Une confiance que vous pouvez vérifier
Vous établissez la confiance en répondant à un ensemble de questions à différents moments du cycle de vie de l'agent :
- Scope, avant son exécution : À quoi sert cet agent, quelles capacités la tâche exige-t-elle, et que ne doit-il jamais faire ?
- Know, au déploiement : Qui l'a autorisé, quelle identité porte-t-il, et pouvez-vous rendre compte de chaque agent agissant en votre nom ?
- Bound, pendant son exécution : Ses actions restent-elles dans les limites que vous avez fixées, et peut-il encore accomplir la tâche ?
- Observe, après chaque exécution : Pouvez-vous reconstituer ce que l'agent a fait et pourquoi, et en tirer des enseignements ?
Parmi ces questions, certaines exigences peuvent s'exprimer sous forme de règles précises, tandis que d'autres requièrent du jugement. Une entreprise peut exiger que seul un responsable puisse approuver un accès, ou que la connexion d'un employé doit être bloquée avant que sa boîte aux lettres puisse être partagée. D'autres attentes, comme conserver un ton aimable ou gérer une situation sensible de manière appropriée, dépendent du contexte et du jugement humain.
Pour les règles définies avec précision, les tests montrent si les contrôles fonctionnent dans les cas que vous anticipez, mais un agent emprunte des chemins auxquels vous n'avez pas pensé. La technologie qui va plus loin est le raisonnement automatisé, la logique mathématique qui vérifie si une règle tient dans tous les cas possibles. Il peut établir qu'une règle tient sur chaque chemin couvert par une description précise du système et de ses hypothèses, ou découvrir le cas exact où elle échoue. Ce résultat est une preuve, et elle n'est aussi bonne que les règles et les hypothèses qui la sous-tendent, c'est pourquoi le travail le plus difficile se fait avant l'exécution de l'agent.
AWS a utilisé le raisonnement automatisé en production pendant plus d'une décennie, depuis Identity and Access Management (IAM) à plus de 2.1 milliards de requêtes par seconde jusqu'à des systèmes critiques comme l'AWS Nitro Hypervisor, Amazon S3 Block Public Access et VPC Reachability Analyzer. Nous l'appliquons désormais aux agents. Partout où les règles d'un agent peuvent être énoncées précisément, le raisonnement automatisé peut les vérifier.
Cependant, toutes les règles ne peuvent pas être énoncées précisément. « Seul un responsable peut approuver un accès » peut être prouvé. « Conserver un ton aimable » ne le peut pas. Là où la preuve ne s'applique pas, limitez l'accès et les actions de l'agent, évaluez son comportement, et soumettez l'ambiguïté réelle à une personne pour qu'elle exerce son jugement. Accordez davantage d'autonomie à mesure que vous établissez que les règles pertinentes sont appliquées, que l'agent accomplit la tâche de manière fiable et que les échecs peuvent être détectés et gérés.
Voici ce que chaque couche de Trust in Depth exige de vous, et comment AWS vous aide à y répondre.
Délimitez votre agent à ce que la tâche exige uniquement
La confiance s'établit avant l'exécution d'un agent, et c'est là qu'il faut investir le plus d'efforts. Les problèmes détectés à ce stade sont peu coûteux à corriger. Délimiter signifie décider quel travail l'agent prend en charge, quels outils, données et services il peut atteindre, les règles qu'il doit respecter, et quelles décisions restent confiées à une personne.
« Résoudre le problème du client » indique quoi accomplir, mais pas comment l'agent peut agir pour y parvenir. L'agent a toujours besoin de limites sur ce qu'il peut voir, ce qu'il peut faire, et quand il doit s'arrêter et demander. Ne lui accordez que l'accès exigé par sa tâche, et rien de plus. Méfiez-vous des capacités que personne n'a accordées intentionnellement, celles qui sont fournies avec un outil ou un rôle. Accordez un rôle d'administrateur pour une seule tâche, et l'agent peut hériter de permissions sur tout votre environnement.
Le cadrage commence à l’étape de développement, par la manière dont vous définissez l’agent. Kiro, le système de codage agentique, apporte rigueur et pratiques d’ingénierie matures à l’étape de développement des agents. Il transforme une intention de haut niveau en exigences structurées et pilotées par des spécifications, et utilise le raisonnement automatisé pour détecter les contradictions, les ambiguïtés et les lacunes avant l’écriture du moindre code. Kiro dérive également des tests basés sur des propriétés qui vérifient l’implémentation par rapport à ces exigences sur une large gamme d’entrées, attrapant ainsi des bugs difficiles à détecter. Strands fournit une boîte à outils open source pour définir le modèle, les instructions et les outils d’un agent, ainsi qu’un runtime géré pour son exploitation. Quel que soit le framework choisi, la responsabilité de définir le travail de l’agent et ses limites reste la même.
L’étape suivante consiste à transformer ces limites en règles auxquelles vous pourrez tenir l’agent. Amazon Bedrock AgentCore fournit des contrôles de gouvernance pour faire évoluer les agents en toute sécurité et gouverne ce que fait l’agent. À l’aide des Policies dans Bedrock AgentCore, vous décrivez en langage naturel quels outils, API et données l’agent peut atteindre, et le raisonnement automatisé vérifie l’absence de lacunes dans la politique, comme détecter une règle qui accorde trop d’accès, et recherche les contradictions qui rendent une règle impossible à satisfaire, avant son entrée en vigueur.
Cadrer votre agent est la partie la plus difficile, car transformer une intention humaine en politique durable et applicable exige précision et exhaustivité. Cependant, c’est aussi la partie qui rapporte le plus. Tout repose sur ce que vous définissez ici, et plus la politique est précise, plus votre agent peut faire de choses en toute autonomie et en toute sécurité.
Connaissez chaque agent agissant en votre nom, et sous quelle autorité
On ne peut pas gouverner ce qu’on ne voit pas. Les équipes créent des agents plus vite que quiconque ne peut les suivre, et un agent dont personne ne connaît l’existence est un agent que personne ne contrôle. Chaque agent a besoin de sa propre identité, vérifiée à chaque action. Aucune action ne doit être orpheline. Quand quelque chose se passe mal, vous pouvez savoir quel agent a fait quoi, et qui l’a autorisé.
AWS Agent Registry fournit un catalogue géré et approuvé des agents, serveurs Model Context Protocol (MCP), outils et compétences de votre organisation. Les administrateurs utilisent des flux d’approbation pour contrôler ce qui devient détectable et retirer ce qui ne répond plus aux exigences de sécurité, de conformité et de qualité. Les personnes comme les agents peuvent trouver et réutiliser ce qui existe déjà au lieu de le reconstruire. Mais un catalogue ne vous dit que ce qui existe. Une fois les agents connus, AgentCore attribue à chaque agent sa propre identité et la vérifie à chaque requête, si bien que chaque action remonte à un agent spécifique opérant sous une autorité connue. C’est ainsi que vous connaissez chaque agent agissant en votre nom.
Délimitez ce que votre agent dit et fait, dans les limites que vous fixez
Fixer des limites est important parce qu’un agent peut suivre 10 étapes que vous avez approuvées et aboutir malgré tout à un résultat que personne n’avait prévu. Il peut exposer des données sensibles, sortir du sujet ou combiner des actions autorisées d’une manière que vos politiques interdisent. Les limites peuvent échouer dans les deux sens. Trop lâches, et l’agent peut faire ce qu’il ne devrait pas. Trop strictes, et il ne peut plus faire son travail du tout. Laissez donc l’agent choisir comment mener sa tâche, mais ne comptez jamais sur lui pour faire respecter ses propres limites. Ces limites définissent les frontières de l’agent et appartiennent à l’environnement qui l’entoure, appliquées de manière déterministe et évaluées sur la séquence complète des actions, et non une étape à la fois.
C’est ici que la politique définie lors du cadrage prend effet. Policy dans AgentCore l’applique à chaque appel d’outil routé via AgentCore Gateway, un point d’entrée sécurisé pour les agents, les outils et les modèles. Comme l’application des règles se situe en dehors du raisonnement de l’agent, les mêmes vérifications tiennent même lorsque l’agent est bogué, manipulé ou victime d’une injection de prompt : il ne peut pas désactiver un contrôle qu’il n’exécute pas. L’autorité n’a pas non plus à rester figée. Comme le risque d’une tâche évolue au fur et à mesure, temporal policies pondèrent ce qui s’est déjà passé dans une session et ajustent les autorisations à mesure que le travail progresse. Amazon Bedrock Guardrails gouverne ce que dit l’agent et ce qu’on lui dit. Il filtre les contenus nuisibles ou hors sujet et masque les données sensibles. Automated Reasoning checks vont plus loin, prouvant qu’une réponse est cohérente avec la politique que vous avez définie, et non avec l’interprétation qu’en fait le modèle.
Les limites gouvernent aussi ce qu’un agent peut atteindre en premier lieu : quels fichiers il peut toucher, quels services il peut appeler, et quels identifiants il peut utiliser. Strands Box, un bac à sable open source, applique ces limites depuis l’extérieur des instructions de l’agent, de sorte que l’agent puisse travailler avec de vrais outils et de vraies données mais n’atteindre que ce que vous autorisez. Les mêmes limites s’appliquent de la première session locale d’un développeur jusqu’à la production, si bien qu’un agent ne peut pas faire en production ce qu’il ne pouvait pas faire en développement.
Observez ce que votre agent a fait, puis améliorez-le
Même avec un périmètre, une identité et des limites en place, un agent peut répondre en quelques millisecondes, sans aucune erreur et avec tous les tableaux de bord au vert, et quand même faire la mauvaise chose. Il peut avoir récupéré la mauvaise information, choisi le mauvais outil ou suivi un chemin que personne n'attendait. Un système sain n'est pas la même chose qu'une tâche réussie. Pour faire la différence, vous devez reconstituer ce que l'agent a réellement fait : le contexte qu'il a reçu, les outils qu'il a appelés, les décisions de stratégie appliquées et le résultat. Les tests avant le déploiement restent essentiels. La production ajoute des preuves sur le comportement dans des conditions réelles et fournit aux opérateurs ce dont ils ont besoin pour enquêter, intervenir et améliorer.
Amazon CloudWatch Omni est conçu pour l'observation continue. Il capture chaque trace et présente chaque étape qu'un agent a suivie, des appels de modèle aux invocations d'outils, sur une chronologie qu'une équipe peut examiner. Ses évaluateurs intégrés notent les réponses des agents pour des qualités que la surveillance standard ne détecte pas, comme l'exactitude, la fidélité et le choix du bon outil par l'agent. Et les traces où l'agent s'est trompé deviennent le jeu de données contre lequel vous testez le correctif, de sorte que l'exploitation d'un agent et son amélioration s'appuient sur les mêmes preuves.
À quoi ressemble la Trust in Depth en pratique
Un responsable demande à un agent de help desk de désactiver le départ de Sam, un gestionnaire de comptes qui quitte l'entreprise. L'agent doit supprimer l'accès de Sam, transférer sa boîte aux lettres à son successeur et libérer la licence dont l'entreprise n'a plus besoin. Mais les e-mails de Sam peuvent également contenir des preuves nécessaires pour un litige avec un client. La mauvaise séquence pourrait laisser Sam avec un accès après son départ ou mettre ces preuves en danger. La sécurité, la messagerie, le service juridique et les finances ont chacun des exigences que l'agent doit respecter, même si personne n'a scripté le flux de travail complet.
Deux règles régissent la séquence. La connexion de Sam doit être bloquée avant que sa boîte aux lettres puisse être convertie et partagée avec son successeur. Avant de modifier sa licence de messagerie, l'agent doit vérifier l'existence d'un blocage juridique, une exigence de conservation des enregistrements pour un litige, et confirmer que la modification maintient ces enregistrements protégés.
Scope. Avant que l'agent ne s'exécute, l'équipe écrit ces règles sous forme de politiques dans AgentCore. Chaque politique exige que l'étape préalable ait déjà réussi pour le compte de Sam avant que l'étape suivante puisse s'exécuter. L'agent reçoit exactement six outils : bloquer la connexion, vérifier les blocages juridiques, placer un blocage, convertir une boîte aux lettres, donner l'accès au successeur et modifier une licence. Il ne reçoit aucun outil pour supprimer le compte, car la boîte aux lettres partagée nécessite que le compte survive.
Know. L'agent possède sa propre identité, de sorte que chaque modification du compte de Sam lui est attribuable.
Bound. L'agent tente de convertir la boîte aux lettres de Sam en une boîte partagée pour Priya, la successeure. La politique dans AgentCore, appliquée au niveau de l'AgentCore Gateway, bloque l'appel : Sam peut toujours se connecter, et la conversion de la boîte aux lettres ne changerait pas son mot de passe, donc ses anciens identifiants ouvriraient toujours la boîte. L'agent bloque la connexion de Sam, puis convertit la boîte aux lettres et donne l'accès à Priya. Ensuite, il passe à la demande réelle du responsable, à savoir libérer la licence, mais la passerelle bloque également cela, car personne n'a vérifié la liste des blocages du service juridique. L'agent vérifie et découvre que le service juridique exige que les e-mails de Sam soient conservés pour un litige avec un client. Il place le blocage, confirme qu'il est en vigueur, puis modifie la licence de Sam pour une licence qui prend en charge cette protection. L'entreprise peut récupérer la licence plus étendue tout en préservant les preuves.
Observe. Chaque étape est enregistrée : ce que l'agent a tenté de faire, ce que les règles ont décidé, le blocage et le résultat.
L'agent a accompli la tâche sans qu'une personne n'approuve chaque étape. Ses autorisations ont limité ce qu'il pouvait modifier, son identité a rendu ces modifications traçables, et les politiques l'ont empêché d'agir avant que les garanties requises ne soient en place. Les étapes enregistrées permettent à l'équipe de vérifier que l'accès de Sam a été bloqué, que sa successeure pouvait utiliser la boîte aux lettres et que les preuves requises sont restées protégées.
Ce qui devient possible lorsque les agents sont dignes de confiance
AWS réunit ces couches afin que vous puissiez délimiter un agent selon sa fonction, savoir quels agents agissent pour vous, limiter ce qu'ils font et disent, voir ce qu'ils ont fait et vous améliorer au fil du temps, et prouver que vos règles tiennent partout où elles peuvent être énoncées avec précision. Aucune couche ne mérite cette confiance à elle seule. Ensemble, elles constituent la Trust in Depth, et ce sont elles qui transforment un agent capable en un agent auquel on peut faire confiance pour accomplir un travail important.
Vous tracez les limites : ce qu'un agent peut faire de son propre chef, ce qui nécessite l'approbation d'une personne, et quand il doit s'arrêter. Cela libère vos équipes pour ce que seuls les humains peuvent faire : peser les décisions difficiles, résoudre les zones grises et assumer les décisions que vous choisissez de garder entre des mains humaines. À mesure que les preuves s'accumulent qu'un agent reste dans ces limites, vous pouvez élargir ou restreindre ses responsabilités.
Chez AWS, nous croyons que chaque organisation qui déploie des agents, sur n'importe quelle plateforme, devrait pouvoir répondre à ces quatre questions avec des preuves, et avec une démonstration partout où c'est applicable. C'est la barre qu'AWS construit pour nos clients, et celle à laquelle nous invitons l'industrie à se soumettre. La Defense in Depth a rendu sûr le fait de connecter des systèmes au monde. La Trust in Depth rend sûr le fait de laisser les agents agir de manière autonome au sein de ce monde.
Commencez avec un agent, un flux de travail et une limite que vous pouvez prouver. Puis élargissez à mesure que la confiance est gagnée.
Pour commencer à mettre en œuvre des règles applicables, explorez Policy in Amazon Bedrock AgentCore et Automated Reasoning checks in Amazon Bedrock Guardrails.