
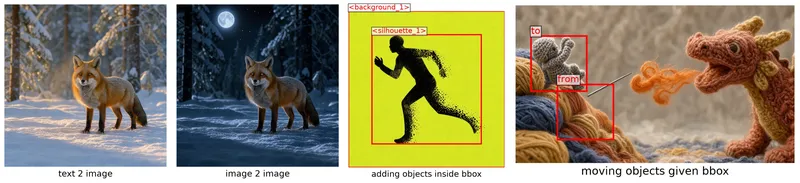
Black Forest Labs FLUX.3 Image Klein est là, et il fonctionne dans Diffusers dès le premier jour. Un seul modèle fait du texte-vers-image et de l'image-vers-image multi-références, et il ajoute quelque chose de nouveau, la contrôle de la mise en page. Vous écrivez des boîtes englobantes dans le prompt pour indiquer où chaque partie de l'image doit se placer, ou quelles parties d'une image de référence déplacer.
Les deux checkpoints ouverts se trouvent dans la collection FLUX.3 Image Klein:
| Checkpoint | Ce que c'est | Valeurs par défaut |
|---|---|---|
black-forest-labs/flux-3-image-klein |
Distillé en pas de temps, pour une inférence rapide | 16 étapes, sans CFG |
black-forest-labs/flux-3-image-klein-base |
Modèle de base | 50 étapes, CFG |

Vous pouvez vous rendre sur l' espace Hugging Face et générer quelques images dès maintenant !
TL;DR
- Un seul modèle pour le texte-vers-image, l'image-vers-image multi-références et le contrôle de mise en page par boîtes englobantes.
- Le checkpoint distillé génère une image de 1024 × 1024 en environ 2 secondes sur un H100.
- Les poids NVFP4 et FP8 se chargent avec
from_single_file, pour les GPU plus petits. - Scripts d'entraînement LoRA pour le texte-vers-image et l'édition d'images.
- Livré sous forme de pipeline Modular Diffusers , vous pouvez donc retirer des blocs ou ajouter les vôtres.
Contenu
- Premiers pas
- Ce que FLUX.3 peut faire
- Modèle de base et variantes quantifiées
- Finetuning LoRA
- Ce que cela coûte à exécuter
- L'architecture
- Modular Diffusers
- Essayez-le
Pour commencer
Installez la dernière version diffusers et transformers (pour l'encodeur de texte Qwen3-VL) :
pip install -U diffusers transformers
Chargez le checkpoint distillé et générez une image :
import torch
from diffusers import ModularPipeline

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein")
pipe.load_components(dtype=torch.bfloat16)
pipe.to("cuda")

pipe(prompt="a red fox", output="images")[0].save("fox.png")
Ce que FLUX.3 peut faire
Texte vers image
FLUX.3 répond mieux à une description complète de la scène, avec le sujet, le décor, la lumière, la composition et le style. Le guide officiel de prompting de Black Forest Labs contient davantage de conseils. Le checkpoint distillé génère une 1024 × 1024 image en 16 étapes par défaut. Passez height, width, ou num_inference_steps pour les modifier.
prompt = (
    "A wide-angle wildlife photograph of a red fox standing alert in a snow-covered forest clearing at golden hour. "
    "The fox is centered in the frame, its thick orange winter coat contrasting with the fresh white snow, breath "
    "visible in the cold air. Snow-laden pine trees fill the softly blurred background, and low warm sunlight rakes "
    "across the scene from the left, casting long blue shadows."
)

fox = pipe(
    prompt=prompt,
    generator=torch.Generator().manual_seed(0),
    output="images"
)[0]
fox.save("fox.png")
 |
|---|
| Texte vers image |
Image vers image
Passez une image de référence (ou plusieurs) avec l'argument image Écrivez le prompt comme une légende de l'image que vous voulez, avec la modification incluse.
prompt = (
    "The same red fox in the same snow-covered forest clearing, now at night under a full moon: cool blue "
    "moonlight, deep shadows, stars visible through the pine branches, the fox's eyes catching the light."
)
night = pipe(
    prompt=prompt,
    image=fox, # from the previous text to image example
    generator=torch.Generator().manual_seed(0),
    output="images",
)[0]
night.save("night.png")
 |
|---|
| Image vers image |
Avec plusieurs références, désignez-les dans le prompt comme <ref_image_0>, <ref_image_1>, ... dans l'ordre où elles sont passées à image:
red_fox = pipe(prompt="a red fox", generator=torch.Generator().manual_seed(0), output="images")[0]
bench = pipe(prompt="a wooden bench", generator=torch.Generator().manual_seed(0), output="images")[0]

combined = pipe(
    prompt="The fox from <ref_image_0> sitting on the wooden bench from <ref_image_1> in a snowy setting.",
    image=[red_fox, bench],
    output="images",
)[0]

combined.save("combined.png")
 |
 |
 |
|---|---|---|
<ref_image_0>: un renard roux |
<ref_image_1>: un banc en bois |
Le renard sur le banc |
Contrôle de la mise en page
Ajoutez une liste JSON de régions après la légende. Chaque région a un id, un bboxet un desc, et la légende la mentionne comme <id>.
Les boîtes sont écrites avec
[y_min, x_min, y_max, x_max], y en premier, sur une échelle de 0–1000. Comme l'échelle est normalisée, la même boîte fonctionne à n'importe quelle taille d'image.
Placer des régions dans une nouvelle image
layout_prompt = (
    "Minimalist graphic illustration featuring a black silhouette of a person <silhouette_1> centered against a "
    "solid, vibrant chartreuse background <background_1>. The figure is captured in a dynamic, mid-stride running "
    "pose, facing toward the left side of the frame. "
    '[{"id": "background_1", "bbox": [0, 0, 1000, 1000], "desc": "A flat field of neon yellow-green with a subtle '
    'paper texture and fine, organic grain."}, {"id": "silhouette_1", "bbox": [150, 150, 850, 850], "desc": "A '
    "black silhouette of a person in motion, made of dense stippled ink. The leading edges are solid; the trailing "
    'arm and leg dissolve into coarse square pixels and scattered dots."}]'
)

runner = pipe(prompt=layout_prompt, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
Le desc de chaque région est dessiné à l'intérieur de son bbox |
Déplacer des régions dans une image de référence
Pour les modifications, chaque région indique d'où vient son contenu de (src_bbox dans la référence) et où il va (tgt_bbox dans la sortie). Une région présentant les deux mêmes boîtes reste là où elle est.
Cet exemple déplace le chevalier tricoté vers le haut et vers la gauche, et épingle la toile de fond, la falaise, l'aiguille, le dragon et le feu :
from diffusers.utils import load_image

knight_image = load_image("knight_orig.png")
edit_prompt = (
    "In <ref_image_0>, move the miniature grey amigurumi knight figure <knight_1> upwards and to the left along the "
    "yarn cliff <cliff_1>. Keep the rest of the image completely unchanged, preserving the blurred yarn backdrop "
    "<backdrop_1>, the large knitted dragon <dragon_1>, and the fiery orange thread <fire_1>. "
    '[{"id": "knight_1", "from": "ref_image_0", "src_bbox": [500, 150, 850, 350], "tgt_bbox": [194, 55, 544, 255], '
    '"desc": "A miniature amigurumi knight crocheted from thick grey woolen yarn."}, '
    '{"id": "backdrop_1", "from": "ref_image_0", "src_bbox": [0, 0, 1000, 1000], "tgt_bbox": [0, 0, 1000, 1000], '
    '"desc": "A soft, out-of-focus backdrop of cream and indigo knitted yarn."}, '
    '{"id": "cliff_1", "from": "ref_image_0", "src_bbox": [300, 0, 1000, 450], "tgt_bbox": [300, 0, 1000, 450], '
    '"desc": "A steep cliff of stacked yarn skeins in mustard, terracotta, and indigo."}, '
    '{"id": "needle_1", "from": "ref_image_0", "src_bbox": [420, 250, 550, 450], "tgt_bbox": [420, 250, 550, 450], '
    '"desc": "An oversized polished steel tapestry needle."}, '
    '{"id": "dragon_1", "from": "ref_image_0", "src_bbox": [100, 600, 950, 1000], "tgt_bbox": [100, 600, 950, 1000], '
    '"desc": "A large, fluffy knitted dragon in terracotta and mustard yarn."}, '
    '{"id": "fire_1", "from": "ref_image_0", "src_bbox": [350, 400, 650, 650], "tgt_bbox": [350, 400, 650, 650], '
    '"desc": "Curled puffs of fiery orange angora thread suspended in mid-air."}]'
)

moved = pipe(prompt=edit_prompt, image=knight_image, generator=torch.Generator().manual_seed(0), output="images")[0]
 |
|---|
Le chevalier passe de son src_bbox à son tgt_bbox, et le reste de la scène reste en place |
Modèle de base et variantes quantisées
Modèle de base
Tout ce qui précède utilise le point de contrôle distillé. Le point de contrôle de base exécute 50 étapes avec le classifier-free guidance, et c'est celui à affiner (voir Affinage LoRA).
pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein-base")
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

pipe.guider = pipe.guider.new(guidance_scale=5.0)  # optional
image = pipe(prompt=prompt, output="images")[0]
Points de contrôle au format fichier unique
Black Forest Labs fournit également le transformateur sous forme de fichier unique, en bf16 et dans deux formats quantisés : fp8r (FP8 par ligne) et nvfp4. Chargez l'un d'eux avec from_single_file, puis chargez les autres composants par nom afin que le transformateur bf16 ne soit pas téléchargé lui aussi.
from diffusers import BFLQuantizationConfig, Flux3Transformer2DModel, ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"
variant = "fp8r"  # or "nvfp4"

transformer = Flux3Transformer2DModel.from_single_file(
    f"https://huggingface.co/{model_id}/blob/main/variants/{variant}/model.safetensors",
    config=model_id,
    subfolder="transformer",
    quantization_config=BFLQuantizationConfig(compute_dtype=torch.bfloat16),
    dtype=torch.bfloat16,
)

pipe = ModularPipeline.from_pretrained(model_id)
pipe.load_components(dtype=torch.bfloat16)
pipe.update_components(transformer=transformer)
pipe.to("cuda")
Pour le fichier unique non quantisé, utilisez https://huggingface.co/{model_id}/blob/main/model.safetensors et omettez quantization_config.
| Variante | Kernels rapides sur | Autres GPU |
|---|---|---|
fp8r |
Capacité de calcul 8.9+ (Ada, Hopper, Blackwell) | Les poids sont déquantisés à chaque étape : mémoire réduite, aucun gain de vitesse |
nvfp4 |
Blackwell, avec flashinfer-python et flashinfer-cubin à la même version |
Identique à ce qui précède |
Fine-tuning LoRA
FLUX.3 fonctionne à la fois en texte-vers-image et en image-vers-image, ce qui en fait une excellente base pour des LoRAs personnalisés. diffusers fournit des scripts d'entraînement DreamBooth LoRA pour les deux tâches (vous pouvez aussi entraîner avec l'AI Toolkit d'Ostris).
Voici un exemple de texte-vers-image qui apprend un style de carte de tarot à partir du jeu de données multimodalart/1920-raider-waite-tarot-public-domain déclenché avec trtcrd:
accelerate launch train_dreambooth_lora_flux3_klein.py \
  --pretrained_model_name_or_path="black-forest-labs/flux-3-image-klein-base" \
  --dataset_name="multimodalart/1920-raider-waite-tarot-public-domain" \
  --caption_column="caption" \
  --instance_prompt="trtcrd" \
  --output_dir="trained-flux3-tarot-lora" \
  --mixed_precision="bf16" \
  --resolution=1024 \
  --use_aspect_ratio_buckets \
  --train_batch_size=1 \
  --rank=16 \
  --lora_alpha=16 \
  --learning_rate=1e-4 \
  --lr_scheduler="constant" \
  --max_train_steps=1500 \
  --validation_prompt="a trtcrd of a cat, tarot style" \
  --validation_epochs=25 \
  --seed=0 \
  --push_to_hub
Pour réduire l'utilisation de la mémoire, ajoutez quelques options d'optimisation :
  --gradient_checkpointing \
  --cache_latents \
  --use_8bit_adam
--gradient_checkpointingrecalcule les activations lors de la passe arrière (moins de VRAM, légèrement plus lent),--cache_latentspré-encode les images et libère le VAE, et--use_8bit_adamconserve les états de l'optimiseur en 8 bits.
Quelques paramètres méritent d'être expérimentés. La grille ci-dessous entraîne le même style de tarot avec différents rangs de LoRA et optimiseurs ; les adaptateurs sont disponibles sur le Hub à l'adresse diffusers-modular/flux3-tarot-lora. D'autres fonctionnalités et configurations d'entraînement sont documentées dans le README DreamBooth FLUX.3.

Pour l'édition basée sur des instructions, le script image-vers-image (train_dreambooth_lora_flux3_klein_img2img.py) s'entraîne sur des triplets (image de référence, image cible, instruction), où la référence est désignée dans le prompt par <ref_image_0>.
Consultez le README DreamBooth FLUX.3 pour toutes les options et l'exemple complet d'image-vers-image.
Ce que cela coûte à exécuter
Dans cette section, nous allons parler de la consommation mémoire et de la vitesse de génération des modèles.
Mémoire
| nom | pic alloué (après chargement) Gio | pic alloué (après inférence) Gio |
|---|---|---|
| nvfp4 (RTX6000) | 13.4 | 15.3 |
| fp8r (H100) | 14.35 | 16.27 |
| bf16 (H100) | 18.80 | 20.72 |
Si vous avez moins de mémoire :
- Charger un transformer quantifié.
- Exécutez l'encodeur de texte séparément puis libérez-le. Il ne s'exécute qu'une seule fois par image, avant le débruitage (voir Encoder une fois, générer plusieurs fois).
- Activez le déchargement automatique vers le CPU, qui déplace chaque composant vers le GPU uniquement pendant son exécution (nous n'avons pas fait de benchmark)
from diffusers import ComponentsManager, ModularPipeline

manager = ComponentsManager()
manager.enable_auto_cpu_offload(device="cuda")

pipe = ModularPipeline.from_pretrained("black-forest-labs/flux-3-image-klein", components_manager=manager)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
# no pipe.to("cuda"): the manager handles device placement
Vitesse
Temps de bout en bout pour le checkpoint distillé (16 étapes), moyenné sur trois exécutions après un échauffement :
| Workflow | Taille de sortie | Temps | Mémoire maximale |
|---|---|---|---|
| Texte vers image | 1024 × 1024 | 1.93 s | 23,8 GiB |
| Image vers image, une référence de 1024 × 1024 | 1024 × 1024 | 3,87 s | 23,8 GiB |
| Édition de mise en page (le cavalier), une référence de 1360 × 768 | 1360 × 768 | 4,10 s | 23,8 GiB |
Un seul NVIDIA H100 80GB, sans déchargement, backend d'attention par défaut.
Une image de référence double environ le temps. Les tokens de référence rejoignent la même séquence que le texte et l'image en cours de génération, ainsi une référence de 1024 × 1024 ajoute 4,096 tokens à chaque appel du transformer
 |
|---|
| Barres empilées de tokens par appel du transformer : texte vers image 4,256 tokens ; image vers image 8,272 ; mise en page texte vers image 4,336 ; mise en page image vers image 8,800 |
L'architecture
Ouvrons le modèle pièce par pièce. Le modèle prend trois sortes de tokens :
- le texte
- l' image bruitée en cours de génération
- et en option des images de référence
Des pixels aux tokens
FLUX.3 est un modèle de flux en espace latent pour la génération d'images. Cela signifie que le débruiteur prend des latents en entrée et produit des latents en sortie. Nous utilisons un VAE pour ramener les latents aux pixels. FLUX.3 utilise la même architecture de VAE que Flux.2.
Le VAE de FLUX.2 compresse une image 8× dans chaque direction en 32 canaux, puis chaque patch de 2 × 2 de ce latent est regroupé en un seul token de 128 canaux.
Ainsi un token couvre un patch de 16 × 16 pixels, et une image de 1024 × 1024 devient une grille de 64 × 64 de 4,096 tokens. L'image bruitée commence comme un bruit aléatoire d'exactement cette forme. Une image de référence passe par le même encodeur VAE et le même regroupement, et conserve sa propre taille.
Du prompt aux tokens
L'encodeur de texte est Qwen3-VL, un modèle vision-langage. FLUX.3 ne se contente pas de sa dernière couche. Il lit les états cachés de huit de ses 36 couches (couches 4, 8, …, 32) et les empile, de sorte que chaque token de texte devient un vecteur de 8 × 2560 = 20,480 dimensions avant qu'une couche linéaire ne le projette à la largeur de 3072 du transformer.
Cela donne au transformer des caractéristiques issues de plusieurs profondeurs du modèle de langage, et pas seulement de sa couche finale. Le prompt est complété à un multiple de 80 tokens, et le transformer prête attention au remplissage aussi, c'est pourquoi le pipeline prend un prompt par appel.
Deux étapes
Le transformer traite les tokens en deux étapes :
- Étape 1 : blocs par mode. Chaque flux passe par 5 blocs avec ses propres poids. Le texte a ses propres blocs, l'image bruitée a les siens, et les images de référence ont les leurs.
- Étape 2 : les blocs joints. Les flux sont concaténés en une seule séquence,
[text | image | reference], qui passe par 28 blocs partageant un seul ensemble de poids.
Les deux étapes diffèrent par qui peut assister qui.
Dans l'étape 1, chaque flux ne s'occupe que de lui-même, ainsi chaque type de token est d'abord raffiné selon ses propres termes. Dans l'étape 2, tout s'occupe de tout, où l'image apprend du texte et des références. À titre de comparaison, les blocs double-stream de FLUX.2 donnent aussi au texte et à l'image des poids séparés, mais les laissent s'occuper l'un de l'autre dès le départ. FLUX.3 garde d'abord les flux entièrement séparés, puis les fusionne.
À la fin, les tokens de texte et de référence sont simplement supprimés. Seuls les tokens d'image passent par les couches de sortie, qui prédisent comment les déplacer d'un pas vers une image propre.
À l'intérieur d'un bloc
Chaque bloc, dans l'une ou l'autre étape, a la même forme. L'attention et le MLP s'exécutent en parallèle sur la même entrée normalisée, et leur somme est rajoutée au flux résiduel.
Chaque bloc commence par un LayerNorm qui n'a pas d'échelle ni de décalage appris en propre. L'échelle, le décalage et la porte viennent d'un embedding de pas de temps à la place (cela s'appelle modulation). Dans l'attention, les queries et les keys sont normalisées par RMS et reçoivent des rotary position embeddings (RoPE), que nous examinons ci-dessous.
Dans un bloc joint, tous les tokens partagent les mêmes poids, mais les tokens de texte, d'image et de référence ont chacun leur propre échelle, décalage et porte (gate).
def block(x, shift, scale, gate):      # shift, scale, gate come from the token's timestep embedding
    h = layer_norm(x)                  # no learned scale or shift
    h = (1 + scale) * h + shift
    q, k, v = to_q(h), to_k(h), to_v(h)
    q, k = rope(rms_norm(q)), rope(rms_norm(k))
    out = attention(q, k, v) + mlp(h)  # parallel, MLP is SwiGLU
    return x + gate * out
Chaque token reçoit son propre pas de temps
Dans FLUX.1 et FLUX.2, une seule incorporation (embedding) de pas de temps module tous les tokens. Dans FLUX.3, la modulation dépend du type de token.
Les tokens d'image bruités sont modulés par le pas de temps courant t. Les tokens de texte et de référence sont toujours modulés par le pas de temps 0, ce qui signifie « propre, rien à débruiter ici ». Ainsi, même une référence qui ressemble presque au résultat est marquée comme contexte donné, et non comme quelque chose à générer.
Le checkpoint distillé est une carte de flux. On lui indique également le pas de temps vers lequel chaque étape saute. Ce second pas de temps reçoit sa propre incorporation, qui est ajoutée à la modulation de chaque token, de sorte que chacune de ses 16 étapes peut faire un saut plus grand.
Des positions en quatre dimensions
L'attention seule ne sait pas où se trouve un token (ce phénomène s'appelle l'équivariance à la permutation). RoPE résout cela en faisant tourner chaque requête et chaque clé d'une quantité qui dépend de la position du token. FLUX.3 utilise quatre axes de position, (t, h, w, l) (pas de temps, hauteur, largeur, longueur de séquence), et donne à chacun un quart (32 dimensions) de chaque tête d'attention de 128 dimensions :
| Tokens | t : pas de temps | h : hauteur | w : largeur | l : longueur de séquence |
|---|---|---|---|---|
| token de texte i | 0 | 0 | 0 | i |
| token d'image en (ligne, colonne) | 0 | ligne / 2 | colonne / 2 | 0 |
| référence k en (ligne, colonne) | 0 | ligne / 2 | colonne / 2 | −(k + 1) |
Les tokens de texte s'alignent le long de l, comme les mots d'une phrase. L'image et les références sont des grilles 2D en (h, w), séparées les unes des autres le long de l. Comme une référence utilise les mêmes (h, w) coordonnées que la sortie, « le même endroit dans la référence » a un sens précis pour le modèle, et c'est ce sur quoi repose src_bbox / tgt_bbox l'édition.
La boucle de débruitage
FLUX.3 est un modèle de flow matching. La génération part d'un bruit pur, et à chacune des 50 étapes le transformeur prédit une vitesse. C'est la direction allant du bruit vers une image nette. Le scheduler fait un pas dans cette direction.
À chaque étape, on peut aussi lire la supposition actuelle du modèle quant à l'image finale. Décoder cette supposition à quelques étapes montre comment l'image prend forme :
 |
 |
||||
|---|---|---|---|---|---|
| Étape 1 | Étape 5 | Étape 10 | Étape 15 | Étape 25 | Étape 50 |
Le renard, sa pose et la lumière sont déjà en place à l'étape 10, alors que le niveau de bruit est encore de 0.97. Les branches chargées de neige et la texture de la fourrure n'apparaissent que dans les dernières étapes. Le scheduler de FLUX.3 utilise un grand décalage temporel (6.93), ce qui maintient le niveau de bruit élevé pendant la majeure partie de l'exécution : 44 des 50 étapes se déroulent au-dessus de σ = 0.5. Nous avons construit cette figure en ajoutant un petit bloc au pipeline, ce qui nous amène à Modular Diffusers.
Si vous débutez avec le flow matching, nous proposons un guide pour débutants didacticiel convivial et un vidéo pour que vous compreniez comment cela fonctionne.
Diffuseurs modulaires
FLUX.3 est livré sous la forme d'un Modular Diffusers pipeline.
Voir les flux de travail
Vous pouvez lister les workflows et afficher les blocs exacts de chacun, sans charger aucun poids.
from diffusers import Flux3AutoBlocks

blocks = Flux3AutoBlocks()
print(blocks.available_workflows)
# ['text2image', 'image_conditioned']

print(list(blocks.get_workflow("text2image").sub_blocks))
# ['text_encoder', 'denoise.input', 'denoise.prepare_latents', 'denoise.set_timesteps',
#  'denoise.prepare_rope_inputs', 'denoise.denoise', 'denoise.after_denoise', 'decode']
get_workflow() résout les branches auto et vous donne la séquence simple d'étapes qui s'exécutera. print(blocks.get_workflow("image_conditioned").doc) affiche les composants, les entrées, les valeurs par défaut et les sorties de ce workflow.
Encoder une fois, générer plusieurs fois
Sortez l'encodeur de texte, encodez le prompt une seule fois, libérez-le, puis générez à partir des embeddings mis en cache.
import torch
from diffusers import ModularPipeline

model_id = "black-forest-labs/flux-3-image-klein-base"

blocks = ModularPipeline.from_pretrained(model_id).blocks
text_blocks = blocks.sub_blocks.pop("text_encoder")  # `blocks` now starts at the VAE encoder

text_pipe = text_blocks.init_pipeline(model_id)
text_pipe.load_components(dtype=torch.bfloat16)
text_pipe.to("cuda")

state = text_pipe(prompt=prompt, negative_prompt="")  # no guider here, so ask for the negative embeddings

prompt_embeds = state.get("prompt_embeds")
negative_prompt_embeds = state.get("negative_prompt_embeds")

del text_pipe
torch.cuda.empty_cache()

image_pipe = blocks.init_pipeline(model_id)  # no text encoder to load
image_pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
image_pipe.to("cuda")

for seed in range(3):
    image = image_pipe(
        prompt_embeds=prompt_embeds,
        negative_prompt_embeds=negative_prompt_embeds,
        generator=torch.Generator().manual_seed(seed),
        output="images",
    )[0]
    image.save(f"{seed}.png")
Ajoutez une étape à l'intérieur de la boucle
La figure de débruitage ci-dessus provient d'un bloc supplémentaire qui enregistre, à chaque étape, l'estimation par le modèle de l'image propre :
from diffusers.modular_pipelines import Flux3AutoBlocks, InputParam, ModularPipelineBlocks, OutputParam


class Flux3PreviewStep(ModularPipelineBlocks):
    model_name = "flux3"

    @property
    def inputs(self):
        return [InputParam("latents"), InputParam("noise_pred")]

    @property
    def intermediate_outputs(self):
        return [OutputParam("x0_previews", type_hint=list)]

    @torch.no_grad()
    def __call__(self, components, block_state, i, t):
        if i == 0:
            block_state.x0_previews = []
        sigma = t / 1000  # timesteps are sigmas scaled to [0, 1000]
        block_state.x0_previews.append(block_state.latents - sigma * block_state.noise_pred)  # x0 = x_t - sigma * v
        return components, block_state


blocks = Flux3AutoBlocks()
denoise_loop = blocks.sub_blocks["denoise"].sub_blocks["text2image"].sub_blocks["denoise"]
denoise_loop.sub_blocks.insert("preview", Flux3PreviewStep(), 1)  # between "denoiser" and "after_denoiser"

pipe = blocks.init_pipeline(model_id)
pipe.load_components(dtype={"vae": torch.float32, "default": torch.bfloat16})
pipe.to("cuda")

out = pipe(prompt=prompt, generator=torch.Generator().manual_seed(0), output=["x0_previews", "images"])
Essayez
- Modèles : FLUX.3 Image Klein collection
- Documentation : FLUX.3 dans Diffusers
- Fine-tuning : Scripts LoRA DreamBooth
- Prompting : Guide d'incitation de Black Forest Labs
Vous avez créé quelque chose avec FLUX.3 ? Partagez vos LoRAs et vos pipelines sur le Hub. Nous serions ravis de les découvrir ! 😎