IT之家 le 15 octobre, Nvidia a annoncé le lancement du modèle multimodal ouvert Nemotron 3.5 Super VL, destiné aux agents d'IA qui doivent fonctionner en continu et exécuter des tâches en plusieurs étapes.
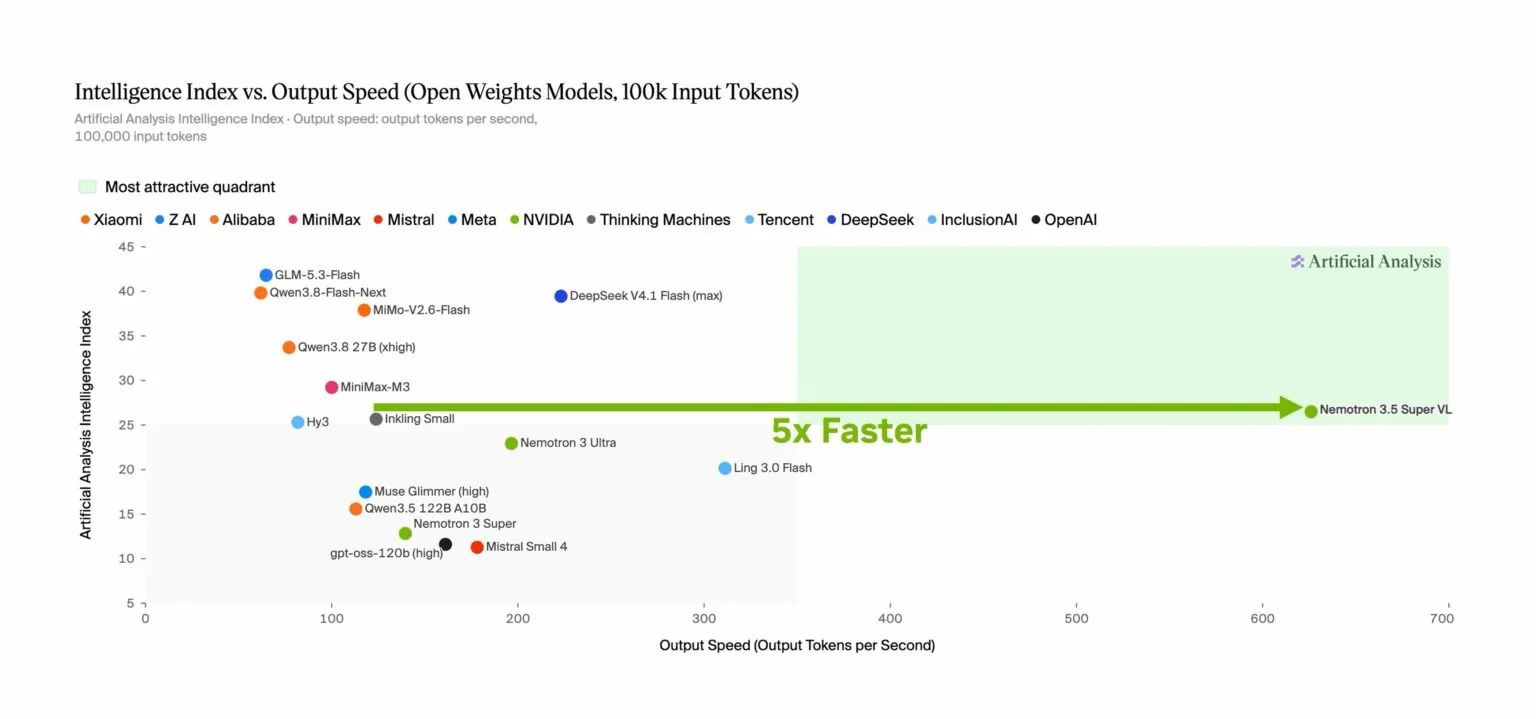
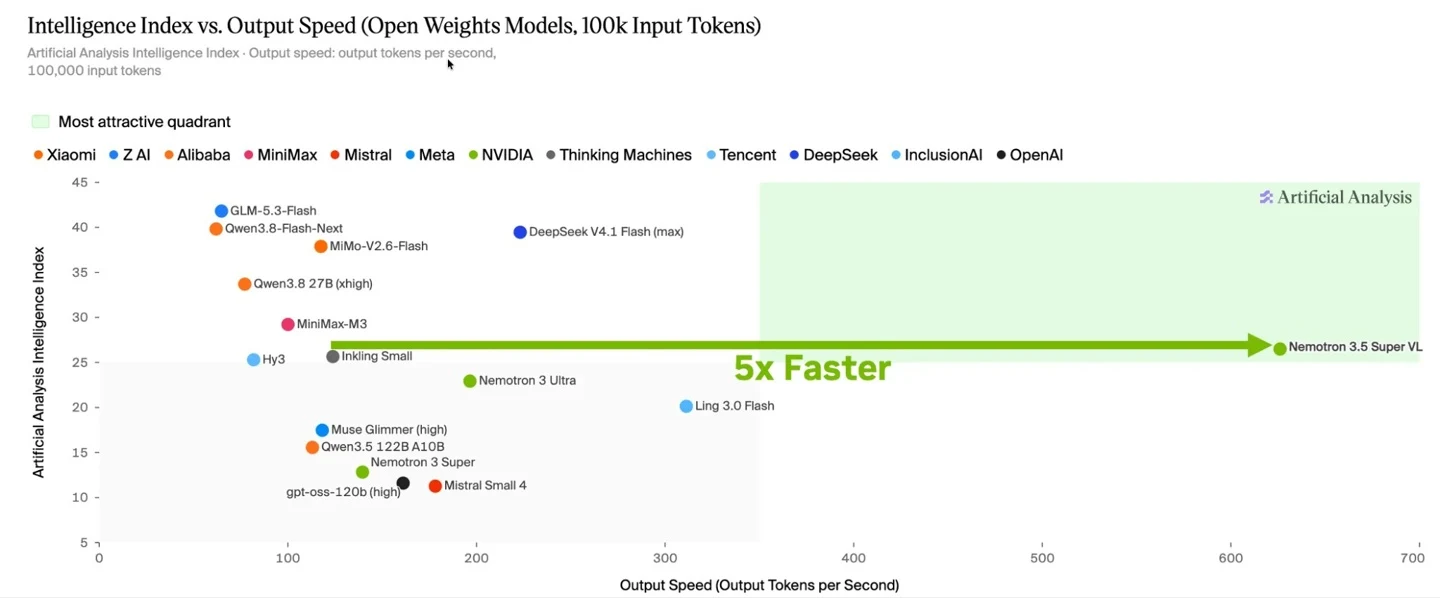
Le modèle adopte une architecture de mélange d'experts (MoE), avec un total de 120 milliards de paramètres, dont 12 milliards activés. Selon Nvidia, lors de l'exécution de tâches d'agents sur un seul GPU, le débit du modèle peut atteindre jusqu'à 5 fois celui d'autres modèles ouverts de taille comparable.
Nemotron 3.5 Super VL intègre dans un même modèle des capacités de raisonnement, de suivi d'instructions et d'appel d'outils, ainsi que des capacités de compréhension du texte, des images, des documents et des vidéos ; il peut être utilisé pour des scénarios tels que le test et le débogage de code, la recherche d'informations multi-sites, l'analyse de documents, la détection de menaces de cybersécurité et la recherche dans le contenu vidéo. Les développeurs peuvent utiliser la chaîne d'outils NeMo de Nvidia pour effectuer un post-entraînement avec leurs propres données, outils, politiques et flux de travail, et ajuster le comportement du modèle selon leurs besoins métier.
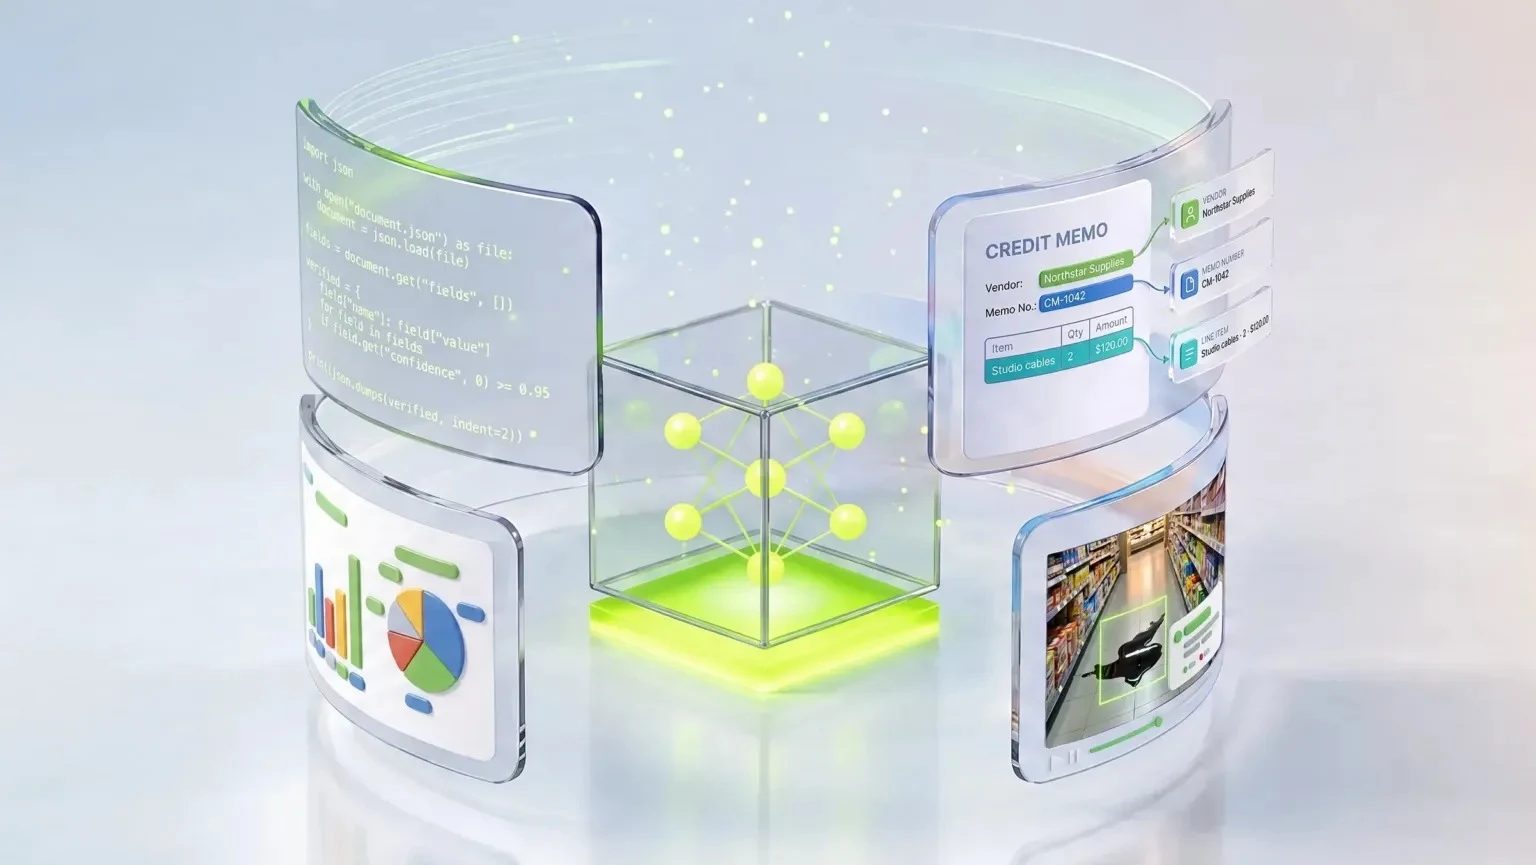
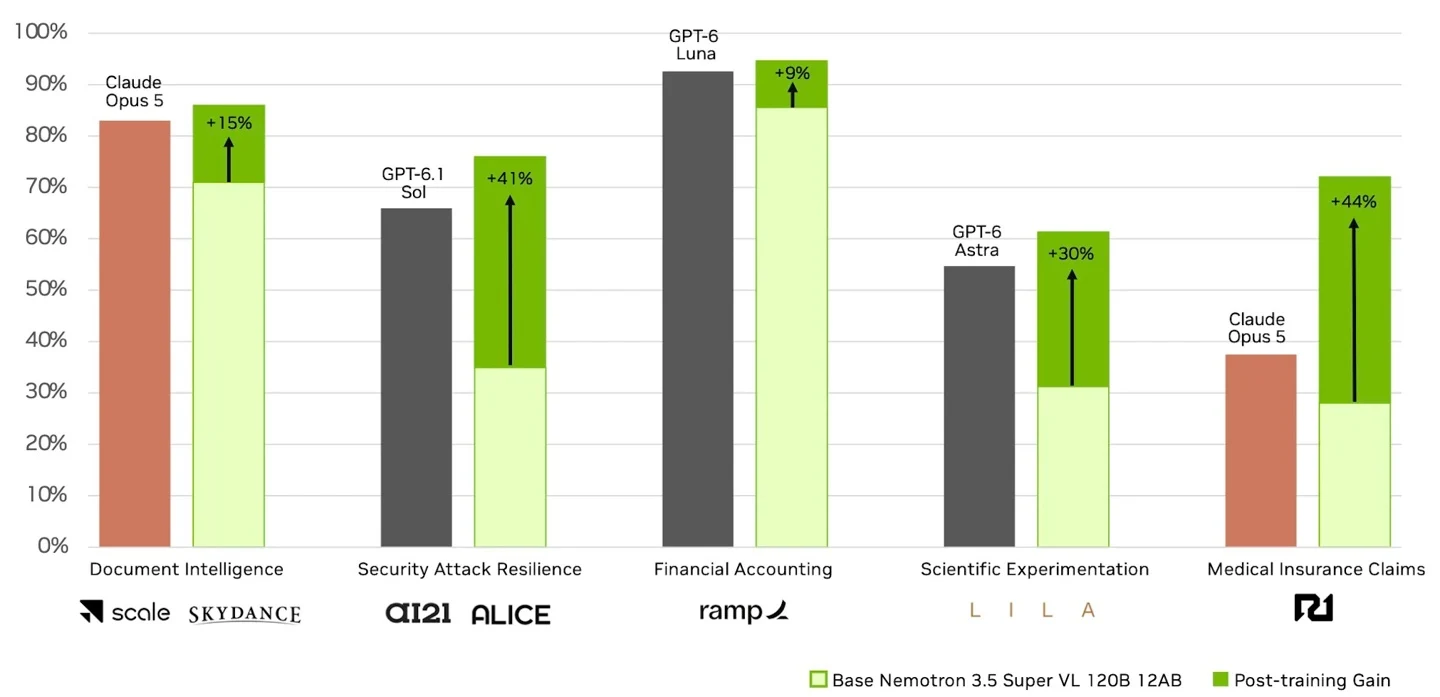
Nvidia a également publié plusieurs cas de personnalisation en entreprise. Par exemple, le fournisseur de technologies de données IA Scale AI a personnalisé pour la société de médias et de divertissement Skydance Corporation un agent de traitement du crédit fournisseurs, avec une réduction prévue de 97,5 % des coûts d'inférence et de 80 % de la latence pour ces charges de travail.
La plateforme d'opérations financières Ramp convertit les images de reçus en données JSON structurées contenant le commerçant, la date et les informations de paiement, avec un débit prévu jusqu'à 50 % plus élevé et une latence réduite de 90 %. AI21 a collaboré avec la société de sécurité IA Alice pour personnaliser un modèle destiné au renseignement sur les menaces et à l'analyse des vulnérabilités, avec une précision améliorée de 40 % sur les tâches concernées.
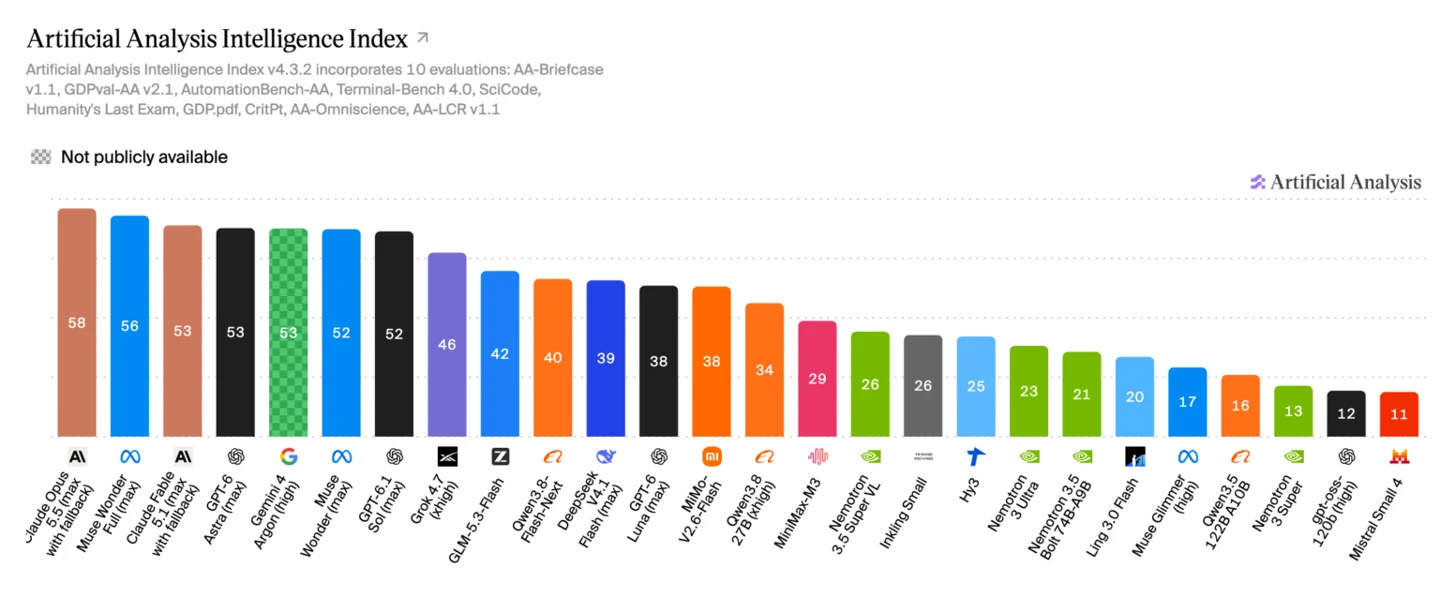
En matière d'évaluation, Nvidia indique que Nemotron 3.5 Super VL obtient un score de 80,8 % au benchmark de raisonnement sur graphiques CharXiv, supérieur aux 63 % de Nemotron 3 Nano Omni ; en combinant l'interprétation de code Python, le score atteint 84 %.
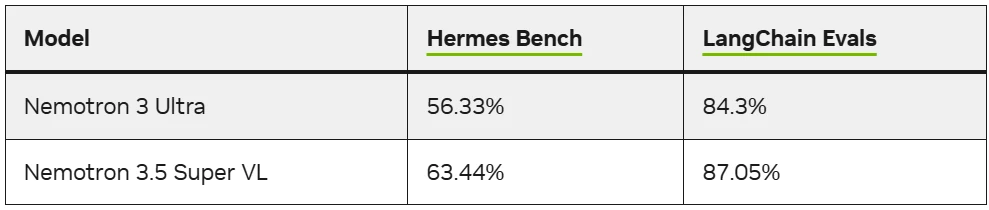
Dans les évaluations comportementales Hermes Bench et LangChain, le modèle obtient respectivement 63,44 % et 87,05 %, supérieur aux 56,33 % et 84,3 % de Nemotron 3 Ultra. Nvidia ajoute que le modèle figure parmi les modèles ouverts les mieux classés sur le classement OCRBench v2.
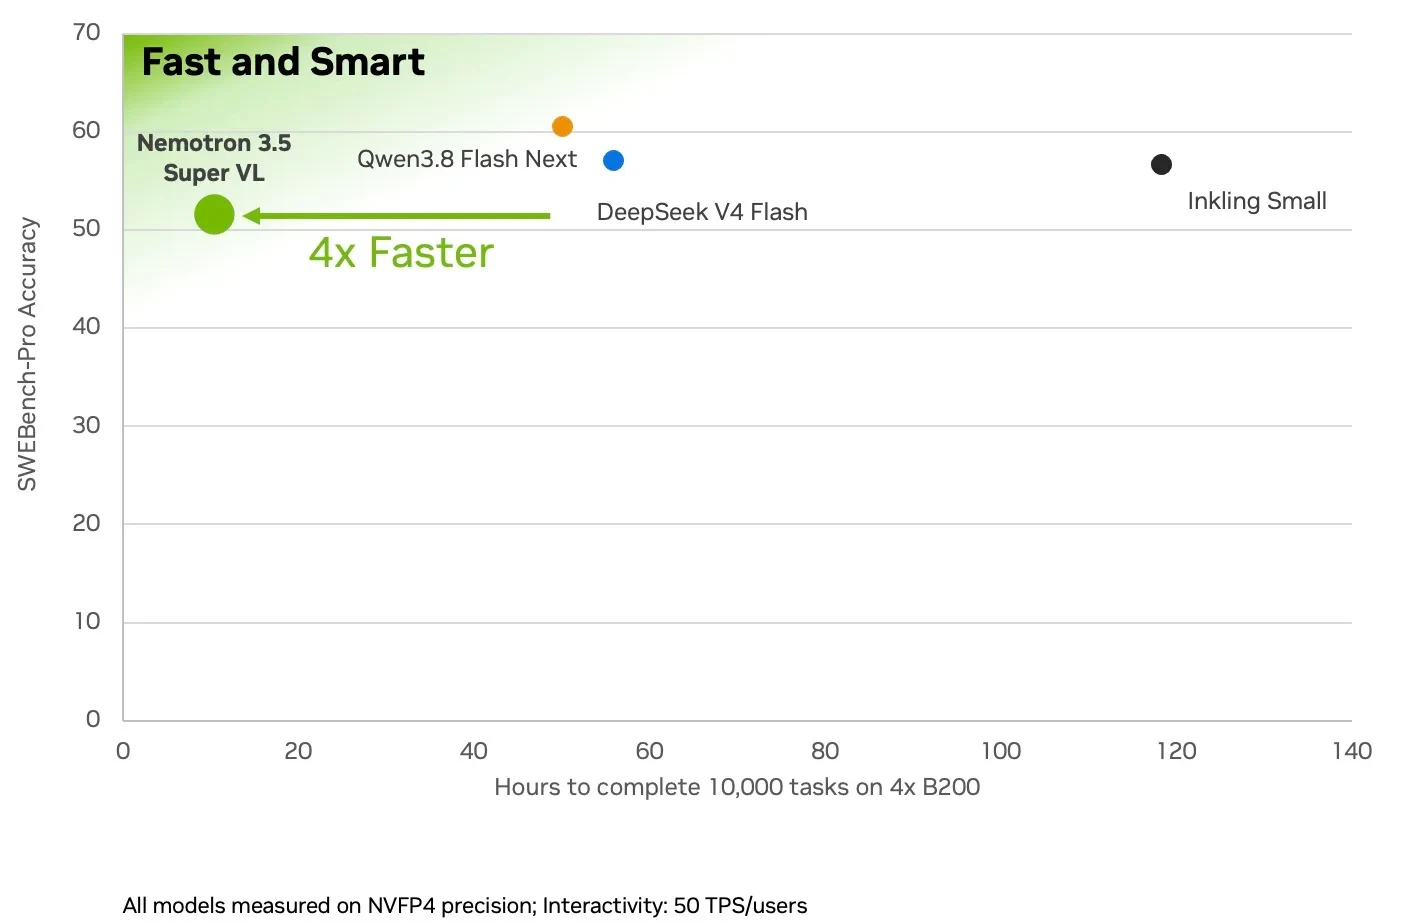
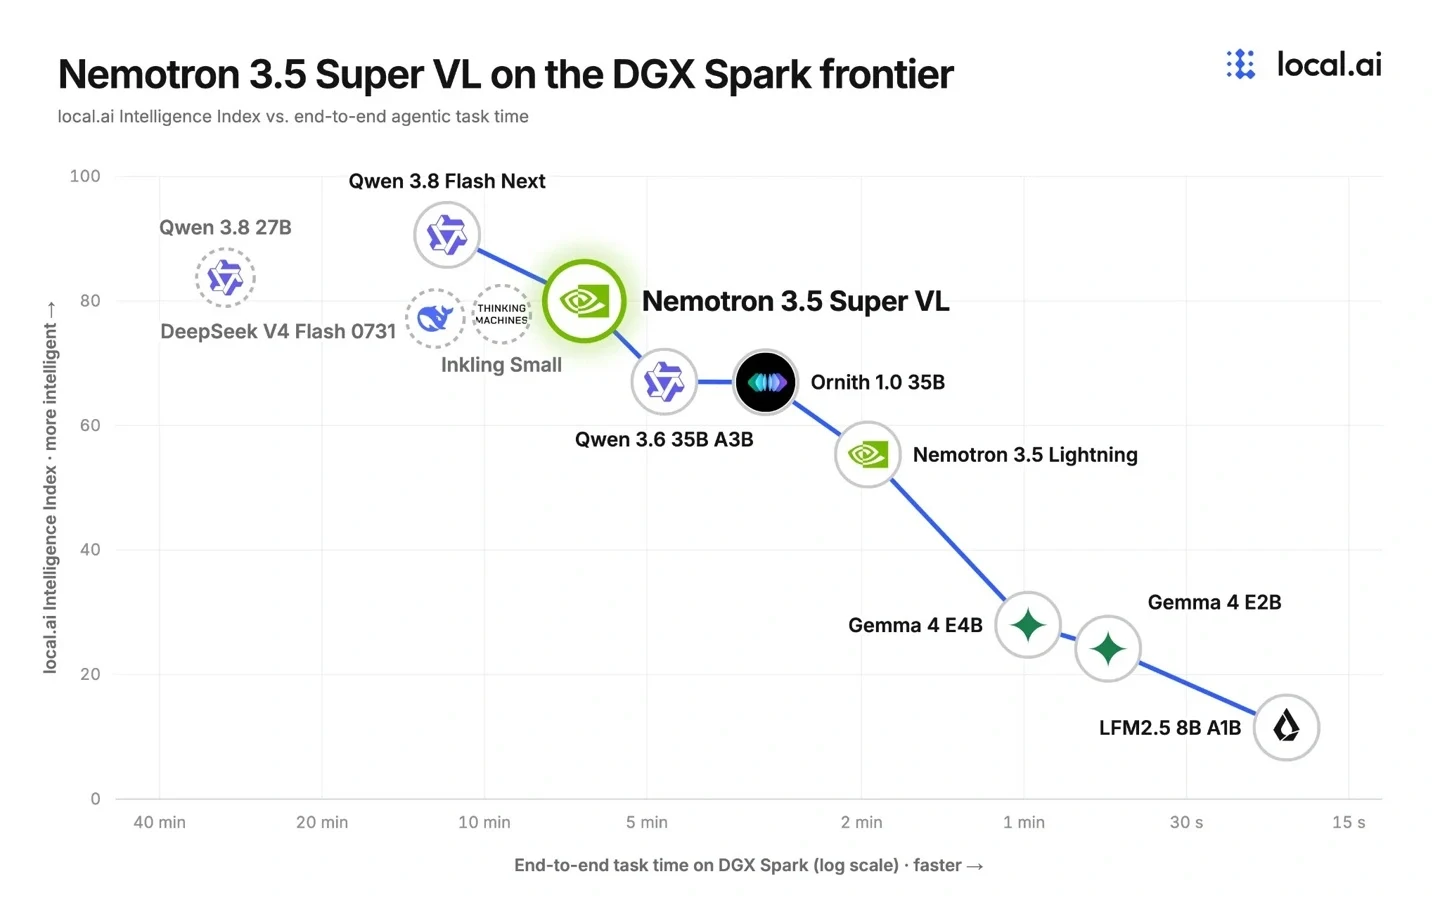
Pour réduire les coûts d'inférence, Nemotron 3.5 Super VL utilise des techniques telles que le décodage spéculatif, la précision mixte et la réutilisation du contexte. Nvidia explique que sa méthode de décodage spéculatif LiLiCorr peut multiplier par 2,3 au maximum la vitesse de génération de jetons sur DGX Spark. Le modèle prend également en charge la quantification NVFP4, avec des poids sur 4 bits et des activations sur 4 bits sur l'architecture Blackwell de Nvidia ; sur les plateformes non Blackwell, le même point de contrôle utilise des poids sur 4 bits et des activations sur 16 bits.
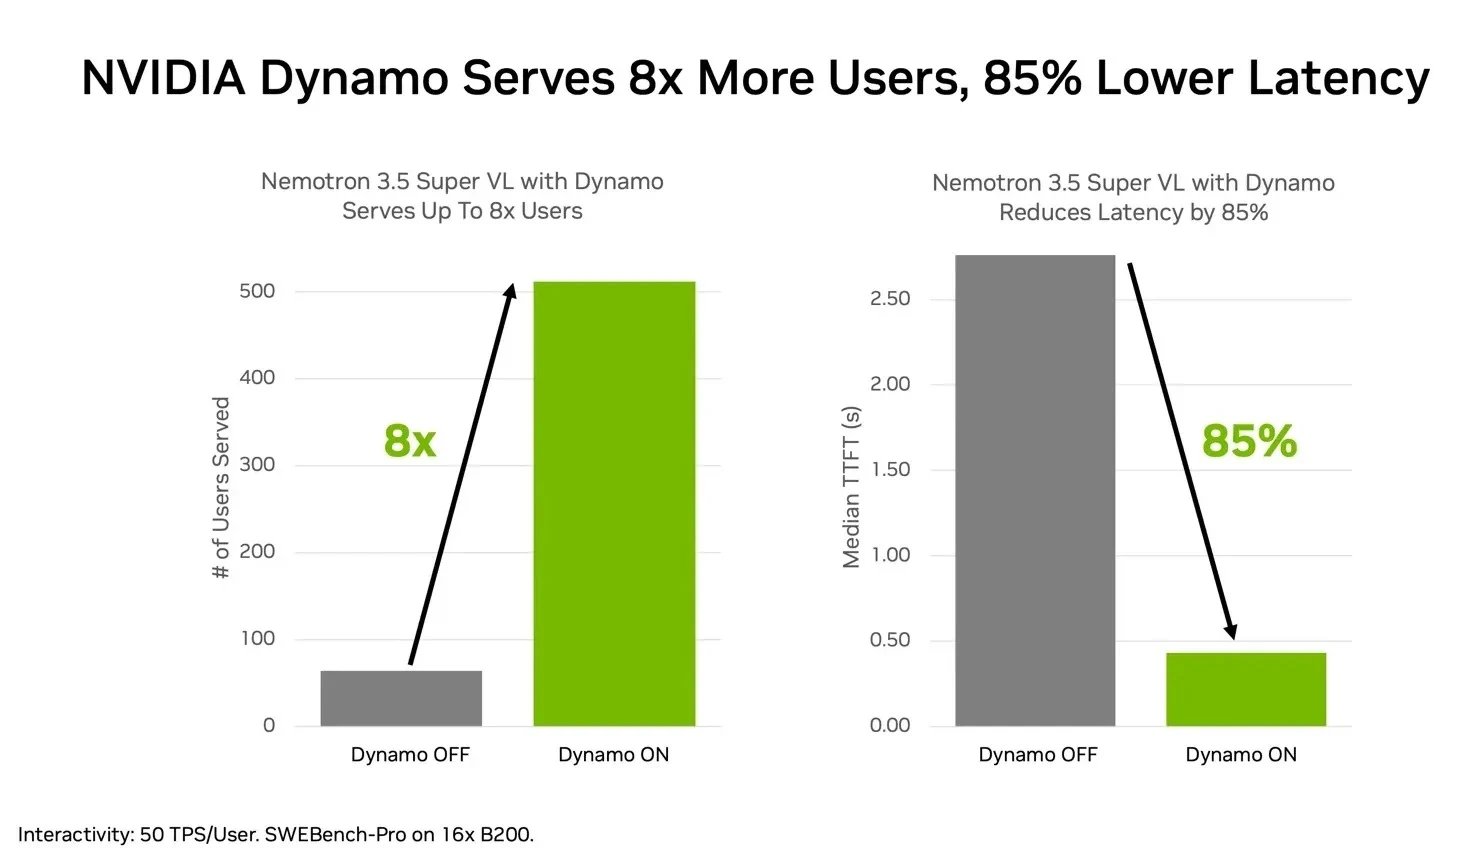
Nvidia a aussi présenté un schéma d'optimisation de déploiement pour l'inférence distribuée. Selon ses données, dans des conditions de test avec 16 GPU NVIDIA B200 et une génération de 50 jetons par seconde et par utilisateur, NVIDIA Dynamo, associé au routage conscient du cache, à l'affinité de session et au déchargement du cache KV, peut servir jusqu'à 8 fois plus d'utilisateurs et réduire la latence du premier jeton de 85 %.
Cette publication inclut également les poids du modèle de base, des modèles post-entraînés et du modèle quantifié NVFP4, ainsi que les recettes d'entraînement, les jeux de données et les environnements d'apprentissage par renforcement.
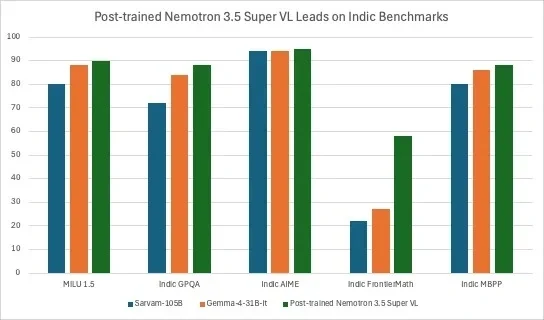
Nvidia indique que Nemotron 3.5 Super VL a utilisé environ 26 trillions de tokens au total durant les phases de pré-entraînement et de pré-entraînement continu, environ 3,8 millions d'échantillons pendant la phase de post-entraînement, ainsi que de l'apprentissage par renforcement dans des dizaines d'environnements. Les nouveaux jeux de données ouverts couvrent des domaines tels que l'appel d'outils par agents, le raisonnement financier, le suivi d'instructions, les longs contextes, l'équité et la compréhension visuo-langagière.
Outre Super VL, Nvidia a également lancé deux modèles embarqués Nemotron 3.5 Bolt. Nemotron 3.5 Bolt 74B-A9B 24GB adopte une architecture MoE de 74 milliards de paramètres totaux et 9 milliards de paramètres activés, compressé à 24 Go grâce à une quantification native sur 2 bits ; destiné aux tâches d'agents locales, il prend en charge llama.cpp, vLLM, Ollama, Unsloth et LM Studio. Nemotron 3.5 Bolt E4B 4GB, quant à lui, cible des scénarios tels que les assistants vocaux locaux, les personnages interactifs et les interfaces embarquées, et est prévu pour le 23 octobre.
IT之家 note que Nemotron 3.5 Super VL et Bolt 74B-A9B 24GB sont déjà accessibles ; les développeurs peuvent utiliser ces ressources de modèles via Hugging Face, OpenRouter, ModelScope et d'autres canaux. Super VL peut être déployé sur DGX Spark, DGX Station, des systèmes RTX, dans des centres de données ou dans le cloud ; Bolt E4B 4GB est prévu pour le 23 octobre.